VLSI Korea
AWS Inferentia에서 Trainium3까지: 가격표를 가진 AI ASIC의 진화
Inferentia1부터 Trainium3까지, AWS Neuron이 chip에서 144-chip UltraServer와 token economics로 확장된 과정을 분석합니다.


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
이 글은 cloud AI accelerator의 세대별 architecture와 system economics를 비교해 구매·투자·공급망 판단을 내리려는 독자를 위한 글이다. 읽고 나면 peak 수치와 실제 model-level TCO를 분리하고, 다음 세대에서 검증할 지표를 선택할 수 있다.
자료 기준일: 2026-08-02
TL;DR
AWS의 AI 반도체 전략은 최첨단 학습칩부터 시작하지 않았다. Inferentia1으로 대량 추론의 비용을 낮추고, 같은 Neuron software stack을 Trainium1 학습으로 확장한 뒤, Inferentia2와 Trainium1이 NeuronCore-v2를 공유하게 했다. Trainium2는 8개의 3세대 NeuronCore, 96 GiB HBM, 2.9 TB/s와 64-chip UltraServer로 rack-scale을 만들었다. Trainium3는 3 nm, 144 GB HBM3e·4.9 TB/s, MXFP8·MXFP4, 144-chip NeuronSwitch all-to-all로 넘어갔다.
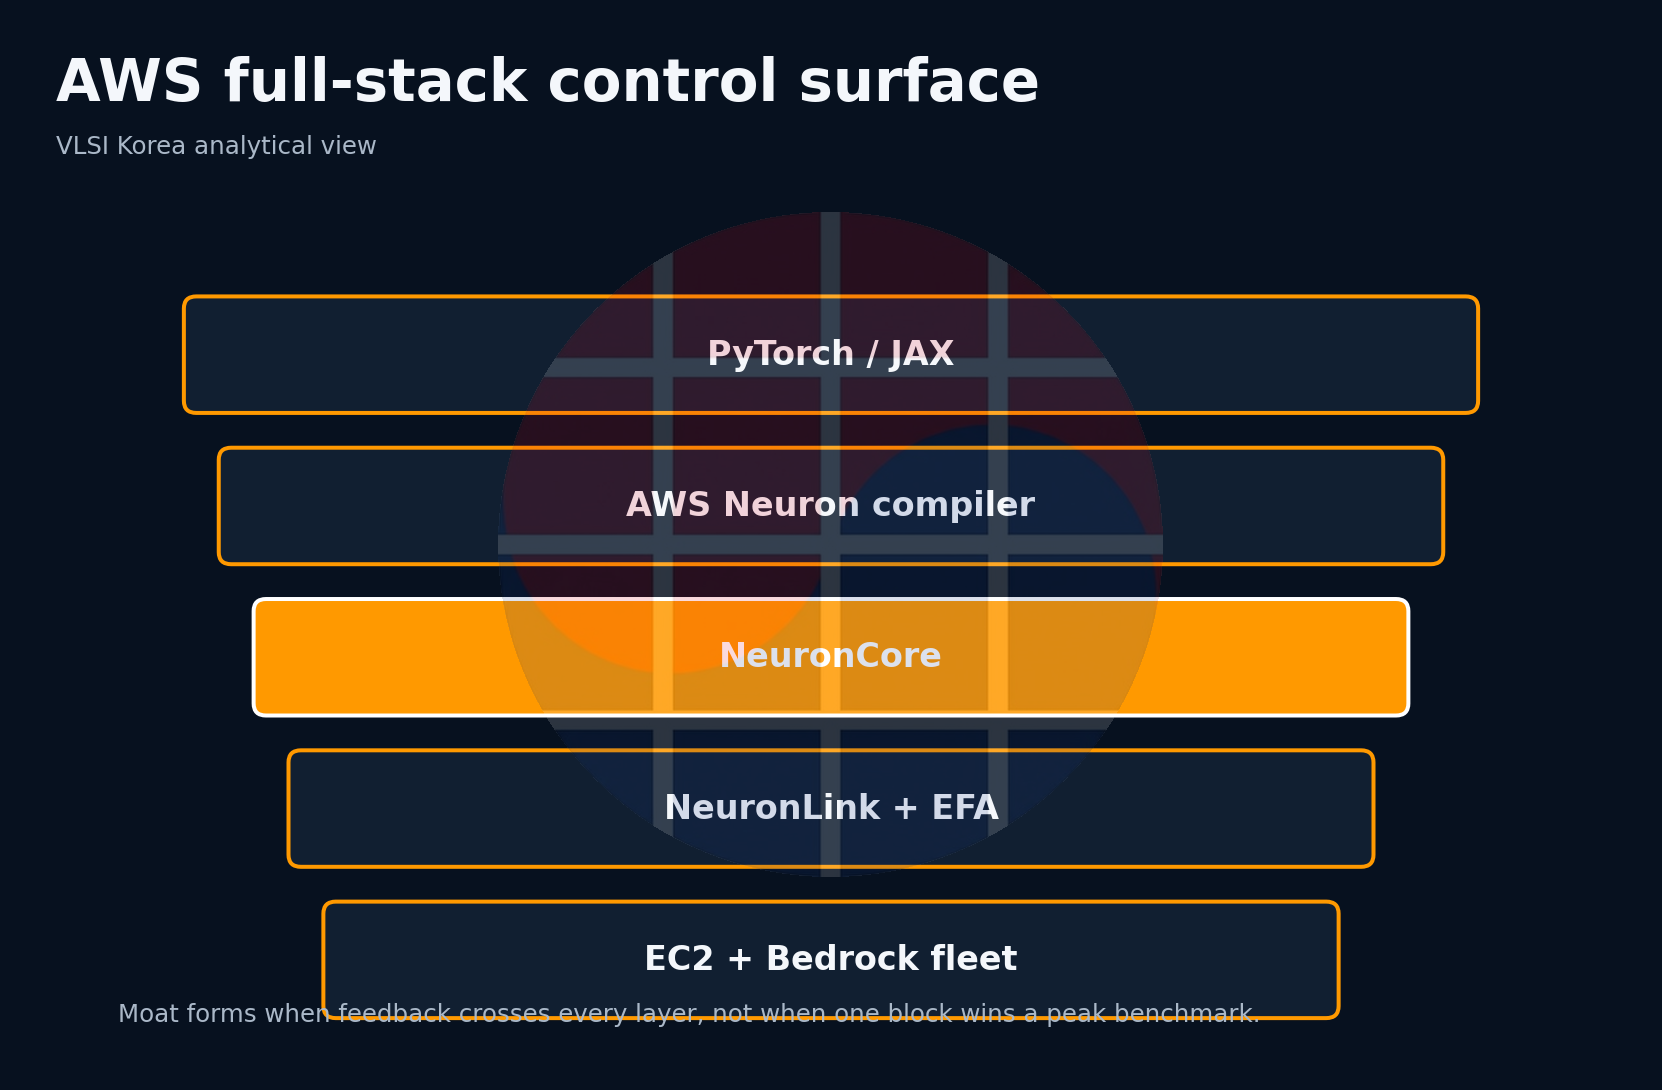
AWS의 강점은 칩이 EC2 instance, SageMaker, Bedrock, EKS와 가격표로 바로 연결된다는 점이다. 약점은 CUDA ecosystem과 비교한 operator coverage, compile·debug friction, AWS 밖으로 나갈 수 없는 runtime이다. Trainium의 승부는 peak PFLOPS보다 Anthropic과 Bedrock의 높은 fleet utilization이 Neuron software debt를 얼마나 빠르게 갚느냐에 달렸다.
Generation map
| Generation | Primary role | Compute per chip | Memory per chip | Scale boundary |
|---|---|---|---|---|
| Inferentia1 | Inference | 128 INT8 TOPS / 64 FP16 TFLOPS | 8 GB DRAM, 50 GB/s | Up to 16 chips per Inf1 instance |
| Trainium1 | Training | About 190 FP16/BF16 TFLOPS | 32 GB HBM, about 0.61 TB/s | 16 chips per Trn1, up to 30,000-chip cluster |
| Inferentia2 | Distributed inference | 380 INT8 TOPS / 190 FP16/BF16 TFLOPS | 32 GB HBM, about 0.82 TB/s | 12 chips per Inf2 instance |
| Trainium2 | Training and inference | 1.3 dense FP8 PFLOPS | 96 GiB HBM, 2.9 TB/s | 64-chip UltraServer |
| Trainium3 | Training and inference | 2.52 FP8 PFLOPS | 144 GB HBM3e, 4.9 TB/s | 144-chip UltraServer |
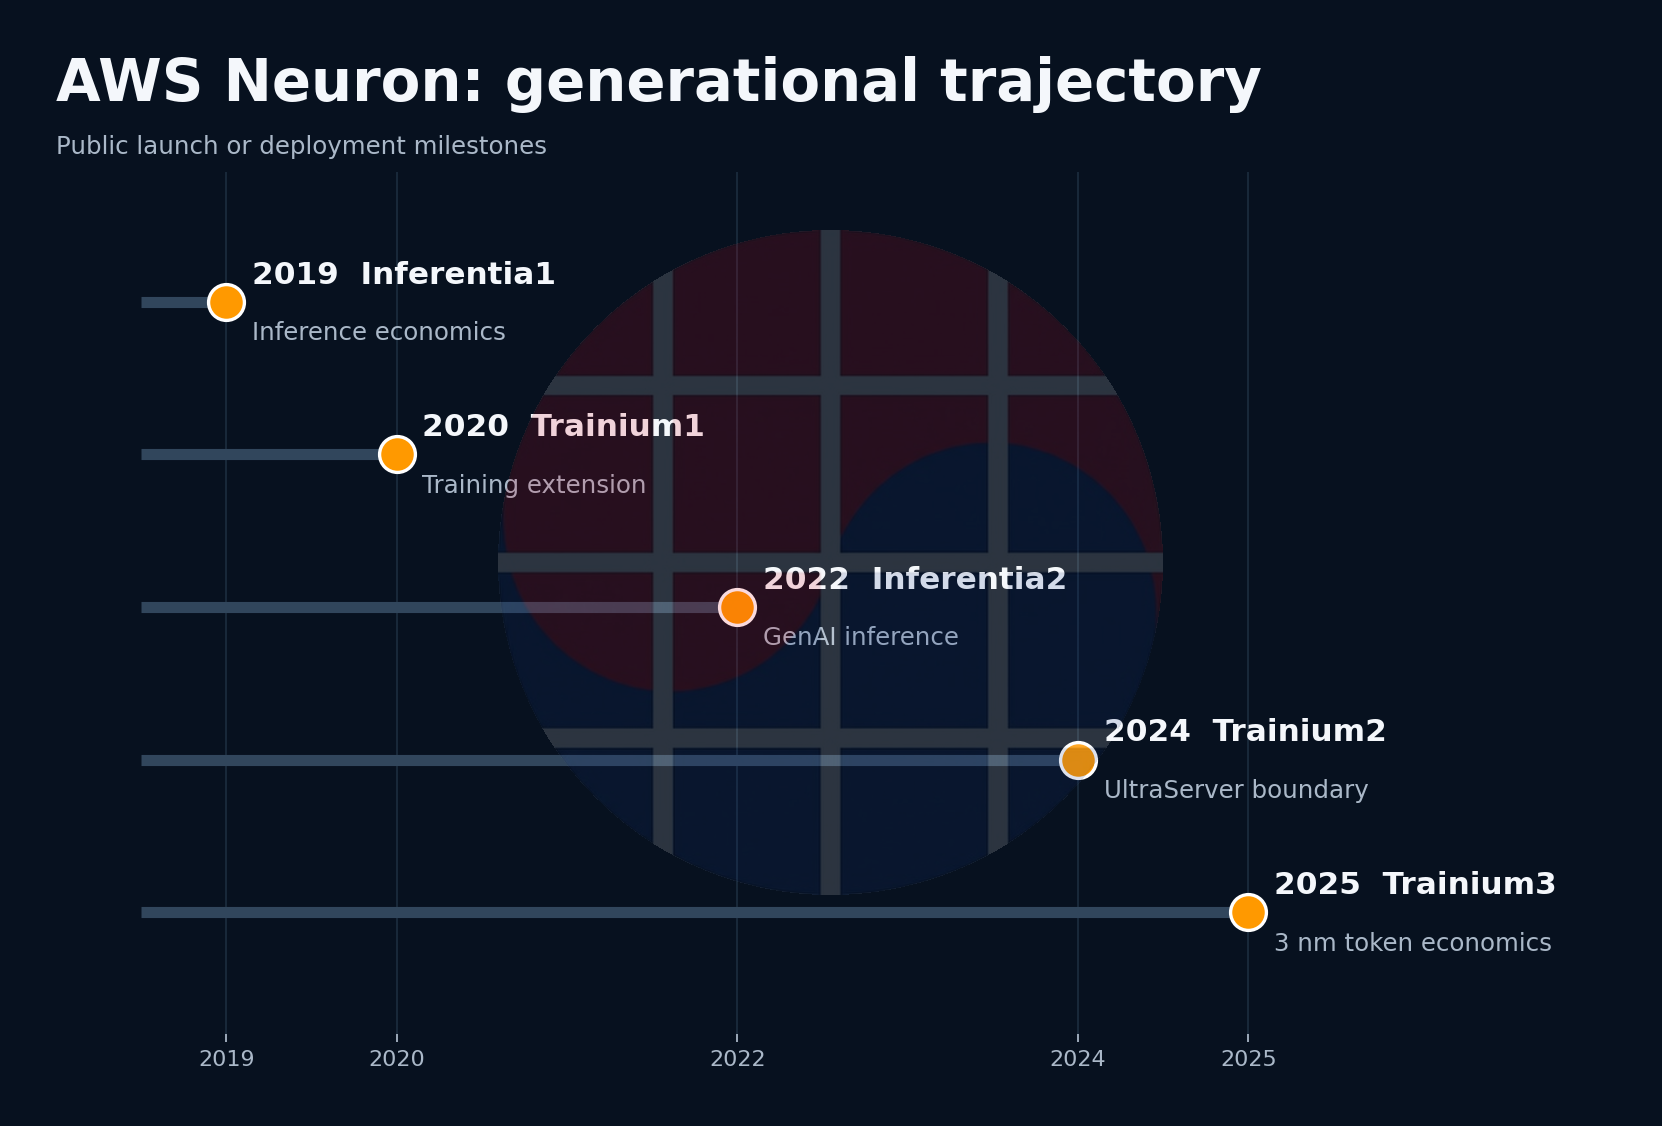
Trainium1의 chip 수치는 AWS가 공개한 16-chip Trn1 aggregate를 chip 수로 나눈 값이라 반올림했다. Trainium2의 5.2 PFLOPS sparse와 Trainium3 UltraServer의 362 MXFP8 PFLOPS는 sparsity·data format 조건이 달라 dense FP8과 직접 비교하지 않았다.
Inferentia1: cloud ASIC의 가장 현실적인 출발
2019년 출시된 Inferentia1은 4개의 NeuronCore-v1, chip당 128 INT8 TOPS, 64 FP16·BF16 TFLOPS, 8 GB DRAM과 50 GB/s bandwidth를 제공했다. 이 사양은 오늘 기준으로 작지만 당시 AWS가 풀려던 문제에는 맞았다. image classification, recommendation, speech, NLP inference는 학습보다 배포량이 훨씬 크고, latency SLO 안에서 batch를 모아야 하며, 고객은 GPU 사용료에 민감하다.
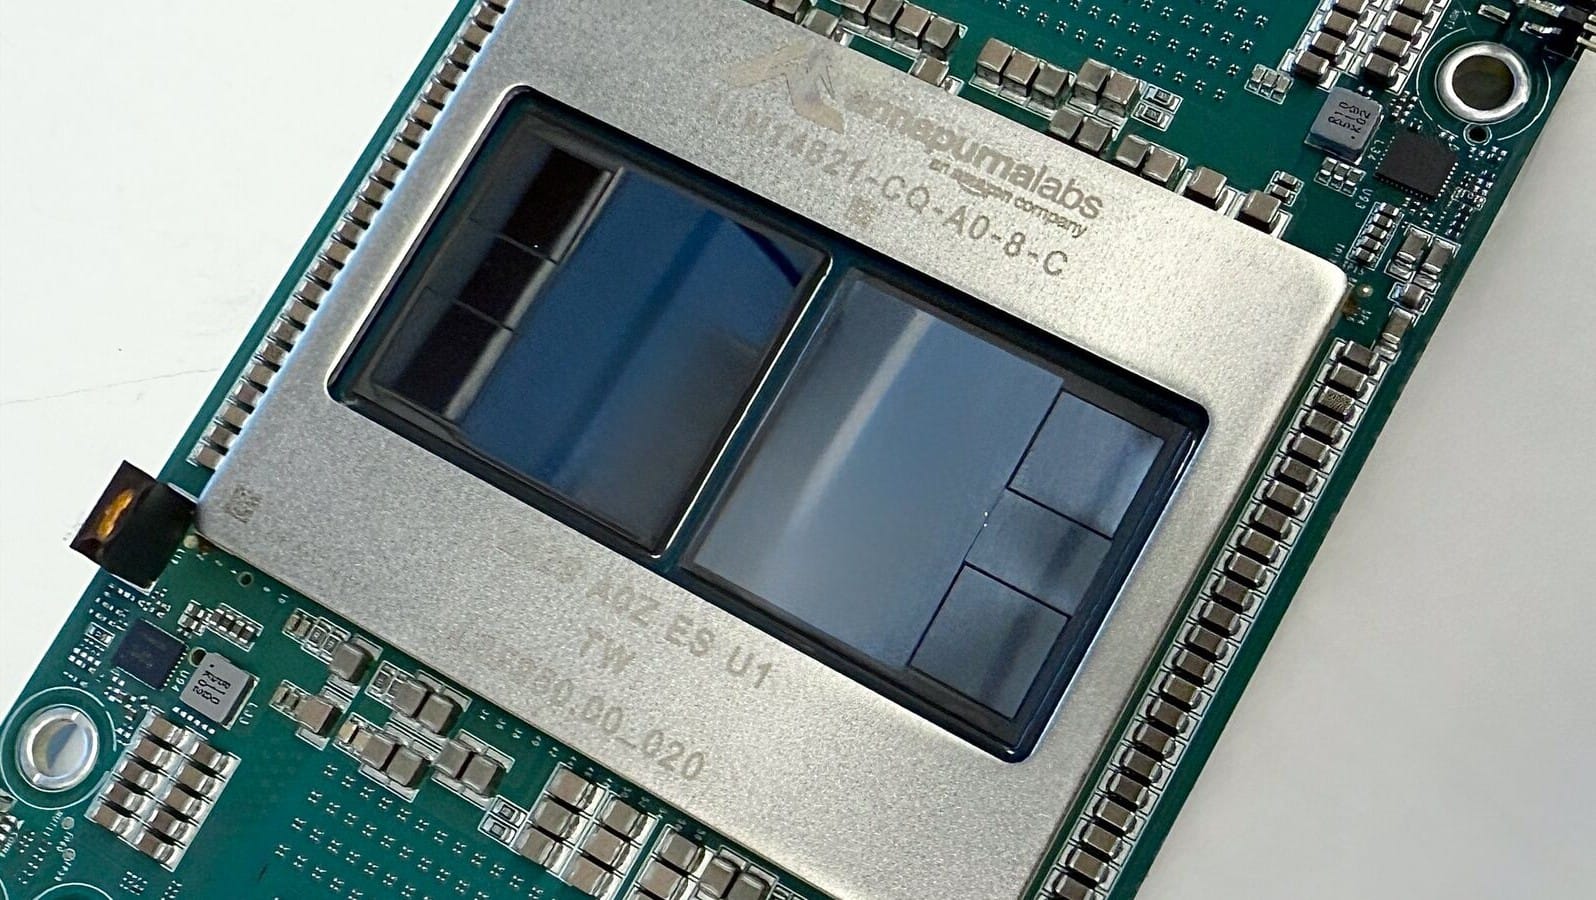
Inferentia1의 설계는 큰 모델 하나보다 여러 작은 production model을 core별로 배치하는 데 유리했다. 네 개 NeuronCore에 서로 다른 model을 올리거나 하나를 shard할 수 있다. 하지만 8 GB와 낮은 memory bandwidth는 생성형 AI의 거대한 weight와 KV cache에는 부족했다. chip 간 연결도 후속 세대처럼 대규모 distributed inference를 중심으로 설계되지 않았다.
AWS가 얻은 가장 큰 자산은 Neuron compiler와 runtime이었다. TensorFlow·PyTorch graph를 가져와 NEFF executable로 compile하고, driver와 runtime이 NeuronCore에 올리는 경로를 만들었다. 첫 세대의 real cost는 silicon보다 unsupported operator, static graph assumption, compilation, profiler와 error message의 성숙도였다. 이 투자는 이후 Trainium에 그대로 전이됐다.
Trainium1: Inferentia의 소프트웨어를 학습으로 확장
Trainium1은 2개의 NeuronCore-v2와 32 GB HBM을 사용한다. Trn1.32xlarge는 16개 chip, 512 GB aggregate HBM, 9.8 TB/s aggregate memory bandwidth, 약 3 PFLOPS FP16·BF16을 제공한다. intra-instance NeuronLink는 최대 768 GB/s, inter-node EFAv2는 800 Gbps, Trn1n은 1,600 Gbps다. UltraCluster는 AWS 발표상 최대 30,000 chip과 6 EFLOPS로 확장된다.
학습칩에서 scalar, vector, tensor engine을 함께 둔 이유는 Transformer가 GEMM의 연속이 아니기 때문이다. normalization, activation, indexing, optimizer update, control flow를 처리할 engine이 필요하다. NeuronCore-v2는 GPSIMD programmable engine과 custom C++ operator, dynamic shape, stochastic rounding, configurable FP8을 지원해 ASIC의 고정성을 완화했다.
Trainium1의 시스템 판단은 EFA를 chip 설계와 같은 수준으로 본 것이다. 16-chip server 안에서는 NeuronLink로 collective를 처리하고, server 밖에서는 Nitro·EFA network를 사용한다. tensor·pipeline·data parallel을 조합할 때 intra-node와 inter-node bandwidth 차이를 sharding plan에 반영해야 한다. Neuron Distributed가 Megatron 계열 parallelism을 제공하지만, topology-aware placement와 compile artifact 관리가 성능에 직접 영향을 준다.
Inferentia2: 생성형 AI가 inference chip을 다시 설계하게 하다
Inferentia2는 NeuronCore 수를 4개에서 2개로 줄였지만 core 자체를 크게 바꿨다. chip당 380 INT8 TOPS, 190 FP16·BF16·cFP8·TF32 TFLOPS, 47.5 FP32 TFLOPS, 32 GB HBM을 제공한다. Inferentia1 대비 memory capacity는 4배, bandwidth는 16.4배다. Inf2.48xlarge는 12개 chip과 384 GB HBM, 2.3 PFLOPS를 제공하며 NeuronLink로 CPU를 우회해 chip 간 model shard를 이동한다.
이 세대의 핵심은 inference-optimized instance도 scale-up이 필요하다는 인식이다. 175B parameter model은 한 accelerator에 들어가지 않는다. weight만 BF16으로 약 350 GB이고 KV cache와 runtime buffer가 추가된다. 12-chip Inf2는 모델을 한 instance 안에 담아 외부 network latency를 줄인다. 반면 작은 모델은 chip마다 여러 copy를 올려 throughput을 높인다.
AWS가 주장하는 Inferentia1 대비 최대 4배 throughput과 10배 낮은 latency는 workload별 최댓값이다. 실제 결과는 tensor-parallel degree, sequence length, batch, quantization, continuous batching과 compiler version에 달린다. 특히 autoregressive decode는 FLOPS보다 HBM bandwidth와 collective latency가 지배적이므로 chip peak만으로 성능을 예측할 수 없다.
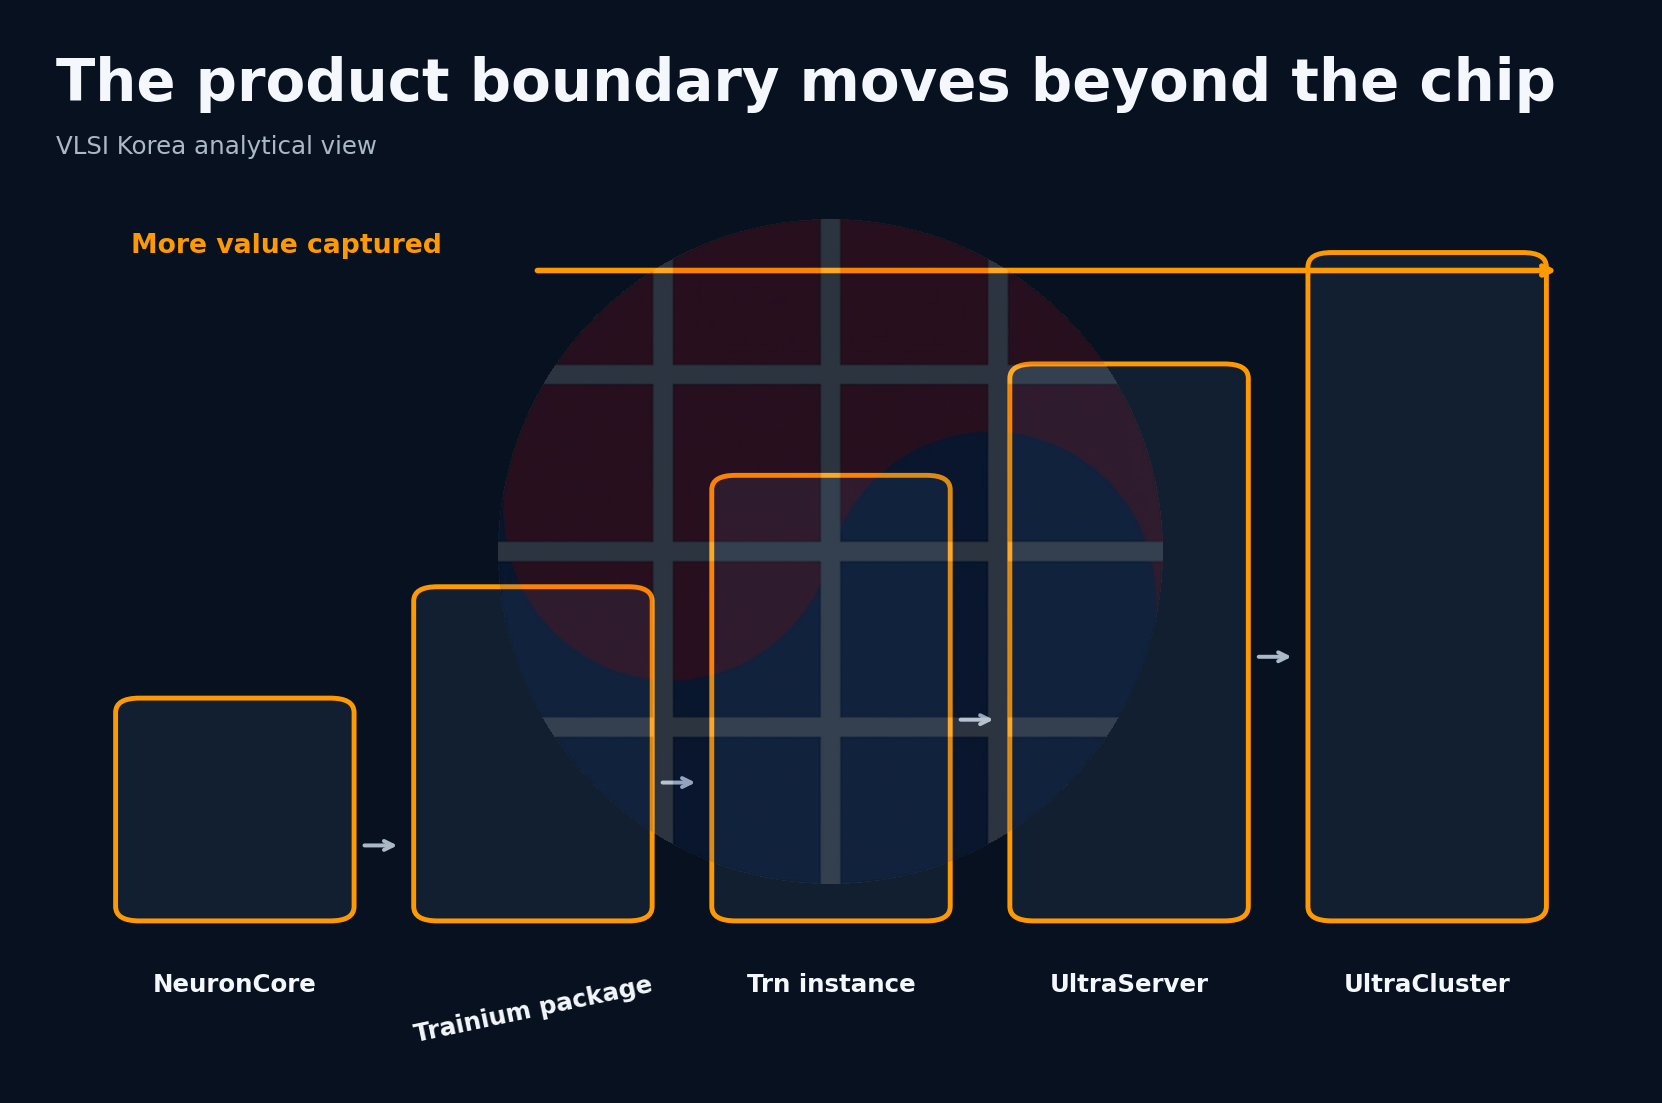
Trainium2: 칩에서 UltraServer로 product boundary를 이동
Trainium2는 8개의 3세대 NeuronCore, chip당 96 GiB HBM과 2.9 TB/s를 제공한다. dense FP8 peak는 1.3 PFLOPS, structured sparsity 조건에서는 5.2 PFLOPS다. 하나의 Trn2 instance는 16개 chip, UltraServer는 64개 chip을 NeuronLink로 묶는다. AWS는 automated HBM queue reordering으로 memory bandwidth utilization 95%를 구동할 수 있다고 설명한다.
NeuronCore는 scalar, vector, tensor, GPSIMD engine으로 구성된다. 중요한 추가 요소는 dedicated collective engine이다. 계산 engine과 통신 engine을 겹치면 all-reduce와 all-to-all이 matrix unit을 쉬게 하는 시간을 줄일 수 있다. MoE에서는 token dispatch와 expert result gather가 빈번해 collective offload가 특히 중요하다.
64-chip UltraServer는 최대 6.144 TiB HBM을 하나의 scale-up domain에 둔다. 이 구조는 model parallel을 rack 안에 가두고 EFA scale-out을 data parallel 중심으로 사용할 가능성을 높인다. 하지만 64개 chip 전체를 효율적으로 쓰려면 software가 physical topology, link contention, expert placement를 알아야 한다. 64개가 연결됐다와 64개가 하나의 GPU처럼 보인다 사이에는 compiler·collective library·failure handling의 큰 간극이 있다.
Trainium3: token economics를 전면에 내건 3 nm 세대
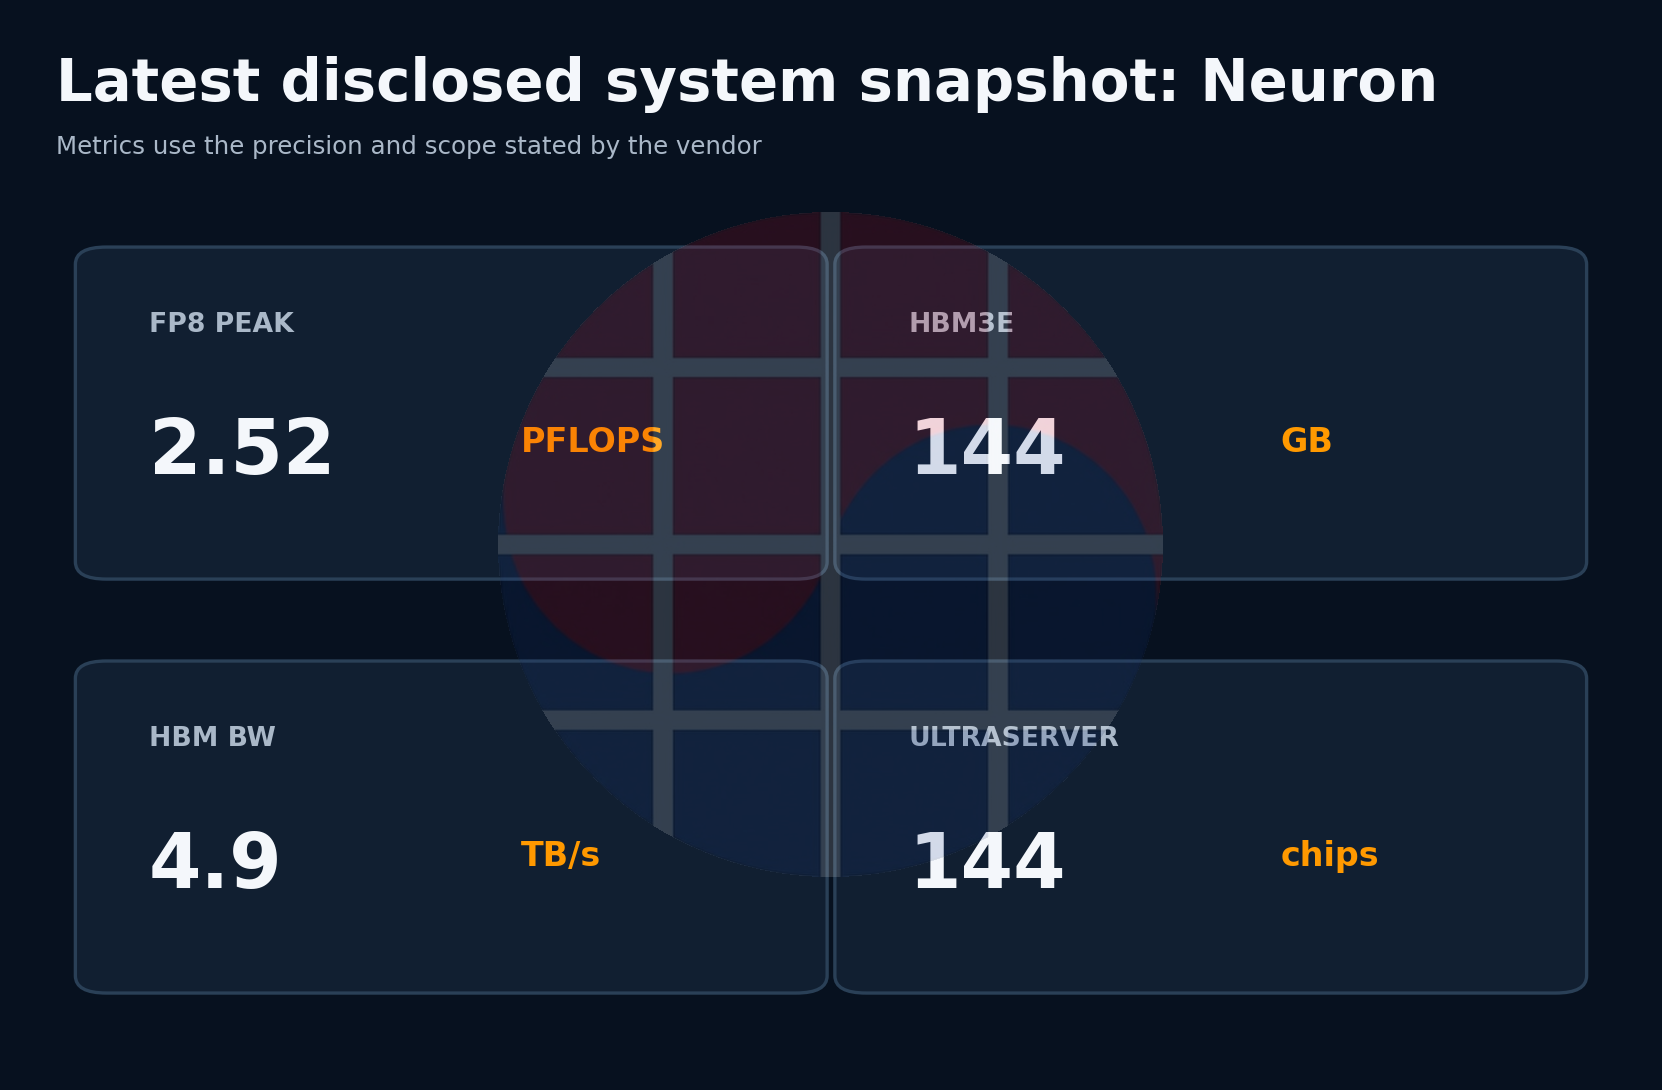
Trainium3는 AWS의 첫 3 nm AI chip이다. chip당 FP8 2.52 PFLOPS, 144 GB HBM3e, 4.9 TB/s를 제공한다. Trainium2 대비 chip compute 약 2배, memory capacity 1.5배, bandwidth 약 1.7배다. FP32, BF16, MXFP8, MXFP4를 지원한다.
Trn3 UltraServer는 최대 144개 chip, 20.7 TB aggregate HBM3e, 706 TB/s aggregate memory bandwidth, 362 MXFP8 PFLOPS를 제공한다. NeuronSwitch-v1과 NeuronLink-v4가 chip당 2 TB/s all-to-all fabric를 구성하고, UltraCluster 3.0은 수십만 chip scale-out을 목표로 한다. AWS는 Trn2 UltraServer 대비 최대 4.4배 performance, 3.9배 memory bandwidth, 4배 performance/W를 주장한다. 여기에는 chip 증가 64개에서 144개, 세대 교체, system topology 변화가 함께 포함되므로 chip-to-chip 배수와 구분해야 한다.
Trainium3의 memory-to-compute balance를 보면 의도가 드러난다. FP8 compute는 2배, HBM bandwidth는 1.7배다. 순수 dense GEMM은 빨라지지만 decode와 memory-bound kernel은 같은 비율로 늘지 않을 수 있다. 대신 144 GB capacity와 더 큰 scale-up domain은 model을 적은 server 경계 안에 담고 network hop을 줄인다. MXFP4는 weight bandwidth를 더 줄여 이 불균형을 보완할 수 있지만 accuracy recipe와 conversion overhead가 관건이다.
NKI가 stable로 올라온 것도 중요하다. Python syntax로 ISA, memory tile, execution schedule을 제어하며 custom attention, quantization, fused optimizer kernel을 작성할 수 있다. CUDA를 모방하는 대신 compiler 자동화와 low-level escape hatch를 동시에 제공한다. 2026년 Neuron release는 Trainium3의 scalar instruction, OCP FP8, MXFP8, variable-length all-to-all, zero-copy host transfer를 추가했다. silicon 출시 후에도 software가 세대 성능을 계속 해금하는 구조다.
AWS의 경제성 논리
AWS는 자체 chip을 외부에 판매하지 않고 EC2 시간, SageMaker training, Bedrock token으로 판매한다. 따라서 die gross margin이 아니라 fleet total cost와 service margin을 최적화한다. 고객이 GPU에서 Trainium으로 이동하면 AWS는 NVIDIA 공급 제약과 vendor margin을 줄이고, 예약·spot·managed service로 utilization을 관리할 수 있다.
Inferentia와 Trainium이 같은 Neuron stack을 쓰는 것도 학습에서 inference로 model을 옮기는 전환 비용을 낮춘다. 하지만 binary portability가 완전하다는 뜻은 아니다. training graph와 serving graph의 parallelism, precision, dynamic batching은 다르다. 고객이 지불하는 migration engineer-hours, compile cache, validation과 fallback capacity까지 포함해야 진짜 가격 우위를 계산할 수 있다.
Anthropic 같은 대규모 anchor tenant는 전략적으로 중요하다. 반복되는 대형 workload가 kernel과 compiler를 빠르게 개선하고 fleet utilization을 보장한다. 반대로 소수 고객에 optimization이 치우치면 long-tail model은 GPU보다 불편할 수 있다. Bedrock이 이 문제를 완충한다. 고객이 hardware API를 직접 다루지 않고 token service를 구매하면 AWS가 내부에서 accelerator를 바꿀 수 있기 때문이다.
Watch points
- Trainium3가 dense, MoE, long-context, video에서 각각 어떤 sustained HBM utilization과 model FLOPS utilization을 보이는가.
- 144-chip all-to-all domain에서 NeuronSwitch failure isolation과 collective tail latency가 어떻게 관리되는가.
- NKI와 Neuron Explorer가 CUDA kernel porting 시간, compile time, numerical validation을 얼마나 줄이는가.
- Inferentia 계보가 Trainium inference로 흡수되는지, 별도의 Inferentia3가 다시 inference-specific balance를 제시하는지.
- Bedrock token price와 EC2 instance price가 실제 accelerator utilization과 energy cost 하락을 반영하는지.
Contrarian read: AWS의 distribution이 software 약점을 영원히 가릴 수는 없다
AWS가 EC2·SageMaker·Bedrock distribution으로 고객을 확보하더라도 developer는 model을 다른 cloud와 on-premise에서도 실행하려 한다. Neuron-specific kernel과 sharding이 많아질수록 portability가 떨어지고, 멀티클라우드 고객은 CUDA 또는 open accelerator stack을 선호할 수 있다. PyTorch code changes 없음은 functional porting과 performance porting을 혼동하기 쉬운 표현이다.
반대로 내가 AWS를 과소평가할 가능성도 크다. 대부분의 enterprise 고객은 accelerator를 직접 programming하지 않고 managed API와 container를 쓴다. Bedrock이 model·runtime·hardware를 숨기고 SLA와 가격만 제공한다면 CUDA ecosystem의 우위는 고객 interface 아래로 내려간다. 이 경우 Trainium의 성공 조건은 developer love보다 AWS 내부 운영팀이 같은 품질을 더 싼 token으로 제공하는가다.
Korean lens
AWS 세대론은 한국 NPU 기업에 두 가지를 말한다. 첫째, 첫 chip부터 frontier training을 노릴 필요는 없다. 반복량이 큰 inference workload로 compiler와 운영 stack을 만들고 training으로 확장할 수 있다. 둘째, chip 판매만으로는 hyperscaler ASIC과 같은 economics를 얻기 어렵다. cloud instance, model service, anchor workload와 장기 capacity가 있어야 낮은 silicon margin을 전체 service margin으로 회수할 수 있다.
한국 부품사는 HBM과 package만 보지 말고 NeuronSwitch·EFA 계층, liquid cooling, rack power, optical scale-out의 BOM을 봐야 한다. Trainium3가 144-chip UltraServer로 커지면서 chip당 HBM 증가보다 rack당 총 HBM과 link 수가 더 빠르게 늘어난다. qualification 병목은 accelerator die와 HBM stack뿐 아니라 switch silicon, connector, optical module, power delivery와 coolant distribution에 분산된다.
Sources
- Inferentia1 and Inferentia2 architecture evolution
- EC2 Inf2 instances
- EC2 Trn1 instances
- Trainium1 GA
- Trainium2 and Trn2 UltraServers
- Trainium3 UltraServers
- AWS Neuron 2.29
- AWS Neuron 2.30
Disclosure
본 글은 정보 제공만을 목적으로 하며, 특정 증권의 매수 또는 매도를 권유하는 것이 아닙니다. 본 글에 포함된 수치와 사실은 기업 공시, 언론 보도, 시장 조사 등 공개적으로 이용 가능한 자료를 바탕으로 작성되었으며, 해당 자료 또는 작성 과정에서 오류가 발생할 수 있습니다. 필자는 언급된 기업의 주식을 보유하고 있을 수 있습니다. 모든 투자 결정 및 그에 따른 결과는 독자의 책임입니다.