VLSI Korea
Baidu Kunlun 세대론: FPGA XPU에서 3만 장 AI Cloud까지
FPGA XPU부터 Kunlun 3와 3만 장 cluster까지, Baidu가 검색 workload·PaddlePaddle·cloud를 수직 통합한 과정을 분석합니다.


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
이 글은 cloud AI accelerator의 세대별 architecture와 system economics를 비교해 구매·투자·공급망 판단을 내리려는 독자를 위한 글이다. 읽고 나면 peak 수치와 실제 model-level TCO를 분리하고, 다음 세대에서 검증할 지표를 선택할 수 있다.
자료 기준일: 2026-08-02
TL;DR
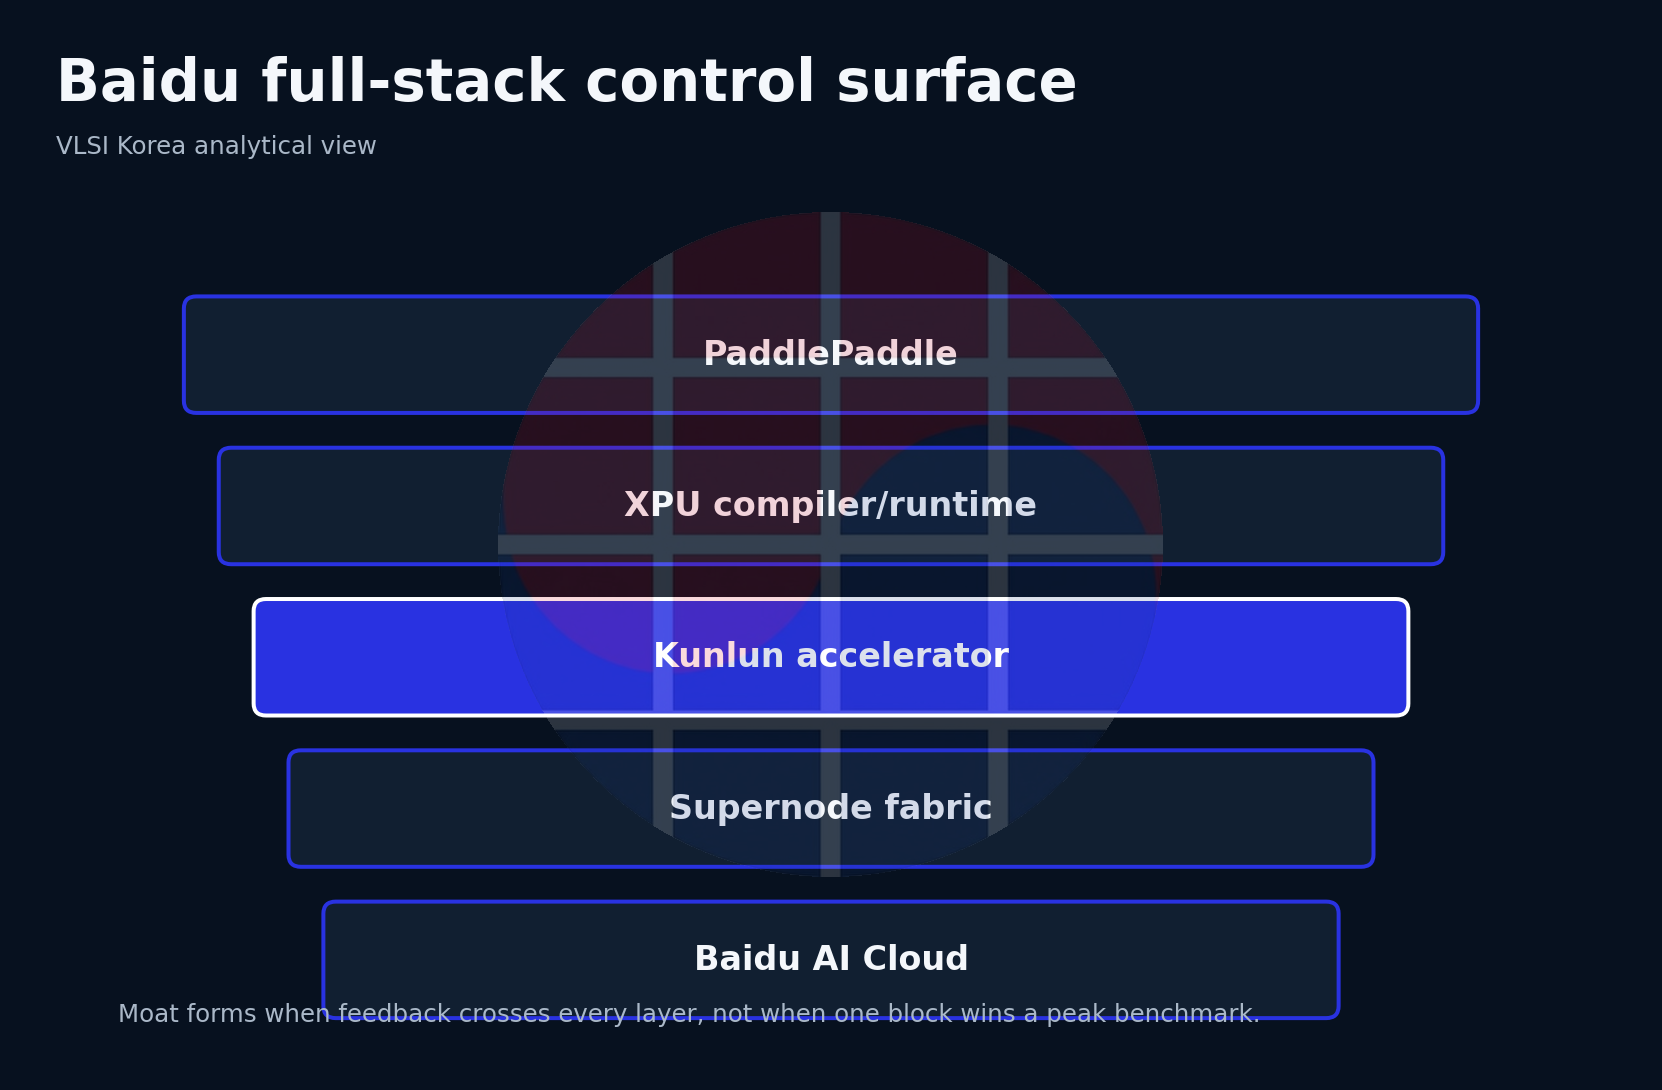
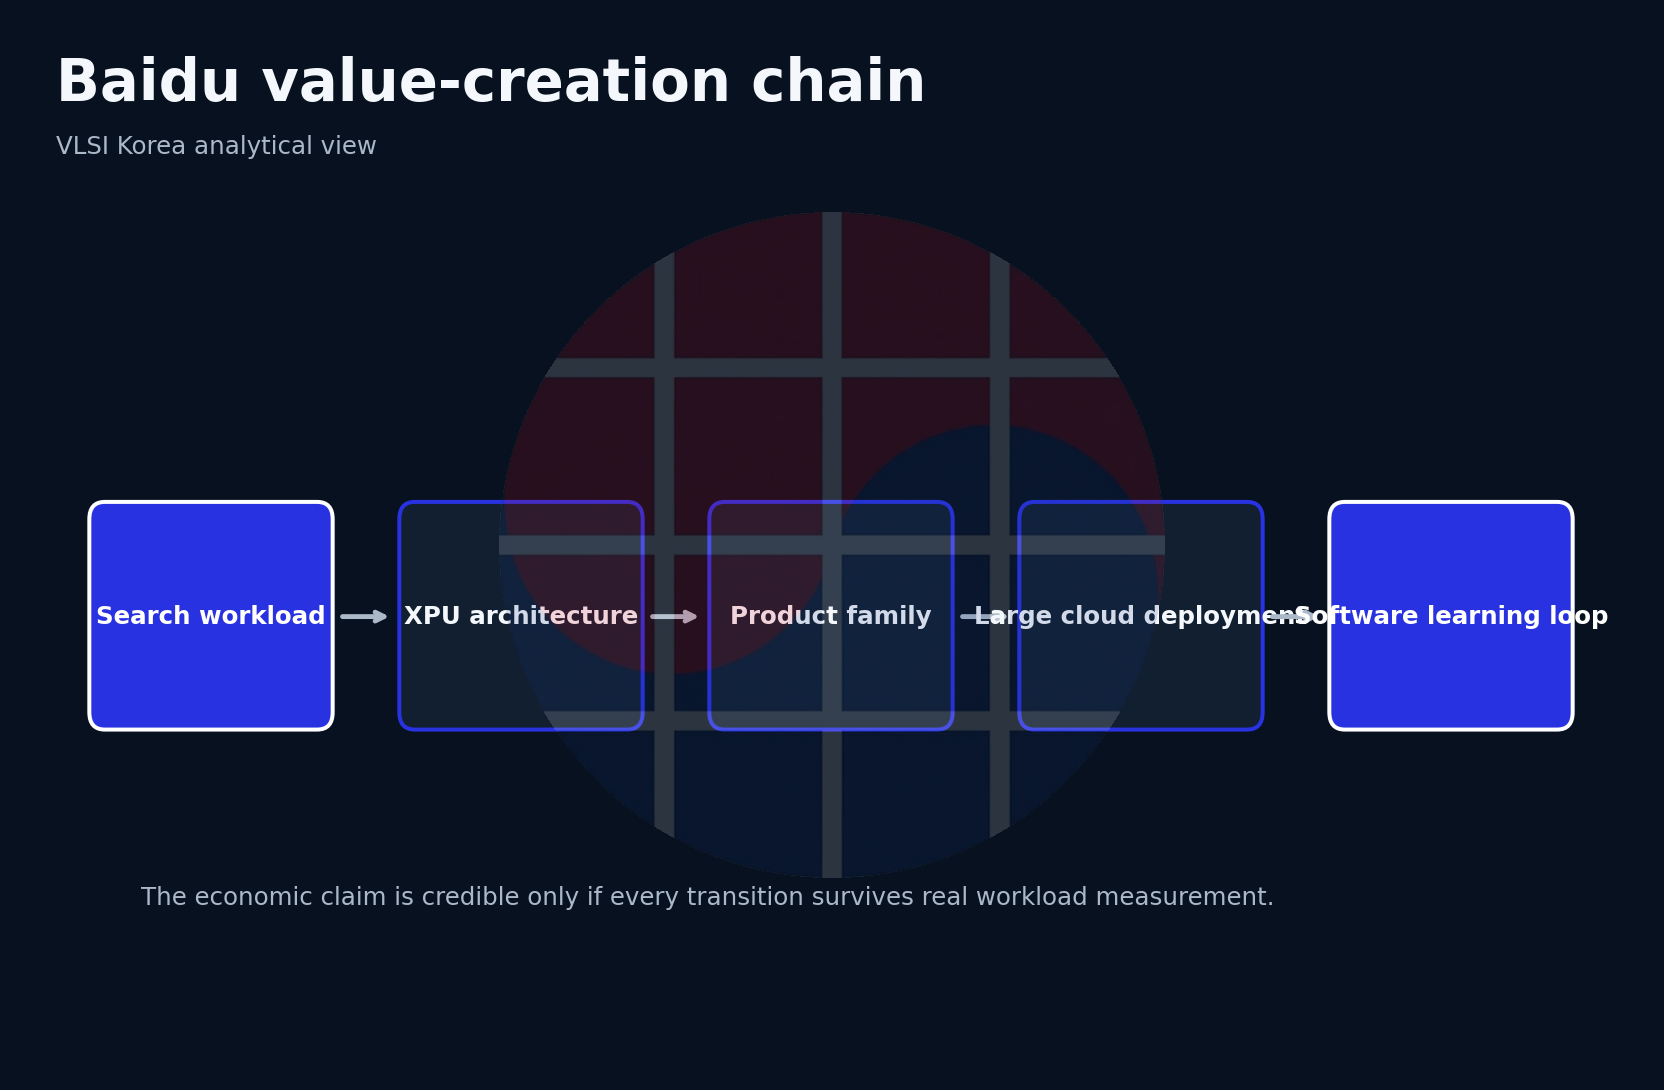
Baidu Kunlun의 핵심은 독립 반도체 회사의 chip roadmap이 아니라 검색·추천·광고·자연어 처리 workload를 가진 cloud operator가 FPGA에서 ASIC, board, cluster, PaddlePaddle까지 수직 통합한 과정이다. Baidu는 2010년부터 FPGA 기반 가속을 연구했고, 2017년까지 1만 장 이상을 내부에 배치했다. 이 workload trace와 compiler 경험이 2019년 1세대 Kunlun, 2021년 2세대, 2024년 3세대 XPU의 기반이 됐다.
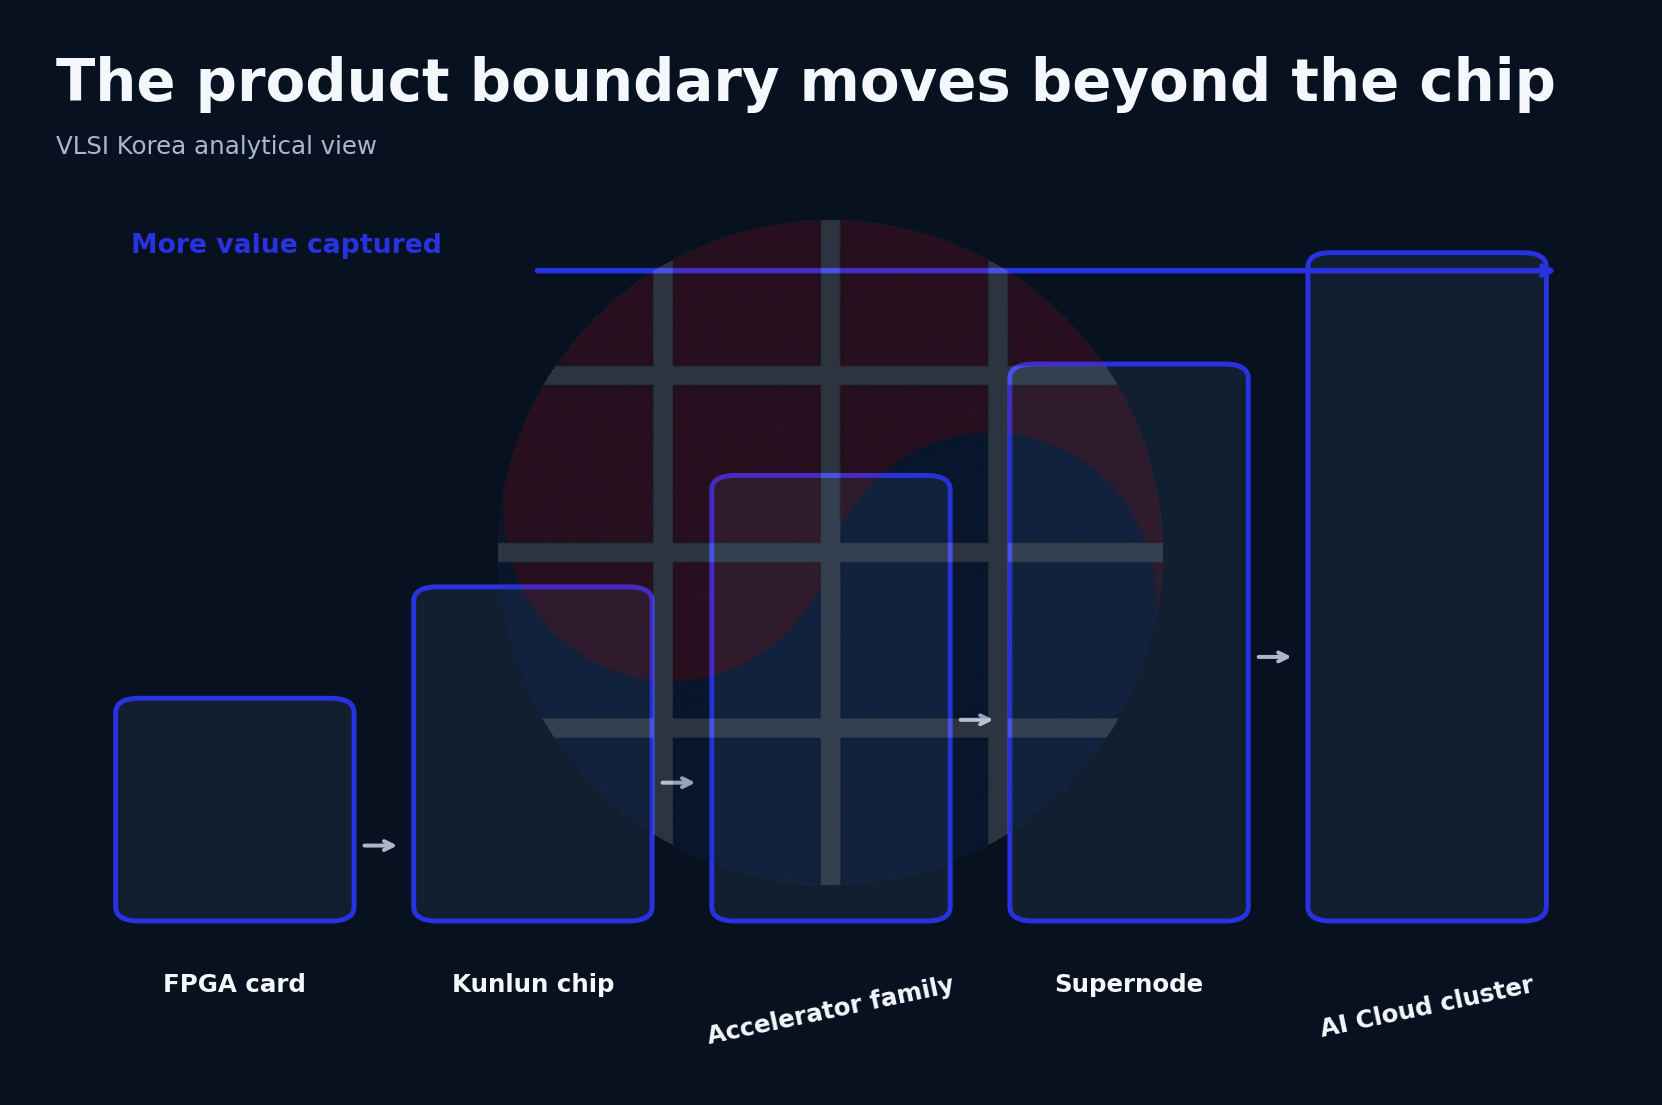
1세대 K200은 Samsung 14 nm와 2.5D I-Cube, 16 GB HBM, 512 GB/s, 256 INT8 TOPS, 150 W로 공개됐다. 2세대는 7 nm와 XPU-R core, GDDR6 기반 R-series로 옮겨 범용성과 공급 유연성을 높였다. 3세대는 2025년 1만 장 cluster를 먼저 가동하고 같은 해 3만 장 cluster로 확장했다는 deployment evidence가 있다. 그러나 3세대 chip의 compute, memory, interconnect 상세는 Google TPU나 AWS Trainium보다 훨씬 적게 공개됐다.
따라서 Baidu를 평가할 때는 세대별 peak TOPS보다 세 가지가 중요하다. 첫째, PaddlePaddle과 ERNIE가 XPU에 얼마나 자연스럽게 내려가는가. 둘째, 수만 장 규모 cluster에서 vendor가 발표한 MFU와 training efficiency가 재현되는가. 셋째, Kunlunxin 분사와 별도 상장이 cloud captive volume을 외부 매출로 바꿀 수 있는가다.
Generation map
| Generation | Process and memory | Public compute | Primary role | Deployment evidence |
|---|---|---|---|---|
| FPGA XPU | Programmable FPGA platforms | Workload-specific pipelines | Search, recommendation, NLP, image | More than 10,000 deployed by 2017 |
| Kunlun 1 K100/K200 | Samsung 14 nm, 2.5D, 16 GB HBM on K200 | 256 INT8 TOPS, 150 W on K200 | Datacenter inference and training | Mass production in 2020, about 20,000 units deployed |
| Kunlun 2 R-series | 7 nm, XPU-R, GDDR6 products | Vendor states 2x to 3x core uplift | Cloud inference and broader AI compute | Commercial cloud and server products |
| Kunlun 3 | XPU architecture, details not public | Not sufficiently disclosed | Large-model training and inference | 10,000-chip cluster in early 2025, 30,000-chip cluster later in 2025 |
| M100 and M300 | Details not public | Details not public | Next product roadmap | Announced, not comparable on public specifications |
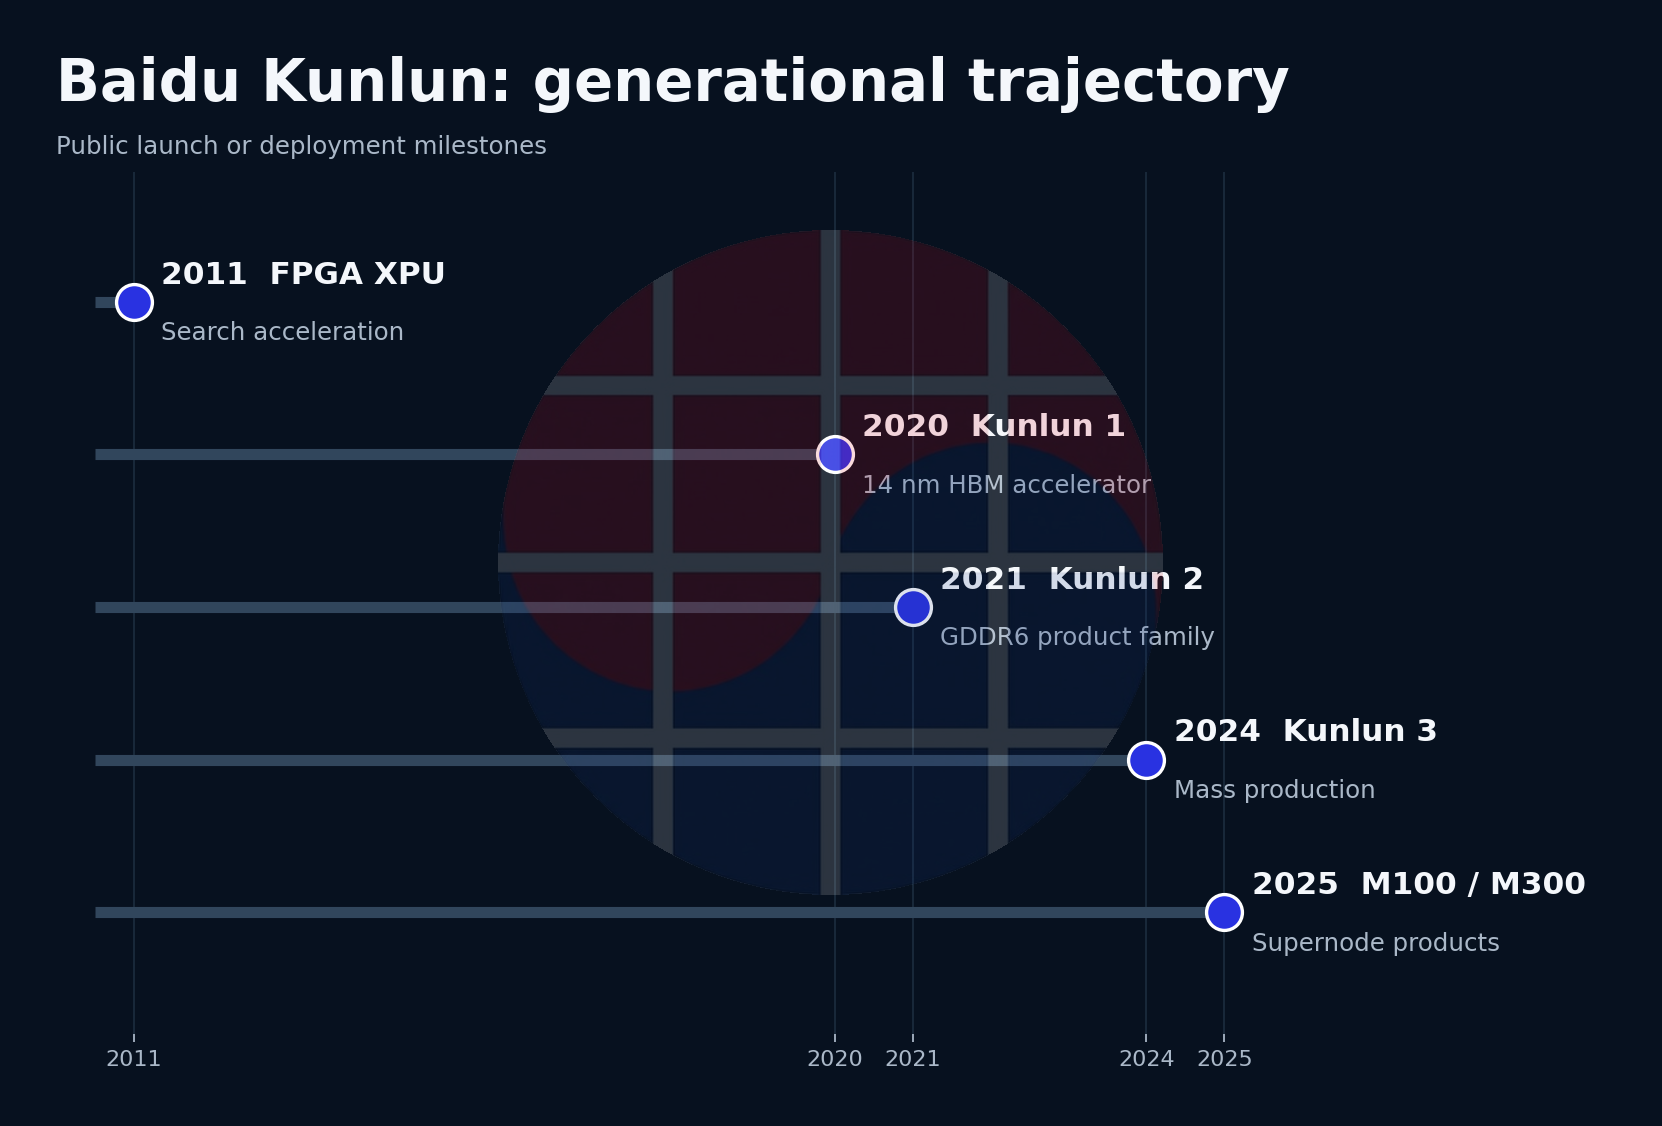
Kunlun 1, Kunlun 2, Kunlun 3의 연도는 Kunlunxin 공식 core technology page의 상용화 이력에 따른다. M100·M300은 Baidu가 공개 행사에서 발표했지만, 본문 기준일 현재 검증 가능한 architecture와 memory spec이 부족하므로 확정 세대 사양으로 채우지 않았다.
FPGA XPU: 첫 세대 이전의 진짜 첫 세대
Baidu는 2010년 FPGA와 software-defined accelerator 연구를 시작했고 2011년 소규모 배치, 2017년 1만 장 이상 배치로 확장했다. FPGA는 ASIC보다 전력과 면적 효율이 낮지만 workload가 바뀔 때 datapath와 operator를 다시 구성할 수 있다. 검색 회사에 중요한 것은 첫 silicon의 peak가 아니라 실제 traffic에서 어떤 operator가 반복되고 어떤 memory access가 병목인지 학습하는 일이다.
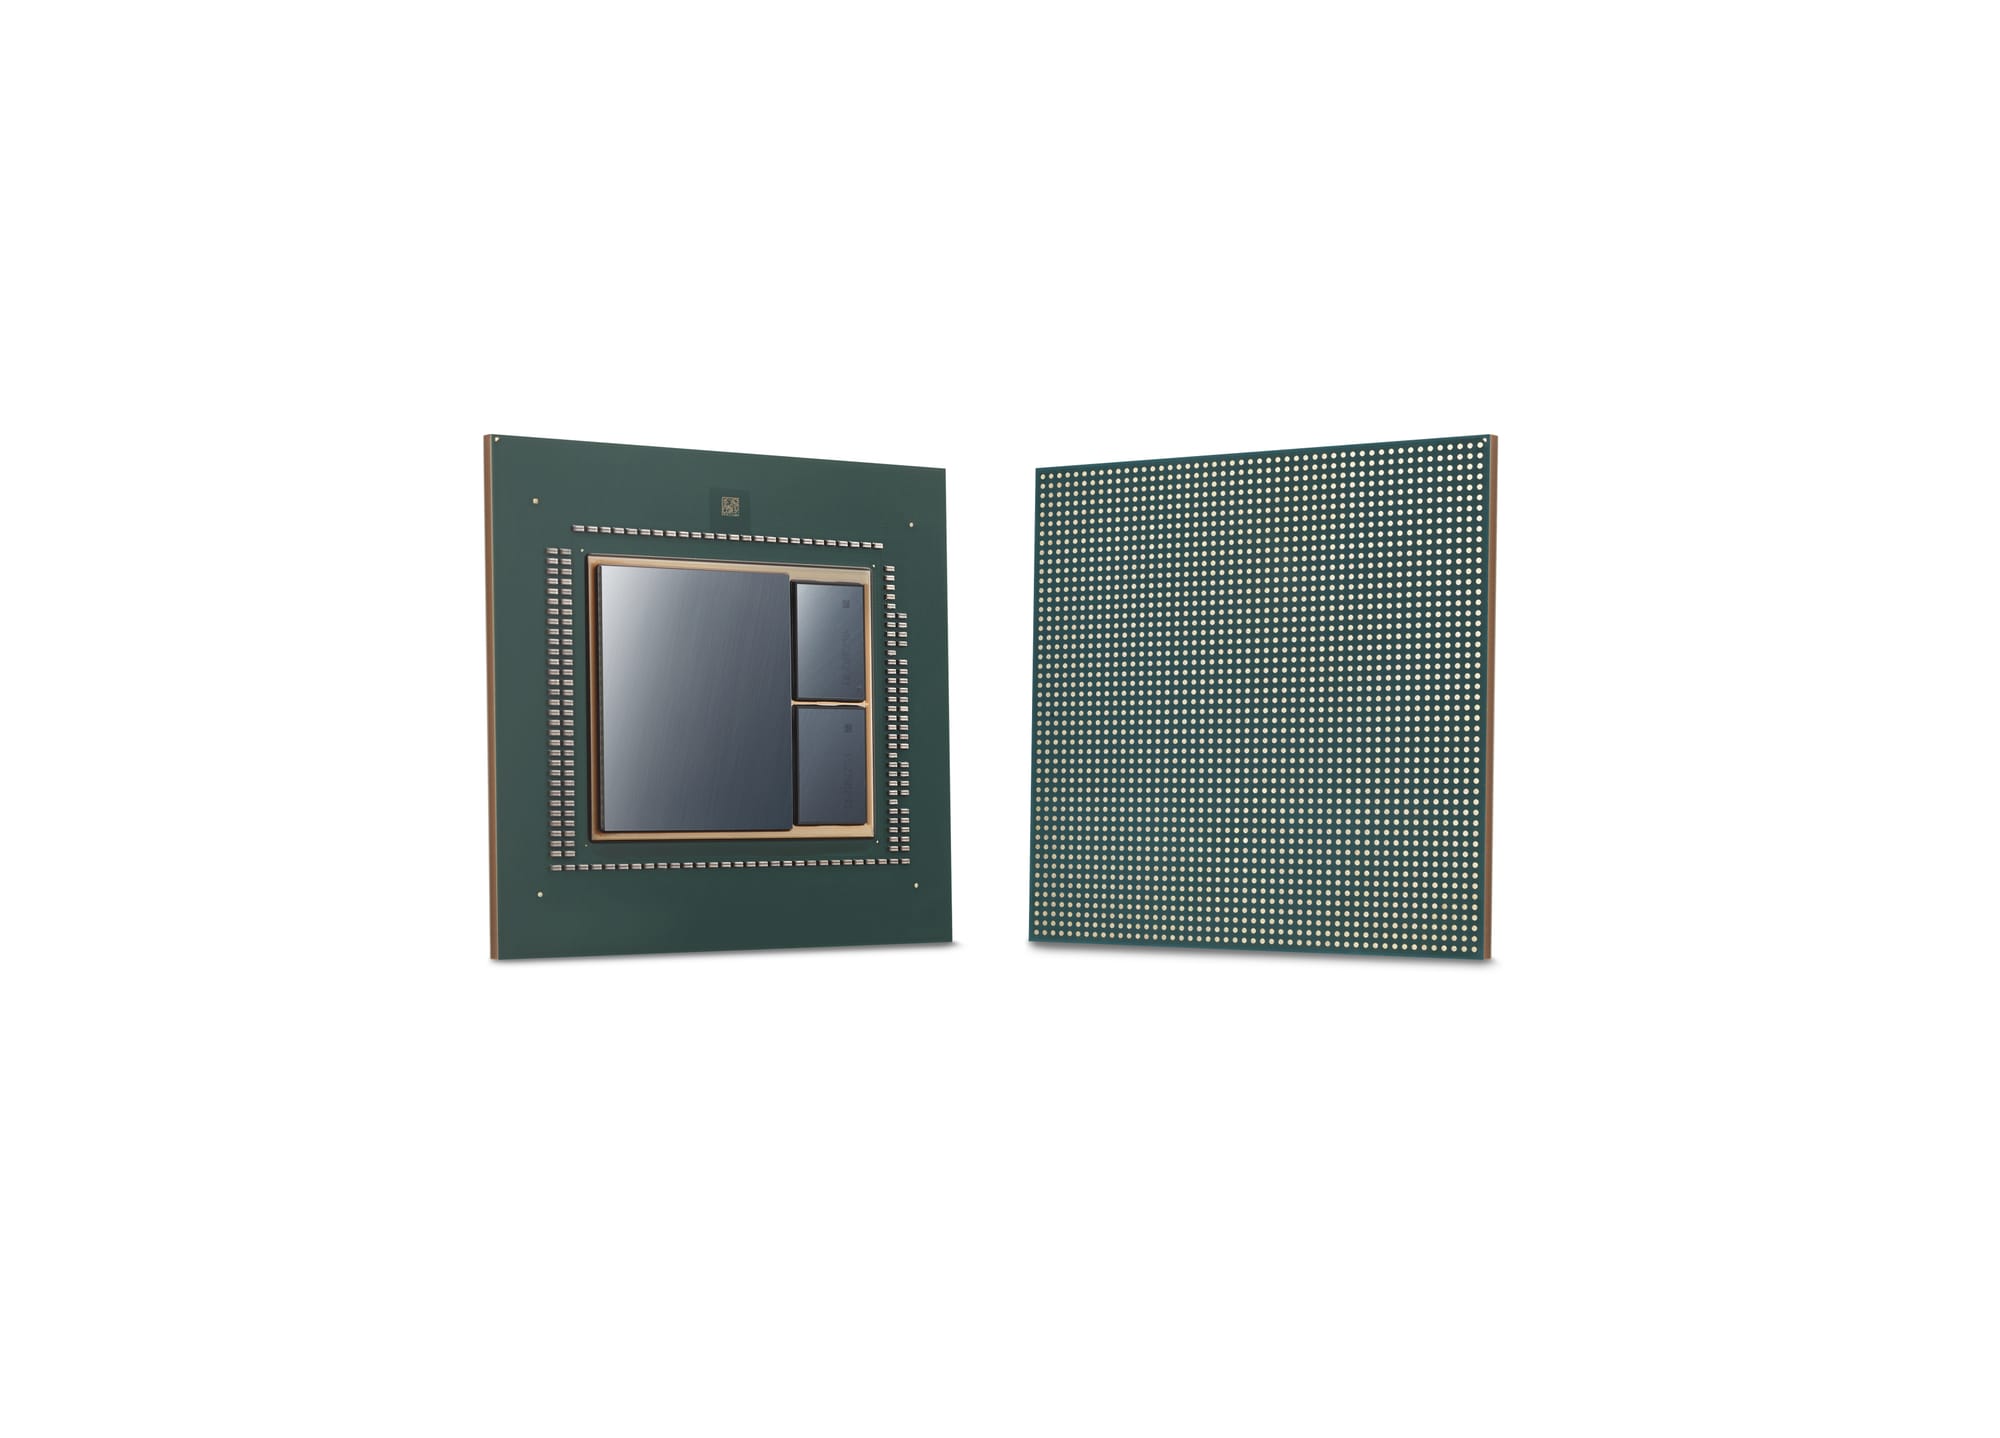
2017년 Hot Chips에 공개한 XPU는 이 경험을 하나의 programmable architecture로 정리했다. XPU의 방향은 CPU처럼 모든 instruction을 빠르게 처리하는 것도, 하나의 convolution만 고정하는 것도 아니다. 작은 programmable core, tensor·vector engine, local memory, software-defined instruction과 scheduling을 결합해 recommendation, image, NLP를 하나의 family로 처리한다.
이 단계의 가장 큰 자산은 FPGA board 수가 아니라 software corpus다. production graph, operator frequency, tensor shape, quantization error, latency tail, compiler failure와 service fallback 데이터가 쌓였다. ASIC 전환에서 가장 위험한 문제는 2년 뒤 model이 달라지는 것인데, Baidu는 programmable XPU layer를 남겨 fixed datapath의 효율과 workload 변화 대응을 절충했다.
Kunlun 1: 14 nm에서도 memory와 workload로 승부
Kunlun 1은 2018년 공개, 2019년 tape-out, 2020년 mass production 흐름을 밟았다. Samsung은 14 nm process와 I-Cube 2.5D package를 공식 발표했다. K200은 16 GB HBM, 512 GB/s, 256 INT8 TOPS, 150 W로 공개됐고 FP16과 FP32도 지원한다. 당시 leading GPU보다 오래된 node를 썼지만 large die와 HBM을 묶어 datacenter inference에 필요한 bandwidth를 확보했다.
Hot Chips 자료의 핵심은 XPU cluster다. command와 scheduling을 맡는 작은 core, tensor·vector data path, distributed local memory를 묶고 software-defined neural network instruction으로 operator를 실행한다. matrix engine만 키우는 방식보다 control과 data movement를 chip 안에서 처리해 host round trip을 줄이는 구조다.
Samsung과 Baidu는 ERNIE inference에서 기존 GPU·FPGA 대비 약 3배 performance를 주장했다. 이 수치는 model version, batch, latency와 상대 장비 구성이 완전히 같아야 비교할 수 있으므로 보편적 우위로 확장하면 안 된다. 더 강한 증거는 2020년까지 약 2만 장이 검색, recommendation, cloud workload에 실제 배치됐다는 Baidu의 발표다. captive workload가 초기 yield와 software maturity가 불완전한 칩을 흡수해 준 셈이다.
Kunlun 1의 architecture trade-off는 분명하다. 14 nm는 wafer cost와 공급 안정성이 좋지만 같은 전력에서 transistor budget이 작다. HBM은 bandwidth를 해결하지만 package cost와 공급을 높인다. Baidu는 가장 자주 쓰는 INT8 inference를 256 TOPS까지 밀고 programmability를 남겨 transistor 효율을 회수했다.
Kunlun 2: HBM에서 GDDR6로, chip에서 product family로
Baidu는 2세대를 7 nm와 1세대 대비 약 3배 performance로 예고했다. Kunlunxin 공식 자료는 XPU-R core가 이전 core보다 2배에서 3배 높은 compute를 제공한다고 설명한다. 공개 제품군은 R100, R200, RG800, R480-X8 등 accelerator card와 multi-card system으로 확장됐다.
2세대의 흥미로운 변화는 GDDR6다. HBM은 높은 bandwidth와 package density를 주지만 interposer, packaging capacity와 원가가 부담이다. GDDR6는 board trace와 전력이 늘지만 더 넓은 공급망, 큰 용량 선택, 낮은 package complexity를 제공한다. 범용 cloud instance와 inference server를 늘리는 단계에서는 chip peak보다 board BOM과 조달 안정성이 중요할 수 있다.
이는 단순 downgrade로 볼 수 없다. recommendation과 일부 inference는 embedding·KV·weight capacity와 request-level parallelism이 중요하고, 모든 workload가 HBM의 극단적인 bandwidth를 요구하지 않는다. 반대로 dense training에서 GDDR6가 병목이 되면 더 많은 card와 communication이 필요해진다. Baidu가 R-series를 general AI로 포지셔닝한 것은 한 architecture를 다양한 cost envelope에 넣으려는 선택이다.
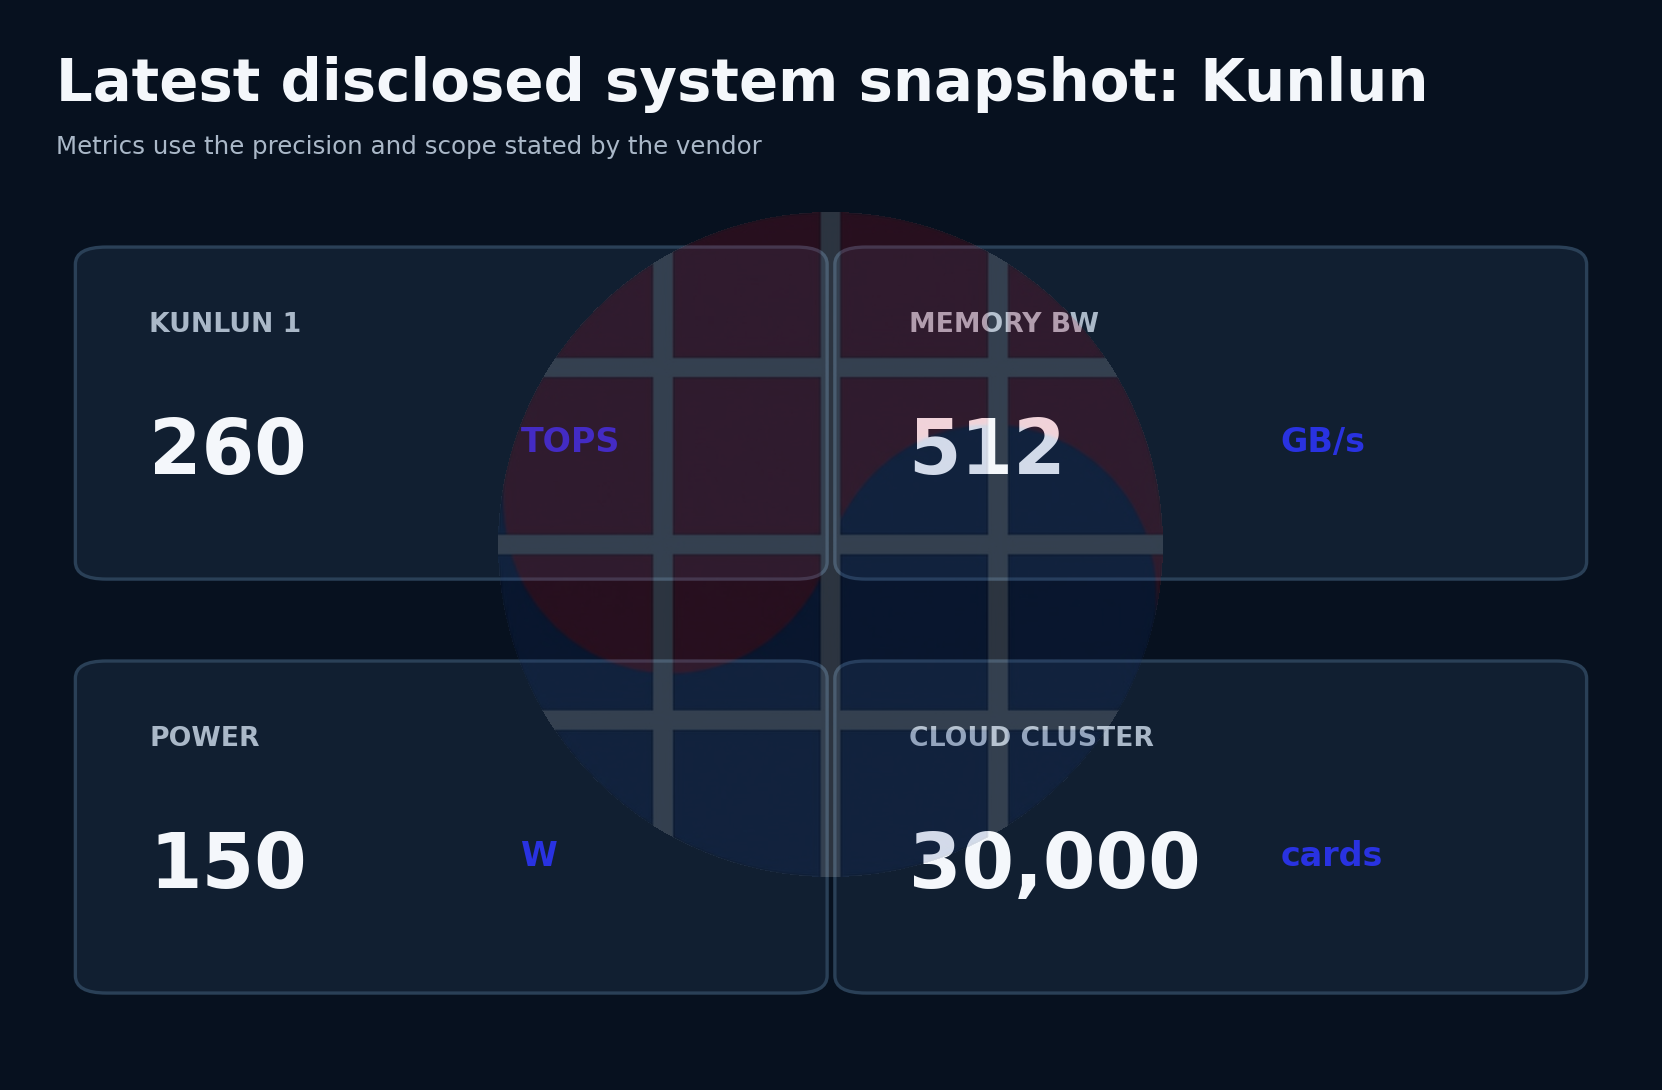
software 쪽에서는 PaddlePaddle graph와 operator가 XPU backend로 이어지고, Baidu AI Cloud가 instance와 cluster scheduling을 제공한다. CUDA code를 그대로 실행하는 것이 아니라 Paddle compiler, XPU SDK, kernel library가 model을 흡수하는 구조다. Baidu 내부 model은 framework와 hardware를 함께 바꿀 수 있지만 외부 고객은 PyTorch compatibility와 debugging tool이 부족하면 전환 비용이 높다.
Kunlun 3: chip spec보다 1만 장과 3만 장 cluster
Kunlunxin은 3세대가 2024년 상용화됐다고 밝힌다. Baidu AI Cloud는 2025년 2월 3세대 Kunlunxin 1만 장 cluster를 가동했고, 이후 3만 장 자체 개발 chip cluster를 공개했다. Tianchi 512 supernode와 더 큰 cluster를 결합해 trillion-parameter model의 full-process training을 목표로 한다.
Baidu가 공개한 1만 장 cluster 지표는 MFU 58%, effective training ratio 98%, bandwidth effectiveness 90%다. 이 숫자는 의미가 있지만 정의를 분리해야 한다. MFU는 theoretical FLOPS 중 model math가 차지한 비율이고, effective training ratio는 job availability나 유효 시간에 가까운 vendor 정의일 수 있으며, bandwidth effectiveness는 topology와 message size에 좌우된다. model, sequence length, precision, parallelism, failure window와 denominator가 공개되지 않으면 다른 cluster와 직접 비교할 수 없다.
그래도 system implication은 크다. 1만 장에서 training job을 유지하려면 collective library, topology-aware placement, checkpoint, failed-device isolation, storage ingestion과 power management가 작동해야 한다. 3만 장은 하나의 flat scale-up domain이라기보다 여러 supernode와 scale-out network, scheduler가 엮인 cluster일 가능성이 높다. 핵심 질문은 총 card 수가 아니라 single job이 몇 장까지 높은 utilization을 유지하고, 장애 후 몇 분 안에 복귀하는가다.
3세대의 chip-level spec은 공식 공개가 제한적이다. process, HBM 또는 GDDR 구성, tensor precision, link bandwidth를 비공식 자료로 메우면 false precision이 생긴다. Baidu가 Google·AWS 수준의 datasheet를 내놓지 않는 사실 자체가 외부 고객의 capacity planning과 independent benchmark를 어렵게 만드는 약점이다.
M100·M300과 Kunlunxin 분사의 의미
Baidu는 M100과 M300을 차세대 제품으로 발표했지만 architecture와 출시 상태를 상세히 공개하지 않았다. 이름이 새로워졌다고 4·5세대의 성능 배율을 가정하면 안 된다. 확인해야 할 것은 실제 board availability, memory type과 capacity, link topology, supported precision, compiler release와 cloud instance다.
2026년 1월 Baidu는 Kunlunxin의 분사와 별도 상장을 제안했다고 공시했다. 독립 법인은 외부 자본과 고객을 얻고 Baidu 외 매출을 키울 수 있다. 동시에 captive workload와 긴밀한 co-design이 약해지고, product roadmap이 외부 고객의 범용 요구와 Baidu 내부 최적화 사이에서 갈릴 수 있다.
분사의 성공 지표는 valuation보다 customer concentration이다. Baidu Cloud 외 고객이 반복 구매하고, Paddle 외 PyTorch workload가 production에 올라가며, board·server partner가 늘어야 독립 accelerator vendor로 인정받을 수 있다. 그렇지 않으면 실질적으로 Baidu의 captive silicon cost center를 별도 법인으로 옮긴 것에 머문다.
Technical reality: 무엇이 실제 moat인가
첫째, workload history다. 검색과 recommendation은 batchable dense compute, latency-sensitive ranking, large embedding lookup이 혼재한다. FPGA부터 얻은 operator trace는 XPU datapath와 compiler scheduling의 근거다.
둘째, PaddlePaddle과 ERNIE다. hardware 팀이 model graph, quantization과 operator를 통제하면 new silicon bring-up 때 가장 경제성이 큰 workload부터 옮길 수 있다. 이는 public cloud 고객이 먼저 porting하기를 기다리는 회사보다 adoption risk가 낮다.
셋째, domestic supply다. 수출 통제 아래 최신 NVIDIA GPU 접근이 불확실하면 절대 성능이 낮아도 안정적으로 확보 가능한 XPU의 option value가 커진다. 다만 process, high-speed memory, package, optical network가 모두 국내에서 충분하다는 뜻은 아니다.
가장 큰 약점은 transparency다. chip spec과 benchmark methodology가 부족하면 고객은 tokens/s, latency, power, failure rate를 자체 proof of concept으로 다시 측정해야 한다. 이는 sales cycle과 switching cost를 높이고 ecosystem 확장을 늦춘다.
Watch points
- Kunlun 3의 process, memory capacity·bandwidth, precision과 link spec이 공식 공개되는가.
- 3만 장 cluster에서 single-job scale, model, MFU 정의, fault rate와 checkpoint overhead가 제시되는가.
- M100·M300이 실제 cloud instance와 server SKU로 출시되는가.
- PyTorch, vLLM과 popular model의 operator coverage가 PaddlePaddle 밖에서도 검증되는가.
- Kunlunxin 분사 이후 Baidu 외 반복 고객과 service revenue가 생기는가.
Contrarian read: 3만 장은 강점이 아니라 chip 효율 부족의 결과일 수 있다
대형 cluster는 engineering capability를 증명하지만 동일한 model을 더 적은 chip으로 처리하는 경쟁사보다 효율적이라는 뜻은 아니다. 낮은 chip compute나 memory bandwidth를 수량으로 보완하면 network, power, cooling, spare inventory와 failure surface가 커진다. vendor MFU가 높아도 rack당 output과 total cost가 낮을 수 있다.
반대로 중국 시장에서 accelerator 공급이 수요를 따라가지 못하고 imported GPU가 제한된다면, 3만 장의 usable capacity 자체가 moat다. Baidu는 검색 traffic과 ERNIE service로 utilization을 내부에서 채울 수 있다. 이 경우 완벽한 chip보다 지금 설치되고 software가 작동하는 cluster가 경제적으로 더 가치 있다.
Korean lens
Baidu 사례는 한국 NPU 기업에 두 가지를 말한다. chip 설계 전에 고객 workload와 compiler trace를 충분히 축적해야 하고, 2세대 이후에는 chip보다 board BOM, memory 선택, cluster software와 고객 전환 비용이 중요하다. 국내 cloud·portal·telecom이 captive workload를 초기 silicon에 제공하지 않으면 fabless만으로 이 학습 곡선을 만들기 어렵다.
한국 공급망에는 HBM만이 답이 아니라는 점도 중요하다. workload와 가격에 따라 GDDR6·GDDR7, CXL memory, advanced package를 조합할 수 있다. 다만 memory를 바꾸면 arithmetic intensity, board power와 collective topology를 다시 설계해야 한다. 부품 선택을 마케팅 숫자가 아니라 output당 비용으로 연결해야 한다.
Sources
- Kunlunxin core technology and generation history
- Samsung and Baidu Kunlun production announcement
- Hot Chips 32 Baidu Kunlun presentation
- Baidu Kunlun second-generation announcement
- Baidu AI Cloud Kunlun solution
- Baidu AI Cloud 10,000-chip cluster announcement
- Baidu AI Cloud 30,000-chip cluster and M100/M300 announcement
- Baidu proposed Kunlunxin spin-off
Disclosure
본 글은 정보 제공만을 목적으로 하며, 특정 증권의 매수 또는 매도를 권유하는 것이 아닙니다. 본 글에 포함된 수치와 사실은 기업 공시, 언론 보도, 시장 조사 등 공개적으로 이용 가능한 자료를 바탕으로 작성되었으며, 해당 자료 또는 작성 과정에서 오류가 발생할 수 있습니다. 필자는 언급된 기업의 주식을 보유하고 있을 수 있습니다. 모든 투자 결정 및 그에 따른 결과는 독자의 책임입니다.