VLSI Korea
Die Shot 분석 ③ NVIDIA GP100·PS5·Micron DRAM: 반복 구조가 만드는 성능과 수율
반복 무늬가 많다고 같은 종류의 칩은 아니다. NVIDIA GP100의 반복 단위는 throughput을 늘리고 일부 단위를 끈 제품도 성립하게 만드는 compute hierarchy이고, PlayStation 5 Oberon의 반복 단위는 게임 workload에 면적을 집중한 GPU array이며, Micron MT4C1024의 반복 단위는 bitline·wordline RC를 제어하면서 저장 밀도를 확보하는 DRAM mat다. 좋은 분석은 이 반복 단위를 architecture, P&R, test와 제품화의 경계에 연결하되.


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
연재: ① Intel 80486·Sandy Bridge로 배우는 Floorplan 판독법 · ② Raptor Lake·AMD Zen 2(Matisse·Rome)·Apple M1 · ③ NVIDIA GP100·PS5·Micron DRAM
핵심 답
반복 무늬가 많다고 같은 종류의 칩은 아니다. NVIDIA GP100의 반복 단위는 throughput을 늘리고 일부 단위를 끈 제품도 성립하게 만드는 compute hierarchy이고, PlayStation 5 Oberon의 반복 단위는 게임 workload에 면적을 집중한 GPU array이며, Micron MT4C1024의 반복 단위는 bitline·wordline RC를 제어하면서 저장 밀도를 확보하는 DRAM mat다.
- 관찰: 사진에서 반복성, 대칭, array의 경계, 주변부 macro와 pad ring을 먼저 찾는다.
- 추론: 반복 단위가 architecture, P&R partition, clock·power control, test와 제품 binning에서 같은 경계로 쓰였을 가능성을 검토한다.
- 한계: optical die shot만으로 exact block boundary, clock tree, power grid, 실제 hotspot, 결함 위치와 수율을 단정하지 않는다.
- 실무 판단: 좋은 floorplan은 기능 블록을 예쁘게 배열한 그림이 아니라 성능 단위, 고장 격리 단위, 배선 단위와 제품화 단위를 가능한 한 맞춘 결과다.
Die shot의 반복 무늬는 면적을 복사한 흔적이 아니다. 설계자가 성능을 늘리고, 배선을 닫고, 불완전한 실리콘도 제품으로 만들기 위해 선택한 물리 계층의 흔적이다.
1. 같은 반복이라도 목적은 다르다: 관찰·추론·한계 프레임
이 글의 분석 단위는 블록 이름 맞히기가 아니라 반복 단위, 물리 계층, 제품 계층의 정렬이다. 같은 모양이 여러 번 나타나면 먼저 무엇이 반복되는지 보고, 그 경계가 배선과 전력 공급, test와 SKU 구성에서도 재사용될 수 있는지 따진다.
첫 단계인 관찰에는 사진 자체에서 확인되는 정보만 넣는다. 일정한 피치의 직사각형, 좌우 대칭, 크기가 같은 타일, die edge를 따라 늘어선 pad 또는 PHY 후보, 규칙적인 array와 불규칙한 logic의 질감 차이가 여기에 속한다.
두 번째 단계인 추론은 물리설계 지식을 사용하되 조건을 붙인다. 반복 타일이 local clock domain이나 P&R partition일 가능성, 큰 array 옆의 가는 띠가 sense amplifier나 decoder일 가능성, 외곽 macro가 memory·I/O interface일 가능성은 합리적이지만 공식 floorplan이나 회로 자료로 교차 검증해야 한다.
세 번째 단계는 주장 금지선을 긋는 일이다. 사진의 색과 밝기는 층 제거 방식, 조명, stitching, backside IR 여부에 따라 달라지므로 색만으로 metal layer나 전압 domain을 지정할 수 없다.
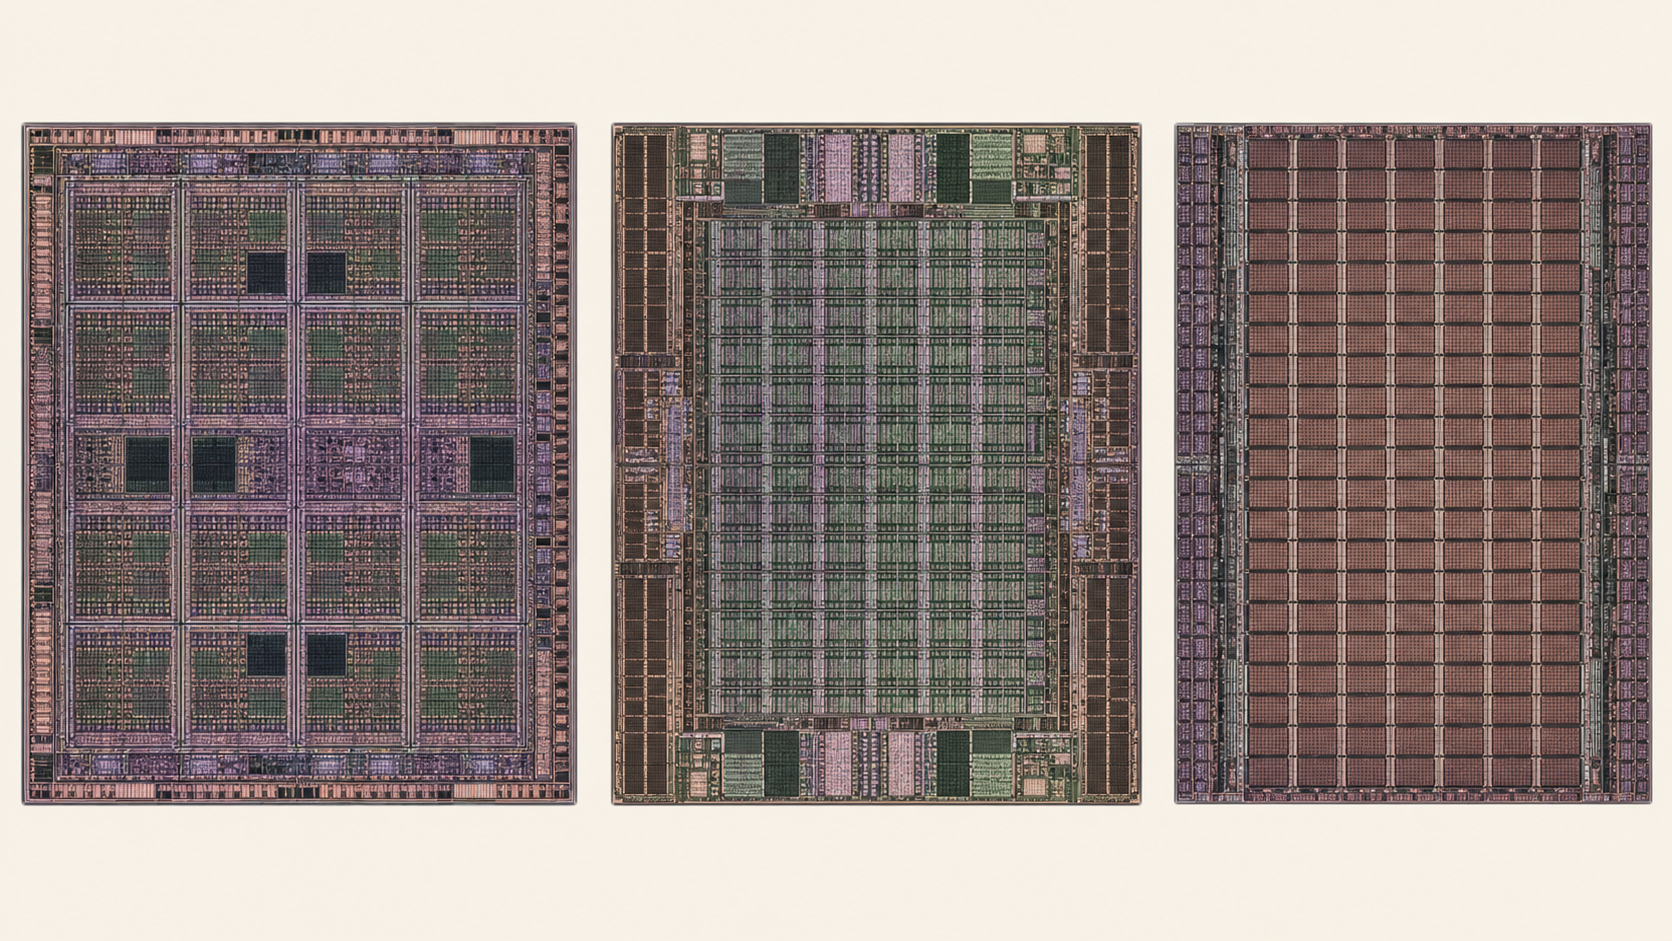
GP100에서는 반복이 compute throughput과 harvesting 가능한 제품 구조로 이어지고, Oberon에서는 콘솔의 고정 workload가 GPU 중심 면적 배분으로 이어진다. MT4C1024에서는 반복이 연산 복제가 아니라 bitline capacitance와 wordline resistance를 제한하면서 cell efficiency를 높이는 방법이다.
이 프레임은 세 가지 독자 업무에 바로 연결된다. PD 엔지니어는 hierarchy 경계를 어디에 둘지 검토할 수 있고, architecture·DFT 엔지니어는 일부 단위가 비활성화된 구성을 지원할 때 fabric·control·test에서 무엇을 검증해야 하는지 요구사항을 만들 수 있으며, package·PI 엔지니어는 die edge의 interface 후보를 package 배선과 함께 볼 수 있다.
결정도 세 가지로 좁혀진다. 반복 unit을 독립 구현할지, 공유 fabric과 memory를 어디에 둘지, 그리고 사진 기반 설명에서 어느 문장까지 사실로 쓰고 어느 문장부터 가설로 표시할지다.
2. NVIDIA GP100: 60개의 SM이 만든 반복 계층

이미지 검증 주의: Commons 파일 설명에는 GP100과 무관한 다른 그래픽 칩 설명이 섞여 있다. 사진의 identity는 업로더 파일명과 메타데이터로 한정하고, architecture와 수치는 NVIDIA GP100 백서와 NVIDIA 공식 설명으로 교차 검증했다.
사진에서 직접 보이는 첫 특징은 die 대부분을 채운 큰 반복 영역이다. 같은 크기의 타일이 여러 단계로 묶여 있고, 그 사이와 중앙에는 타일을 연결하거나 데이터를 분배하는 구조로 해석할 수 있는 비반복 영역이 놓인다.
NVIDIA 공식 백서는 full GP100을 6개의 Graphics Processing Cluster, 30개의 Texture Processing Cluster, 60개의 Streaming Multiprocessor로 설명한다. GP100은 TSMC 16nm FinFET, 153억 transistor, 610mm²의 큰 die이며 full configuration은 3,840개의 FP32 CUDA core를 가진다.
여기서 중요한 것은 숫자보다 hierarchy다. SM을 복제하고, 두 SM을 TPC로 묶고, 다섯 TPC를 GPC로 묶는 논리 계층은 placement와 routing에서도 반복 가능한 작업 단위를 제공한다.
물리설계 관점에서는 local interconnect와 shared resource를 같은 경계 안에 가두는 것이 평균 wirelength와 congestion을 줄이는 데 유리하다. 여러 팀이 같은 타일을 병렬로 구현하고 검증한 뒤 상위 계층에서 조립할 수 있다는 조직적 이점도 생긴다.
다만 사진만 보고 각 사각형을 SM, TPC, cache 또는 memory controller로 정확히 지정할 수는 없다. 공식 백서의 계층 수와 사진의 반복성을 대응시킬 수는 있지만, 공개된 community annotation 없이 exact polygon을 그으면 추론을 사실처럼 보이게 만든다.
반복 구조는 clock과 power에도 질문을 만든다. 각 GPC가 어느 정도 local clock distribution과 power gating을 가질 가능성은 높지만, optical 사진으로 clock spine의 topology, voltage island의 경계, mesh와 tree의 선택을 확인할 수는 없다.
관찰: 유사한 compute 타일이 큰 면적에 계층적으로 반복되고 die 외곽과 중앙에 비반복 구조가 있다.
추론: 반복 hierarchy는 구현 복제, local routing, clock·power control과 test 분할에 유리했을 가능성이 높다.
주장할 수 없음: 사진만으로 exact SM 경계, 실제 congestion hotspot, clock tree와 power grid를 확정할 수 없다.
3. GP100의 60 SM과 Tesla P100의 56 SM: harvesting은 제품 구조다
full GP100에는 60개의 SM이 있지만 NVIDIA가 공개한 Tesla P100 제품은 56개의 SM과 3,584개의 FP32 CUDA core를 사용한다. 물리적으로 존재하는 반복 단위와 판매 제품에서 활성화된 반복 단위가 다르다는 뜻이다.
이 차이를 특정 네 개 SM이 불량이었다는 증거로 읽으면 안 된다. 제조 수율, 주파수 bin, 전력 한도, 제품군 구성과 공급 계획이 모두 unit disable 정책에 영향을 줄 수 있으므로 개별 chip의 disable 이유는 사진으로 알 수 없다.
공개 자료가 확인해 주는 사실은 full design의 60 SM과 Tesla P100의 56 active SM 구성이다. Address mapping, scheduler, firmware, clock control, power isolation과 DFT가 이를 정확히 어떻게 지원하는지는 공개 자료에서 확인되지 않으므로, 이 항목들은 GP100의 확정 구현이 아니라 unit-disable 제품을 검토할 때의 공학적 요구사항으로 다뤄야 한다.
큰 die에서는 random defect 하나가 전체 chip 폐기로 이어지지 않도록 실패 단위를 작게 만드는 것이 경제적으로 중요하다. SM 또는 상위 cluster가 독립적으로 test되고 격리될 수 있다면 usable die의 범위를 넓힐 수 있지만, 그 대가로 fuse 관리와 검증 상태 수가 늘어난다.
이것은 SRAM의 spare row·column처럼 동일 위치를 치환하는 물리적 repair와는 다르다. GP100의 방식은 일부 compute capacity가 줄어든 구성을 architecture와 product specification이 받아들이는 harvesting에 가깝다.
GP100의 floorplan은 package와 함께 봐야 완성된다. NVIDIA 자료는 네 개의 HBM2 stack과 여덟 개의 512-bit memory controller, 총 4,096-bit interface를 설명하며, 이는 좁고 매우 빠른 SerDes 몇 lane과 다른 die-edge·interposer 문제를 만든다.
넓은 interface는 많은 신호를 짧고 규칙적으로 interposer에 내보내는 배치가 중요하다. 그러나 bare die 사진만으로 어떤 edge가 어느 HBM stack을 향하는지, bump map이 어떻게 분할됐는지, channel별 skew budget이 얼마인지 계산할 수는 없다.
일반적인 unit-disable 설계에는 공유 fabric과 memory path의 정확성, clock·power control, test coverage를 확인하는 검토가 필요하다. 이는 합리적인 설계 요구사항이지만 공개된 GP100 문서가 address mapping, firmware 또는 power isolation의 구체적 구현을 확인해 주는 것은 아니다.
4. PlayStation 5 Oberon: workload가 면적 배분표가 된 SoC

Oberon 사진도 큰 반복 영역과 상대적으로 작은 비반복 영역의 대비가 먼저 보인다. community die map을 보지 않고도 전체 면적의 상당 부분이 유사한 compute tile로 채워졌다는 관찰까지는 가능하다.
Sony의 공식 PlayStation 5 사양은 8-core AMD Zen 2 CPU, AMD RDNA 2 기반 GPU, 최대 2.23GHz와 10.3TFLOPS, 16GB GDDR6와 448GB/s memory bandwidth를 제시한다. 이 사양은 사진의 큰 반복 영역을 GPU 중심으로 해석할 근거를 주지만 각 polygon의 정확한 이름을 제공하지는 않는다.
콘솔 SoC의 floorplan은 범용 desktop CPU의 균형과 다르다. 게임 rendering과 graphics compute가 제품의 주 workload이고 CPU core 수, media engine, display, security, storage I/O가 정해진 platform 안에서 함께 움직이므로 GPU에 큰 면적을 쓰는 선택이 합리적이다.
여기서 면적 비율은 architecture 우선순위의 물리적 예산표가 된다. 더 많은 CPU core를 넣으면 GPU tile, cache, I/O 또는 routing channel에 쓸 면적이 줄고, 반대로 GPU를 키우면 power density와 memory bandwidth 요구가 함께 커진다.
GP100과 Oberon은 둘 다 compute tile이 반복되지만 제품 경계가 다르다. GP100은 HBM2와 interposer를 포함한 accelerator module을 전제로 하고, Oberon은 CPU·GPU·media·I/O를 한 SoC에 묶어 GDDR6가 달린 console board에서 동작한다.
이 차이는 die edge를 읽는 방법도 바꾼다. 공식 memory interface와 board 구조를 보면 GDDR6 PHY와 I/O가 die 외곽 배치를 강하게 제약했을 것으로 추론할 수 있지만, decapped die 사진만으로 각 PHY lane의 위치와 package escape routing을 지정할 수 없다.
열 분포도 같은 원칙으로 다룬다. 넓은 GPU 영역이 workload 시 hotspot 후보가 될 수 있다는 가설은 세울 수 있지만, 실제 온도는 clock, voltage, activity, cooling solution과 workload phase에 따라 달라지므로 면적 사진은 thermal map이 아니다.
PS5의 고정 platform은 co-design의 장점도 만든다. OS와 game API, memory 용량, storage architecture, cooling envelope를 제품 수명 동안 함께 최적화할 수 있어 범용 SoC보다 workload에 맞춘 면적 배분이 가능하다.
관찰: 큰 반복 compute 영역과 여러 크기의 주변 logic·I/O 후보 영역이 비대칭적으로 공존한다.
추론: 공식 RDNA 2 GPU·memory 사양과 console workload를 함께 보면 GPU 중심 floorplan과 memory bandwidth 중심의 edge planning이 합리적이다.
주장할 수 없음: 사진만으로 각 CPU complex, GPU compute unit, cache, media block, PHY 경계와 실제 hotspot을 확정할 수 없다.
5. Micron MT4C1024 DRAM: cell보다 bitline RC가 floorplan을 정한다

MT4C1024 사진은 logic SoC와 전혀 다른 면적 경제를 보여준다. Commons 메타데이터는 이 chip을 1989년 Micron 1Mbit DRAM으로 설명하고 die 크기를 약 8,662×3,969µm로 기록한다.
사진에서 직접 보이는 것은 die 대부분을 차지하는 규칙적인 직사각형 array와 그 사이의 좁은 경계, 주변부의 불규칙 logic과 pad다. 이 반복 영역을 memory mat로 해석할 수 있지만 각 mat의 정확한 row·column 수와 spare 구조는 회로도나 reverse-engineering annotation 없이는 확정할 수 없다.
DRAM cell은 capacitor에 저장된 작은 전하 차이를 bitline과 sense amplifier가 읽는 구조다. bitline이 길어져 많은 cell이 매달리면 capacitance가 커지고 작은 전압 변화를 감지하는 시간과 에너지가 늘어난다.
wordline도 공짜가 아니다. 긴 wordline은 resistance와 capacitance가 커져 먼 cell까지 신호가 도달하는 delay와 edge quality를 악화시키므로 array를 여러 mat 또는 subarray로 나누고 local driver와 sense circuitry를 배치해야 한다.
mat를 작게 나누면 bitline과 wordline의 RC는 줄고 access 동작을 local하게 만들 수 있다. 반대로 sense amplifier, decoder, driver와 routing overhead가 반복돼 cell area efficiency가 떨어지므로 floorplan은 latency·energy와 density 사이에서 균형을 찾는다.
그래서 DRAM 사진의 넓고 균일한 영역은 비어 있는 공간이 아니다. bit density를 만드는 핵심 제품 면적이며, 가는 경계와 주변 logic은 그 density를 실제 timing과 signal margin 안에서 읽고 쓰게 만드는 비용이다.
logic die에서는 irregular standard-cell region이 많은 기능을 담은 것처럼 보일 수 있지만 DRAM에서는 규칙성이 곧 제품 가치다. 작은 변화가 수백만 cell에 복제되므로 cell pitch, mat aspect ratio와 peripheral overhead의 몇 퍼센트 차이가 die size와 wafer cost에 직접 연결된다.
DRAM의 반복 구조도 수율과 연결되지만 GP100과 방식이 다르다. memory는 일반적으로 spare row·column과 repair mechanism을 활용할 수 있으나, 이 사진만 보고 MT4C1024의 실제 redundancy 수, fuse 위치, 불량 cell 분포를 말할 수는 없다.
현대 DRAM paper가 설명하는 subarray·sense-amplifier trade-off를 1989년 chip에 그대로 투영하는 것도 주의해야 한다. 기본적인 bitline RC와 array subdivision 원리는 유효하지만 bank hierarchy, timing parameter, cell 구조와 process integration은 세대마다 달라진다.
관찰: die 면적 대부분을 규칙적인 memory array가 차지하고 array 사이와 주변부에 좁은 비반복 구조가 있다.
추론: mat 분할은 bitline·wordline RC, sense margin, decoder overhead와 cell efficiency 사이의 절충을 반영한다.
주장할 수 없음: 사진만으로 exact cell count per mat, sense amplifier 배치, spare row·column 수, timing과 불량 분포를 확정할 수 없다.
6. 세 칩을 한 표로 비교하면 성능과 수율의 비용이 보인다
| 판독 질문 | NVIDIA GP100 | PS5 Oberon | Micron MT4C1024 |
|---|---|---|---|
| 지배적 반복 단위 | SM·TPC·GPC compute hierarchy | RDNA 2 GPU compute array | DRAM cell array와 mat |
| 성능을 늘리는 방식 | 병렬 compute unit 복제와 HBM2 bandwidth | console graphics workload에 GPU 면적 집중 | 많은 bit를 작은 cell pitch로 집적 |
| 물리 계층의 목적 | local implementation, routing, control과 unit disable | CPU·GPU·media·I/O의 고정 platform 균형 | bitline·wordline RC 제한과 sensing locality |
| 수율 대응의 형태 | 활성 SM 수를 줄인 판매 구성이 가능 | 공개 사진만으로 disable·repair 정책 판단 불가 | 일반적 row·column repair 원리는 있으나 이 chip의 상세는 판단 불가 |
| package가 주는 제약 | 네 HBM2 stack과 4,096-bit interface, interposer | 16GB GDDR6, 448GB/s board memory와 console cooling | 외부 address·data·control pin과 refresh 동작 |
| 사진만으로 못 보는 것 | clock·PDN·bump map·실제 결함 | exact block map·PHY lane·thermal map | cell schematic·timing·spare map·defect map |
세 chip을 묶는 메커니즘은 성능을 만드는 단위와 물리적으로 격리할 단위를 맞춘다는 것이다. GP100은 compute tile을 반복해 throughput과 SKU 유연성을 얻고, Oberon은 제품 workload에 맞춘 면적 비율로 system performance를 얻으며, DRAM은 mat 경계로 RC와 density를 동시에 관리한다.
반복 단위가 너무 크면 한 곳의 timing·power·defect 문제가 넓은 영역을 무효화한다. 너무 작으면 상위 interconnect, clock, test, decoder와 control overhead가 늘어 면적과 전력을 잃는다.
따라서 좋은 hierarchy는 가장 보기 좋은 사각형 크기가 아니라 반복 이익과 경계 비용이 만나는 지점이다. 이 지점은 logic에서는 wirelength·congestion·clock·power gating으로, DRAM에서는 bitline RC·sense amplifier overhead·cell efficiency로 나타난다.
수율도 die 면적 하나로 설명되지 않는다. defect density와 die size가 같아도 어느 기능이 독립적으로 test·disable·repair될 수 있는지, 제품 specification이 줄어든 capacity를 허용하는지에 따라 판매 가능한 die의 범위가 달라진다.
package를 빼면 비교가 불완전해진다. GP100의 HBM2, Oberon의 GDDR6, DRAM의 pin interface는 모두 die edge와 내부 data path를 제약하며, die shot에서 보이는 외곽 macro는 package 자료와 함께 볼 때만 의미가 선명해진다.
7. 재사용 가능한 Die Shot 분석 체크리스트
다음 체크리스트는 CPU, GPU, accelerator, memory와 mixed-signal SoC에 공통으로 쓸 수 있다. 각 항목에서 관찰 문장 하나, 추론 문장 하나, 주장 금지 문장 하나를 기록하면 과도한 block guessing을 줄일 수 있다.
- Identity와 provenance: chip marking, package, uploader 메타데이터, 촬영자와 원본 URL을 확인한다. 같은 제품명이라도 stepping과 die revision이 다를 수 있으므로 공식 사양은 사진의 revision과 분리해 적는다.
- 이미지 생성 방식: optical frontside, backside IR, polysilicon 노출, metal 제거, stitching 여부를 기록한다. 처리 방식이 다르면 같은 block도 색과 질감이 달라진다.
- Scale과 orientation: die 크기, 사진의 회전·mirror 여부, scale bar의 존재를 확인한다. scale이 없으면 면적 비율은 말할 수 있어도 절대 길이와 pitch를 계산하지 않는다.
- 반복 단위: 가장 작은 반복 타일과 그것을 묶는 상위 반복을 찾는다. 타일 수를 공식 core·CU·SM·mat 수와 대조하되 숫자가 맞는다는 이유만으로 exact boundary를 확정하지 않는다.
- Array와 logic의 경계: 규칙적인 memory·ROM·register array 후보와 불규칙한 control logic 후보를 나눈다. array 종류는 주변 decoder, 공식 cache 용량과 architecture 문서가 있어야 구체화한다.
- 중앙 fabric과 공유 자원: 반복 tile 사이의 비반복 영역이 interconnect, shared cache, scheduler 또는 distribution network일 가능성을 검토한다. 사진만으로 protocol과 bandwidth를 계산하지 않는다.
- Die edge와 package: pad ring, PHY, memory controller, analog macro 후보를 찾고 package ball map, interposer, memory 배치와 연결한다. edge 모양만으로 lane assignment와 signal integrity를 단정하지 않는다.
- 대칭과 비대칭: mirror 배치, 빈 자리, 크기가 다른 tile과 반복에서 벗어난 영역을 표시한다. 이것이 clock·power 균형, 제품 specialization 또는 disabled unit을 뜻할 수 있지만 원인은 별도 자료로 확인한다.
- 성능 단위와 고장 단위: 어느 block이 독립적으로 test, clock gate, power gate, disable 또는 repair될 수 있는지 질문한다. 공개 fuse map이 없으면 가능성으로만 기록한다.
- 배선과 전력 가설: long global route가 필요한 경계, 높은 activity가 예상되는 영역, macro channel을 표시한다. congestion, IR drop과 hotspot은 signoff report나 측정 자료가 없으면 후보 위치로만 부른다.
- 세 단계 증거표: 사진에서 직접 보이는 것, 공식 문서로 확인한 것, 두 자료를 결합한 공학적 추론을 서로 다른 열에 쓴다. community annotation은 유용하지만 제조사 공식 floorplan과 같은 권위를 부여하지 않는다.
- 권리와 수정 이력: CC0, Public Domain, CC BY, newsroom 조건을 확인하고 저작자·원본·라이선스·수정 여부를 표시한다. 이미지 사용 권리와 chip 상표, 제조사의 endorsement는 별개의 문제다.
분석을 중단해야 하는 조건도 정해 둔다. 사진 identity가 불명확하거나, 서로 다른 revision 사진이 섞였거나, community label과 공식 unit 수가 충돌하면 block 이름을 늘리는 대신 불확실성을 먼저 공개한다.
이 글의 thesis를 깨는 자료는 명확하다. 공식 floorplan이나 high-resolution cross-section이 여기서 제시한 hierarchy 해석과 다른 block boundary를 보여주거나, 제품 disable 정책이 yield·binning과 무관하다는 제조사 자료가 나오면 해당 추론을 수정해야 한다.
다음 관찰 대상도 남는다. GP100 package의 HBM channel 배치와 bump map 자료, Oberon revision별 die 비교, 세대가 다른 DRAM의 mat aspect ratio와 peripheral overhead를 같은 기준으로 비교하면 이 프레임의 적용 범위를 더 정확히 알 수 있다.
연재 전체를 다시 볼 때는 1부의 logic·cache·ring 판독법과 2부 Raptor Lake·AMD Zen 2(Matisse·Rome)·Apple M1을 함께 사용하면 된다. 세 편의 공통 결론은 사진을 많이 맞히는 사람이 아니라 증거의 경계를 지키는 사람이 더 좋은 die-shot 분석을 한다는 것이다.
Sources
- NVIDIA, Pascal Architecture Whitepaper: GP100 process, die size, transistor count, GPC·TPC·SM hierarchy와 HBM2 interface.
- NVIDIA Developer Blog, Inside Pascal: Tesla P100의 active SM과 CUDA core 구성.
- NVIDIA Pascal Tuning Guide: Pascal compute hierarchy와 programming 관점의 공식 설명.
- Sony Interactive Entertainment, PlayStation 5 launch specifications: CPU, RDNA 2 GPU, GDDR6 용량과 bandwidth.
- Wikimedia Commons, NVIDIA GP100 die shot: 이미지 원본, 촬영자와 CC0 조건. 설명문 오류 때문에 기술 사양 출처로는 사용하지 않았다.
- Wikimedia Commons, PlayStation 5 Oberon die shot: 이미지 원본, 촬영자와 CC0 조건.
- Wikimedia Commons, Micron MT4C1024 die shot: model identity, die 치수, ZeptoBars와 CC BY 3.0 조건.
- Chang et al., “Low-Cost Inter-Linked Subarrays (LISA): Enabling Fast Inter-Subarray Data Movement in DRAM”, Carnegie Mellon University·Georgia Institute of Technology: DRAM subarray, bitline과 sense-amplifier locality의 기술 배경.
작성 고지: 이 글은 공개된 제조사 문서, 연구 논문과 라이선스가 확인된 die-shot 메타데이터를 바탕으로 AI 보조를 받아 작성했으며 VLSI Korea가 수치, 링크와 관찰·추론의 경계를 검수했습니다.
AI가 만든 비교 개념도는 실제 제조사 floorplan이나 signoff 결과가 아닙니다. Die-shot 사진은 원본 라이선스에 따라 attribution했으며 Micron 이미지의 실제 resize는 해당 caption에 명시했습니다.
VLSI Korea는 저자의 고용주와 독립적으로 운영됩니다. 자세한 원칙은 Editorial Standards에서 확인할 수 있습니다.
관련 글