 VLSI Korea
HBM 8단 vs 12단 vs 16단: 단수가 높을수록 누가 돈을 버는가
HBM 8단 vs 12단 vs 16단 — 단수는 스펙이 아니라 가격표다. 누적 수율은 KGD 98% 기준 8단 85%→12단 79%→16단 72%로 떨어지고, 박형화(약 30µm)·본딩 전환·리워크 불가가 병목이다. 먼저 만드는 회사가 프리미엄을 독점하고, 8단으로 더 많은 GPU를 찍는 선택도 있다. 누가 돈을 버는지, 단계별 킬러 병목을 정리했다.


TL;DR: HBM 단수는 단순한 스펙 숫자가 아니라 돈의 흐름이다. 12단에서 16단으로 한 단계를 올리는 데 DRAM 다이 수율·박형화·본딩·테스트 전 공정이 동시에 걸리고, 누적 수율은 KGD 98% 기준으로 8단 85% → 12단 79% → 16단 72%로 떨어진다. 그래서 고단수는 먼저 만드는 회사가 프리미엄을 독점하고(SK하이닉스의 2026년 상반기 HBM 점유율 절반), 저단수는 더 많은 GPU를 찍어내는 NVIDIA와 클라우드, 그리고 8단에서 수율을 맞추는 중국 후발주자에게 유리하다. 핵심 병목은 박형화 한계(약 30µm)와 본딩 방식 전환(hybrid bonding), 그리고 스택 후 리워크 불가라는 세 가지다.
왜 단수를 높이나 — 인터포저 면적은 고정돼 있다
AI 가속기의 패키지 면적은 사실상 고정이다. GPU 다이 옆에 놓을 수 있는 HBM 사이트 수는 물리적으로 정해져 있고(예: Vera Rubin은 HBM4 8 sites), 인터포저를 키우면 수율과 비용이 동시에 깨진다. 면적이 고정된 이상, 용량과 대역폭을 늘리는 유일한 방법은 위로 쌓는 것뿐이다.
숫자로 보면 명쾌하다. HBM3E 12단 스택은 1024-bit 인터페이스에 9.6Gbps로 스택당 약 1.2TB/s, 36GB다. HBM4는 인터페이스가 2048-bit로 두 배가 되면서 12단 스택당 36GB, 스택당 2TB/s 이상을 낸다. 같은 8개 사이트라도 세대만 바뀌면 용량·대역폭이 통째로 뛴다. 16단 HBM4는 32Gb 다이를 써서 스택당 48GB까지 간다(SK하이닉스가 CES 2026에서 공개한 제품). 즉 단수는 "같은 면적에서 얼마나 많은 메모리와 대역폭을 뽑아내는가"의 밀도 게임이다.
시스템 TCO 관점에서도 단수가 높을수록 유리하다. GPU 한 패키지에 더 많은 용량을 넣으면 같은 모델을 더 적은 수의 GPU로 서빙할 수 있고, GPU 간 통신(NVLink·스케일업 패브릭) 오버헤드가 줄어든다. 추론 시대에 토큰당 비용을 낮추는 가장 확실한 지렛대 중 하나가 HBM 단수인 이유다.
단수별 필요 기술 — 8단, 12단, 16단은 완전히 다른 공정이다
8단 — 성숙의 영역. DRAM 다이 두께에 여유가 있고, 기존 TC(thermo-compression) 본딩과 NCF(non-conductive film) 공정으로 안정적으로 찍힌다. HBM3E 8단은 24GB로 Blackwell 세대의 주력이었고, 지금도 수율·원가 면에서 가장 편한 구간이다. 기술적 허들은 낮지만, 대신 용량 밀도 경쟁에서는 밀린다.
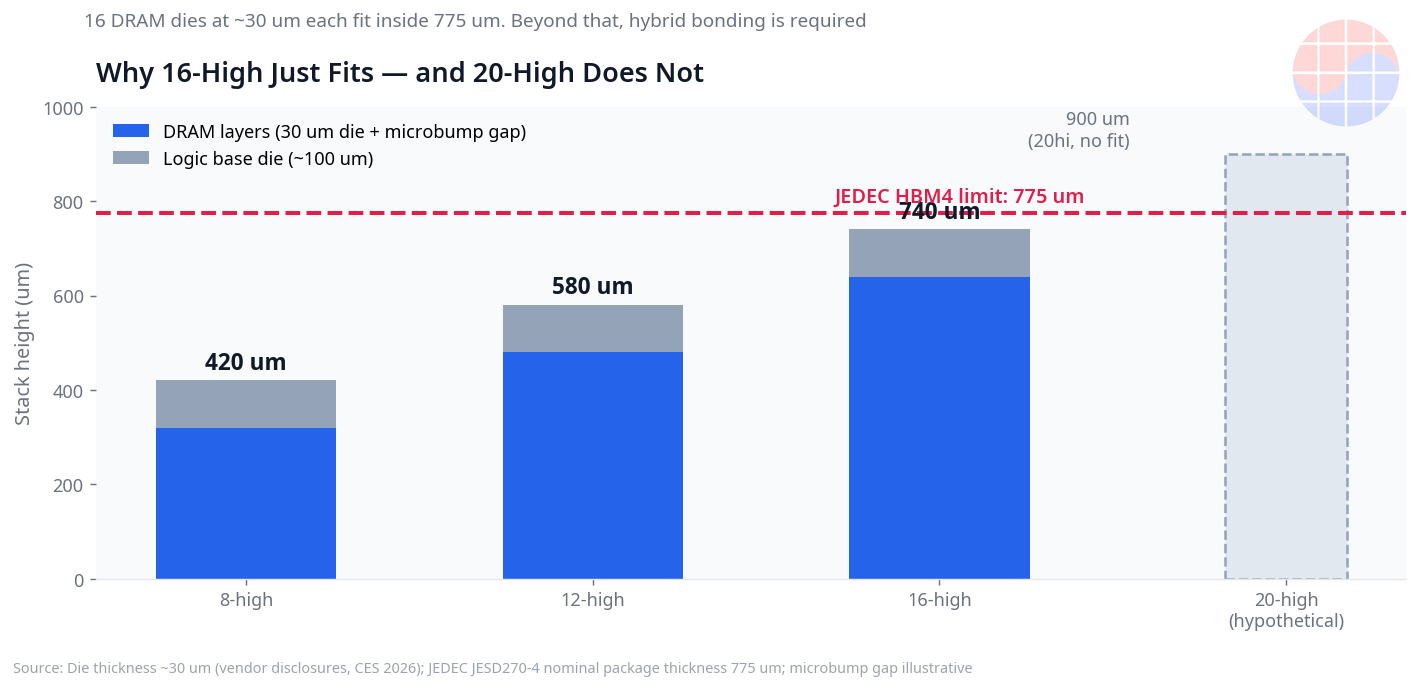
12단 — 현재의 주전장. JEDEC JESD270-4(HBM4 표준, 2025년 4월)는 12단과 16단 모두 패키지 높이를 775µm로 잡았다. 12단을 이 안에 넣으려면 DRAM 다이를 약 30µm까지 박형화하고 TSV(through-silicon via) 형성·박형 웨이퍼 핸들링·워피지(warpage) 제어가 전부 한 단계씩 올라간다. SK하이닉스는 Advanced MR-MUF(mass reflow molded underfill)로 12단 HBM4를 2026년 6월 말부터 NVIDIA에 양산 출하했고, 삼성전자는 2026년 2월 12일 HBM4 양산을 발표했다(4nm 로직 베이스 다이, 12단, 3.3TB/s). 베이스 다이도 DRAM 공정이 아니라 TSMC의 로직 공정(3nm·4nm급)으로 만드는 것이 표준이 됐다. 마이크론 역시 2026년 3월부터 HBM4를 출하 중이다.
16단 — 박형화의 한계 구간. JEDEC이 775µm를 유지해준 덕분에 기존 본딩 기술로도 16단을 만들 여지가 생겼다. SK하이닉스는 CES 2026에서 DRAM 웨이퍼를 약 30µm로 얇게 만들어 16단을 775µm 안에 넣은 48GB HBM4를 공개했다. 하지만 16단에서는 다이 핸들링 파손, 스택 워피지, 방열이 동시에 임계점에 닿는다. 삼성전자는 한 발 더 나아가 마이크로범프 없는 bumpless hybrid bonding으로 16단을 노리고 있고, SK하이닉스는 Advanced MR-MUF 고도화로 맞서는 구도다. 2026년 10월 현재 hybrid bonding으로 양산된 HBM 제품은 아직 없다.
왜 비쌀 수밖에 없나 — 누적 수율의 수학
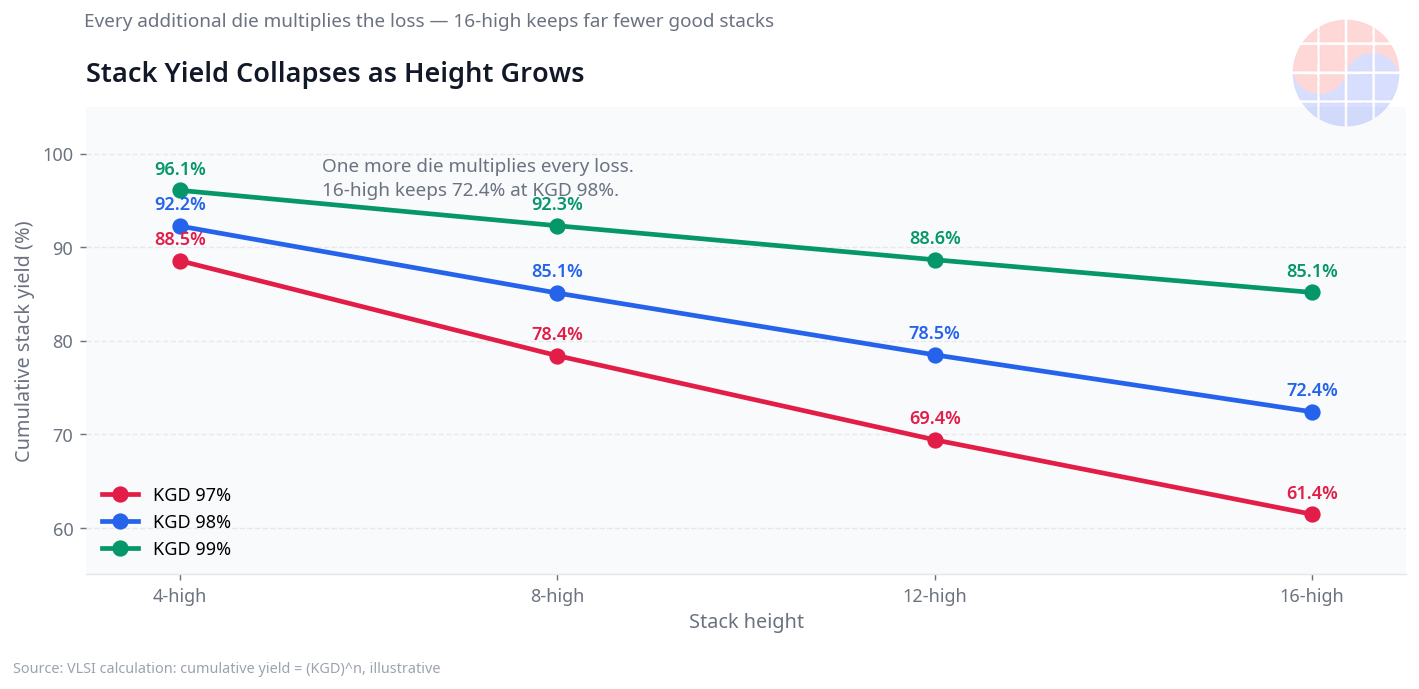
HBM 가격의 본질은 누적 수율이다. 스택 하나에 들어가는 DRAM 다이 N개가 각각 양품일 확률(KGD 수율)을 p라 하면, 스택 수율은 p^N이다. p=98%를 가정하면 8단은 85%, 12단은 79%, 16단은 72%다. 다이 수율이 1%p만 떨어져도(p=97%) 16단 스택 수율은 62%까지 주저앉는다.
여기에 세 가지가 더해진다. 첫째, 스택 후 리워크 불가 — 16단을 다 쌓고 나서 불량이 발견되면 스택 전체를 버려야 한다. 그래서 스택 전 KGD 테스트가 생명줄이고, 테스트 시간·장비(Advantest·Teradyne 계열) 비용이 단수와 함께 는다. 둘째, 본딩 스텝 증가 — 다이를 한 장씩 올리는 TC 본딩은 단수가 곧 택타임이다. 셋째, 박형화 비용 — 30µm급 박형 웨이퍼는 핸들링·TSV 식각(Lam·TEL 장비)·CMP·계측(KLA·Onto Innovation) 전 단계의 난이도를 올린다.
시장 가격도 이를 반영한다. 업계 추정치로 HBM4의 2027년 가격은 Gb당 약 USD 4.50~4.90 수준으로, HBM3E의 3배에 육박한다. 단수가 오르면 Gb당 가격이 오르는 구조 — 그래서 "단수가 많은 게 같은 가격이면 누구나 많은 걸 쓴다"는 가정 자체가 성립하지 않는다. 같은 가격이 될 수 없는 구조다.
누가 이득인가 — 고단수 편 vs 저단수 편
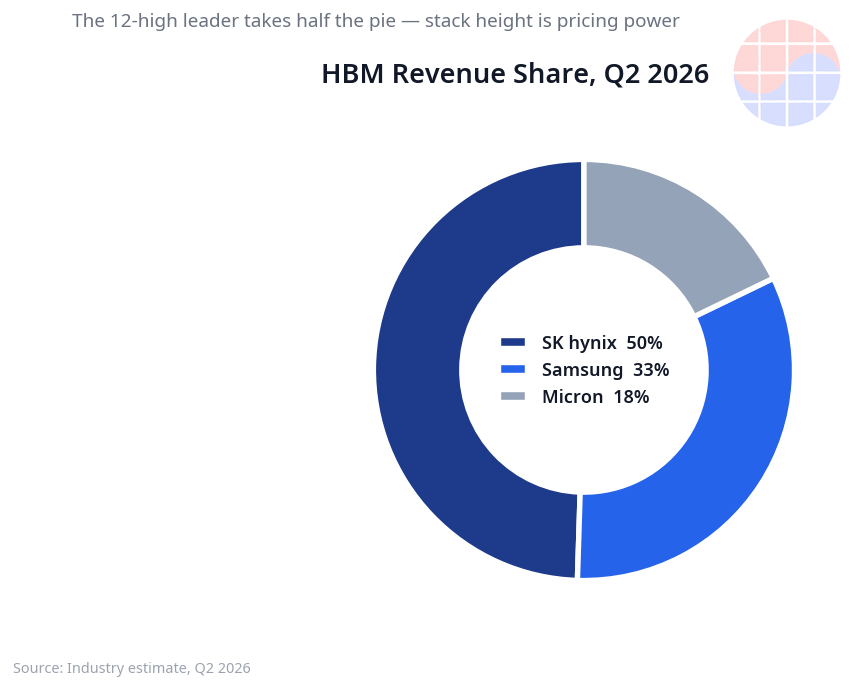
고단수가 유리한 쪽. 먼저 만드는 회사가 프리미엄을 독점한다. 2026년 2분기 HBM 매출 기준으로 SK하이닉스가 약 50%, 삼성전자가 약 33%, 마이크론이 약 18%를 가져간 것으로 추정된다(업계 추정치). 12단 HBM4를 가장 먼저 양산 램프에 올린 SK하이닉스의 리드가 숫자로 드러나는 대목이다.
삼성전자는 hybrid bonding에서 기술 리드를 주장하며 16단 이후의 턴키(메모리+파운드리) 카드로 추격한다. 장비사도 고단수 편이다. TC 본더의 절대 강자인 한미반도체, hybrid bonding 장비의 BESI·Applied Materials·EVG·한화세미텍, TSV 식각·증착의 Lam·TEL, 계측의 KLA·Onto Innovation, 첨단 패키징 OSAT까지 — 단수가 올라갈수록 공정 스텝이 늘어나 장비·소재·패키징 밸류체인이 통째로 수혜를 본다. Applied Materials는 HBM 패키징 전 공정의 4분의 3에 장비를 공급하고, 해당 시장의 60% 이상을 점유한다고 밝힌 바 있다.
저단수가 유리한 쪽. 역설적이게도 가장 큰 수혜자는 NVIDIA와 클라우드다. HBM 웨이퍼와 TSMC 선단 로직 공급량이 고정된 상황에서, 12단 큐브로 다 쓰면 찍을 수 있는 GPU 수가 줄어든다. 8단으로 낮추면 같은 웨이퍼로 약 1.5배 많은 스택을 만들 수 있고, 대역폭은 스택당 동일하게 유지된다(대역폭은 단수가 아니라 인터페이스 폭과 속도가 결정한다). SemiAnalysis의 분석에 따르면 Rubin Ultra의 스펙이 당초안(16단 HBM4E 16스택, 1TB)에서 수정안(8단 HBM4 8스택, 192GB)으로 바뀐 배경에 이런 rationing 논리가 있다. 이에 대해서는 12단 유지를 점치는 반론(시장조사업체 추정치)도 있어, 확정 사실이 아닌 보도·분석 단계로 봐야 한다. 어쨌든 저단수는 "더 많은 가속기를 시장에 푸는" 선택이고, 추론·비용 민감 워크로드와 후발주자에게 유리하다. 중국의 CXMT가 16nm 공정·8단 HBM3로 수율 약 25%에서 양산을 시작하고 HBM3E를 퀄 단계에 올린 것이 대표적이다. 8단은 그들이 유일하게 돈을 맞출 수 있는 구간이다.
병목 총정리 — 단계별로 죽는 지점이 다르다
| 단계 | 킬러 병목 3개 |
|---|---|
| 8단 → 12단 | ① DRAM 다이 30µm급 박형화와 웨이퍼 핸들링 파손 ② TSV aspect ratio 상승에 따른 식각 난이도 ③ 로직 베이스 다이의 TSMC 선단 공정 의존(공급·원가) |
| 12단 → 16단 | ① 누적 수율 급락(KGD 98%→스택 72%)과 스택 후 리워크 불가 ② 16단 스택 워피지·방열(MR-MUF vs hybrid bonding 기로) ③ KGD 테스트 시간·비용 증가 |
| 16단 → 20단+ | ① 패키지 높이 한계(775µm 초과) — hybrid bonding 필수 ② bumpless 직접 접합의 정렬 정밀도(100nm급)·표면 처리 ③ HBM4E 높이 규격 논의(~900µm)와 표준 부재(vendor-defined) 리스크 |
전망 — 2027년의 갈림길
세 가지 변수가 2027년을 가른다. 첫째, HBM4E — 2026년 10월 현재 JEDEC 표준이 없는 vendor-defined 세대다. 2048-bit를 유지하면서 14~16Gbps로 스택당 약 3.6TB/s, 12단에 48GB(32Gb 다이)를 노린다. 삼성전자가 5월 말, SK하이닉스가 약 3주 뒤에 12단 HBM4E 샘플을 출하했고, 마이크론은 2027년 양산을 목표로 한다. 둘째, hybrid bonding 전환점 — JEDEC이 HBM4E 높이 규격을 약 900µm로 완화하는 방안을 논의 중인 것으로 보도됐다. 완화되면 기존 TC 본더(한미반도체)의 수명이 연장되고, hybrid bonding(BESI·Applied Materials) 도입은 늦춰진다. 반대로 규격이 타이트해지면 16단 이상은 hybrid bonding이 필수가 된다. 셋째, 커스텀 HBM — 빅테크의 자체 가속기가 늘면서 표준 HBM이 아닌 고객 맞춤형 스택 요구가 커지고 있다. 단수 논쟁은 결국 "누가, 어떤 워크로드에, 얼마를 내고 메모리를 사는가"의 문제로 수렴한다. 단수는 기술 스펙이 아니라 가격표다.
본 글의 시장 점유율·가격·수율 수치는 2026년 10월 기준 업계 추정치이며, Rubin Ultra 스펙 변경 관련 내용은 보도·분석 단계로 NVIDIA가 공식 확인한 바 없다. HBM 용량은 Gb 단위로 표기했다.


