VLSI Korea
In-Network Compute란? UALink 2.0이 AI 스위치를 연산 계층으로 바꾸는 조건
UALink 2.0은 switch를 collective 연산에 참여시킵니다. 성능보다 먼저 닫아야 할 correctness·security·recovery 계약을 정리합니다.


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
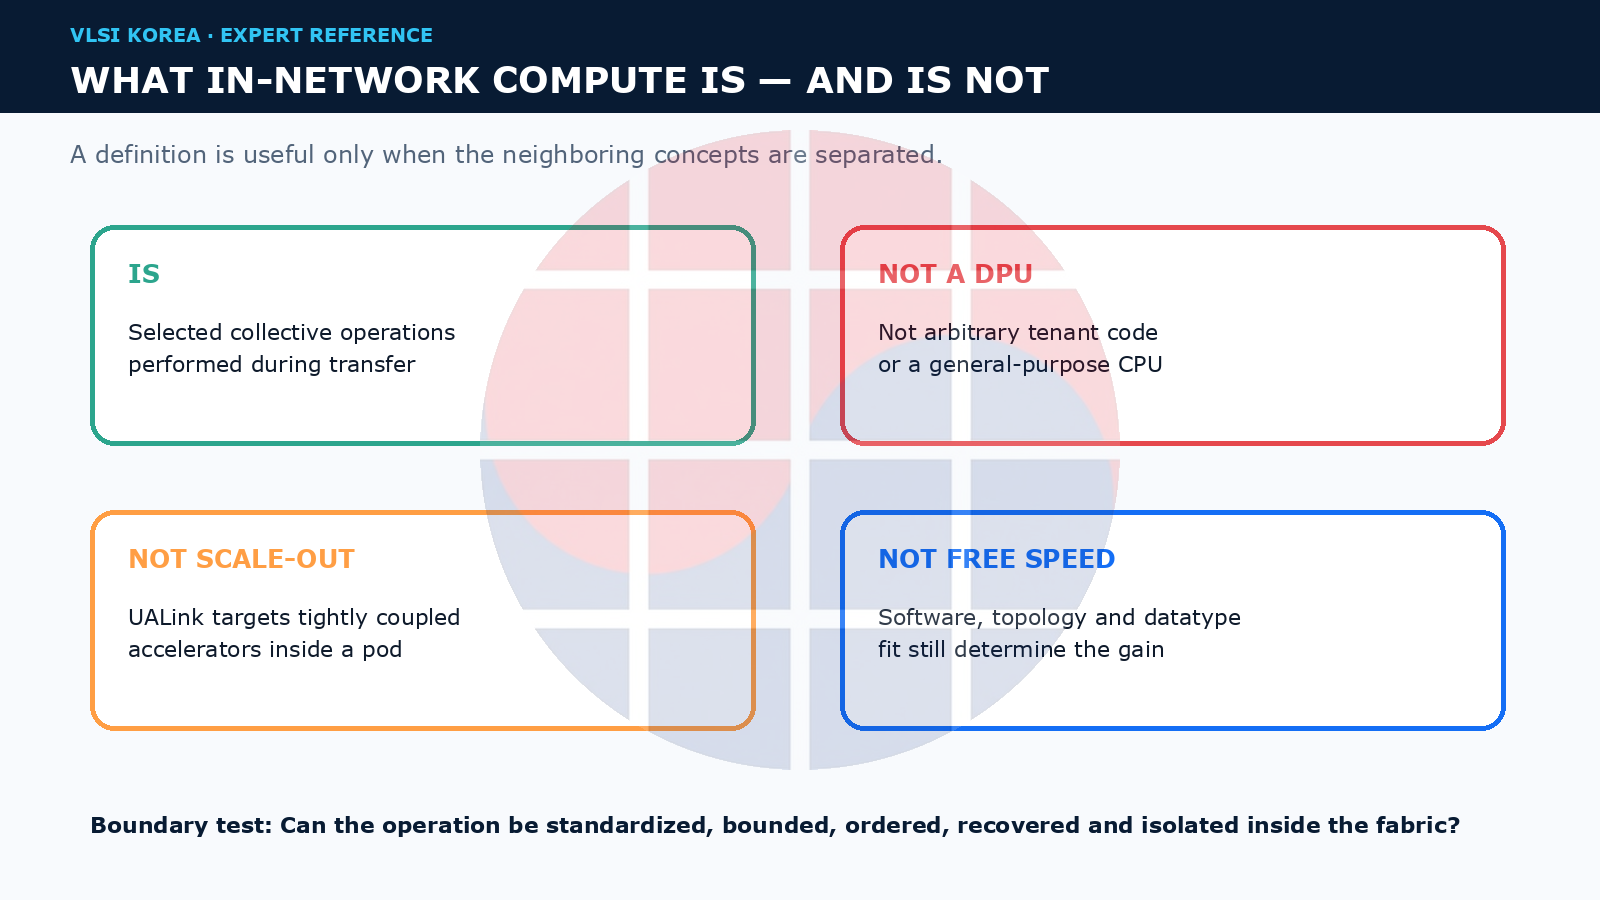
In-Network Compute란 전송 중 패브릭 스위치가 정해진 collective 연산 일부를 수행하는 구조다. 2026년 4월 공개된 UALink Common Specification 2.0은 이를 AI scale-up 패브릭의 공식 기능으로 끌어올렸다. 스위치가 범용 CPU가 아니라 reduce, all-reduce, broadcast, reduce-scatter처럼 경계가 분명한 통신 연산에 참여한다.
이는 DPU의 임의 사용자 코드나 scale-out Ethernet과 다르다. UALink는 한 AI pod의 scale-up domain을 겨냥하며, collective 이름이 같아도 datatype, ordering, completion, retry, tenant isolation 계약이 다르면 호환되지 않는다.
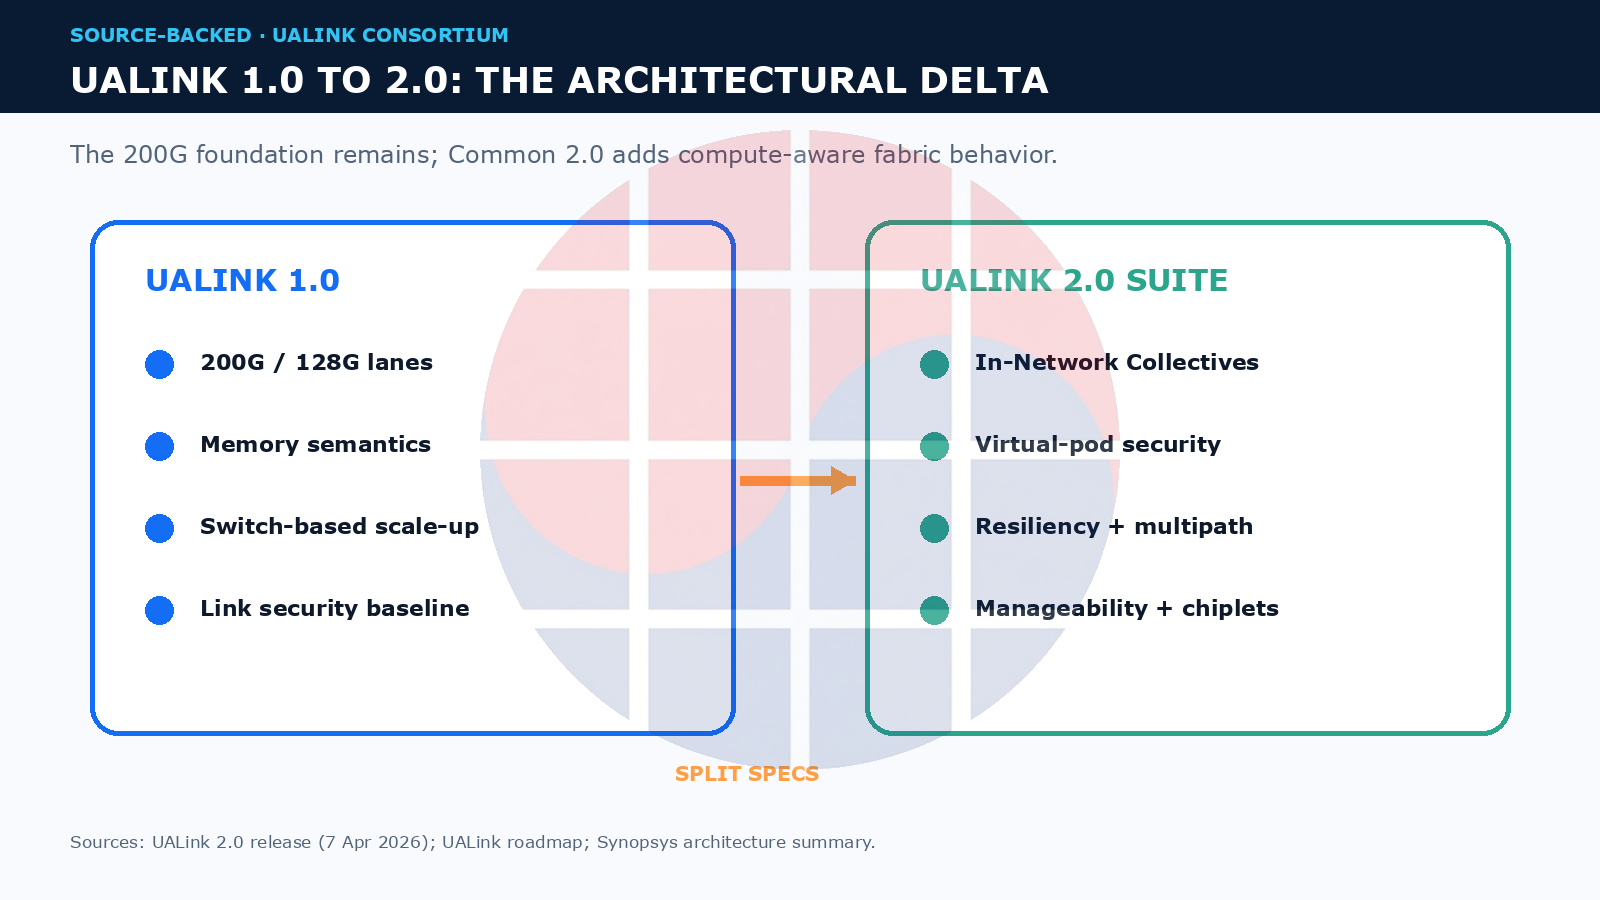
공개 자료는 기능을 확인하지만 multi-vendor 성능과 복구 시간은 확정하지 못한다. 핵심은 성능 기회와 correctness·trust boundary가 함께 switch로 이동했다는 것이다.
왜 지금인가: 대역폭을 늘려도 collective 단계가 사라지지 않는다
AI 학습과 추론은 가속기 하나로 끝나지 않는다. data parallel은 gradient를 합치고, tensor parallel은 부분 결과를 교환하며, mixture-of-experts는 token을 여러 expert로 보냈다가 모은다. 가속기가 늘수록 동기화와 데이터 이동은 더 복잡해진다.
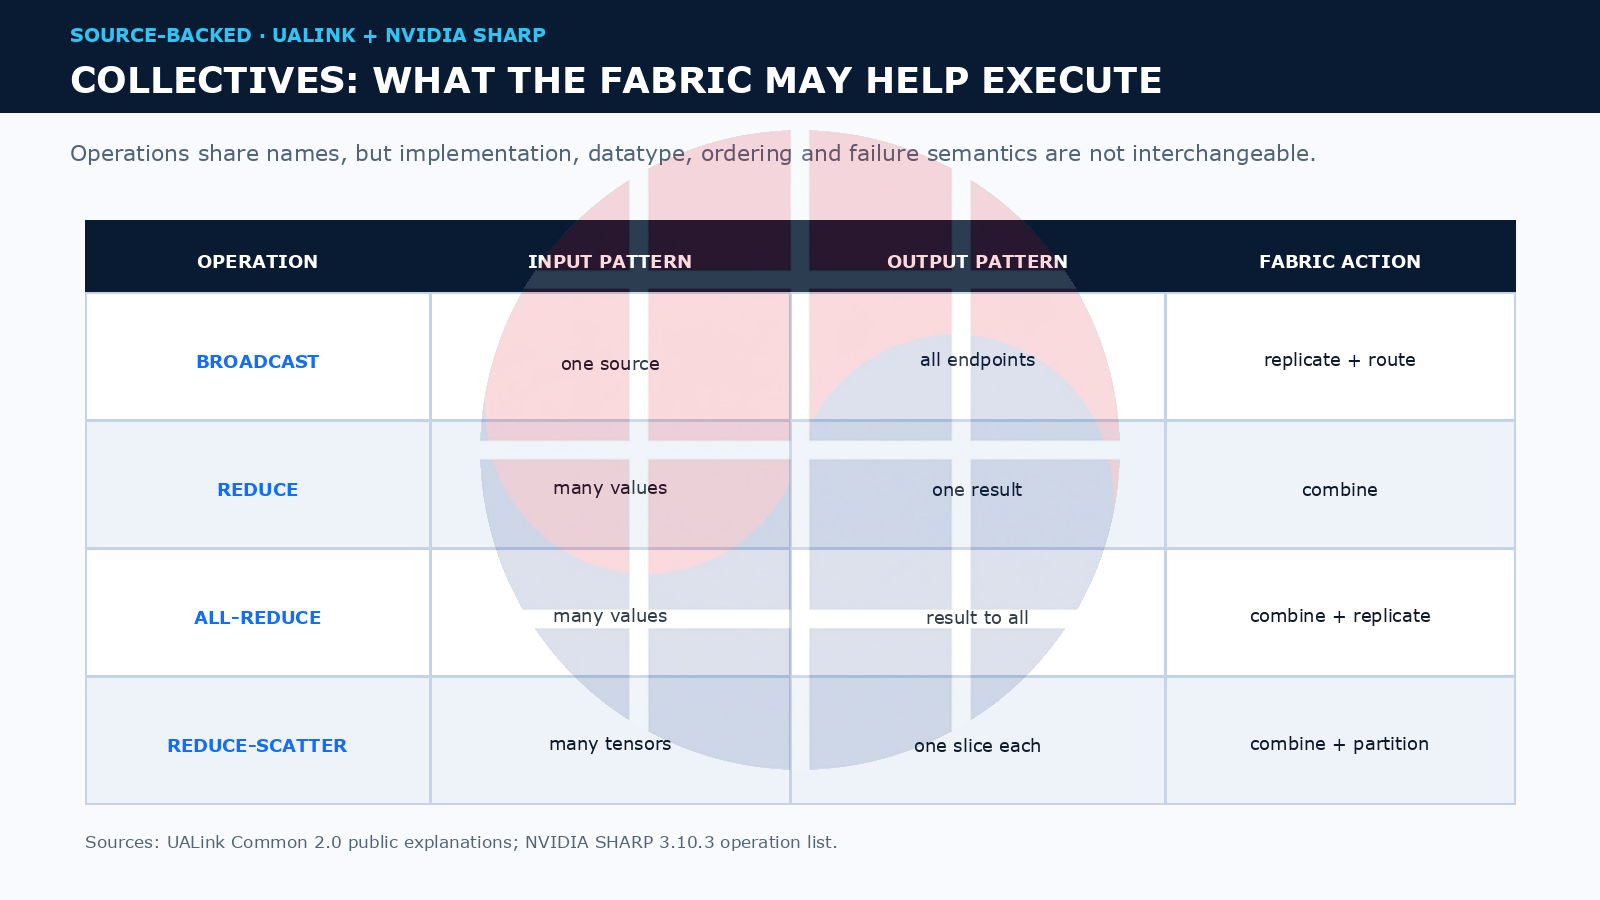
In-Network Compute의 기회는 이 반복을 패브릭 안에서 줄이는 데 있다. 여러 입력이 같은 switch를 통과한다면 switch가 부분 합을 만들고 결과 하나만 다음 단계로 보낼 수 있다. broadcast에서는 하나의 입력을 여러 경로로 복제하고, reduce-scatter에서는 합산과 partition을 연결할 수 있다. 그러나 이득은 topology, tensor size, operation mix, overlap, congestion에 따라 달라진다. 작은 메시지에서는 setup cost가 지배할 수 있고, endpoint computation과 통신이 이미 잘 겹치면 offload의 추가 이득이 작을 수 있다.
무엇이 아닌가: DPU, CXL, UCIe, scale-out network와의 경계
programmable DPU는 networking, storage, security 등 다양한 software function을 실행하지만, UALink 2.0의 핵심은 임의의 tenant program이 아니라 경계가 정해진 collective primitive다. CXL은 host·device·memory의 coherency와 resource composition을, UCIe는 package 안 die-to-die 연결을, scale-out Ethernet은 더 긴 거리의 rack·pod 간 network를 다룬다. In-Network Compute는 이들과 공존할 수 있지만, 주소 일관성이나 범용 network를 대신하지 않는다.
Mechanism: combine, replicate, route, complete
data가 들어오면 switch는 operation에 맞춰 combine, replicate, partition을 수행한다. reduce는 여러 partial value를 하나로 합치고, broadcast는 한 input을 여러 output으로 복제한다. all-reduce는 reduction과 dissemination을 연결한다. reduce-scatter는 reduction 결과의 서로 다른 slice를 각 endpoint에 보낸다. Synopsys의 2026년 해설은 UALink 2.0의 In-Network Collectives가 collective primitive와 block collective를 제공하며 setup, data flow, completion tracking을 정의한다고 설명한다.
hard part는 산술기보다 계약이다. floating-point reduction은 결합 순서에 따라 rounding이 달라지고 datatype별 overflow와 NaN 처리도 정해야 한다. switch state가 크면 scale과 verification이 어려워지고, 너무 작으면 recovery를 endpoint software에 다시 떠넘긴다.
runtime은 membership, operation, datatype, buffer, sequence를 switch와 endpoint에 일관되게 설치해야 한다. 마지막에는 모든 endpoint가 하나의 valid result 또는 하나의 explicit failure에 도달해야 한다. 일부만 success를 보고 나머지가 timeout이면 model state가 갈릴 수 있으므로 latency만 재는 benchmark는 절반의 contract만 본다.
보안: switch가 trusted computing base 안으로 들어온다
이 변화는 switch를 trusted computing base의 일부로 만든다. collective traffic을 계산하려면 필요한 범위에서 decrypt하고 결과를 다시 encrypt해야 할 수 있다. 그러면 key provisioning, secure boot, firmware update, attestation, debug access, crash dump가 모두 데이터 보호 모델에 포함된다. 물리 링크가 암호화되어 있다는 사실만으로 multi-tenant collective의 isolation이 증명되지는 않는다.
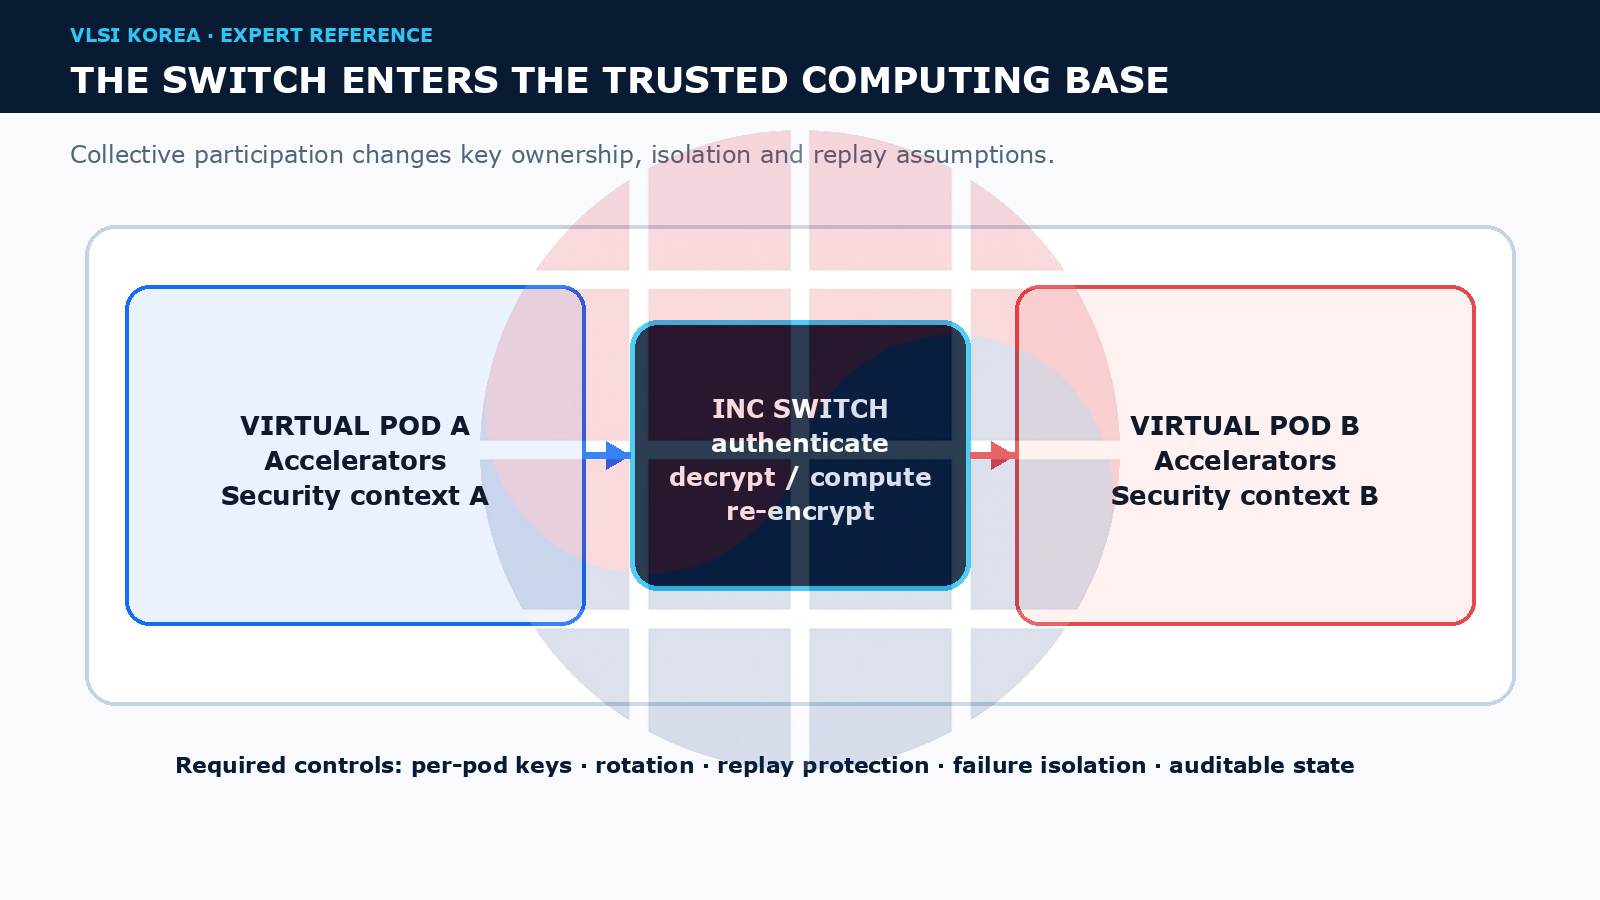
실무 질문은 “encryption이 있는가”가 아니라 “누가 어떤 순간에 plaintext와 key state를 보유하는가”다. Synopsys의 공개 설명은 virtual pod별 security context, key derivation·rotation, replay protection을 언급한다. pod A가 pod B의 state, counter, buffer reuse에 영향을 주지 않는지, key rotation·switch reset·firmware rollback에서도 분리가 유지되는지 시험해야 한다.
Failure mode: 링크 하나의 고장이 collective 전체의 의미를 바꾼다
큰 pod에서는 link error, reset, timeout이 운영 조건이다. participant 하나가 사라지면 partial reduction을 버릴지, topology를 접어 다시 실행할지 정해야 한다.
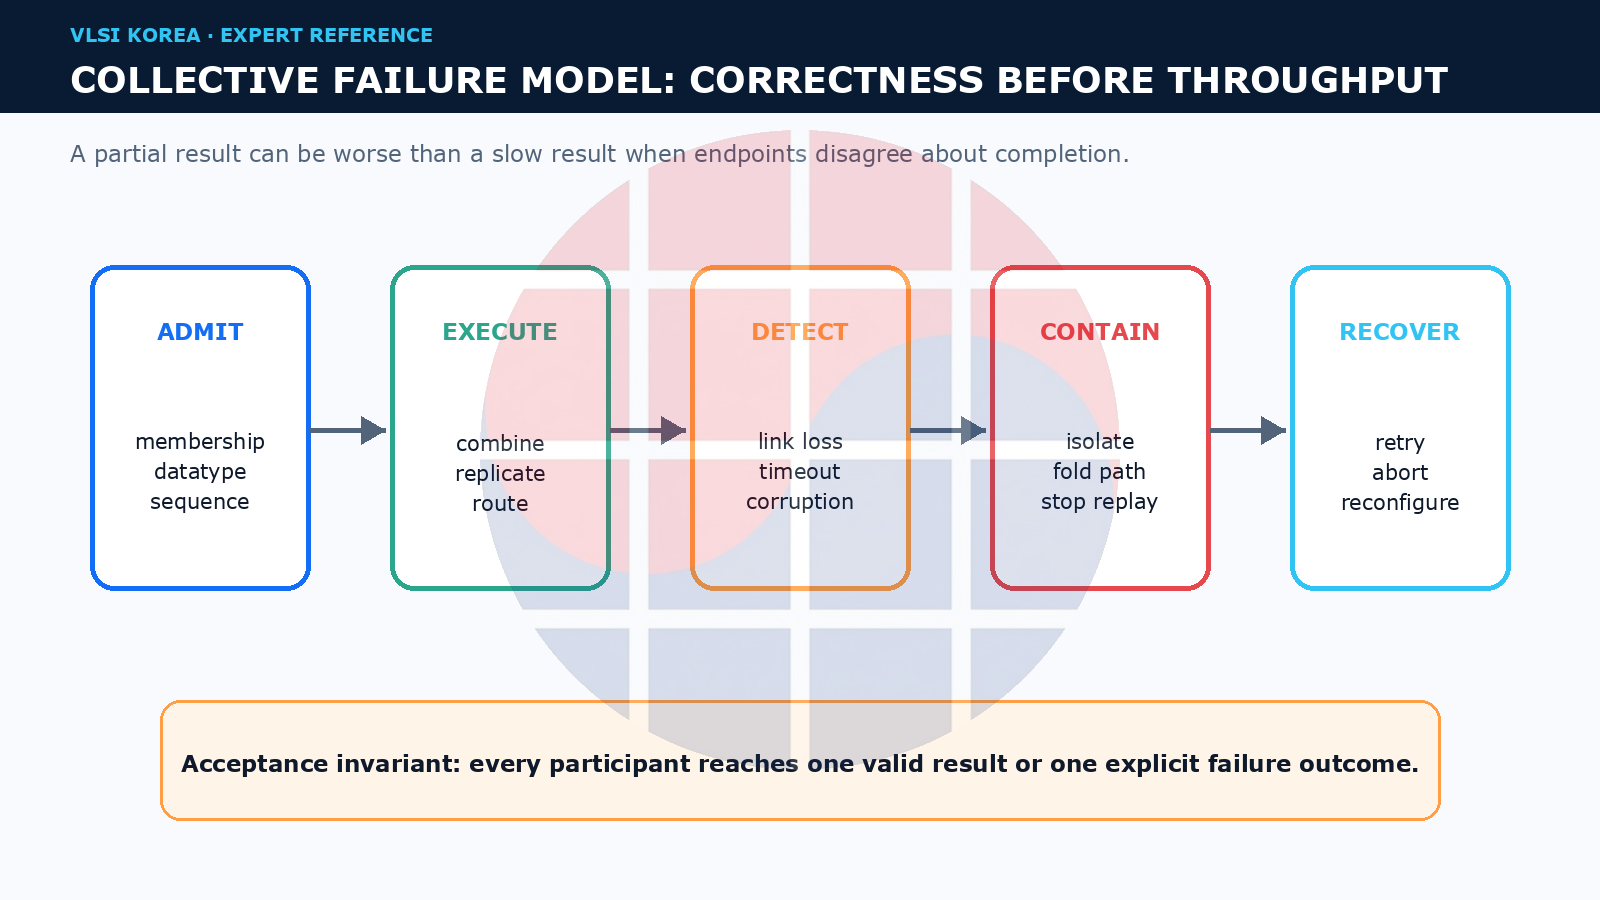
Synopsys는 multipath routing, failure isolation, collective-aware recovery, link folding을 설명한다. 이는 구현 제품의 recovery time 보증이 아니며, spec과 silicon 사이에는 buffer, firmware, runtime, fault coverage가 있다.
failure mode는 admission, execution, detection, containment, recovery에서 생긴다. membership 불일치, duplicate·missing contribution, 느린 endpoint 오판, 다른 pod로의 오류 전파, 일부 endpoint만의 retry가 대표적이다. fault injection에서 completion 상태가 갈리거나 multi-vendor 장비가 error event를 같은 의미로 해석하지 못하면 thesis는 깨진다.
Manageability: Redfish, gNMI, YANG, SAI가 왜 같이 등장했나
UALink Manageability 1.0은 centralized control·management plane과 gNMI, YANG, SAI, Redfish 활용을 발표했다. 하나의 protocol이 아니라 여러 층의 계약을 연결하려는 선택이다.
gNMI는 configuration과 telemetry interface, YANG은 data model, SAI는 control plane과 switch ASIC SDK 사이의 abstraction, Redfish는 platform·component management를 맡는다. collective state가 software와 silicon에 동시에 있으므로 네 층이 연결되어야 한다. API 이름보다 collective ID, participant, sequence, retry, key epoch, degraded path가 실제로 observable한지가 중요하다.
검증은 PHY부터 workload까지 한 identity로 이어져야 한다
UALink 200G receiver compliance는 출발점일 뿐이다. channel과 FEC가 정상이어도 collective state나 tenant key가 틀리면 workload는 실패하고, protocol이 맞아도 error burst는 tail latency를 흔든다.
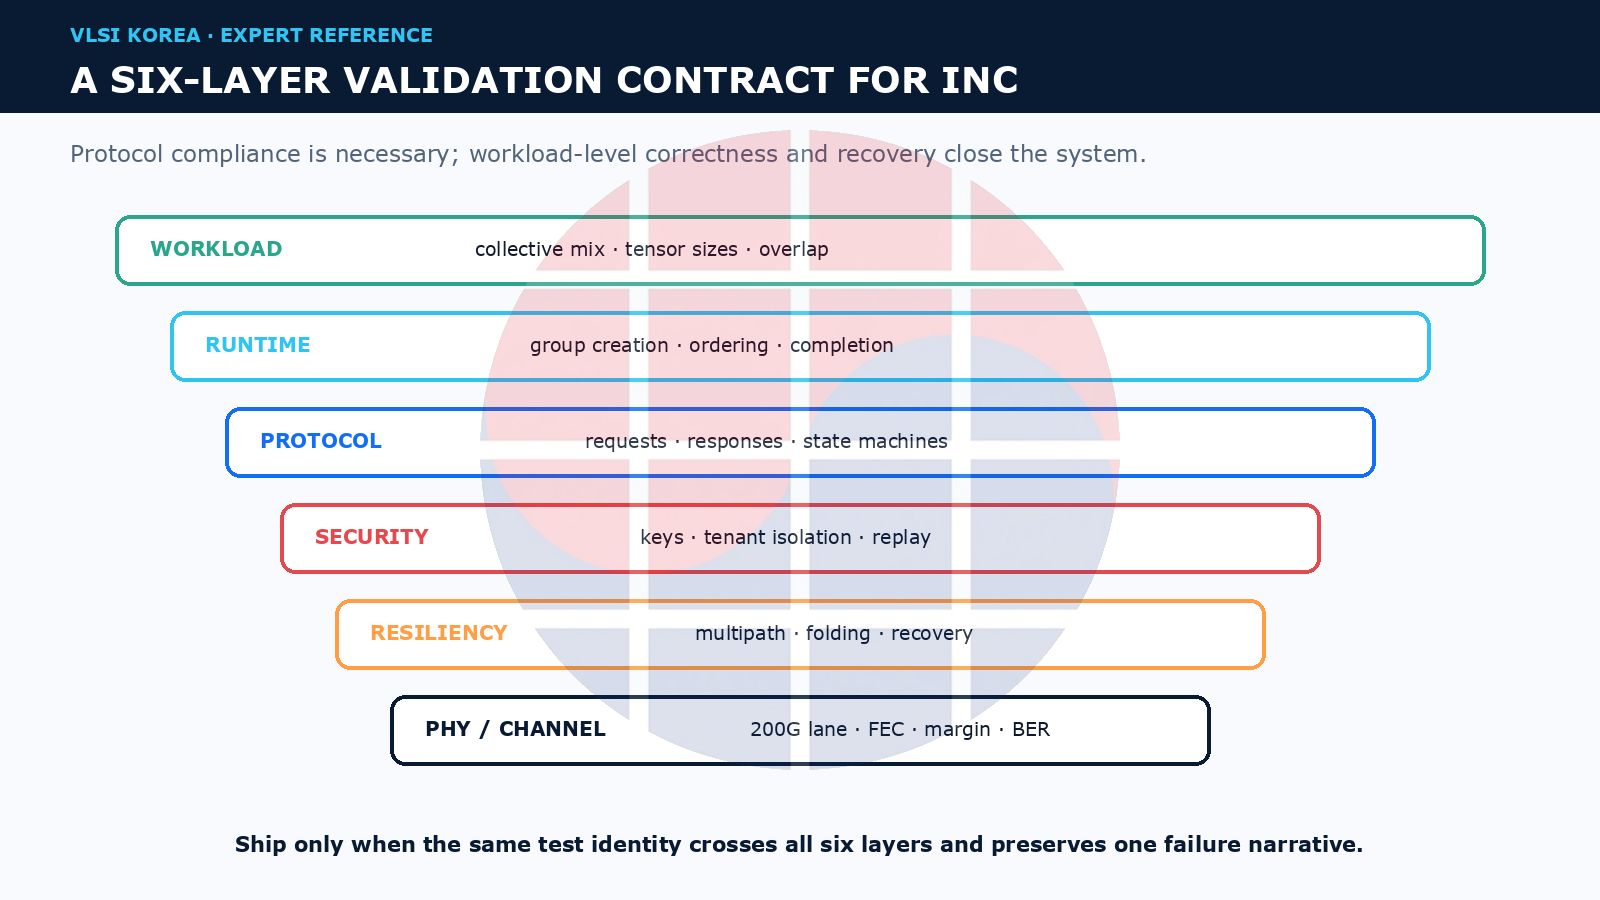
검증 contract는 PHY·channel, protocol, security, resiliency, runtime, workload 여섯 층을 묶는다. lane·BER부터 ordering, key, recovery, group completion, tensor result까지 하나의 test identity로 이어야 한다.
각 층의 log에는 같은 collective identity와 timeline이 있어야 workload timeout을 channel burst, switch state leak, runtime ordering bug로 추적할 수 있다. EDA·test 환경도 controller VIP 하나가 아니라 PHY model, protocol checker, security fault, switch traffic, pod-level emulation을 연결해야 한다.
실무 의사결정: 어떤 collective부터 offload할 것인가
첫 reader job은 architect가 workload별 collective bytes, message size, frequency, overlap, tail latency를 측정하는 일이다. 둘째는 verification·platform lead가 participant loss, duplicate packet, path fold, key rotation, switch reset, mixed firmware에 대한 acceptance criteria를 만드는 일이다.
의사결정은 두 단계다. 먼저 workload fit을 본다. 반복 participant가 많고, supported datatype과 reduction semantics가 맞으며, aggregation으로 실제 traffic을 줄일 수 있는 collective가 우선이다. 다음으로 risk fit을 본다. failure containment, tenant isolation, observability를 재현할 수 없다면 성능이 좋아도 production offload를 보류한다.
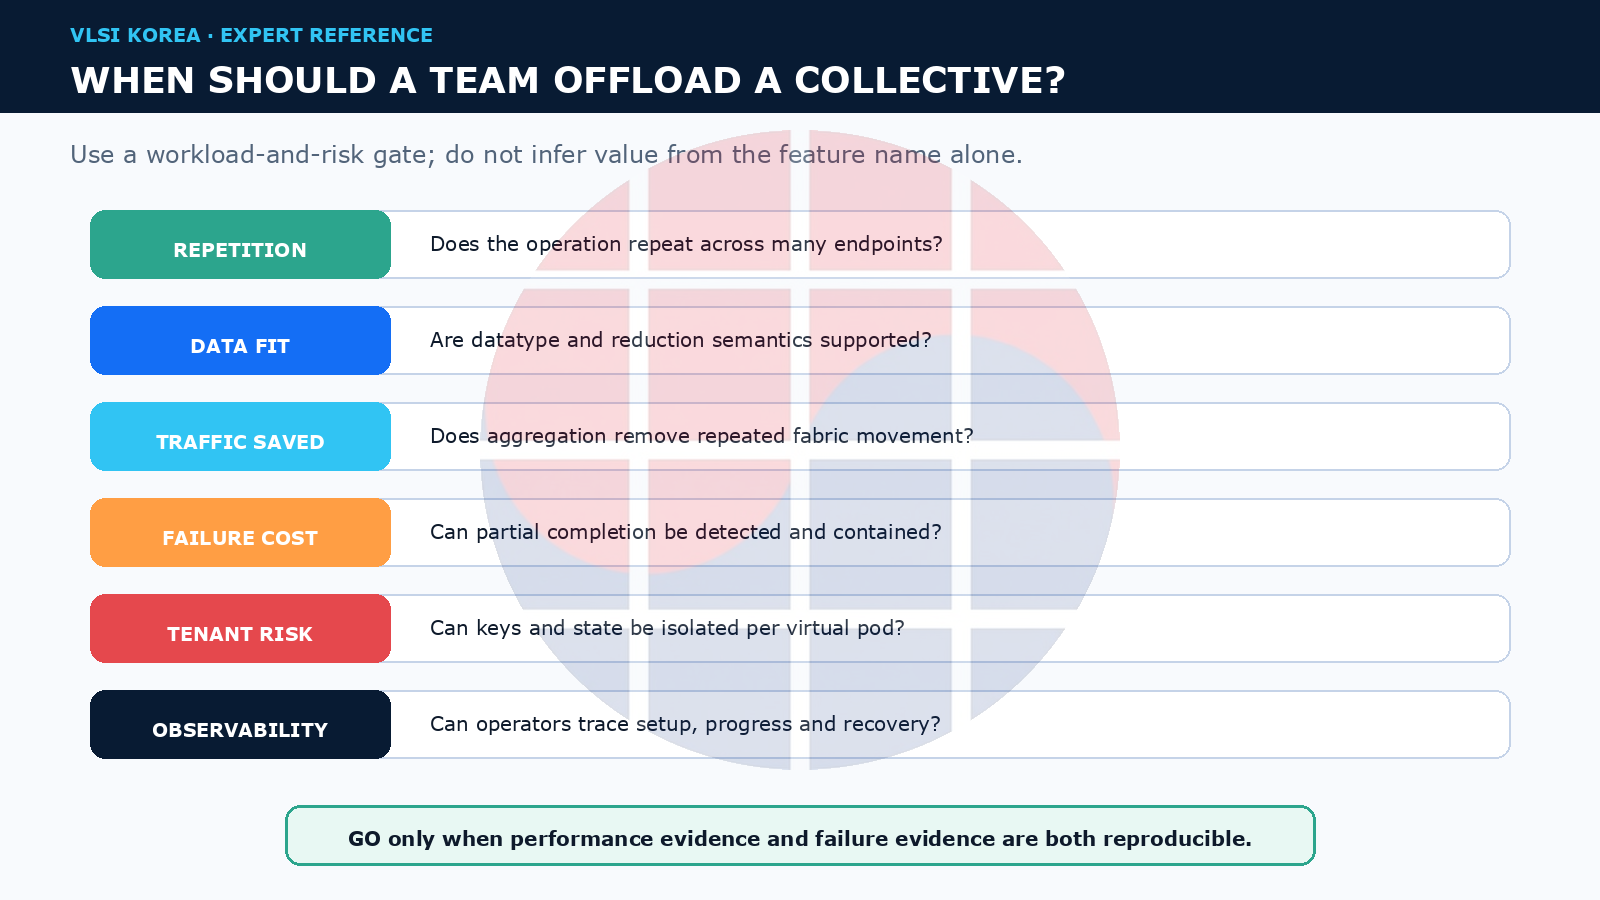
endpoint-only, switch-assisted, failure-injected path를 같은 topology에서 비교하고 step time, p99 latency, accelerator idle, fabric bytes, recovery time, energy, correctness를 함께 보고한다. 작은 pod나 이미 잘 겹치는 통신에서는 endpoint software가 더 단순할 수 있다. 동일 data가 switch를 반복 통과해 endpoint cycle과 fabric bytes를 함께 줄일 때 offload thesis가 강하다.
Korean Lens: HBM 다음 병목에 참여하려면 switch와 검증 IP가 필요하다
한국의 HBM·패키징 강점만으로 이 value를 포착할 수는 없다. scale-up switch, 200G SerDes, controller·security IP, verification, compliance, runtime이 함께 필요하다.
국내 기업의 진입점은 switch·retimer·controller·security IP와 compliance다. “UALink compatible” 문구보다 accelerator, switch, firmware, runtime 조합을 공개한 mixed-vendor bring-up artifact가 중요하다. 대학과 연구소는 completion과 tenant isolation의 formal model·fault injection으로 차별화할 수 있다.
앞으로 6~12개월에 볼 신호
2026년 9월 30일까지: public evaluation 자료가 datatype, primitive, completion, security boundary를 구현 가능한 수준으로 공개하는지 본다. 2026년 12월 31일까지: silicon·switch·PHY·verification IP 발표가 port, power, topology, interoperability partner까지 밝히는지 확인한다.
2027년 3월 31일까지: compliance program이 fault injection, firmware mix, security negative test를 포함하는지 본다. 2027년 6월 30일까지: endpoint-only 대비 fabric-assisted path의 step time, fabric bytes, recovery time이 독립적으로 공개되는지 확인한다. 2027년 8월 31일까지: open management model이 vendor extension 없이 collective state와 virtual-pod fault를 설명하는지 본다.
최종 판단
In-Network Compute의 의미는 스위치에 ALU를 몇 개 더 넣는 데 있지 않다. AI pod의 collective를 패브릭이 이해하기 시작하면서 bandwidth, compute, security, recovery, telemetry의 sign-off boundary가 하나로 합쳐진다는 데 있다.
실무 결론은 세 가지다. collective traffic을 계측하고, 후보마다 failure invariant를 정의하며, public silicon과 compliance 결과가 나올 때까지 endpoint-only fallback을 유지한다.
한 문장으로 요약하면: In-Network Compute는 “네트워크가 계산한다”는 유행어가 아니라, 반복 collective를 switch가 제한적으로 실행하는 구조이며, 채택 여부는 줄어든 bytes보다 더 엄격해진 correctness와 trust contract가 결정한다.
Sources
- UALink Consortium, UALink 2.0 specification suite release, 2026-04-07.
- UALink Consortium, Exploring In-Network Compute, 2026-06-24.
- Synopsys, Four Ways UALink 2.0 Advances AI Scale Up, 2026.
- NVIDIA SHARP Collective Library documentation, comparison context for collective operation names.
- OpenConfig gNMI Specification 0.10.0.
- Open Compute Project, Switch Abstraction Interface.
- DMTF Redfish standard.
- IETF RFC 7950, YANG 1.1 Data Modeling Language.
AI assistance note: AI는 1차 자료 탐색, 한영 사실 일치, 구조·도판 점검을 보조했습니다. VLSI Korea는 주요 주장을 연결된 자료와 대조했습니다.
본 글은 정보 제공만을 목적으로 하며, 특정 증권의 매수 또는 매도를 권유하는 것이 아닙니다. 본 글에 포함된 수치와 사실은 기업 공시, 언론 보도, 시장 조사 등 공개적으로 이용 가능한 자료를 바탕으로 작성되었으며, 해당 자료 또는 작성 과정에서 오류가 발생할 수 있습니다. 필자는 언급된 기업의 주식을 보유하고 있을 수 있습니다. 모든 투자 결정 및 그에 따른 결과는 독자의 책임입니다.