 VLSI Korea
테라팹은 무엇을 만들까: AI 칩·웨이퍼·패키징으로 읽는 1 TW
AI5·AI6·D3부터 웨이퍼 수율과 패키징 병목까지. 실제 칩·장비 사진과 계산으로 테라팹의 제조 구상을 읽는다.


테라팹은 Tesla·SpaceX·xAI의 AI 칩 수요를 logic, memory, advanced packaging까지 묶어 충당하려는 반도체 제조 프로젝트다. 공식 사이트가 제시한 제품은 FSD·Optimus용 AI5, Optimus용 AI6, 우주용 D3다. Intel은 2026년 1분기 실적 발표에서 협력을 확인했다. Terafab, Intel.
핵심은 세 가지다. 어떤 칩을 만들고, 웨이퍼에서 양품을 얼마나 얻고, 메모리와 결합해 얼마나 출하할 수 있느냐다. 아래 실물 사진은 이 제조 과정을 보여주는 협력사 Intel의 제품·장비 사례다.
1. AI 칩 하나가 공장 설계를 바꾼다
자동차와 로봇에 들어가는 칩은 전력·발열·응답시간 제약 안에서 일을 처리해야 한다. 우주용 칩은 여기에 방사선 환경과 열 배출, 수리의 어려움까지 고려한다. 연산 성능이 같아도 용도가 바뀌면 메모리, 패키지, 검사 조건이 달라지는 이유다.
테라팹이 logic과 memory를 함께 내세운 것도 이 때문이다. 연산 회로가 빨라도 필요한 데이터를 제때 받지 못하면 대기한다. 제조 계획에는 연산 칩뿐 아니라 메모리 공급량과 둘을 연결할 패키징 처리량이 함께 들어가야 한다.
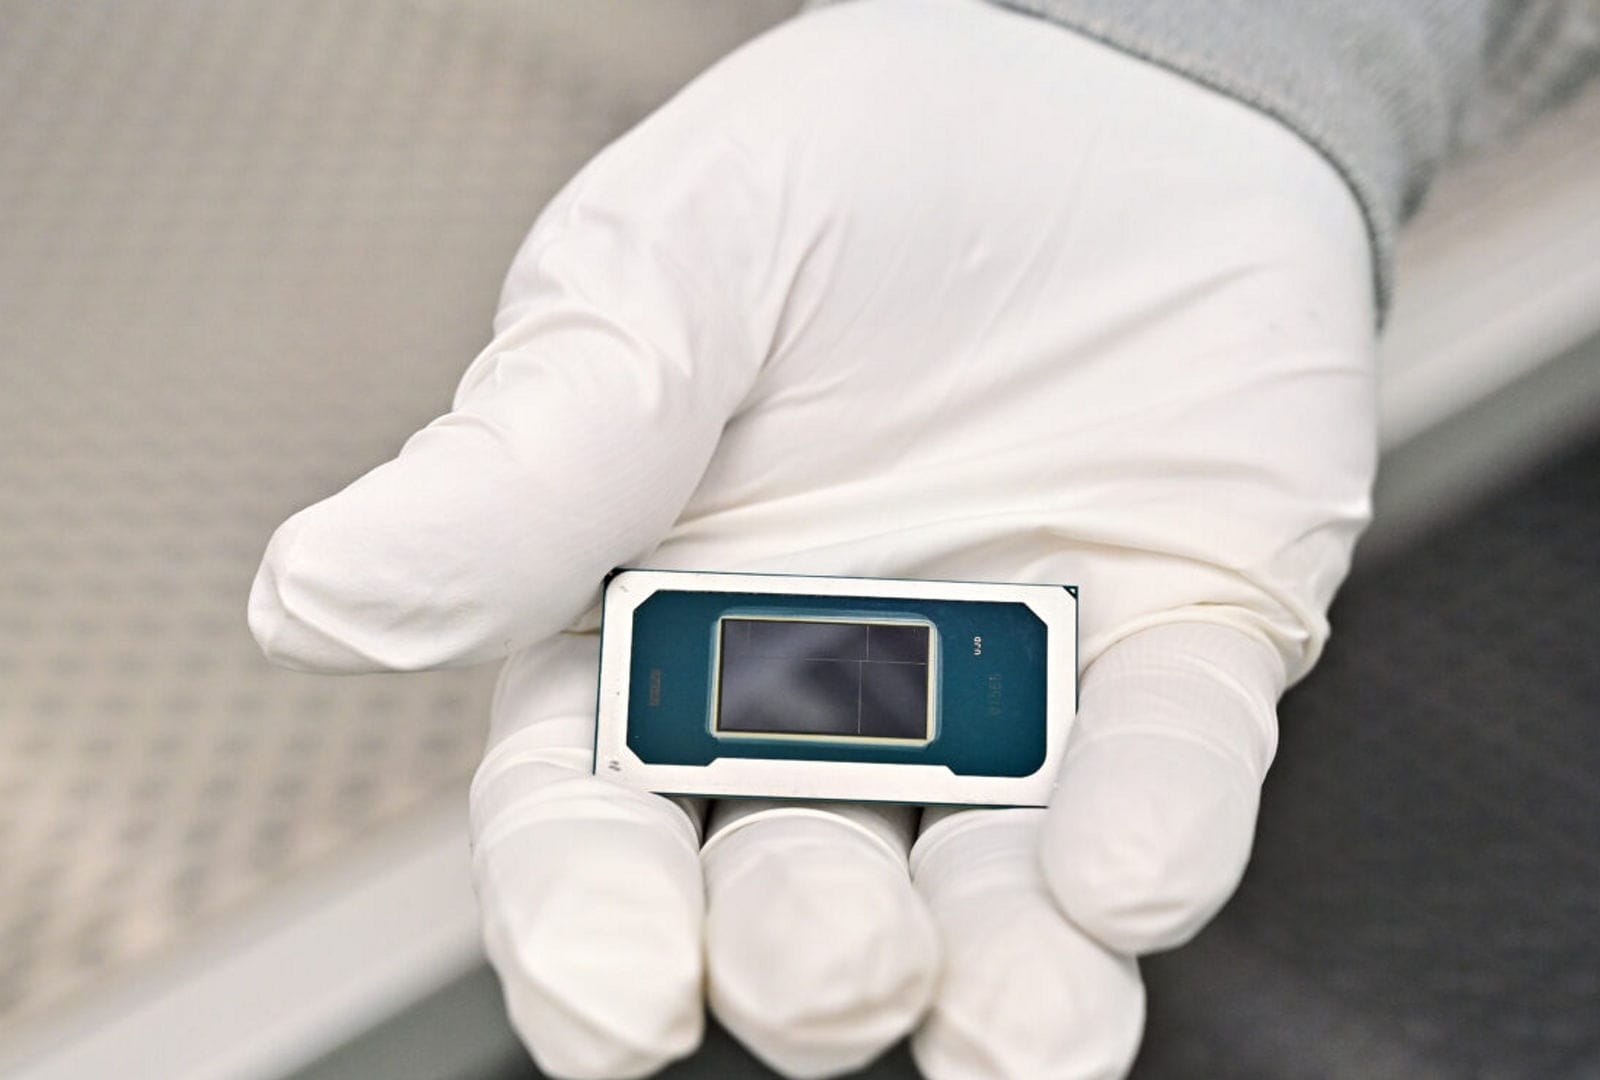
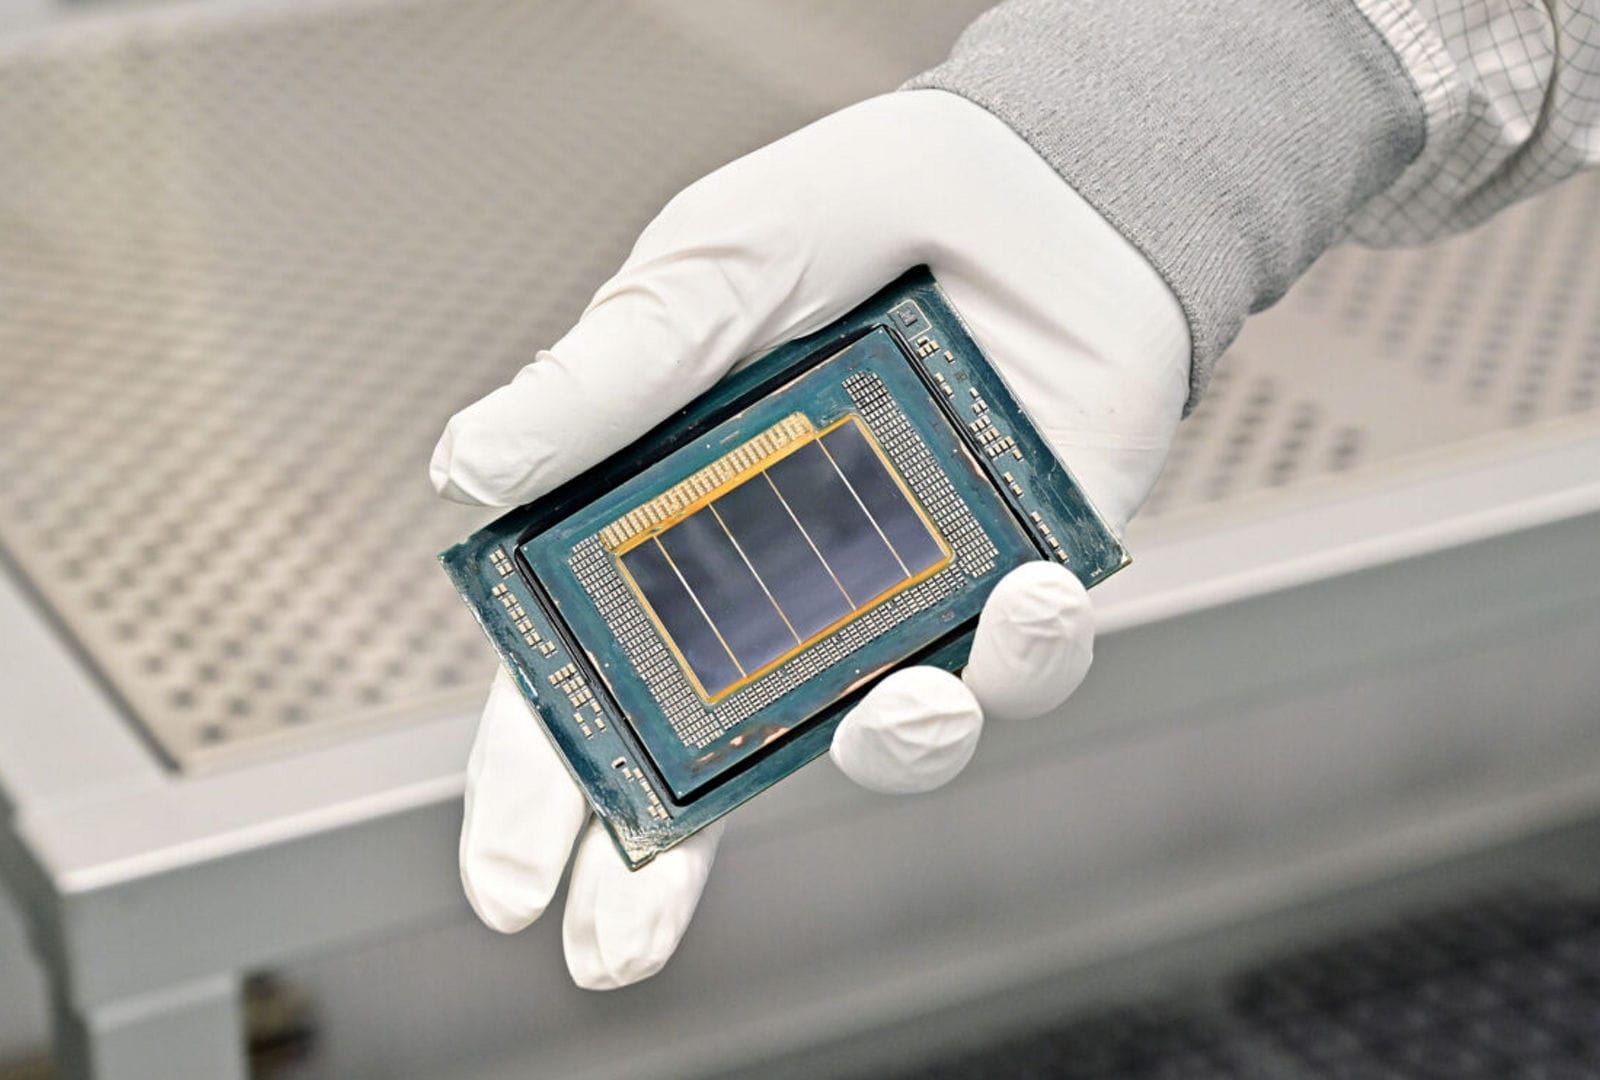
실제 제품의 차이는 사진에서 보인다. 위는 PC용 Panther Lake, 아래는 서버용 Clearwater Forest다. Intel이 2025년 공개한 서로 다른 제품으로, 같은 회사의 칩도 용도에 따라 패키지 크기와 구성이 달라진다. 제품 공개 자료.
테라팹의 사업 구조도 제품 범위만큼 중요하다. SpaceX의 2026-06-05 투자설명서는 Tesla와 개발 협력의 큰 틀에 합의했으며, 개별 일정·이정표·자본지출은 별도 합의 대상으로 설명한다. 외부 업체의 컴퓨팅 하드웨어도 계속 조달할 계획이다. 자체 제조와 외부 구매를 병행하는 구조다. 투자설명서, PDF 84·99쪽.
2. 웨이퍼 한 장에서 칩 몇 개가 나오는가
웨이퍼에는 같은 회로를 반복해서 만든다. 회로 하나의 면적이 커질수록 한 장에 들어가는 개수는 줄고, 가장자리에서는 온전한 사각형을 만들 수 없는 부분이 생긴다. 이후 검사에 통과한 die를 골라 패키징한다.
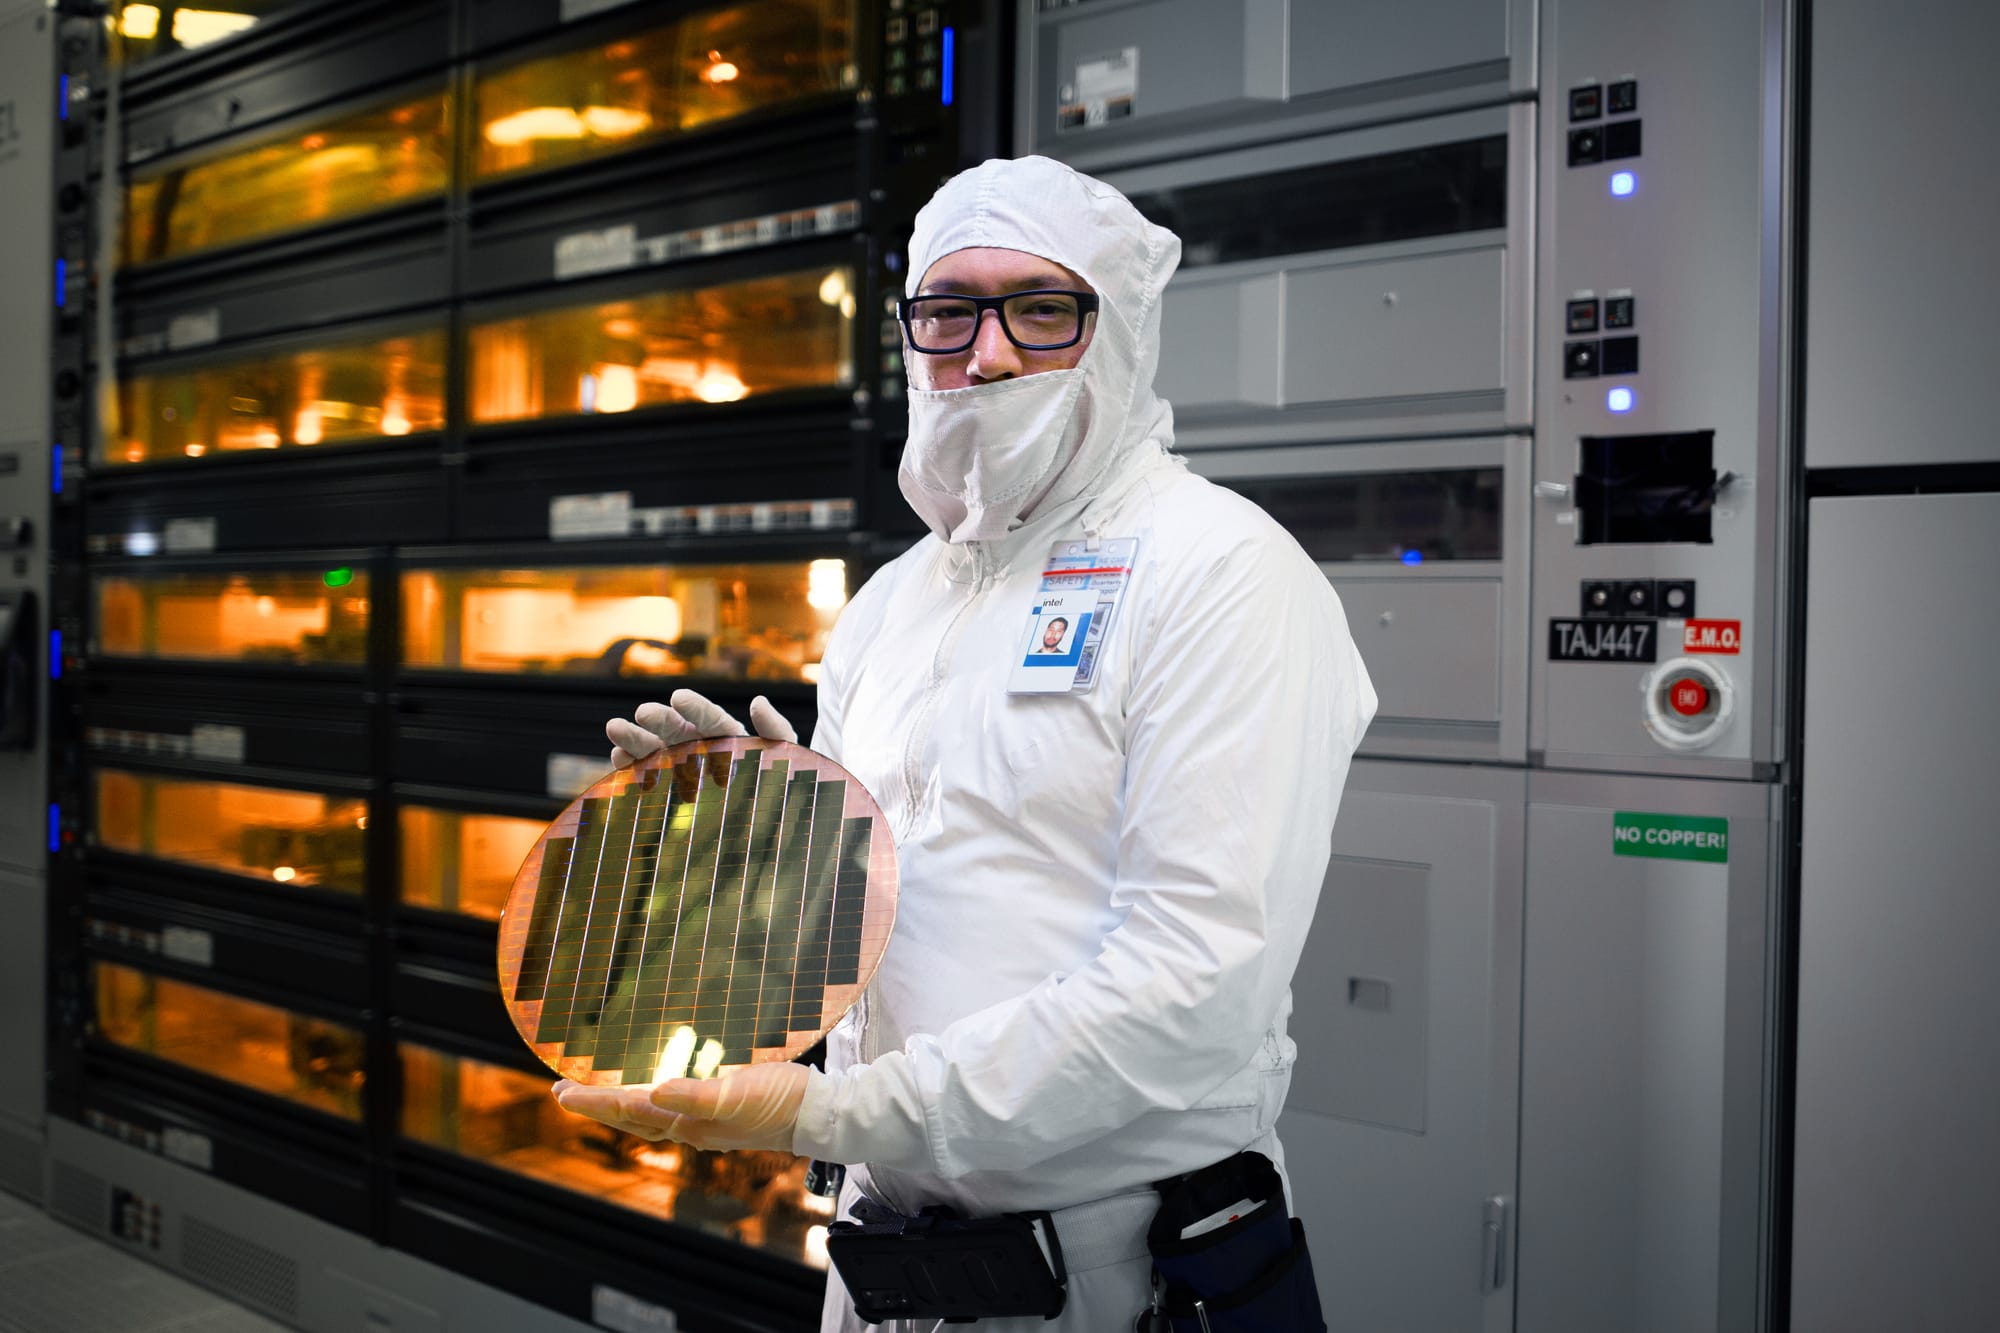
위 사진은 Intel의 Foveros 적층 기술이 적용된 웨이퍼다. 웨이퍼 위의 반복 패턴과 최종 판매되는 패키지가 서로 다른 생산 단위라는 점을 보여준다. 공식 사진 자료.
계산해 보자. 직경 300 mm, die 면적 600 mm², die yield 60%, packaging yield 90%, 패키지당 logic die 1개를 가정한다. 테라팹의 제품 사양이 아니라 생산량의 구조를 이해하기 위한 예제다.
Gross dies ≈ π × (D / 2)² / A − π × D / √(2A)
D는 웨이퍼 직경(mm), A는 die 면적(mm²)이다. 가장자리 손실을 근사하면 웨이퍼당 90.60개, die 검사 후 54.36개, 패키징 후 최종 양품은 48.93개가 된다. 실제 배치에서는 scribe line과 edge exclusion도 반영한다.
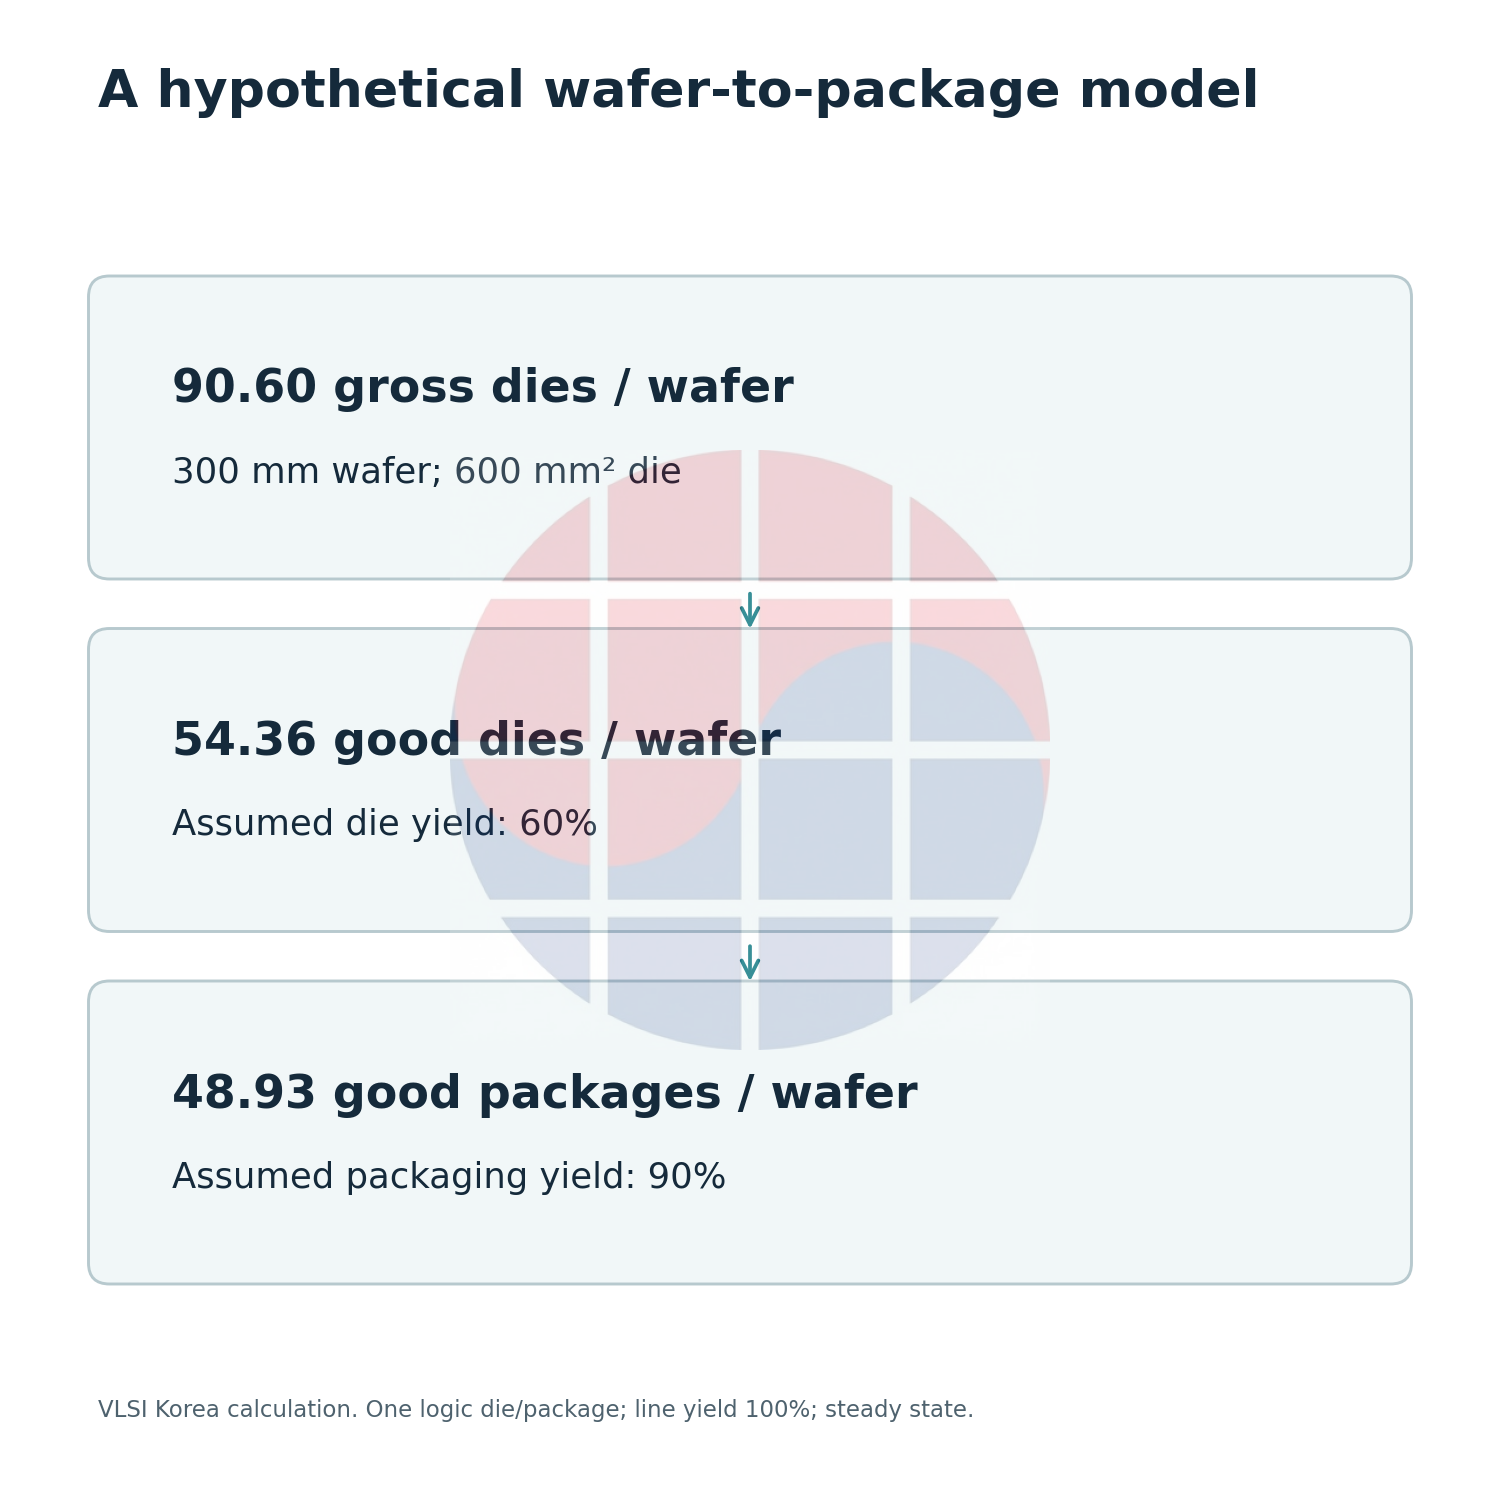
이 모델에서 die yield를 60%에서 70%로 올리면 웨이퍼당 최종 양품은 57.08개가 된다. 같은 양품 물량에 필요한 웨이퍼는 약 14.3% 줄어든다. 공장을 추가하는 것과 기존 공장의 수율을 높이는 것은 모두 공급량을 늘리는 방법이다.
3. ‘연간 1 TW’를 웨이퍼로 바꾸면
테라팹은 목표 생산 규모를 1 TW/year로 표현한다. 이를 ‘한 해 생산한 칩들의 정격 전력 합계’로 해석하면, 칩당 전력으로 나눠 필요한 칩 수를 계산할 수 있다. 팹이 소비하는 전력이나 실제 연산 성능과는 다른 값이다.
1 TW는 1,000,000,000,000 W다. 칩당 1,000 W라면 연간 1,000,000,000개가 필요하다. 앞서 계산한 웨이퍼당 양품 48.93개를 적용하면 연간 약 20.44 million wafers, 월평균 약 1.70 million wafers다.
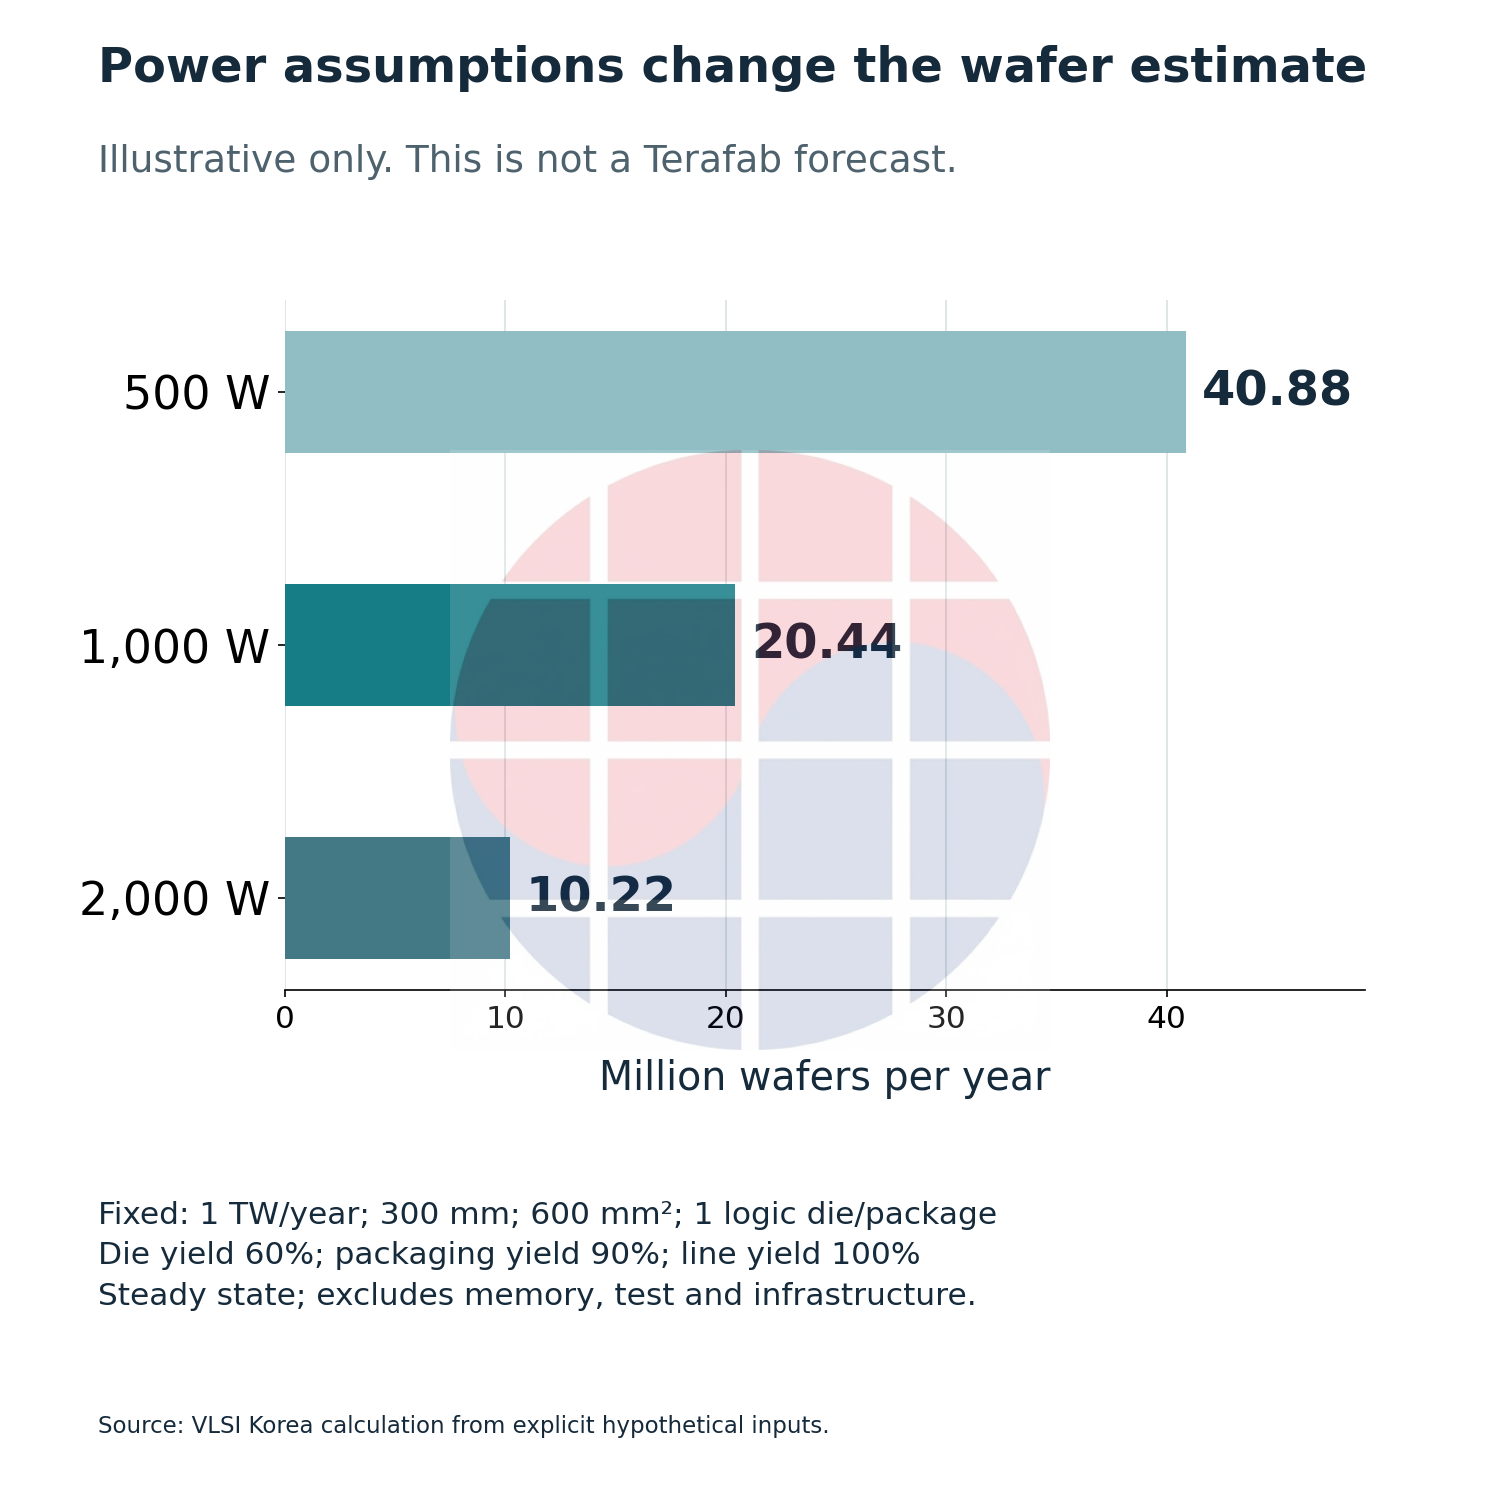
칩당 전력을 500 W로 잡으면 연간 40.88 million wafers, 2,000 W면 10.22 million wafers가 나온다. 같은 목표라도 어떤 제품을 기준으로 세느냐에 따라 물량이 크게 달라진다.
계산은 정상상태의 생산과 line yield 100%를 가정하며, 별도 메모리 웨이퍼는 제외했다. 이 숫자로 공장 개수를 구하려면 공장별 공정과 월간 처리량이 추가로 필요하다.
VLSI Korea view: 테라팹의 규모를 읽는 출발점은 건물 면적보다 제품 구성이다. 칩의 면적·전력·수율이 정해져야 장비와 웨이퍼 물량이 나온다.
4. 비싼 노광 장비 다음에도 공정은 계속된다
노광은 웨이퍼의 감광막에 회로 패턴을 형성하는 단계다. 증착·식각·세정·측정을 반복하면서 트랜지스터와 배선을 쌓는다. 한 장비를 한 번 통과한다고 칩이 완성되는 구조가 아니다. ASML 공정 설명.
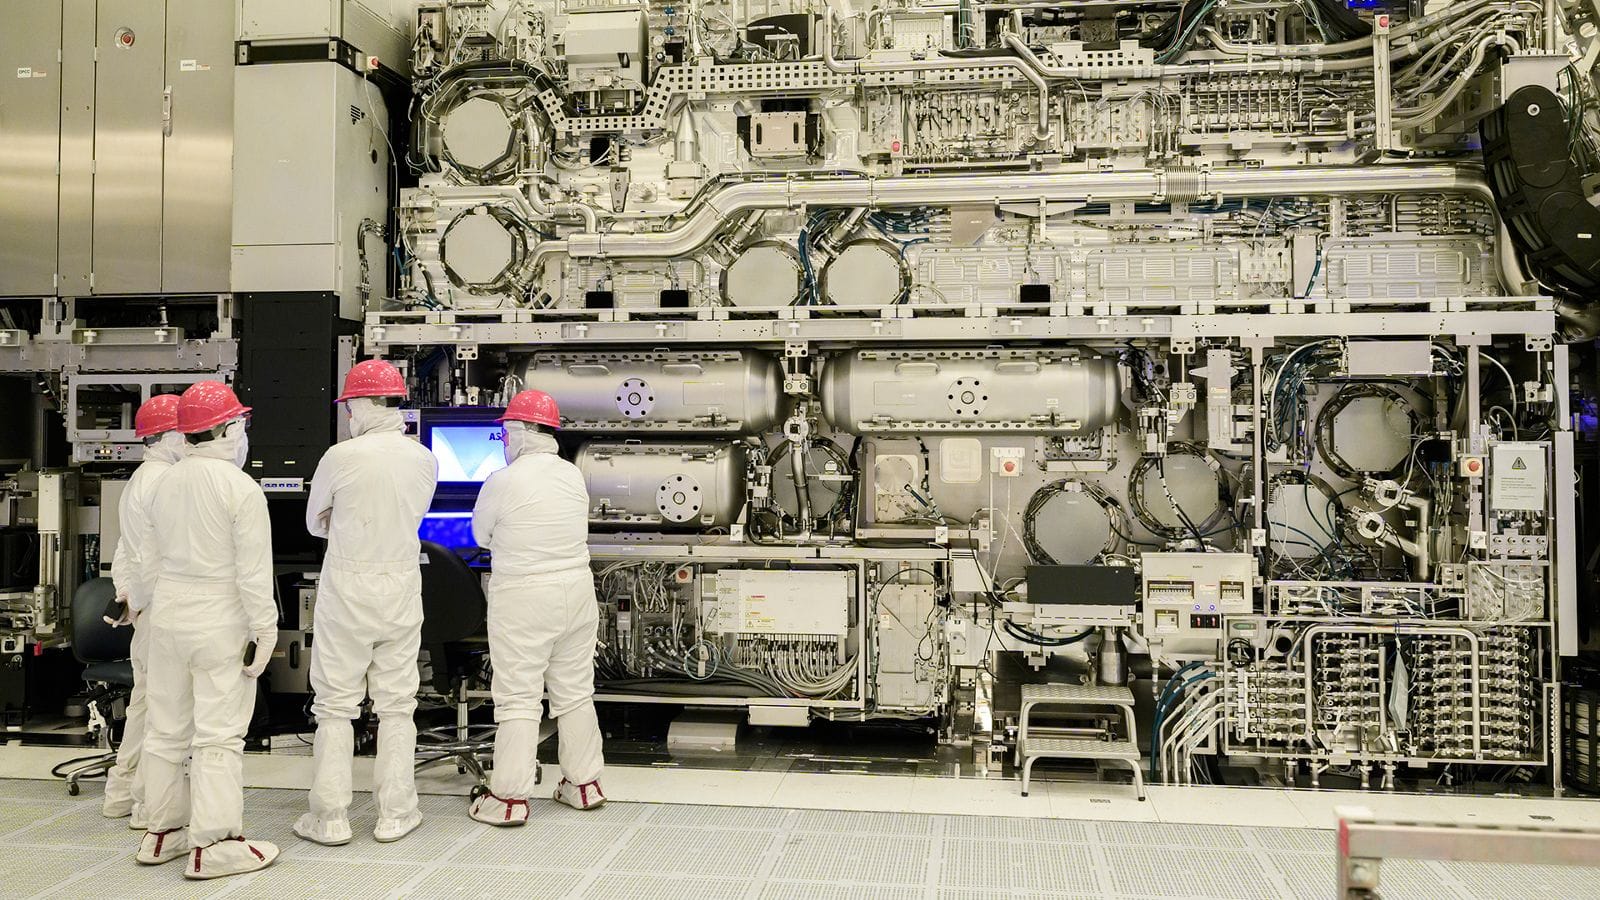
사진은 Intel Oregon의 ASML EXE:5000 High NA EUV 장비다. 빛으로 작은 패턴을 만드는 능력에 더해, 이전 층과의 정렬, 장비 간 일치, 가동시간이 생산량을 결정한다. 제조사는 측정 결과를 공정 설정에 되돌려 보내 오차를 줄인다. 장비 사진, ASML 측정 기술.
예를 들어 한 장비군이 시간당 100회 작업하고, 웨이퍼마다 그 장비군을 50번 거친다면 처리량은 시간당 2장이다. 생산에 쓸 수 있는 시간이 80%면 1.6장으로 내려간다. 장비의 작업 속도, 반복 방문 횟수, 가동률을 함께 봐야 공장의 처리량을 계산할 수 있다.
새 공정은 설계와도 맞아야 한다. PDK와 IP를 이용해 만든 회로가 실제 실리콘에서 목표 전압·주파수·전력을 충족해야 한다. 장비 반입 이후에도 시험 생산, 결함 분석, 설계·공정 수정, 신뢰성 평가가 이어진다.
5. 마지막 병목: 칩을 붙이고 검사하는 일
양품 logic die를 얻으면 메모리·다른 칩렛·기판과 연결한다. Foveros처럼 die를 위아래로 쌓는 방식은 접합 위치와 표면 상태를 정밀하게 관리해야 한다. 접합 하나의 결함이 이미 완성된 여러 die의 가치를 함께 잃게 만들 수 있기 때문이다.
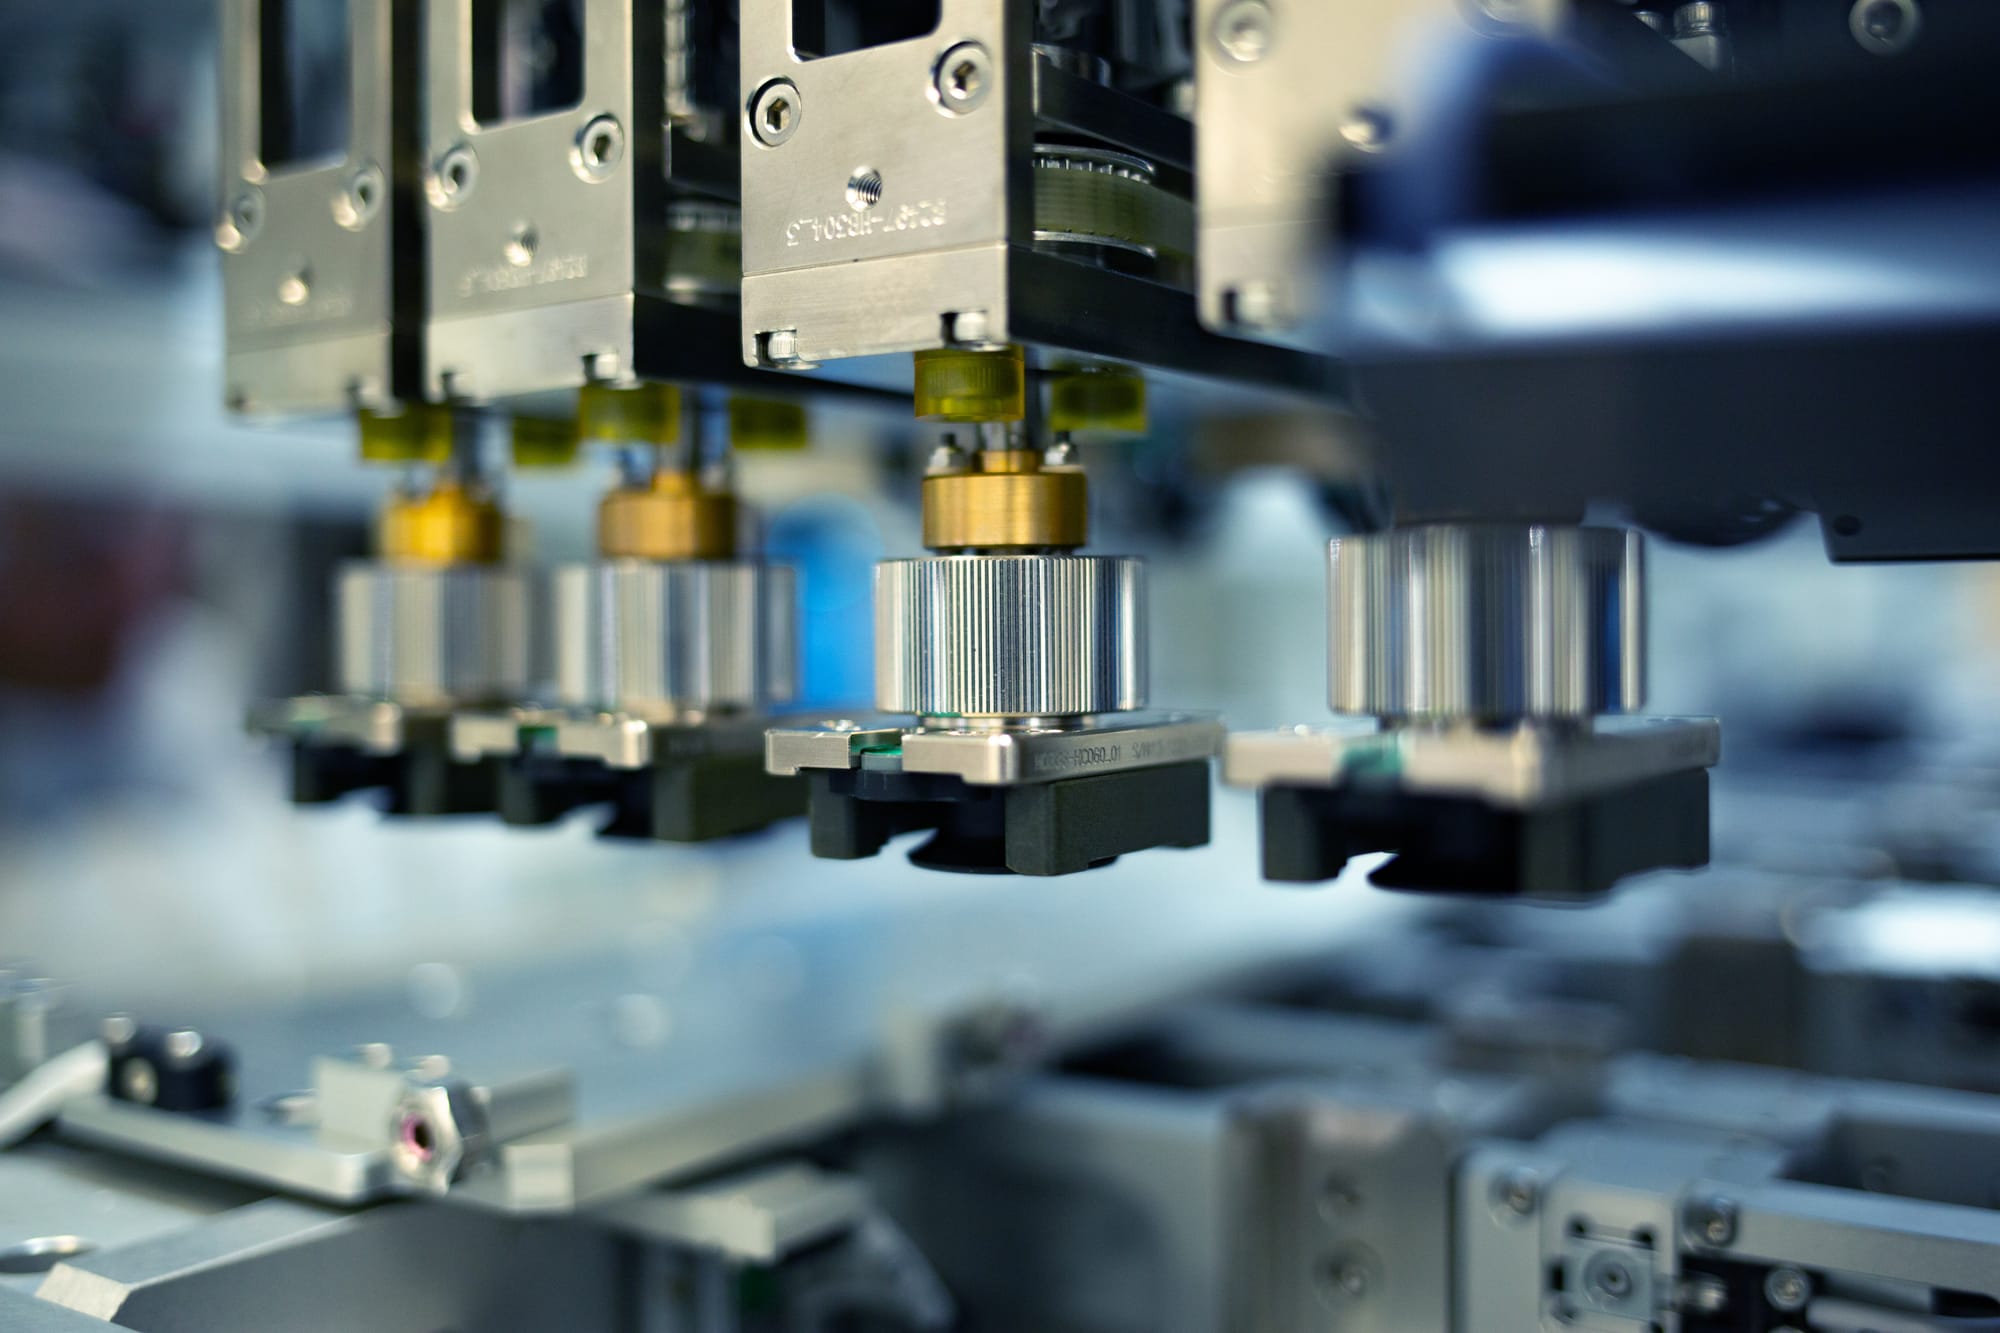
사진은 Intel 공장에서 완성된 패키지를 다루는 자동화 핸들러다. 웨이퍼 생산 뒤에도 접합과 패키지 처리·검사를 위한 별도 설비와 시간이 필요하다. 공식 자료.
생산능력을 같은 완성품 단위로 맞춰 보자. 월간 logic 공급 100개, 메모리 공급 80개, 조립 90개, 최종 전기검사 70개라면 출하는 최대 70개다. logic을 120개로 늘려도 출하는 그대로다. 검사능력을 85개로 올린 뒤에는 메모리 80개가 다음 병목이 된다.
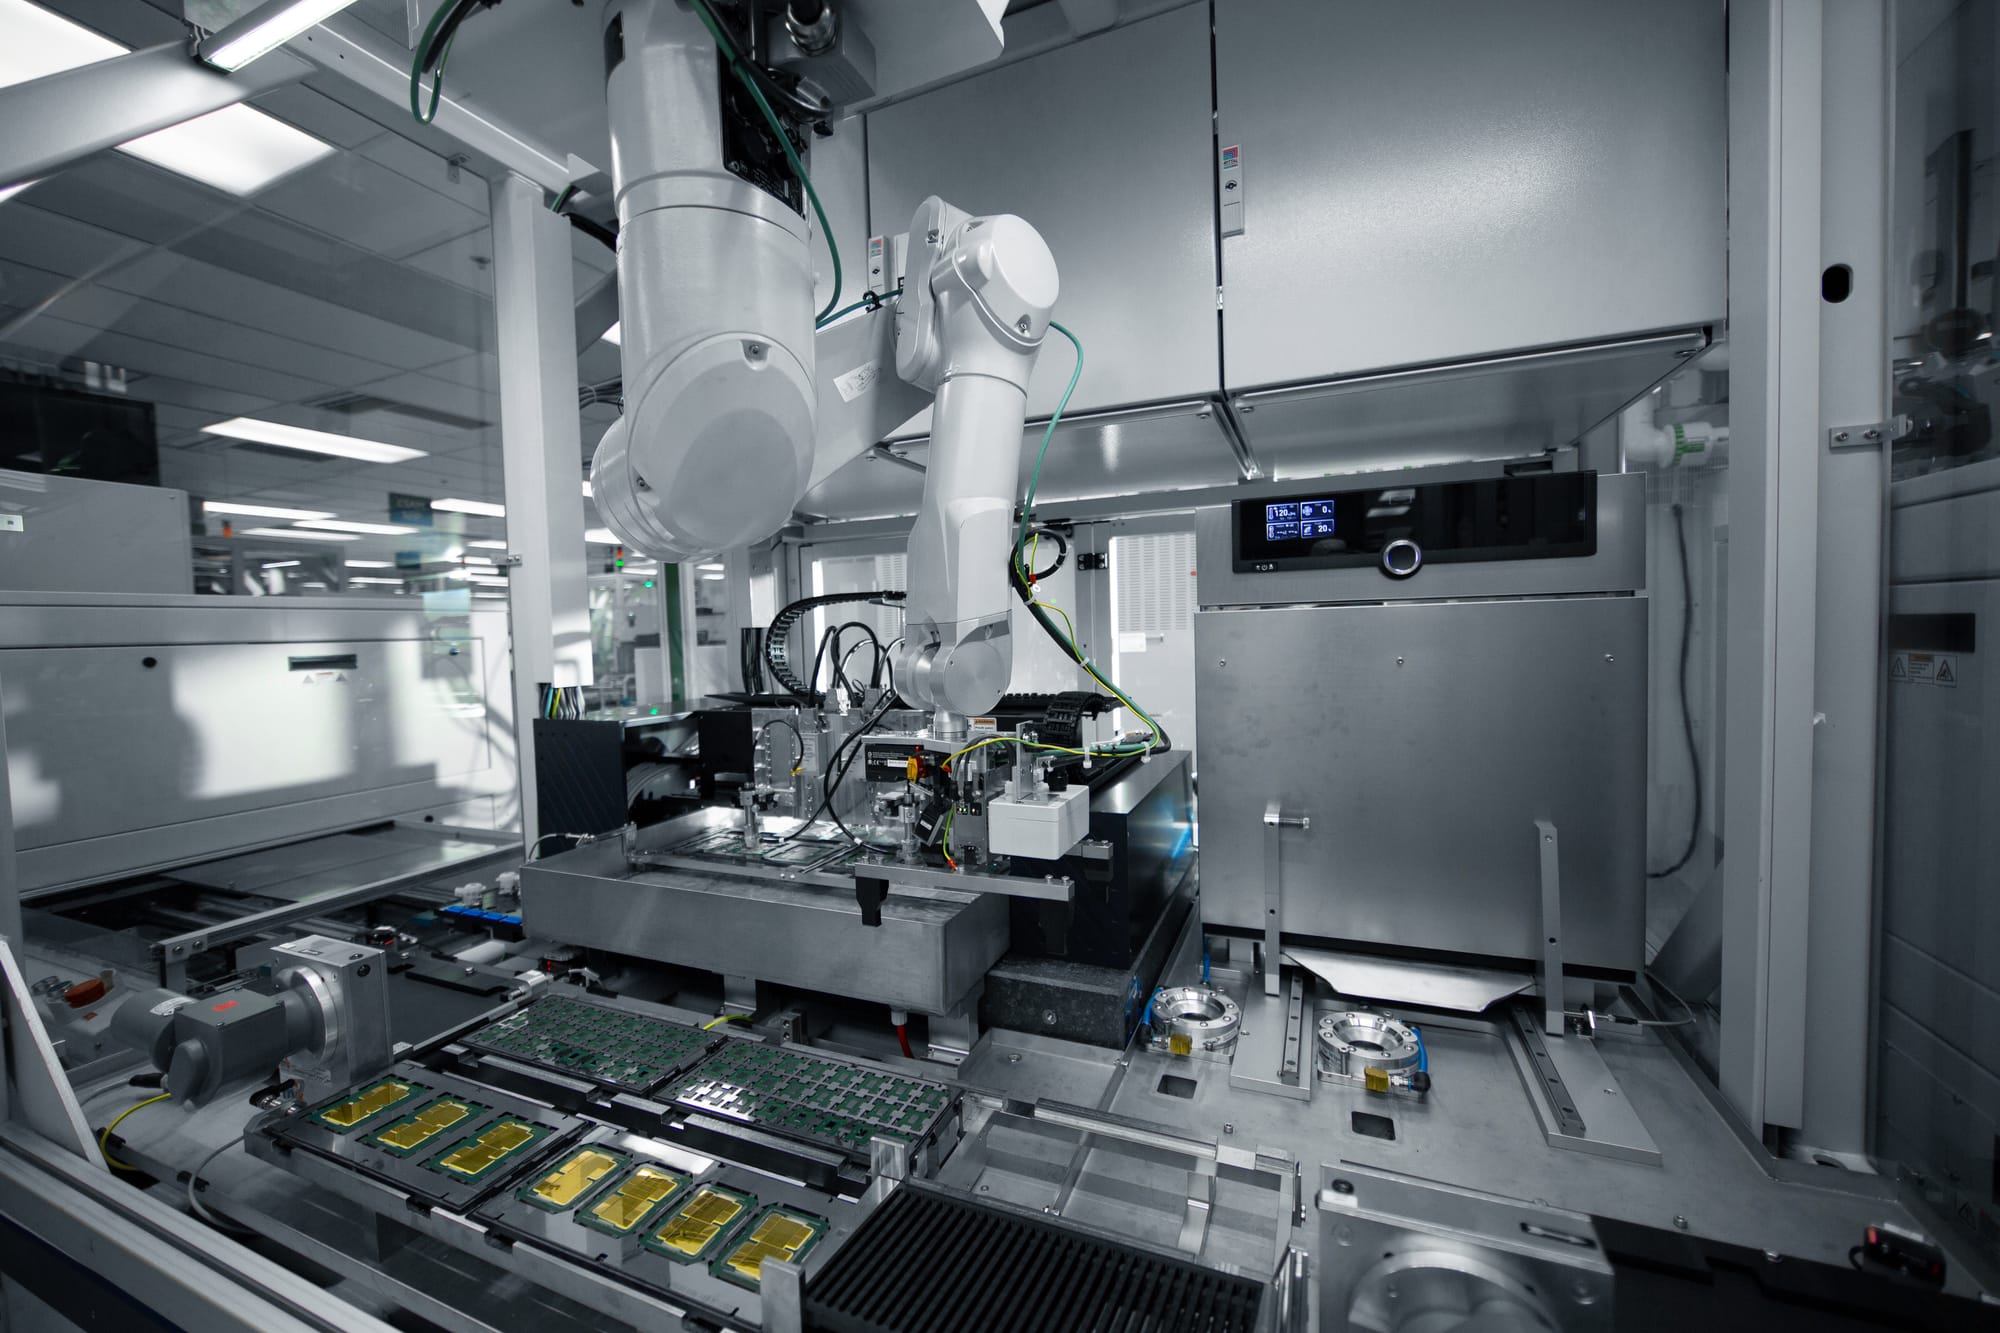
사진은 Intel의 데이터센터 GPU 초음파 검사다. 패키지 내부 구조를 확인하는 검사와 칩을 구동해 기능·전력·성능을 확인하는 전기검사는 목적이 다르다. 출하품은 제품에 필요한 검사들을 모두 통과해야 한다.
VLSI Korea view: logic·memory·패키징 통합의 가치는 세 시설을 가까이 놓는 데서 끝나지 않는다. 가장 느린 단계를 찾아 줄이고, 불량 원인을 설계와 공정에 빠르게 돌려보내는 데 있다.
테라팹의 다음 진척은 제품별 공정 → 시험 칩 → 패키지·신뢰성 평가 → 반복 출하 순서로 읽으면 된다. 이번 편의 계산에서 빠져 있는 실제 die 크기와 수율, 메모리 구성, 공장별 처리량이 공개될수록 ‘1 TW’는 더 구체적인 제조 계획으로 바뀐다.
자료 확인: 2026-09-29. 다음 편은 TSMC 팹별 역할과 생산능력의 단위를 다룬다.
Disclosure
공개 자료를 바탕으로 작성한 기술 해설이며, 투자 권유가 아닙니다.


