 VLSI Korea
INT8 가속기의 정확도는 곱셈 뒤에서 갈린다
스케일·반올림·포화 규칙을 맞추지 않으면 같은 양자화 모델도 다른 답을 낸다. RISC-V와 FPGA 설계자가 먼저 검증할 출력 경로를 짚는다.


INT8 모델을 가속기에 올렸는데 정확도가 떨어졌다면, 곱셈기를 넓히기 전에 누산 결과를 다음 층의 정수로 바꾸는 경로를 확인해야 한다. 입력 비트 수가 같아도 채널별 스케일, 영점, 반올림 순서가 다르면 다음 층이 받는 값은 달라진다.
이 글은 RTL 설계자가 어떤 산술 동작을 보존해야 하는지, 모델 배포 담당자가 어느 단계부터 오차를 추적해야 하는지 설명한다. 회로를 줄일 때 유지할 기능과, 모델을 다시 학습하기 전에 비교할 기준 출력을 결정하는 데 초점을 맞춘다.
VLSI Korea view: INT8 지원 여부보다 중요한 것은 모델 변환기와 가속기가 같은 정수 연산 규칙을 실행하는가다. 면적 절감은 그 일치를 확인한 뒤에 평가해야 한다.
같은 INT8이라는 말에 빠진 정보
사진의 장치는 ztachip 공식 가이드에 실린 Digilent Arty A7-100T와 카메라·VGA 연결 구성이다. ztachip은 RISC-V 기반 가속기와 소프트웨어를 함께 제공하는 공개 프로젝트이며, 이처럼 실제 보드에 모델을 올리는 과정에서는 변환기와 회로 사이의 약속이 작동 여부를 좌우한다. ztachip 프로젝트, 공식 보드 구성
지금 이 질문을 꺼내는 계기는 2026년 10월 1일 제출된 ZTA-Q 프리프린트다. 저자들은 ztachip을 확장한 Arty A7-100T 구현에서 채널별 재양자화와 반올림을 함께 다뤘고, 비교한 근사화 가운데 시프트 반올림을 없앴을 때 수치 오차가 크게 늘었다고 보고한다. 메타데이터의 ICECS 2026 채택 표기는 저자 신고이며, 오늘 새로 발표된 결과라는 뜻은 아니다. ZTA-Q 원문과 제출 이력
여기서 재양자화는 넓은 누산값을 다음 연산이 받아들일 낮은 비트 수의 정수로 되돌리는 과정이다. 곱셈과 덧셈이 모두 맞아도 이 마지막 변환에서 출력이 달라질 수 있으므로, MAC의 일치만으로 전체 가속기의 정확성을 판정할 수 없다.
| Boundary | Question | Evidence to retain |
|---|---|---|
| Float to integer model | Did conversion change the task result? | Calibration inputs and integer model |
| Integer model to hardware | Did implementation change the arithmetic? | Layer outputs and operator parameters |
| Hardware to application | Does the deployed result meet the product need? | Accuracy, latency and power conditions |
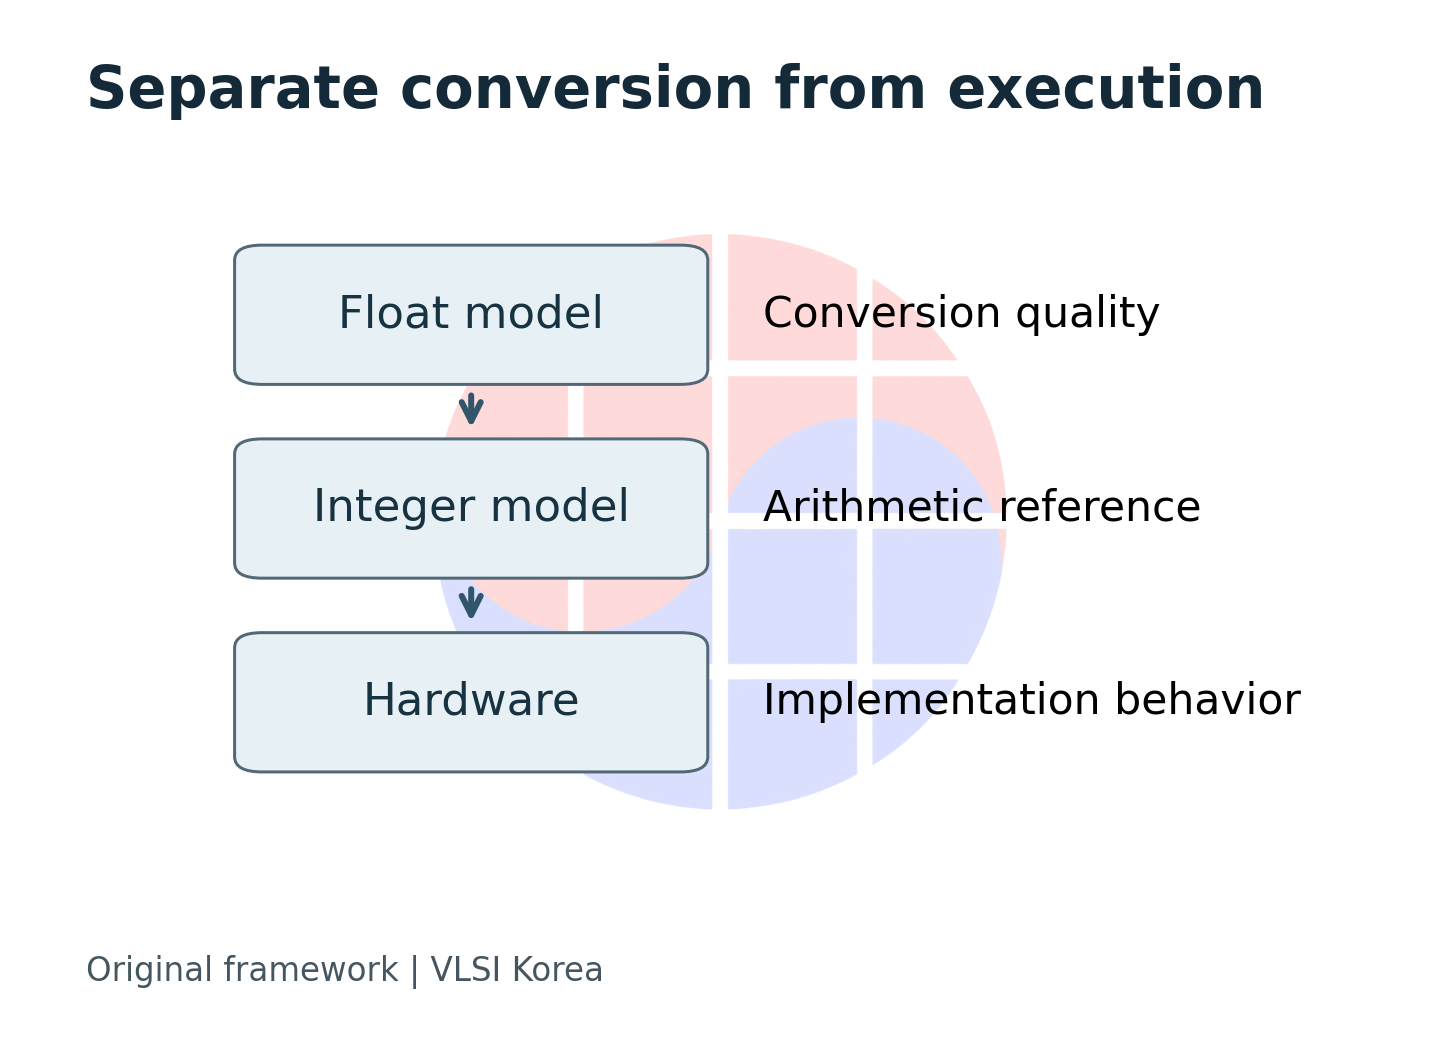
이 구분은 원인에 맞는 수정을 가능하게 한다. 정수 기준 모델부터 목표 정확도를 놓쳤다면 데이터와 변환 방식을 살피고, 정수 기준은 통과하는데 보드에서만 틀린다면 연산 매핑과 구현을 먼저 살펴야 한다.
모델 팀이 재학습하고 하드웨어 팀이 비트 수를 늘리는 일을 동시에 시작하면, 어느 변경이 문제를 해결했는지 알기 어렵다. 먼저 실패가 시작되는 경계를 찾는 편이 다음 실험의 설명력을 높인다.
정수 코드에는 단위와 영점이 붙는다
정수 코드 q가 나타내는 실수는 x = s × (q − z)로 생각할 수 있다. s는 코드 사이의 간격인 스케일이고 z는 실제 값 영에 대응하는 정수 코드다. LiteRT의 INT8 규격은 합성곱 가중치에 채널별 스케일을 허용하며, 가중치 영점과 활성값 영점에 서로 다른 제약을 둔다. Google LiteRT 규격
스케일이 다르면 같은 코드도 다른 크기를 나타낸다. 따라서 합성곱 결과를 저장할 때는 입력과 가중치의 단위로 쌓인 누산값을 출력 단위로 바꿔야 하며, 출력 채널마다 가중치 스케일이 다르면 변환 계수도 달라진다.
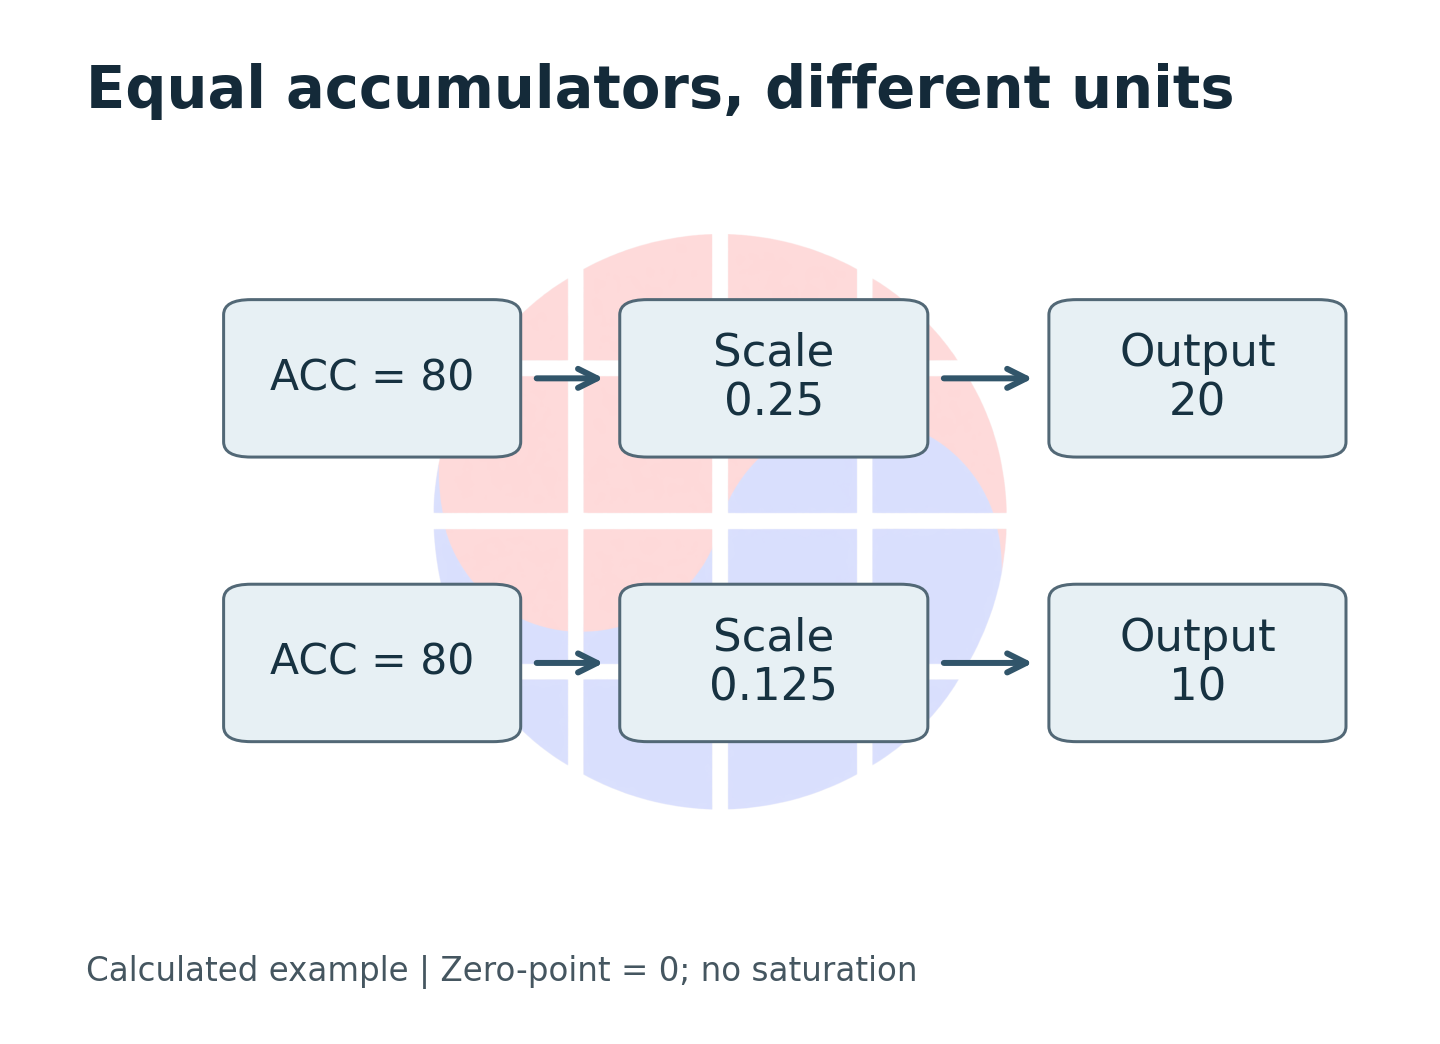
그림의 예에서는 누산값 80에 유효 스케일 0.25를 곱하면 20, 0.125를 곱하면 10이다. 이는 실제 신경망의 측정값이 아니라 단위 변환만 분리한 계산이며, 같은 시프트나 계수를 모든 채널에 적용하는 최적화가 왜 별도 검증을 필요로 하는지 보여준다.
메모리에서 계수를 읽었다는 사실만으로 올바른 계수를 썼다고 할 수는 없다. 채널을 묶거나 타일 순서를 바꾸는 컴파일러는 가중치뿐 아니라 그 채널의 계수도 같은 순서로 옮겨야 한다.
| Parameter | Meaning | A useful failure probe |
|---|---|---|
| Scale | Real-value step per integer code | Adjacent channels with different scales |
| Zero-point | Integer code representing real zero | Padded border and zero-valued input |
| Channel axis | Dimension indexed by scale values | Channel permutation with matching metadata |
| Output range | Codes the next operator can receive | Values just inside and outside the limits |
영점은 패딩에서도 드러난다. 실제 영을 채워야 하는 경계에 정수 코드 영을 무조건 기록하면, z가 영이 아닌 모델에서는 다른 값을 입력한 셈이 된다. gemmlowp의 설계 문서는 실제 영을 정확히 표현하는 조건을 양자화 산술의 출발점으로 설명한다. gemmlowp 산술 설명
설계자가 얻어야 할 산출물은 ‘INT8 합성곱 지원’이라는 한 줄보다 구체적이다. 입력·가중치·출력 각각의 스케일과 영점, 채널 축, 바이어스의 단위까지 고정한 연산 명세가 있어야 같은 모델을 두 구현에 넣고 비교할 수 있다.
버리는 비트가 다음 층의 입력을 바꾼다
재양자화 계수는 회로에서 정수 곱셈과 시프트의 조합으로 구현할 수 있다. 이때 버리는 하위 비트를 어떻게 처리하는지와, 중간 결과를 어느 지점에서 반올림하는지는 계산의 일부다. gemmlowp는 넓은 누산기 뒤에 별도의 출력 파이프라인을 두어 이런 변환을 표현한다. gemmlowp 출력 경로
NVIDIA TensorRT의 INT8 양자화 정의에는 가장 가까운 정수로 반올림하되 정확히 중간이면 짝수를 택하는 규칙이 명시돼 있다. 모든 런타임이 같은 세부 동작을 갖는다는 뜻은 아니며, 가져올 모델의 기준 연산을 확인할 때 살필 항목의 예다. TensorRT 양자화 정의
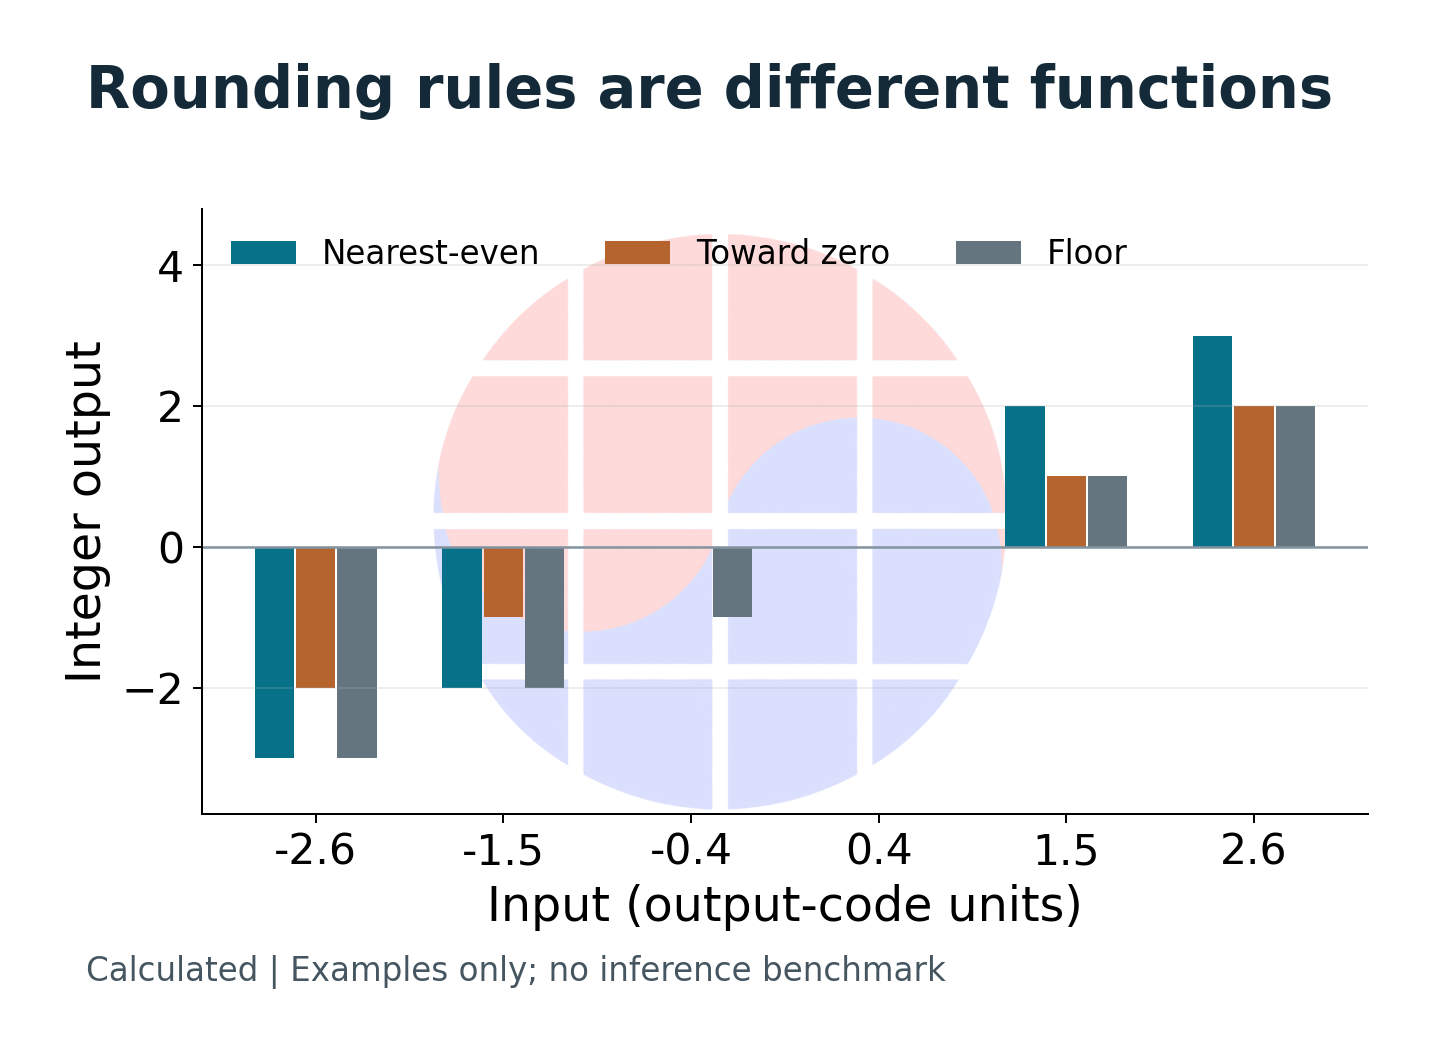
예를 들어 1.5는 짝수 쪽 최근접 반올림에서 2가 되지만 영 방향 버림에서는 1이다. −1.5는 각각 −2와 −1이 되므로, 양수만 확인한 테스트는 음수 동작의 차이를 놓친다.
부호 있는 정수를 산술 우측 시프트하는 동작도 영 방향 버림과 구별해야 한다. 버려지는 부분이 있는 음수에서는 바닥값 쪽으로 내려가는 결과가 생기며, 부호 확장과 반올림 보정을 섞어서 구현하면 양수에서는 맞고 음수에서는 어긋나는 오류를 만들 수 있다.
검증의 경계: 비트 단위 불일치는 원인을 찾는 신호다. 그 자체를 최종 분류 정확도의 동일한 크기 감소로 환산할 수는 없다.
한 출력 코드의 차이가 다음 층을 지나며 사라질지 커질지는 모델과 입력에 달려 있다. 구현의 정확성은 층별 수치 비교로, 제품에 미치는 영향은 전체 모델의 작업 지표로 확인해야 한다.
반올림을 두 번 적용하는 경로와 넓은 중간값을 유지한 뒤 한 번 적용하는 경로도 일반적으로 같은 연산이 아니다. 설계 명세에는 최종 반올림 이름뿐 아니라 중간 비트 폭, 연산 순서, 포화 지점까지 적어야 회로와 참조 코드가 같은 대상을 시험한다.
좁은 출력의 비용을 어디에서 낼 것인가
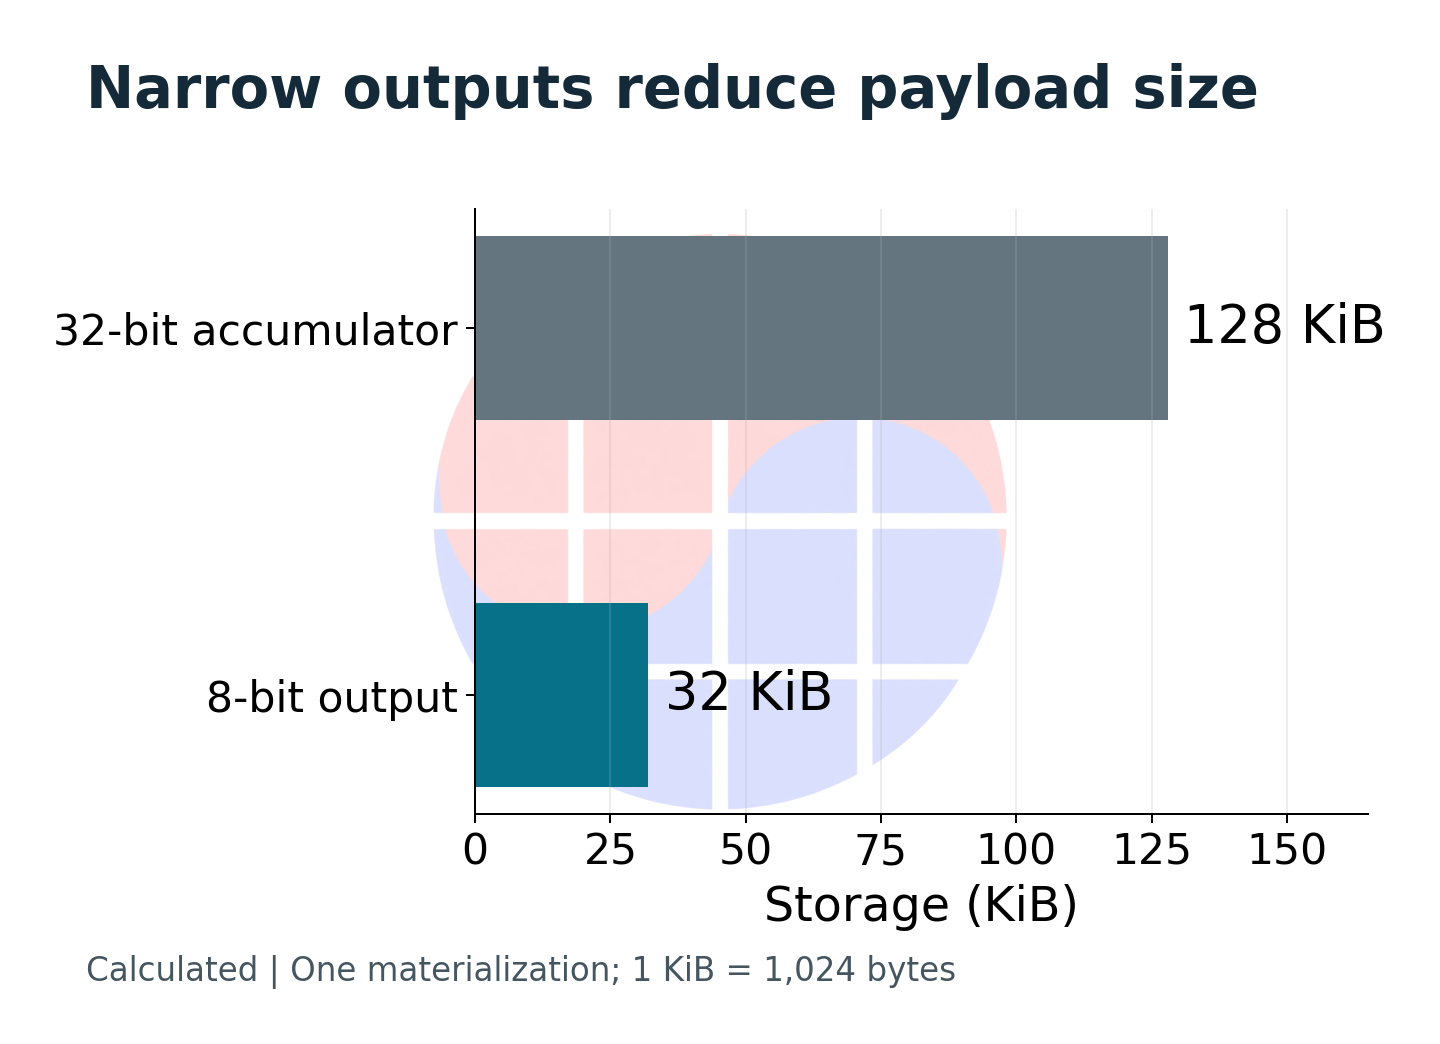
재양자화는 정확도만의 문제가 아니다. 넓은 누산값을 메모리에 내보낸 뒤 CPU에서 줄일지, 가속기 안에서 낮은 비트 수로 바꿔 내보낼지에 따라 저장 공간과 전송량이 달라진다.
가정한 출력 텐서에 32,768개 값이 있을 때, 값마다 32비트를 저장하면 128 KiB이고 8비트로 저장하면 32 KiB다. 이 계산은 값 자체의 크기만 세며, 메타데이터·정렬 패딩·읽기와 쓰기의 반복은 포함하지 않는다.
출력 경로에 회로를 더 넣으면 넓은 중간값이 이동하는 거리를 줄일 기회가 생긴다. 반대로 채널마다 다른 계수와 시프트를 공급하려면 레지스터·배선·제어가 필요하므로, 단순히 저장량 비율을 전력 절감률로 읽어서는 안 된다.
이 부분의 설계 선택은 ‘곱셈기를 적게 쓰면 좋다’보다 조건이 많다. 여러 출력이 하나의 변환기를 공유하면 회로를 줄일 수 있지만, 출력 발생 속도를 따라가지 못할 때는 버퍼가 차고 연산기가 기다릴 수 있다.
| Choice | Potential benefit | Condition to measure |
|---|---|---|
| Convert near the accumulator | Move narrower outputs | Added datapath area and timing |
| Share a conversion unit | Reuse arithmetic resources | Service rate and queue occupancy |
| Process on the CPU | Reuse software arithmetic | Transfer cost and end-to-end latency |
세 선택의 우열은 모델에 따라 바뀐다. 출력이 드문 연산에는 공유 회로가 충분할 수 있고, 출력이 연속되는 연산에는 후처리 처리율이 병목이 될 수 있다.
따라서 같은 입력 집합과 실행 조건에서 정확도, 지연시간, 자원 사용을 함께 비교해야 한다. 그림의 저장량 계산은 어느 경로를 측정할지 정하는 출발점이며, 특정 FPGA나 ASIC의 면적·전력 결과를 대신하지 않는다.
첫 번째로 어긋나는 층을 찾는다
진단은 실수 기준 모델, 정수 기준 모델, 하드웨어 출력의 세 묶음을 보존하는 데서 시작한다. 첫 비교는 모델 변환의 영향을, 두 번째 비교는 그 정수 연산을 구현한 방식의 영향을 분리한다.
ONNX Runtime은 가중치와 중간 활성값을 대응시켜 비교하는 디버깅 도구를 제공한다. 문서는 그래프 최적화가 대응 관계를 흐트러뜨릴 수 있으므로 전처리와 양자화 단계를 분리해 다룰 것을 권한다. ONNX Runtime 양자화 디버깅
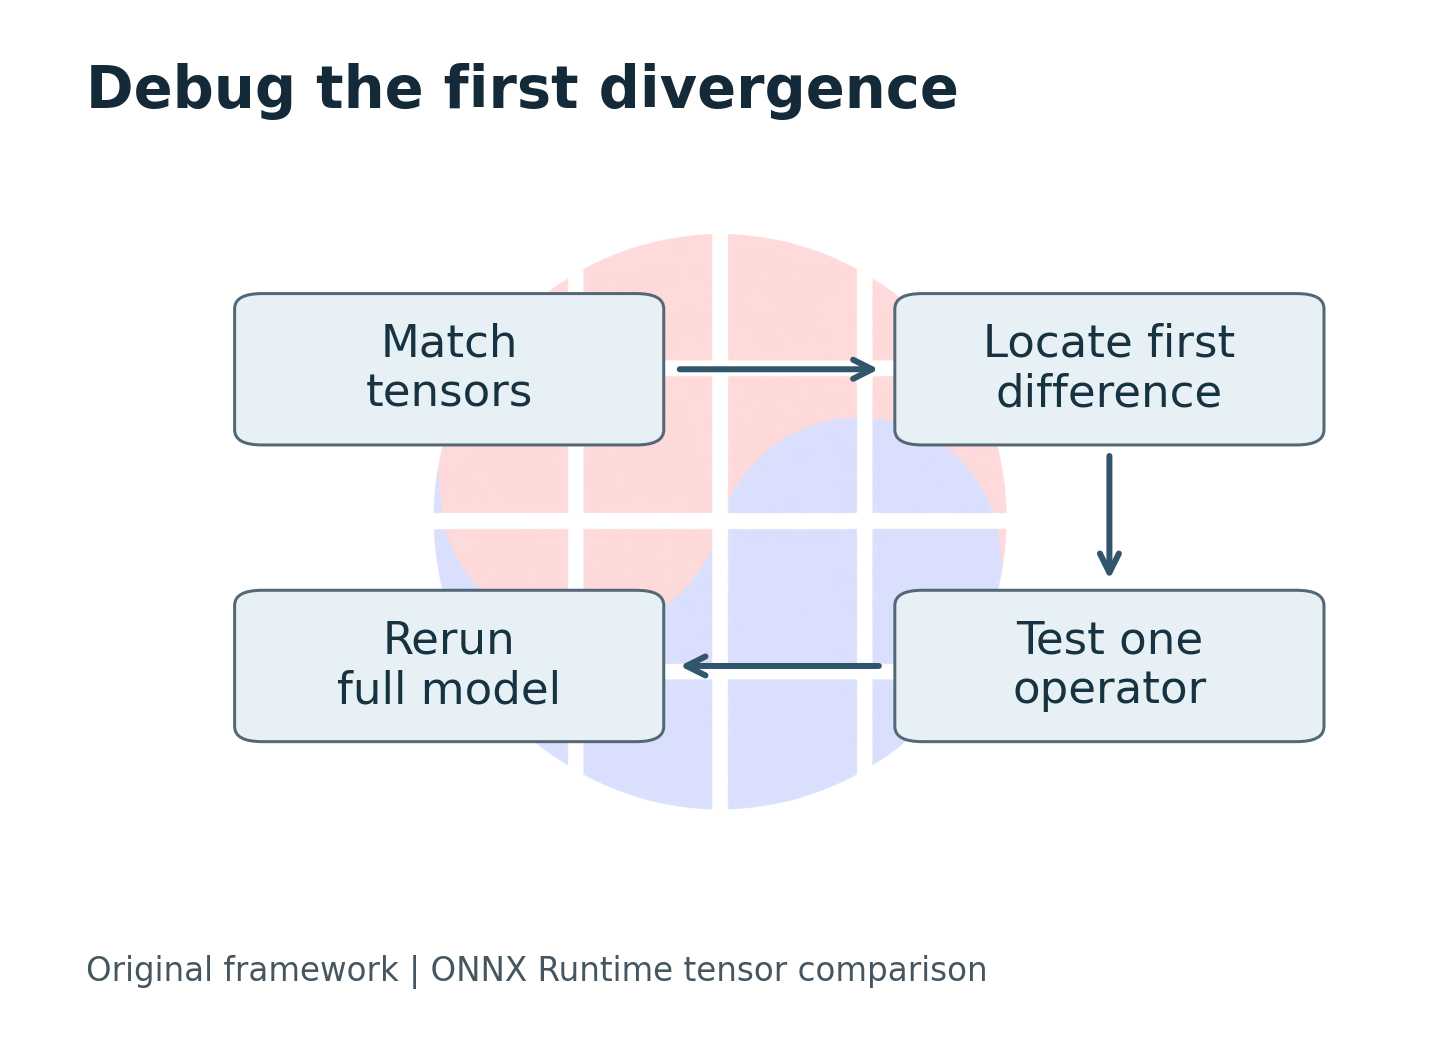
층 출력이 다를 때는 평균 오차만 보지 말고 위치도 본다. 채널 전체가 비슷한 비율로 어긋나는지, 영상 가장자리에서만 차이가 나는지, 음수와 포화 부근에서만 문제가 생기는지는 서로 다른 실험을 설계할 단서다.
이 패턴은 원인을 확정하는 공식이 아니다. 채널 계수 순서를 바로잡는 작은 변경으로 문제가 사라지는지, 동일한 입력을 참조 연산과 RTL에 넣었을 때 차이가 재현되는지 확인하는 출발점이다.
| Probe | What it isolates | Keep constant |
|---|---|---|
| Positive and negative half steps | Tie rule and sign handling | Scale and operation order |
| Values around saturation | Clamp boundary and overflow | Output type and activation |
| Different neighboring scales | Channel-to-coefficient mapping | Tensor layout and tile order |
| Border-only inputs | Padding and zero-point treatment | Shape, stride and padding mode |
작은 연산 테스트가 맞은 뒤에는 실제 모델로 돌아가야 한다. 단일 층에서 잘 맞는 구현도 연산 융합, 텐서 재배치, 지원하지 않는 연산의 대체 경로를 지나면 다른 결과를 낼 수 있다.
전체 정확도 수치와 함께 평가 데이터 식별자, 전처리, 모델 파일 해시, 런타임·컴파일러 버전을 남기면 변경 전후의 차이를 설명할 수 있다. 이 기록이 빠지면 정확도가 좋아져도 회로 수정의 효과인지 입력 파이프라인 변경의 효과인지 구별하기 어렵다.
호환성을 확인한 뒤 근사를 선택한다
양자화 하드웨어의 실무 목표는 모든 상황에서 가능한 한 넓게 계산하는 것이 아니다. 제품이 요구하는 작업 정확도와 지연시간을 만족하는 범위에서 저장·전송·계산 비용을 낮추는 것이다.
RTL 담당자는 먼저 기준 연산과 일치하는 경로를 만들고, 줄이려는 기능을 개별 변경으로 분리할 수 있다. 모델 담당자는 같은 데이터로 층별 오차와 최종 작업 지표를 비교해 어느 변경이 허용 범위를 넘는지 판단할 수 있다.
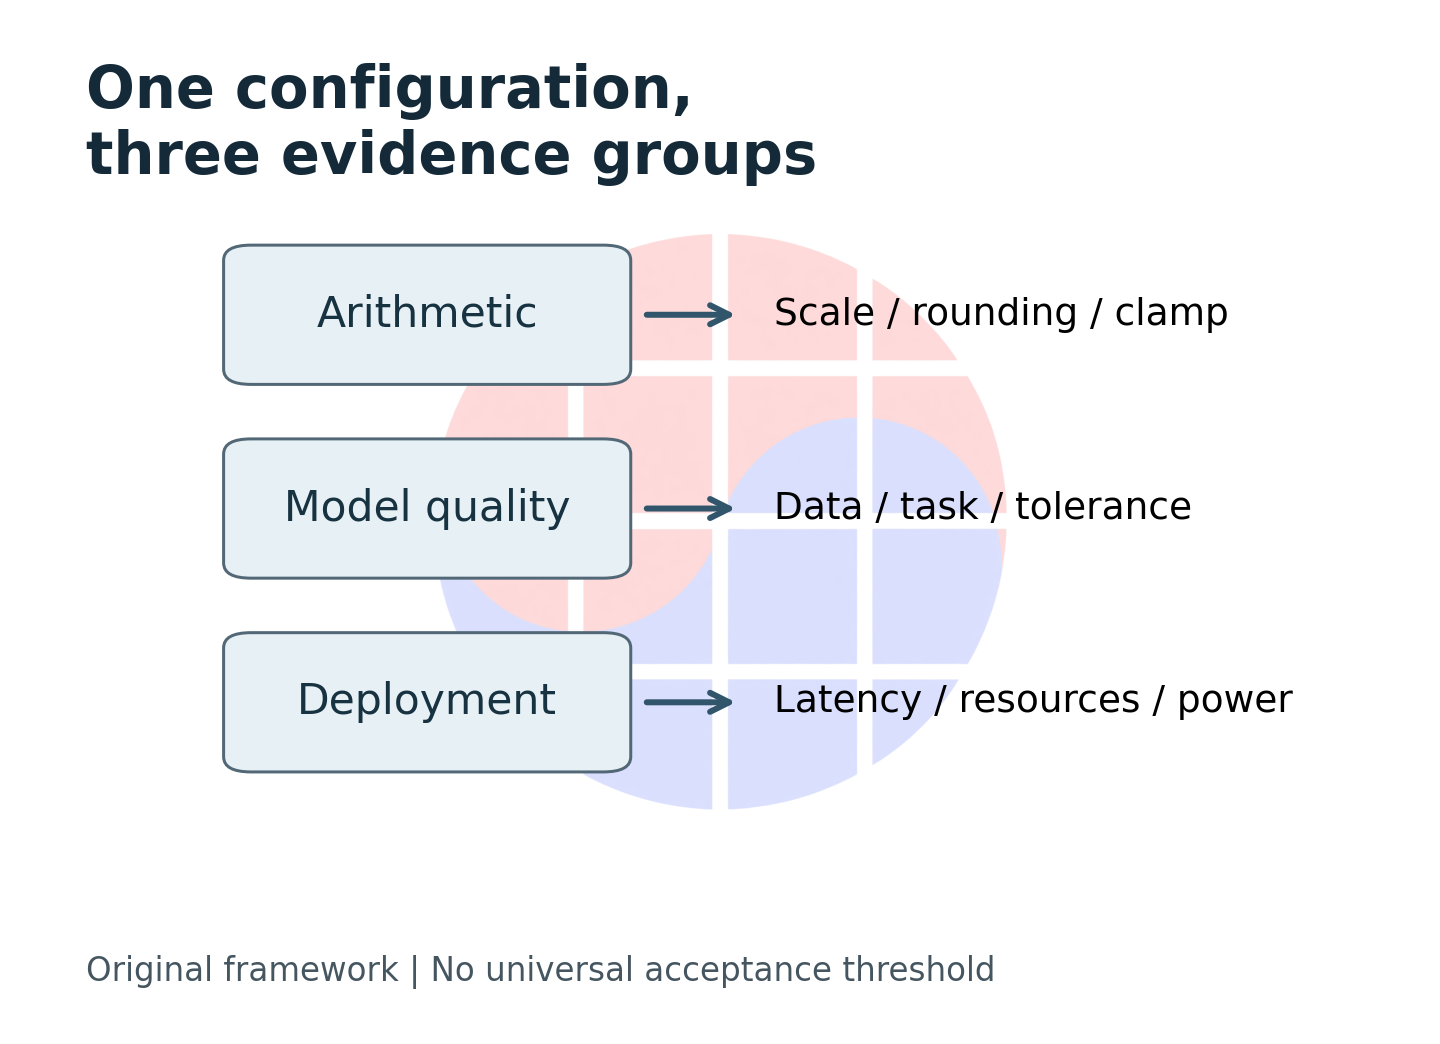
허용 오차를 두는 구현이라면 그 허용 범위를 평가 전에 정해야 한다. 결과를 본 뒤 불리한 클래스나 입력을 빼면 모델의 강건성을 설명할 수 없고, 평균 정확도가 같다는 이유로 드문 입력의 큰 실패를 숨길 수도 있다.
공급업체나 IP 팀과 논의할 때도 같은 원칙이 유효하다. 지원 비트 수와 연산 목록에 더해 변환기 버전, 반올림·포화 동작, 계층별 비교 자료, 전체 모델의 실행 조건을 요청하면 실제 통합 비용을 더 구체적으로 판단할 수 있다.
이 글의 판단이 달라질 조건은 명확하다. 배포할 모델이 더 단순한 출력 산술로도 사전에 정한 품질 기준을 반복해서 충족하고, 그 구현이 실제 자원이나 지연시간을 개선한다면 그 근사는 합리적 선택이다.
그때까지는 정확도 저하를 막연히 ‘양자화 손실’로 묶지 않는 편이 좋다. 다음 층에 어떤 정수 값을 넘기는지 설명할 수 있어야, 그 값을 더 싸게 만드는 설계도 선택할 수 있다.
Sources and scope
ZTA-Q는 전체 HTML 원문을 확인한 프리프린트이며 독립 재현은 수행하지 않았다. 사진은 기반 프로젝트 ztachip의 공식 구성으로, ZTA-Q 저자들의 실험 장치를 촬영한 사진은 아니다. 계산 그림은 명시한 가정에 따른 자체 예제다.
- ZTA-Q, v1: 2026-10-01
- Google LiteRT: INT8 quantization specification
- Google gemmlowp: quantization arithmetic
- ONNX Runtime: quantization and debugging
- NVIDIA TensorRT: quantization schemes
- ztachip: official hardware setup
AI assistance: 자료 정리·번역·도식 제작에 AI를 사용했다. 사실과 원문 대조 및 편집 판단은 별도 검토 대상이다.
Disclosure
본 글은 정보 제공만을 목적으로 하며, 특정 증권의 매수 또는 매도를 권유하는 것이 아닙니다. 본 글에 포함된 수치와 사실은 기업 공시, 언론 보도, 시장 조사 등 공개적으로 이용 가능한 자료를 바탕으로 작성되었으며, 해당 자료 또는 작성 과정에서 오류가 발생할 수 있습니다. 필자는 언급된 기업의 주식을 보유하고 있을 수 있습니다. 모든 투자 결정 및 그에 따른 결과는 독자의 책임입니다.


