VLSI Korea
Meta MTIA 100에서 500까지: 추천 ASIC이 6개월 주기 GenAI chiplet로 변한 이유
MTIA 100부터 500까지, 추천 ASIC이 HBM·network chiplet·MX4를 갖춘 6개월 주기 GenAI roadmap으로 변한 이유를 분석합니다.


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
이 글은 cloud AI accelerator의 세대별 architecture와 system economics를 비교해 구매·투자·공급망 판단을 내리려는 독자를 위한 글이다. 읽고 나면 peak 수치와 실제 model-level TCO를 분리하고, 다음 세대에서 검증할 지표를 선택할 수 있다.
자료 기준일: 2026-08-02
TL;DR
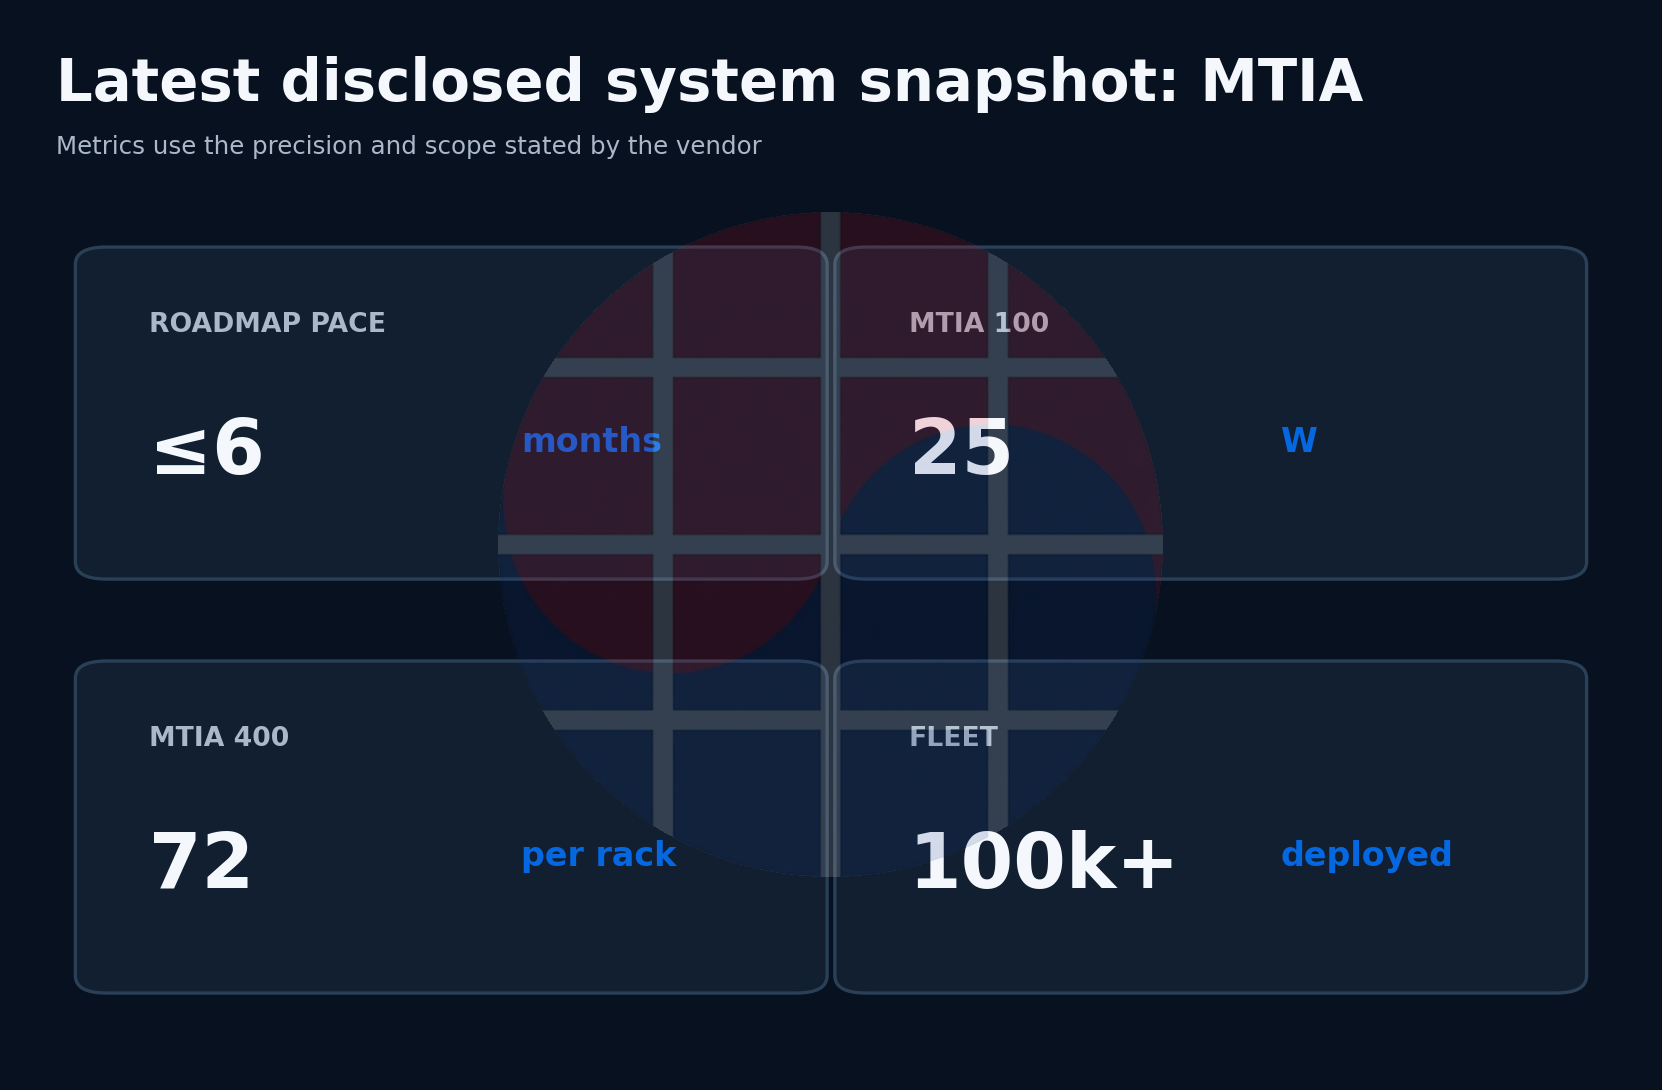
Meta의 MTIA는 처음부터 frontier training GPU를 대체하려 하지 않았다. MTIA 100은 25 W, LPDDR5, 128 MB SRAM, 64개의 RISC-V processing element로 small-batch ranking·recommendation inference의 낭비를 줄였다. MTIA 200은 5 nm, 90 W, 256 MB SRAM, 128 GB LPDDR5로 compute와 memory를 키우고 16개 지역에 빠르게 배포했다. 이후 MTIA 300은 HBM과 network chiplet, collective offload로 recommendation training을 맡고, 400은 72-device scale-up과 GenAI 범용성, 450·500은 HBM bandwidth와 MX4를 앞세운 GenAI inference로 이동했다.
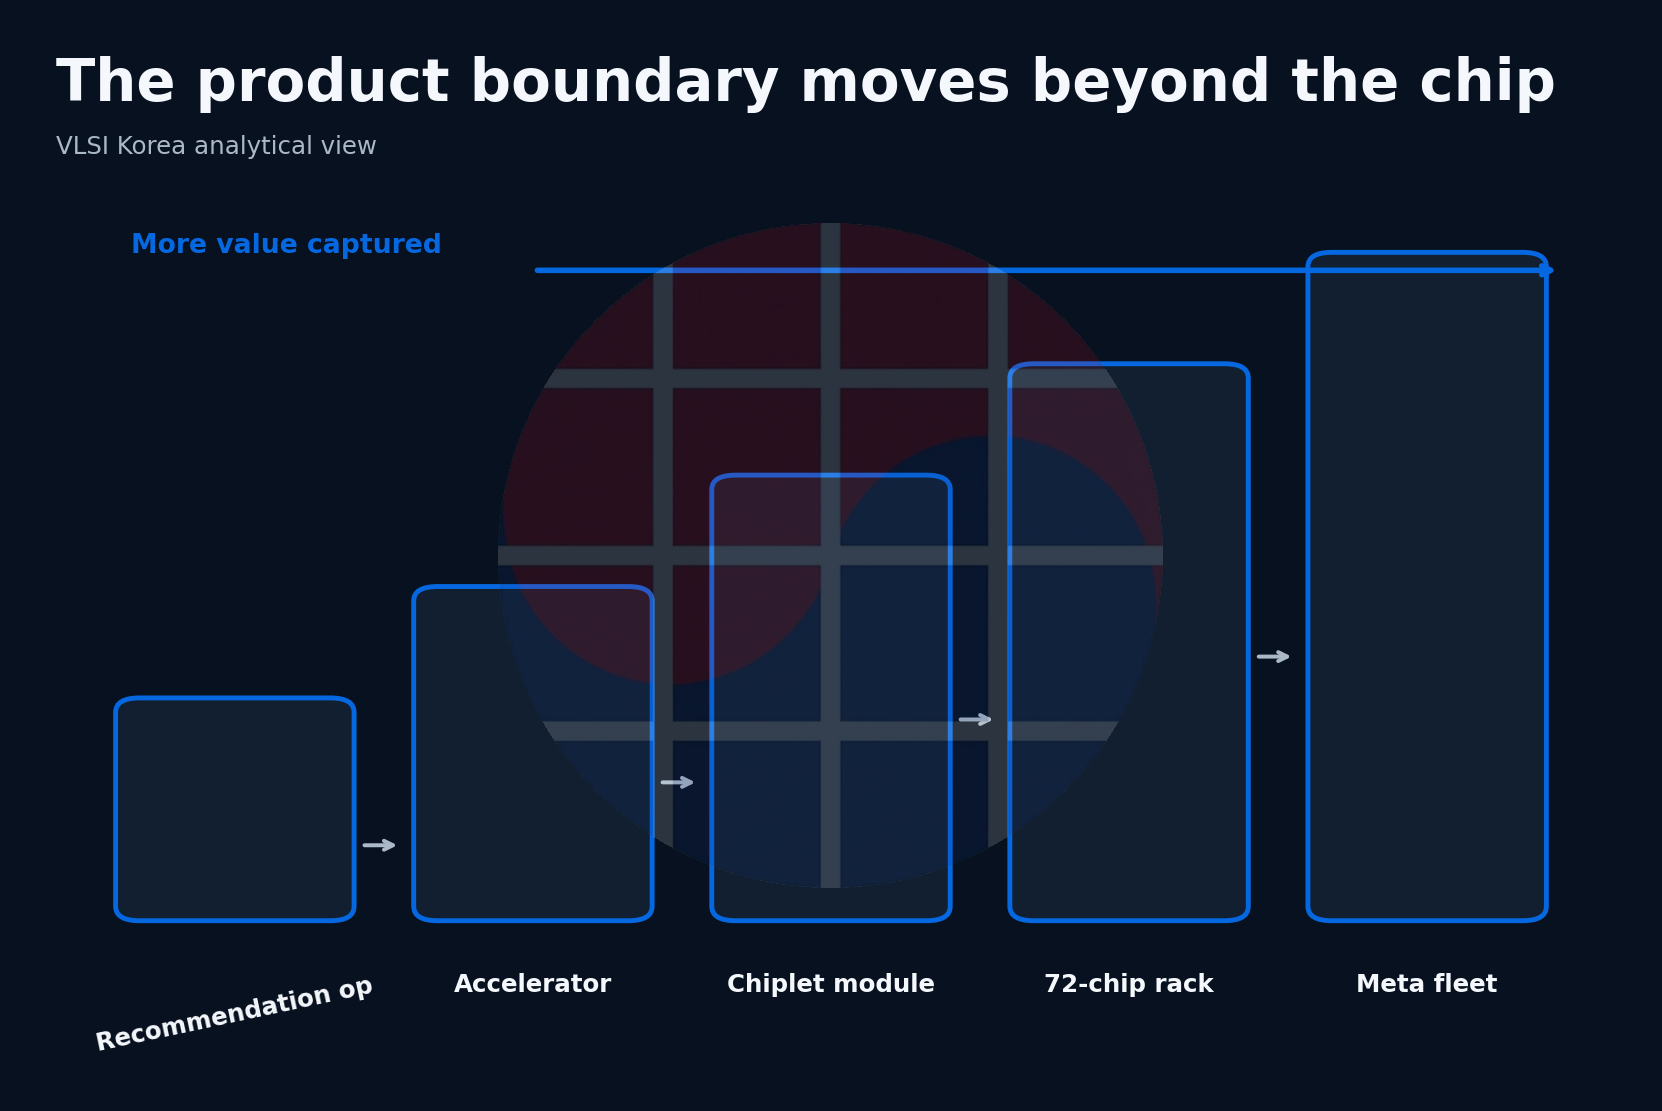
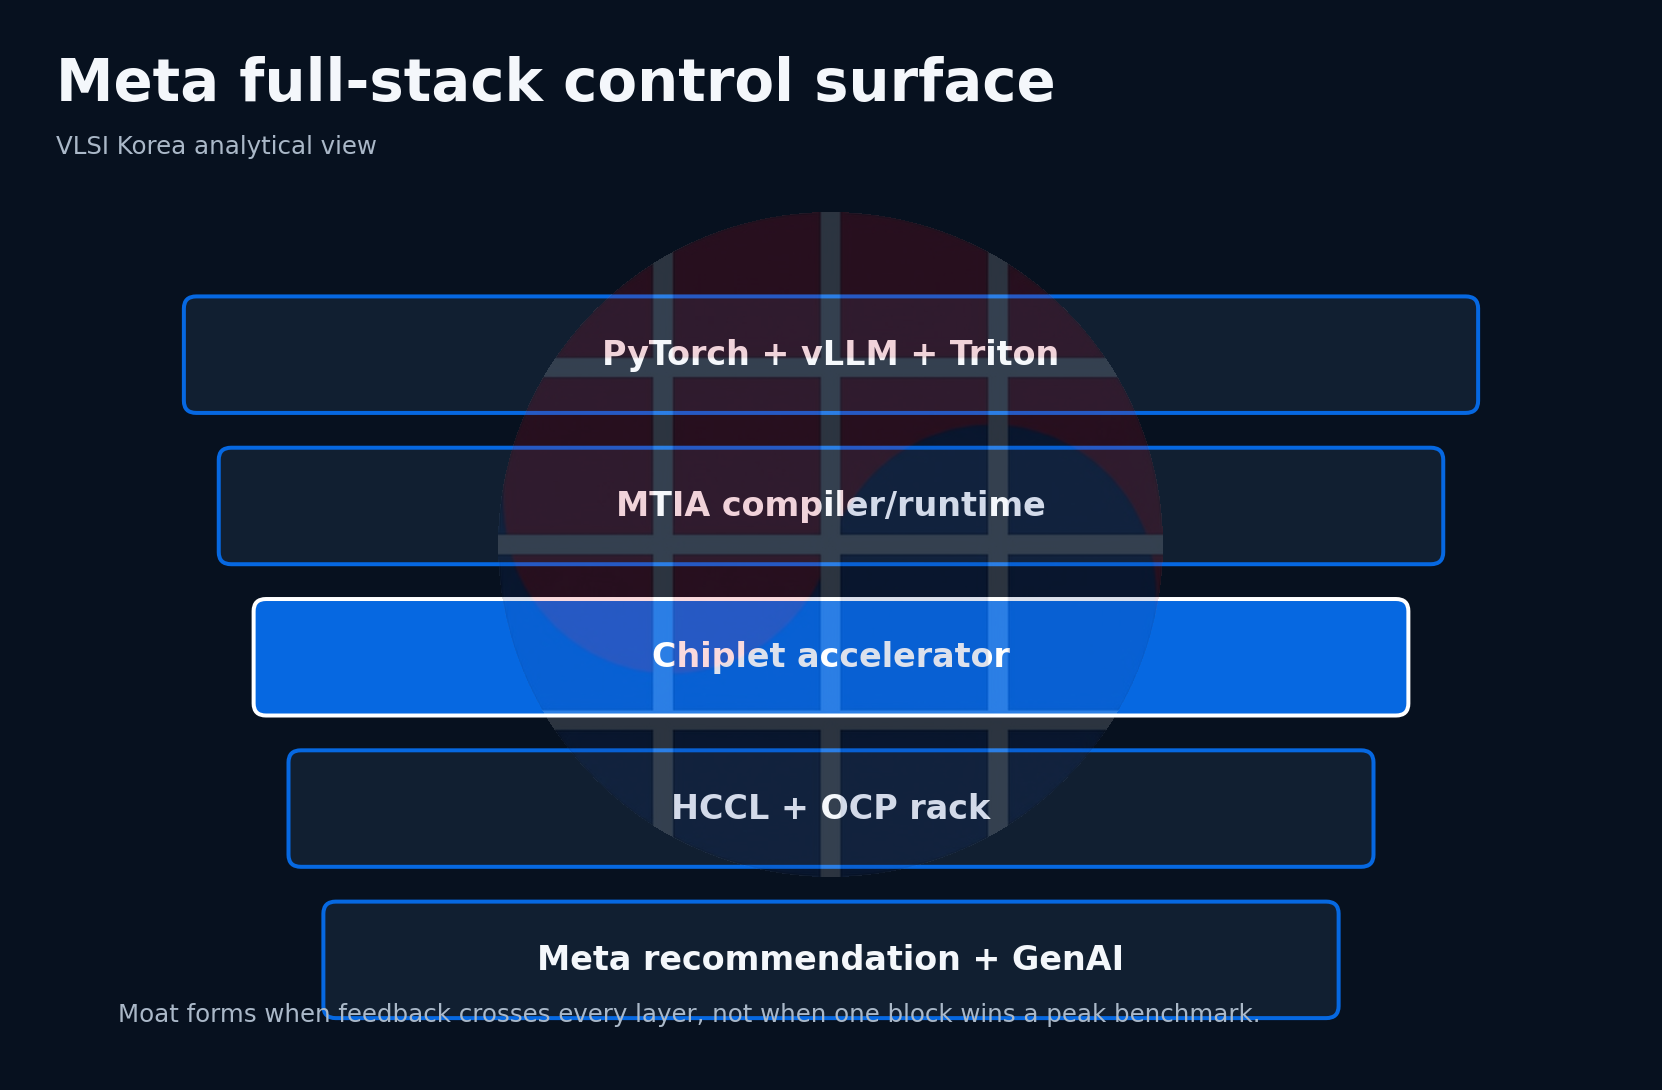
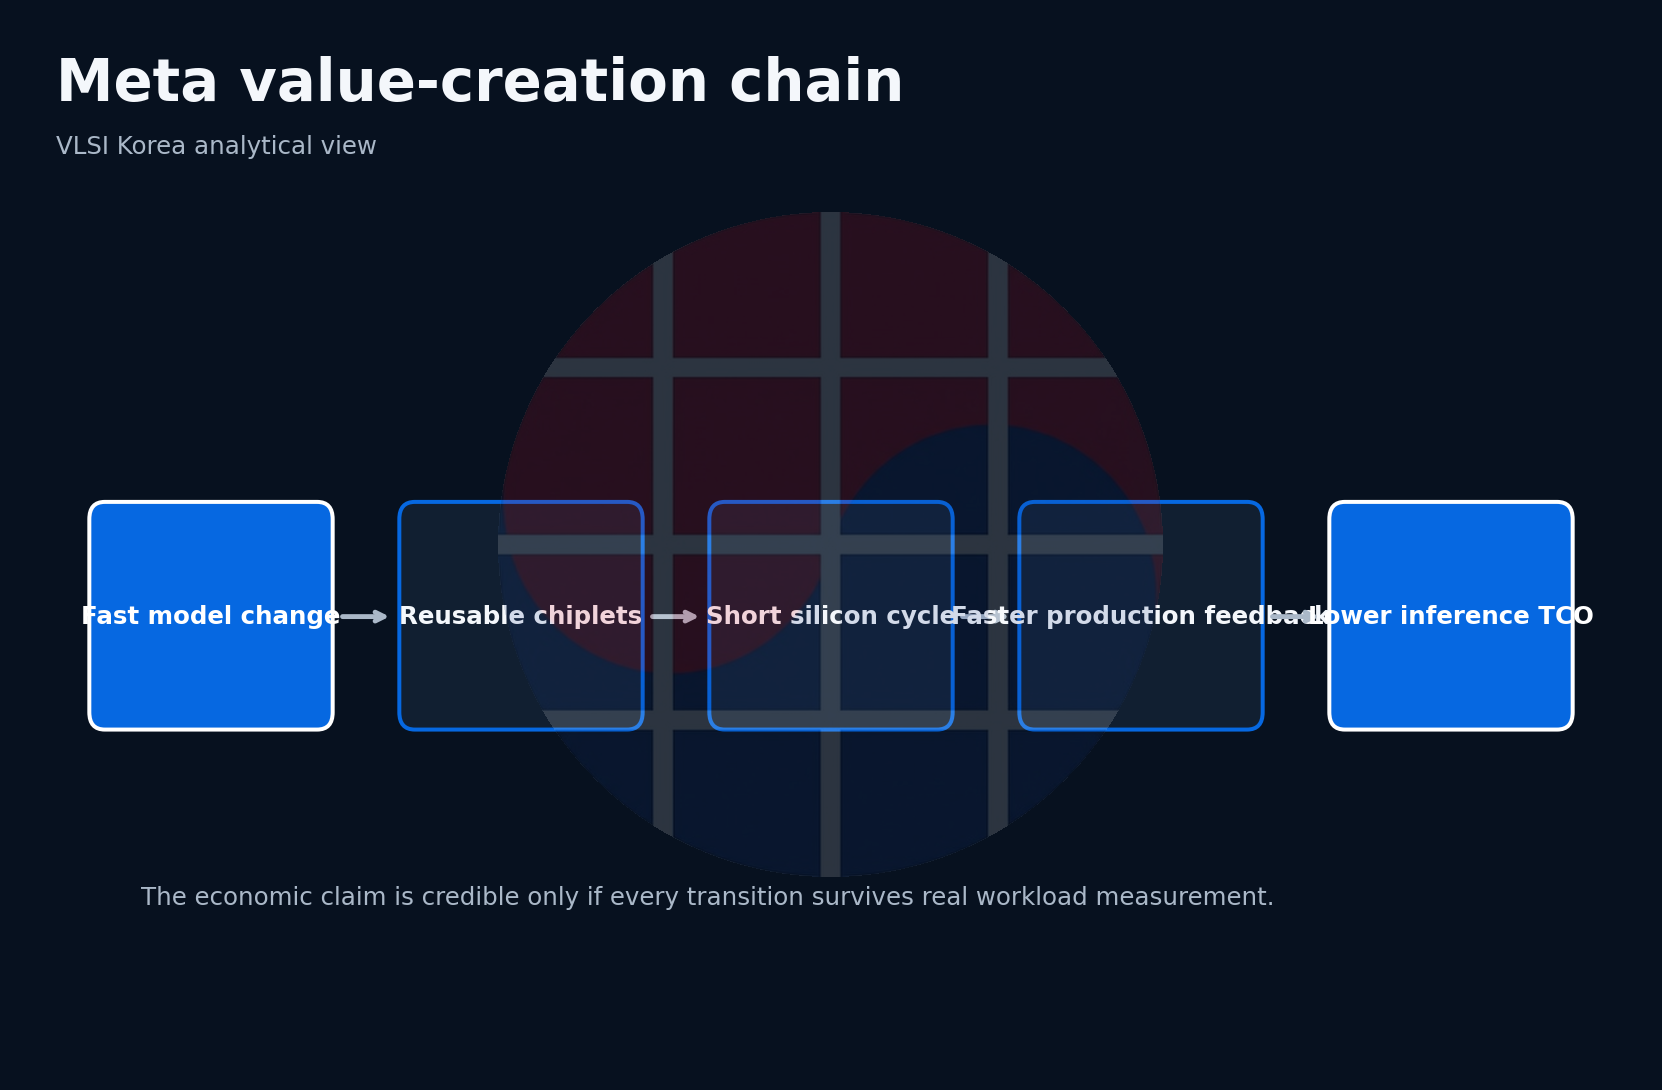
Meta가 300, 400, 450, 500을 약 6개월 cadence로 설계할 수 있는 이유는 compute·network·SoC chiplet, chassis, rack, software를 재사용하기 때문이다. 강점은 PyTorch·Triton·vLLM을 직접 통제하고 수십억 사용자의 추천·광고·GenAI traffic을 anchor workload로 가진다는 점이다. 약점은 external market 검증이 없고, inference-first architecture가 frontier training이나 새로운 irregular model에서 범용 GPU보다 불리할 수 있다는 점이다.
Generation map
| Generation | Workload focus | Memory direction | Compute and system direction | Deployment status |
|---|---|---|---|---|
| MTIA 100 | Ranking and recommendation inference | 64 GB LPDDR5, 128 MB SRAM | 25 W, 8 x 8 PE grid | Production foundation |
| MTIA 200 | Ranking and recommendation inference | 128 GB LPDDR5, 256 MB SRAM | 90 W, 3.5x dense compute | Large-scale production |
| MTIA 300 | Ranking and recommendation training | HBM-based chiplet system | Compute plus dual network chiplets | In production |
| MTIA 400 | R&R plus general GenAI | 51% more HBM bandwidth than 300 | 5x FP8, 72-device scale-up | Lab testing completed |
| MTIA 450 | GenAI inference | 2x HBM bandwidth vs 400 | 75% more MX4, attention and FFN acceleration | Mass deployment planned for early 2027 |
| MTIA 500 | GenAI inference | 50% more bandwidth and up to 80% more capacity vs 450 | 43% more MX4, 2 x 2 compute chiplets | Mass deployment planned for 2027 |
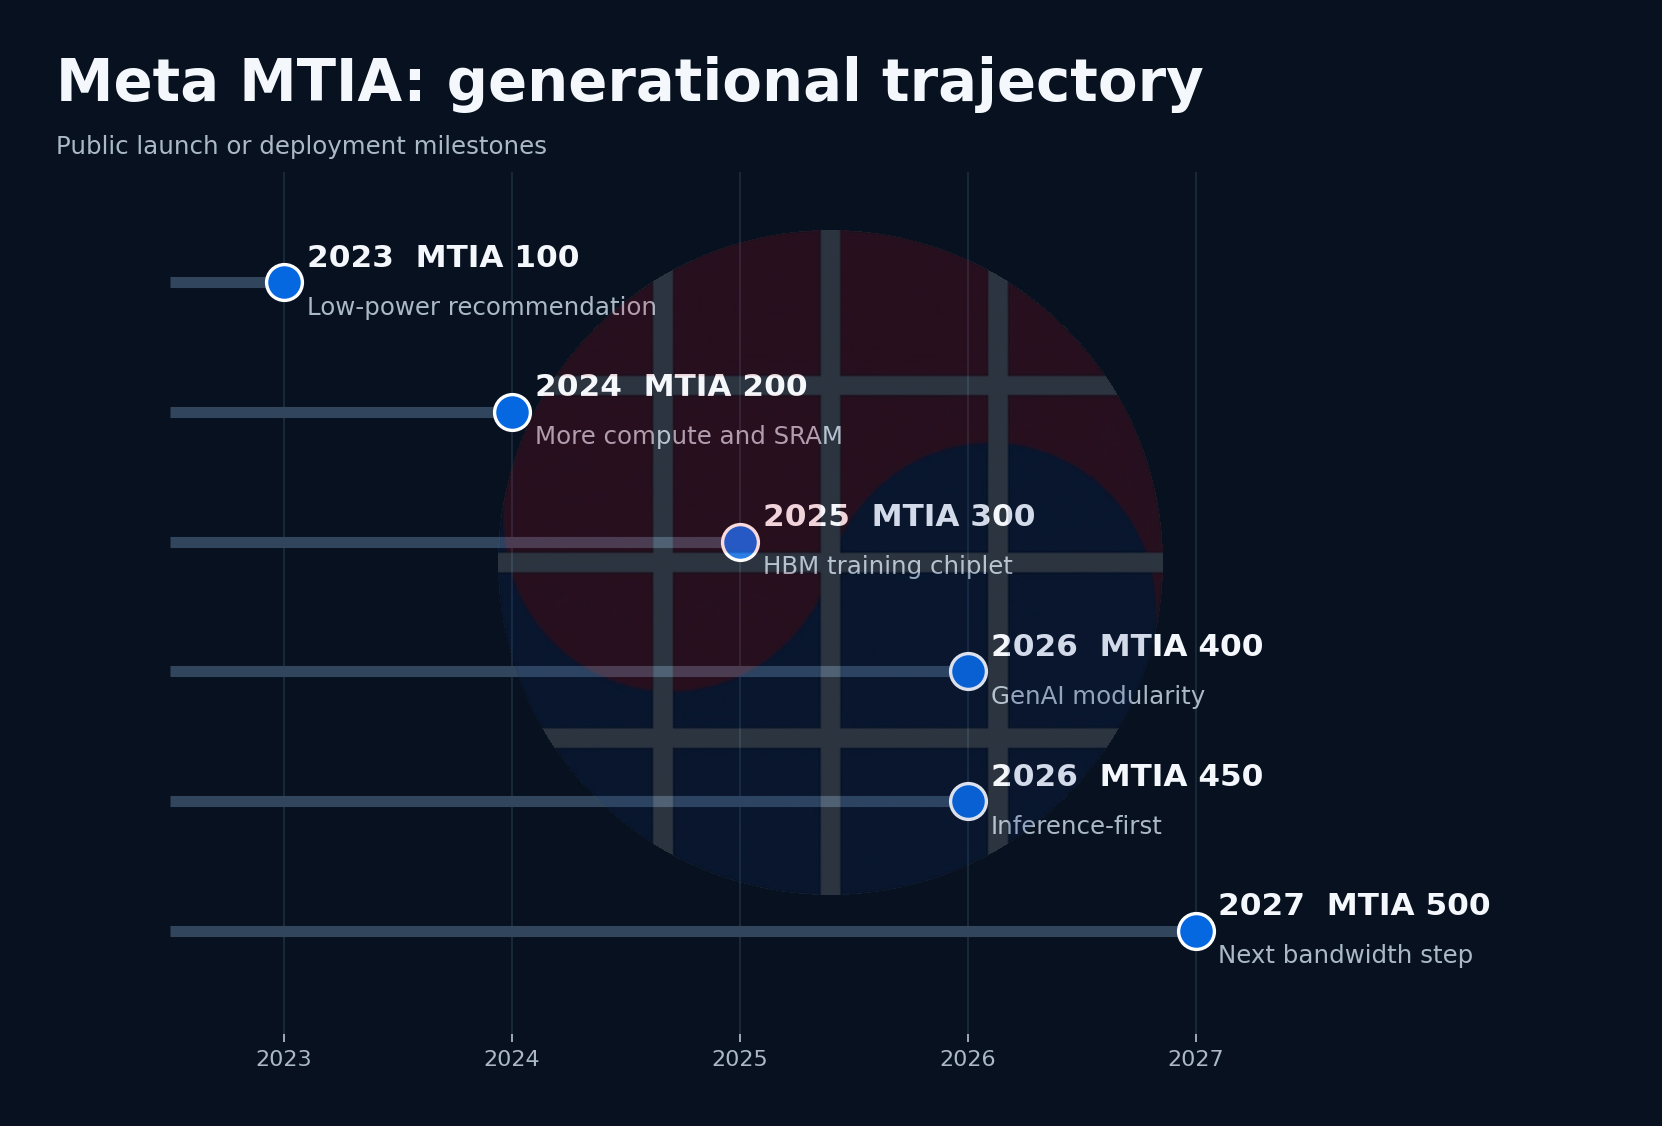
MTIA 300 이후 절대 사양 일부는 Meta가 이미지 표로 공개했지만 본문 텍스트에서 모든 숫자를 반복하지 않는다. 위 표는 공식 본문에 명시된 상대 변화와 배포 상태만 사용한다.
왜 추천 workload가 custom silicon의 좋은 출발점인가
Meta의 Feed와 광고 ranking은 요청량이 크고 model 구조를 회사가 통제하며 매일 지속된다. GPU는 큰 dense matrix와 high batch에서 강하지만 recommendation은 embedding lookup, small tensor, sparse access, feature interaction, strict latency가 섞인다. batch를 크게 만들면 throughput은 좋아져도 user-facing latency가 악화된다. GPU의 많은 thread와 HBM을 충분히 활용하지 못하는 경우가 생긴다.
자체 ASIC은 정확히 이 반복 낭비를 줄일 수 있다. off-chip memory를 비싼 HBM 대신 대용량 LPDDR로 구성하고, 큰 on-chip SRAM에 hot data를 두며, processing grid를 여러 subgrid로 나눠 작은 job을 동시에 실행한다. model과 serving software를 함께 바꾸면 fixed-function unit과 RISC-V core의 비율을 workload에 맞출 수 있다.
Meta는 자체 chip이 모든 workload를 맡는다고 주장하지 않는다. GPU와 MTIA를 함께 사용한다. custom silicon의 목표는 GPU를 없애는 것이 아니라 stable high-volume workload를 더 낮은 TCO로 이동시켜 scarce GPU를 frontier training과 flexible workload에 남기는 것이다.
MTIA 100: small batch를 위한 25 W architecture
2020년에 설계된 MTIA 100은 TSMC 7 nm, 800 MHz, 25 W TDP, 102.4 INT8 TOPS, 51.2 FP16·BF16 TFLOPS다. 8 x 8 grid에 64개의 processing element가 있고 mesh NoC로 연결된다. 각 PE에는 두 개의 customized RISC-V core, matrix·accumulation·nonlinear·data-movement unit, 128 KB local SRAM이 있다.
chip 전체에는 128 MB shared SRAM과 최대 128 GB까지 확장 가능한 LPDDR5 memory subsystem이 있다. 2024년 세대 비교표는 first-gen production configuration을 64 GB와 176 GB/s로 표기한다. 공식 2023 설명의 up to 128 GB와 2024 비교표의 64 GB는 maximum capability와 deployed configuration 차이로 읽는 것이 안전하다.
128 MB SRAM은 GPU 대비 큰 on-chip working set을 제공한다. small batch에서는 weight와 activation reuse가 작아 off-chip access가 성능을 제한하므로 hot embedding·dense layer data를 SRAM에 두는 이점이 크다. 반면 LPDDR5 176 GB/s는 대형 dense model에는 부족하다. MTIA 100이 low·medium complexity DLRM에서는 경쟁 accelerator보다 효율적이지만 high-complexity model에서는 GPU보다 불리했다고 Meta가 공개한 이유다.
dual M.2 board와 Yosemite V3 server도 workload에 맞춘 선택이다. server당 12개 accelerator를 PCIe switch hierarchy로 연결하고 chip 간 traffic이 host CPU를 반드시 거치지 않게 했다. board는 약 35 W 수준이라 기존 air-cooled infrastructure에 높은 수량을 배치하기 쉽다.
software는 PyTorch FX IR, LLVM, eager·graph mode, C++ kernel과 KNYFE DSL을 사용했다. 첫 세대의 성패는 silicon보다 PyTorch operator를 얼마나 MTIA kernel로 덮는지에 달렸다. Meta는 high-complexity model에서 software optimization이 부족하다고 직접 인정했다. 이 투명성은 이후 세대의 compiler 방향을 이해하는 데 중요하다.
MTIA 200: compute를 키우되 SRAM 철학을 유지
2024년 공개된 MTIA 200은 TSMC 5 nm, 1.35 GHz, 421 mm², 90 W다. 같은 8 x 8 PE grid를 유지하면서 dense compute는 3.5배, sparse compute는 7배 증가했다. dense INT8은 354 TOPS, dense FP16·BF16은 177 TFLOPS다. structured sparsity 조건에서는 각각 708 TOPS와 354 TFLOPS다.
각 PE local SRAM은 128 KB에서 384 KB로 3배, shared SRAM은 128 MB에서 256 MB로 2배, on-chip bandwidth는 800 GB/s에서 2.7 TB/s로 약 3.4배 증가했다. LPDDR5는 128 GB와 204.8 GB/s다. compute 증가에 비해 off-chip bandwidth 증가는 작고, local·shared SRAM을 크게 늘려 data reuse로 보완했다.
NoC bandwidth는 2배, host는 PCIe Gen5 x8로 올라갔다. rack은 72개 accelerator를 수용하고 RDMA NIC로 rack 밖 scale-out을 선택할 수 있다. platform 기준 first generation 대비 serving throughput 6배, performance/W 1.5배를 발표했다. chip TDP가 25 W에서 90 W로 3.6배 늘었기 때문에 device performance보다 rack throughput과 host 구성, kernel 개선을 함께 봐야 한다.
MTIA 200이 중요한 이유는 first silicon에서 production model까지 9개월 이내, 16개 region에 배포됐다는 Meta의 설명이다. MTIA 100에서 software와 system interface를 이미 만들었기 때문에 backward compatibility가 time-to-deploy를 줄였다. custom ASIC의 두 번째 세대가 첫 세대보다 경제적인 이유를 잘 보여준다.
Triton-MTIA backend와 PyTorch 2 TorchDynamo·TorchInductor 통합도 이 세대의 핵심이다. proprietary DSL만 고집하지 않고 GPU 개발자가 쓰는 Triton frontend를 재사용한다. hardware-specific optimization은 backend와 optional extension에 둔다. developer가 functional code를 공유하고 performance-critical kernel만 다르게 만들 수 있다.
MTIA 300: LPDDR 추천 추론기에서 HBM training chiplet로
MTIA 300은 하나의 compute chiplet, 두 개의 network chiplet, 여러 HBM stack으로 구성된다. compute chiplet의 PE는 두 RISC-V vector core, Dot Product Engine, Special Function Unit, Reduction Engine, DMA를 갖는다. redundant PE를 넣어 yield를 높인다. monolithic die 대신 chiplet를 쓰면 compute와 I/O를 다른 공정에 배치하고 불량 영역의 비용을 줄일 수 있다.
두 network chiplet에는 built-in NIC, collective를 offload하는 message engine, reduction collective를 위한 near-memory compute가 있다. 추천 training은 embedding과 gradient synchronization, all-to-all이 많다. host CPU와 generic NIC에 collective를 맡기면 latency와 PCIe traffic이 커진다. communication engine을 package 안에 넣어 compute와 overlap하는 것이 MTIA 400 이후 GenAI 기반이 됐다.
MTIA 300은 recommendation training production에 들어갔다. 여기서 Meta는 처음으로 inference-only 출발점을 학습으로 넓혔다. 하지만 frontier dense pretraining을 바로 겨냥하지 않고 회사가 가장 잘 아는 R&R training을 선택했다. software coverage와 failure recovery를 통제 가능한 workload에서 학습한 뒤 GenAI로 이동하는 단계적 전략이다.
MTIA 400: GenAI 변화에 chiplet를 재조합
MTIA 400은 MTIA 300 대비 FP8 FLOPS 400% 증가, HBM bandwidth 51% 증가다. 두 개의 compute chiplet로 compute density를 높이고 enhanced MX8·MX4를 지원한다. rack당 72개 device가 switched backplane을 통해 하나의 scale-up domain을 구성한다.
400% higher라는 표현은 5배를 뜻한다. compute가 memory bandwidth보다 훨씬 빠르게 늘었으므로 dense GEMM에는 유리하지만 decode에서는 bandwidth가 병목이 될 수 있다. MTIA 400이 general GenAI를 지원하는 과도기이고, 바로 다음 450에서 HBM bandwidth를 2배로 늘린 이유가 여기 있다.
MTIA 400·450·500은 같은 chassis, rack, network infrastructure를 사용한다. air-assisted liquid cooling rack은 legacy datacenter에 빠르게 배포하고, facility liquid cooling도 지원한다. reusable physical footprint가 six-month silicon cadence를 실제 deployment cadence로 전환한다.
MTIA 450·500: HBM bandwidth가 GenAI inference를 결정한다
MTIA 450은 400 대비 HBM bandwidth를 2배, MX4 FLOPS를 75% 높인다. attention과 FFN의 병목, Softmax와 FlashAttention을 완화하는 hardware acceleration을 추가한다. FP8·MX8보다 낮은 precision을 사용하며 MX4 peak가 FP16·BF16의 6배다. mixed low-precision computation에서 datatype conversion software overhead를 줄인다.
이 구조는 MoE inference를 직접 겨냥한다. token마다 일부 expert만 활성화되므로 weight memory traffic, token routing all-to-all, 작은 expert GEMM이 함께 발생한다. MX4는 weight bytes를 줄이고, 높은 HBM bandwidth는 active expert와 KV cache를 공급하며, network chiplet는 token dispatch를 처리한다. attention·FFN special acceleration은 matrix engine 밖의 시간을 줄인다.
MTIA 500은 450 대비 HBM bandwidth 50%, capacity 최대 80%, MX4 FLOPS 43%를 높인다. 2 x 2의 더 작은 compute chiplet 4개, HBM stack, network chiplet 2개, host PCIe와 scale-out NIC를 담당하는 SoC chiplet로 구성된다. 작은 compute die를 반복하면 yield와 design reuse가 좋아지고 필요한 generation에서 compute tile만 교체하기 쉽다.
Meta는 MTIA 300에서 500까지 HBM bandwidth 4.5배, MX8에서 MX4로 비교한 compute FLOPS 25배 증가라고 설명한다. precision이 달라 raw compute 배수는 동일 품질 성능 배수가 아니다. 오히려 이 숫자는 low-precision model co-design 없이는 roadmap peak를 사용할 수 없다는 뜻이다.
Software moat: PyTorch native와 HCCL
MTIA는 PyTorch eager·graph, torch.compile·torch.export, TorchInductor, Triton, MLIR, LLVM을 연결한다. model이 GPU와 MTIA에 동시에 배포될 수 있게 frontend를 공유하고 low-level backend만 분기한다. vLLM plugin은 FlashAttention, fused LayerNorm 같은 핵심 operator를 MTIA kernel로 대체하고 prefill-decode disaggregation, continuous batching을 재사용한다.
Hoot Collective Communications Library는 network chiplet의 message engine과 near-memory reduction을 사용한다. compute와 collective kernel fusion으로 launch·synchronization overhead를 줄이고 host stack data path를 offload한다. user-space driver와 bare-metal firmware를 Rust로 작성해 iteration과 memory safety를 확보한다.
수십만 chip 운영에서는 debugger와 telemetry가 chip spec만큼 중요하다. Meta는 host·device, software·firmware·hardware를 연결한 fleet-wide observability와 PE-level breakpoint·coordinated stepping을 설명한다. accelerator가 싸도 failure가 model job을 자주 중단하면 TCO가 악화되므로 production tool이 custom silicon의 숨은 진입장벽이다.
Watch points
- MTIA 400의 lab result가 production model과 72-device scale-up에서 재현되는가.
- MTIA 450·500의 HBM 절대 사양, process node, power, package yield가 공개되는가.
- MX4 custom format이 Llama와 광고 model의 quality validation에서 얼마나 넓게 적용되는가.
- MTIA 300의 R&R training 경험이 general GenAI training으로 실제 확장되는가.
- six-month design cadence가 mass deployment와 software qualification cadence까지 유지되는가.
Contrarian read: 빠른 세대가 software와 validation debt를 만들 수 있다
chiplet와 reusable rack이 physical design 시간을 줄여도 model accuracy validation, compiler regression, kernel tuning, fleet qualification은 사라지지 않는다. 6개월마다 device가 바뀌면 software team이 여러 generation을 동시에 지원하고 production traffic을 재검증해야 한다. HBM과 advanced package 공급도 cadence를 따라오지 못할 수 있다.
또한 inference-first chip이 특정 Llama·recommendation workload에서는 효율적이어도 새로운 state-space model, multimodal encoder, agent tool execution처럼 control과 irregular memory가 커지면 GPU의 SIMT flexibility가 유리할 수 있다. Meta의 modularity가 충분히 빠르게 이를 흡수하지 못하면 generation velocity가 오히려 잘못된 workload forecast를 반복하는 속도가 된다.
Korean lens
MTIA의 중요한 교훈은 chiplet가 단순 die 분할 기술이 아니라 조직의 개발 cadence를 바꾸는 도구라는 점이다. compute, network, SoC chiplet와 chassis·rack interface를 안정시키면 workload 변화에 맞춰 일부 block만 교체할 수 있다. 한국 chiplet 전략도 UCIe 지원 여부만 볼 것이 아니라 어떤 subsystem을 독립 검증하고 몇 세대 재사용할지 정의해야 한다.
Meta의 R&R 출발은 국내 인터넷·통신 사업자에게 현실적인 모델이다. 자체 foundation model training chip보다 검색, 광고, 추천, speech, moderation처럼 반복량이 큰 내부 inference를 먼저 옮기면 software와 operation investment를 회수하기 쉽다. 다만 Meta처럼 PyTorch, model, datacenter를 동시에 통제하지 못하면 partner ecosystem과 standard runtime가 더 중요해진다.
Sources
- MTIA v1 architecture
- Next-generation MTIA
- Meta infrastructure overview
- Four MTIA chips in two years
- Meta infrastructure evolution
Disclosure
본 글은 정보 제공만을 목적으로 하며, 특정 증권의 매수 또는 매도를 권유하는 것이 아닙니다. 본 글에 포함된 수치와 사실은 기업 공시, 언론 보도, 시장 조사 등 공개적으로 이용 가능한 자료를 바탕으로 작성되었으며, 해당 자료 또는 작성 과정에서 오류가 발생할 수 있습니다. 필자는 언급된 기업의 주식을 보유하고 있을 수 있습니다. 모든 투자 결정 및 그에 따른 결과는 독자의 책임입니다.