 VLSI Korea
마이크로소프트 Maia 300 공개: 100만 개 자체 AI 칩이 바꾸는 반도체 비즈니스
마이크로소프트가 3세대 자체 AI 칩 Maia 300을 공개하고 2027년 100만 개 이상 투입을 선언했다. 세계 최대 GPU 구매자가 GPU 경쟁자로 돌아선다. 새로운 승부처는 FLOPS가 아니라 토큰 경제학이다.


2026년 10월의 가장 중요한 칩 발표는 더 빠른 가속기가 아니다. 누가 칩 회사가 될 수 있는가에 대한 선언이다. 2026년 10월 12일, 마이크로소프트는 자체 AI 실리콘 3세대인 Maia 300을 공개하고, 2027년에 100만 개 이상을 투입해 자사 제품과 서비스의 주력 추론 시스템으로 삼겠다고 밝혔다 (Reuters, 2026년 10월 16일). 세계 최대 AI GPU 구매자가 이제 사실상 GPU 경쟁자로 돌아선 것이다. Maia로 옮겨가는 추론 쿼리 하나하나는 더 이상 엔비디아를 거치지 않는 매출이다.
스펙 자체도 만만치 않다. TSMC 2나노급 실리콘 위의 compute chiplet, 8개의 HBM4 스택으로 288GB 메모리에 초당 18.0TB의 대역폭, 950W 패키지로 묶어 96개를 한 랙에 넣어 약 167kW를 쓰는 구조다 (마이크로소프트 기술 공개, 2026년 10월 12일). 마이크로소프트는 주요 GPU 기반 시스템 대비 메가와트당 토큰 처리량이 약 40% 높고, 전작 Maia 200 대비 랙 단위 토큰 처리량은 최대 7배라고 주장한다. 하지만 벤치마크 숫자보다 큰 이야기는 전략이다. 마이크로소프트는 AI 스택에서 가장 비싼 층인 추론을 수직 계열화했고, 그 규모가 파운드리·메모리·merchant 칩 업체 모두의 경제학을 다시 쓰고 있다.
발표 내용 정리
발표는 2026년 10월 12일 월요일, Scott Guthrie Cloud·AI 부문 부사장의 블로그 포스트로 나왔다. Satya Nadella CEO는 이를 "자체 실리콘에 대한 지금까지 가장 큰 베팅"이라고 표현하며, 2027년부터 Maia 패밀리를 멀티 기가와트 규모로 확장해 자사 제품과 서비스의 주력 추론 시스템으로 만들겠다고 밝혔다 (마이크로소프트, 2026년 10월 12일).
기록에 남은 핵심 약속은 다음과 같다.
- Maia 300은 추론 전용이다. 학습용 가속기가 아니라 마이크로소프트가 실제로 돈을 버는 워크로드용이다. 코딩 지원, long-context reasoning, 실시간 대화형 AI, multi-step agent task가 타깃이다.
- 2027년부터 양산 투입, 멀티 기가와트 규모로 확장. Reuters는 2027년에 100만 개 이상이 투입될 수 있다고 보도했다.
- Maia 200은 이미 양산 중이다. 마이크로소프트 자체 AI 모델과 Azure에서 제공되는 OpenAI 모델을 돌리고 있으며, 미국·유럽·호주에 배치됐다. Microsoft 365 Copilot이 현재 Maia 200 위에서 동작하고, GitHub Copilot과 Microsoft Foundry는 2026년 말까지 전환 예정이다.
- Maia 200의 공개 효율 지표: GPU 기반 시스템 대비 와트당 토큰 최대 1.7배 — Maia 300의 7배 주장은 이 기준선 대비다.
다만 진지한 독자라면 두 가지 단서를 잡고 있어야 한다. 메가와트당 토큰 40% 주장은 비교 대상 GPU 시스템이 명시되지 않은 업체 주장이라 독립 검증이 필요하다. 그리고 마이크로소프트는 여전히 엔비디아 GPU를 대규모로 구매하고 있다. 당장의 타격은 추론 지출의 구성 변화이지 하룻밤 사이의 대체가 아니다.
칩 스펙 뜯어보기
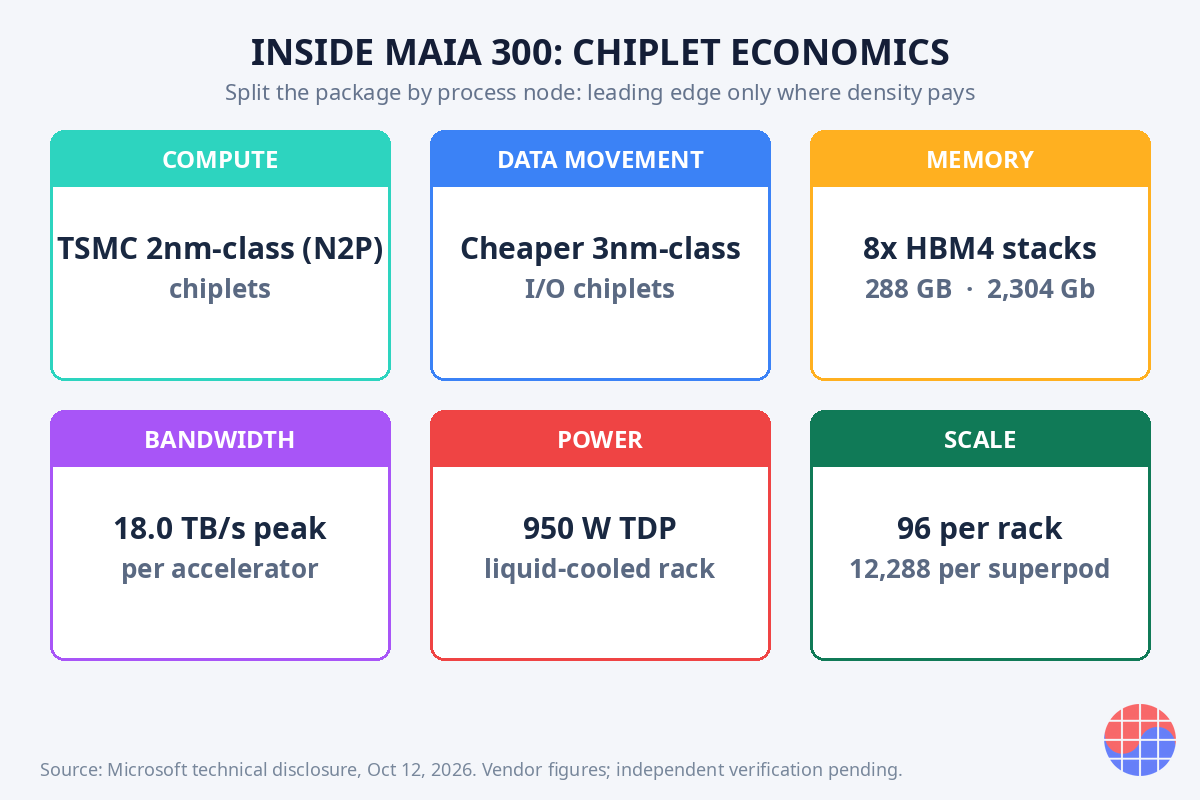
마이크로소프트 기술 공개 (2026년 10월 12일)에 따르면 Maia 300은 기능을 넘어 경제학으로 다이를 나눈 multi-chiplet 패키지다.
| 블록 | 내용 |
|---|---|
| Compute chiplet | 핵심 연산 기능, TSMC 2나노급 (N2P) |
| 데이터 이동 chiplet | 프로세서 외부 데이터 이동용, 저가 3나노급 실리콘 |
| 메모리 | HBM4 8스택, 가속기당 288GB (2,304Gb) |
| 메모리 대역폭 | 초당 18.0TB peak |
| 전력 | 가속기당 950W TDP |
| 랙 | 가속기 96개, 약 167kW, 랙당 HBM 27.6TB |
| 랙 대역폭 | 총합 약 1.7PB/s 메모리 대역폭 |
| Scale-up | 2단 Ethernet 패브릭, 최대 128랙 = 12,288개 가속기 superpod |
세 숫자는 곱씹을 가치가 있다. 칩당 288GB HBM4는 2,304Gb다. 100만 개 이상 투입 계획은 2027년 한 해에만 800만 개 이상의 HBM4 스택, 약 288페타바이트의 HBM4 수요 신호다. 가속기당 950W는 플래그십 merchant GPU와 같은 열 등급이라 같은 수랭·전력 공급망을 쓴다. 96개/랙, 167kW는 Maia 200 대비 가속기 밀도가 2배 — 경쟁의 단위가 칩에서 랙으로 넘어갔다는 뜻이다.
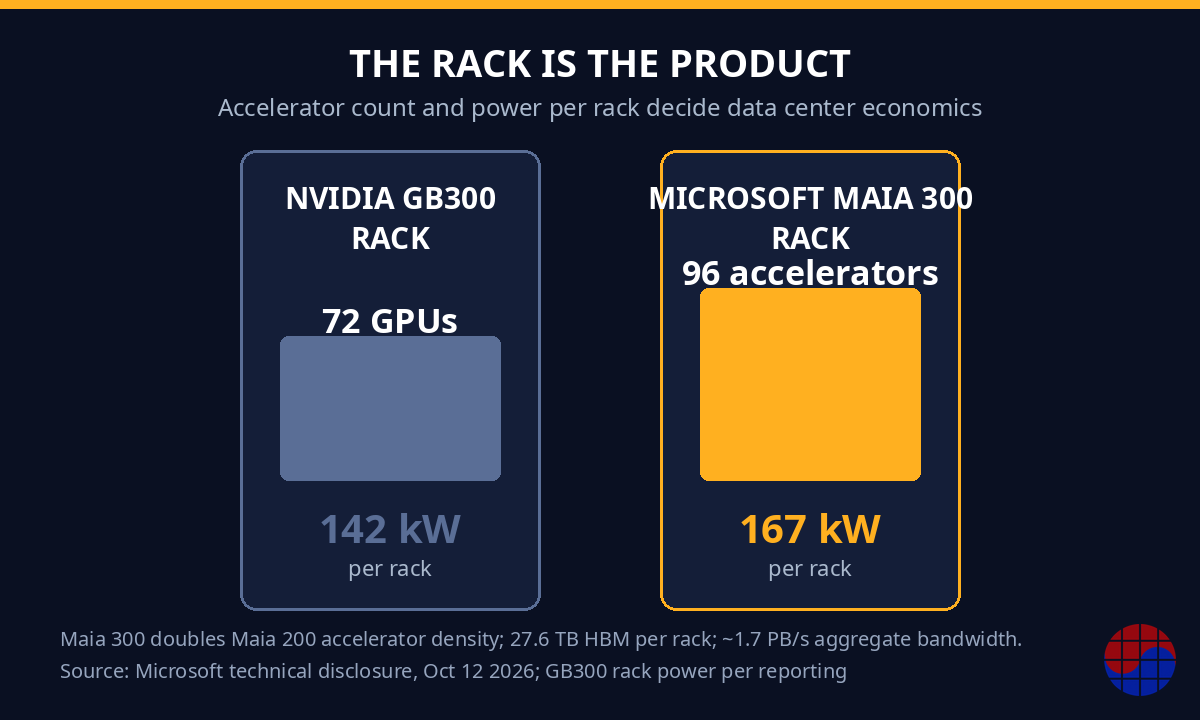
조용하지만 결정적인 단서는 scale-up 패브릭이다. Maia 300은 2단 Ethernet 패브릭을 쓴다. 랙 내부는 전기 링크, 랙 간은 광 링크로 최대 128개 랙, 12,288개 가속기를 묶는 superpod을 구성하고, 대역폭은 작업 스케줄러가 재배분하고 hot-spare 용량은 이웃 랙에서 빌려온다. 독점 scale-up 인터커넥트에 대한 정면 도전이다. commodity 표준인 Ethernet이냐, NVLink류 폐쇄 정원이냐의 싸움에서 마이크로소프트는 Ethernet에 걸었다. Broadcom·Marvell과 Ethernet 생태계에는 올해 가장 중요한 design win이다.
왜 추론인가, 왜 지금인가: 토큰 경제학
학습이 헤드라인을 가져가지만 돈을 버는 건 추론이다. Copilot 쿼리 하나, agent loop 한 바퀴, long-context reasoning 세션 하나하나가 마이크로소프트의 원가 구조에 직접 청구되는 추론 워크로드다. 모델 서빙 비용이 떨어질수록 — 토큰당 지능이 싸질수록 — 돈은 토큰을 가장 싸게 대규모로 서빙하는 쪽에 몰린다.
Maia 300이 노리는 게 정확히 그 지점이다. 메가와트당 토큰 40%, 와트당 더 많은 유효 작업을 뽑아내는 sub-3-bit·향상된 MXFP4 데이터 포맷. 마이크로소프트는 peak FLOPS에서 엔비디아를 이기려는 게 아니다. 자기 P&L을 결정하는 지표, 즉 자사 데이터센터 안에서 자사가 통제하는 워크로드의 토큰 100만 개당 서빙 비용에서 이기려는 것이다.
MBA식 논리로 한 줄이면: 수요(Copilot·Azure)와 공급(Maia 실리콘·데이터센터)을 둘 다 가진 순간, 수직 계열화는 변동비를 고정비로 바꾼다. 남의 마진이 붙은 GPU를 사는 대신 감가상각하는 자산이 된다. 100만 개 계획은 추론 비용을 감가상각하겠다는 선언이다.
엔지니어의 시선: chiplet은 수율 결정이다
마케팅을 걷어내면 Maia 300 패키지는 테이프아웃 현장에서 배우는 첨단 공정 경제학 교본이다.
연산은 TSMC 2나노급 N2P에, 메모리 컨트롤러·I/O는 저가 3나노급에 두는 건 무엇보다 수율과 원가 플레이다. 최첨단 노드는 defect density가 가장 아프고 웨이퍼 가격이 가장 비싼 곳이다. 밀도가 정말 필요한 로직만 올리고 나머지는 성숙한 고수율 노드에 두는 것, 그리고 패키지 수율을 거대한 monolithic 다이 하나가 아니라 known-good-die 경제학으로 결정하게 만드는 것이 chiplet의 본질이다.
둘째, 진짜 signoff 난이도는 HBM4 인터페이스에 있다. 18.0TB/s에 8스택이면 PHY·인터포저 라우팅·메모리 서브시스템 주변의 power integrity 작업이 로직 timing closure보다 물리 설계 공수를 지배한다. 큰 SoC의 STA signoff를 해본 사람은 안다. 헤드라인 숫자는 대역폭이지만 테이프아웃 리스크는 인터페이스에 산다.
셋째, 랙 단위 co-design이 새로운 floorplan이다. 167kW 랙의 열 부하 대부분을 떠안는 수랭, 950W 패키지, 랙 간 광 링크 — 전력망과 열 설계가 RTL보다 먼저 아키텍처를 제약한다. 랙 팀과 co-design하지 않는 칩 팀은 데이터센터에 못 들어가는 부품을 만든다.
엔비디아에 대한 함의
단기 리스크는 제한적이다. 마이크로소프트는 여전히 엔비디아 GPU를 대규모로 사고 있고, 학습 — 엔비디아의 본진 — 은 추론 전용 칩의 사정권 밖이다. 하지만 방향은 분명하다. Maia로 넘어가는 Copilot 쿼리 하나하나는 엔비디아 스택을 거치지 않는 추론 매출이다. GPU도, 붙어 있던 HBM도, 네트워킹도 아니다.
구조적으로 더 큰 건 Maia 300이 Ethernet scale-up 노선을 업계 최대 규모에서 정당화했다는 점이다. 12,288개 규모에서 2단 Ethernet 패브릭이 동작하면 "frontier급 클러스터는 독점 인터커넥트로만 묶인다"는 주장은 약해진다. 인터커넥트 종속은 엔비디아 플랫폼 해자의 기둥 중 하나다.
3차 효과는 가격 협상력이다. 그럴듯한 in-house 대안은 모든 대형 구매자의 merchant 업체 협상을 바꾼다. 마이크로소프트는 Maia가 모든 워크로드에서 최고 merchant GPU를 이길 필요가 없다. 자사 워크로드에서 "충분히 좋은" 수준이면 나머지 구매 단가를 묶는 천장이 된다.
메모리·파운드리에 대한 함의
메모리: 칩당 HBM4 8스택, 100만 개 이상이면 2027년 투입분만 800만 개 이상의 HBM4 스택 수요 신호다. HBM4 양산 경쟁 중인 SK하이닉스·삼성·마이크론 모두에게 가장 큰 수요 앵커가 생겼다. 단위 규율도 중요하다. 가속기당 288GB는 2,304Gb이고, 데이터센터 기획자는 랙 단위(랙당 27.6TB)로 산다. HBM4 공급 경쟁에 가장 큰 수요 기준점이 박혔다.
파운드리: compute chiplet이 TSMC N2P라는 건 마이크로소프트가 N2 패밀리의 초기 대량 고객 중 하나라는 뜻이다. 이 물량에서의 초기 N2P 할당은 기술 선언인 동시에 캐파 협상이며, AI 시대 파운드리로서 TSMC의 리드를 더 깊게 한다.
in-house 실리콘 클럽은 이제 만원이다. 구글 TPU, AWS Trainium, 메타 MTIA에 이어 OpenAI도 자체 칩을 추진 중이다. 그중 Maia 300의 100만 개 계획은 단일 투입 기준으로 최대 규모다. 수직 실리콘이 실험에서 조달 전략으로 넘어갔다는 신호다.
앞으로 볼 것 4가지
- 독립 벤치마크. 40% 주장의 비교 대상 GPU가 명시되지 않았다. 전력 경계가 정의된 실제 워크로드에서의 제3자 측정을 볼 것.
- HBM4 공급. 메모리가 타이트한 상황에서 800만 개 이상을 2027년에 확보할 수 있는지, 3사 중 누가 qualification을 따내는지.
- 외부 고객. 마이크로소프트는 Maia가 자사 제품·서비스용이라고 말한다. 외부 고객이 접근하는 순간 Maia는 원가 절감 수단이 아니라 merchant 경쟁자가 된다.
- Ethernet 베팅의 성패. 12,288개 규모에서 2단 패브릭이 버티는지 — 결과는 모든 네트워킹 업체의 로드맵에 울린다.
결론은 이렇다. Maia 300은 칩 출시가 아니라 다이 사진이 붙은 조달 전략이다. 마이크로소프트는 AI 손익계산서에서 가장 큰 항목인 추론 컴퓨트를 직접 만들기로 했다. 반도체 업계에 대한 메시지는 명확하다. 고객이 이제 경쟁자이기도 하고, 협상은 메가와트당 토큰으로 한다.
FAQ
마이크로소프트 Maia 300이란?
2026년 10월 12일에 발표된 마이크로소프트의 3세대 자체 AI 가속기로, 코딩 지원·long-context reasoning·agent task 같은 추론 워크로드용이다. TSMC 2나노급 실리콘의 compute chiplet, HBM4 8스택 (288GB, 18.0TB/s), 950W 패키지를 96개씩 랙에 넣어 구성한다.
Maia 300을 몇 개나 투입하나?
Reuters 보도 (2026년 10월 16일)에 따르면 마이크로소프트는 2027년에 100만 개 이상의 Maia 칩을 투입할 계획이다. Maia 패밀리를 멀티 기가와트 규모로 확장해 자사 제품과 서비스의 주력 추론 시스템으로 삼는다는 구상이며, 양산 배치는 2027년부터 시작된다.
엔비디아 GPU와 비교하면?
마이크로소프트는 비교 대상을 명시하지 않은 "주요 GPU 기반 시스템" 대비 메가와트당 토큰 약 40%, 전작 Maia 200 대비 랙 단위 토큰 처리량 최대 7배를 주장한다. 둘 다 독립 검증이 필요한 업체 주장이다. 아키텍처적으로는 독점 인터커넥트 대신 2단 Ethernet scale-up 패브릭에 걸었고, peak 학습 FLOPS가 아니라 추론 비용 효율을 노린다.
HBM·파운드리 업체에는 무슨 의미인가?
칩당 HBM4 8스택에 100만 개 이상이면 2027년 투입분만 800만 개 이상 (약 288페타바이트)의 HBM4 수요 신호다. SK하이닉스·삼성·마이크론의 HBM4 램프에 대형 수요 앵커가 생긴 셈이다. TSMC N2P compute chiplet은 마이크로소프트를 2나노급 캐파의 초기 대량 고객으로 만든다.
Disclosure: 본 분석은 마이크로소프트의 2026년 10월 12일 발표와 이후 보도 (Reuters, 2026년 10월 16일)에 근거한다. 성능 수치는 마이크로소프트의 주장으로 독립 검증되지 않았다. 필자는 언급된 기업에 포지션을 보유하고 있지 않다. 수치는 2026년 10월 17일 기준 공개 자료에 따른다.


