 VLSI Korea
HBM ECC를 다시 설계하다 — 성균관대 Cerberus, redundancy 33.3% 줄이고 ISCA 2026 Best Paper
성균관대 Cerberus가 ISCA 2026 Best Paper를 받았다. on-die·link·system ECC를 하나의 redundancy로 묶는 EODM 공동 설계로 HBM redundancy를 33.3% 줄이면서 신뢰성을 높인 구조와 한계를 분석한다.


⏱ 30초 요약
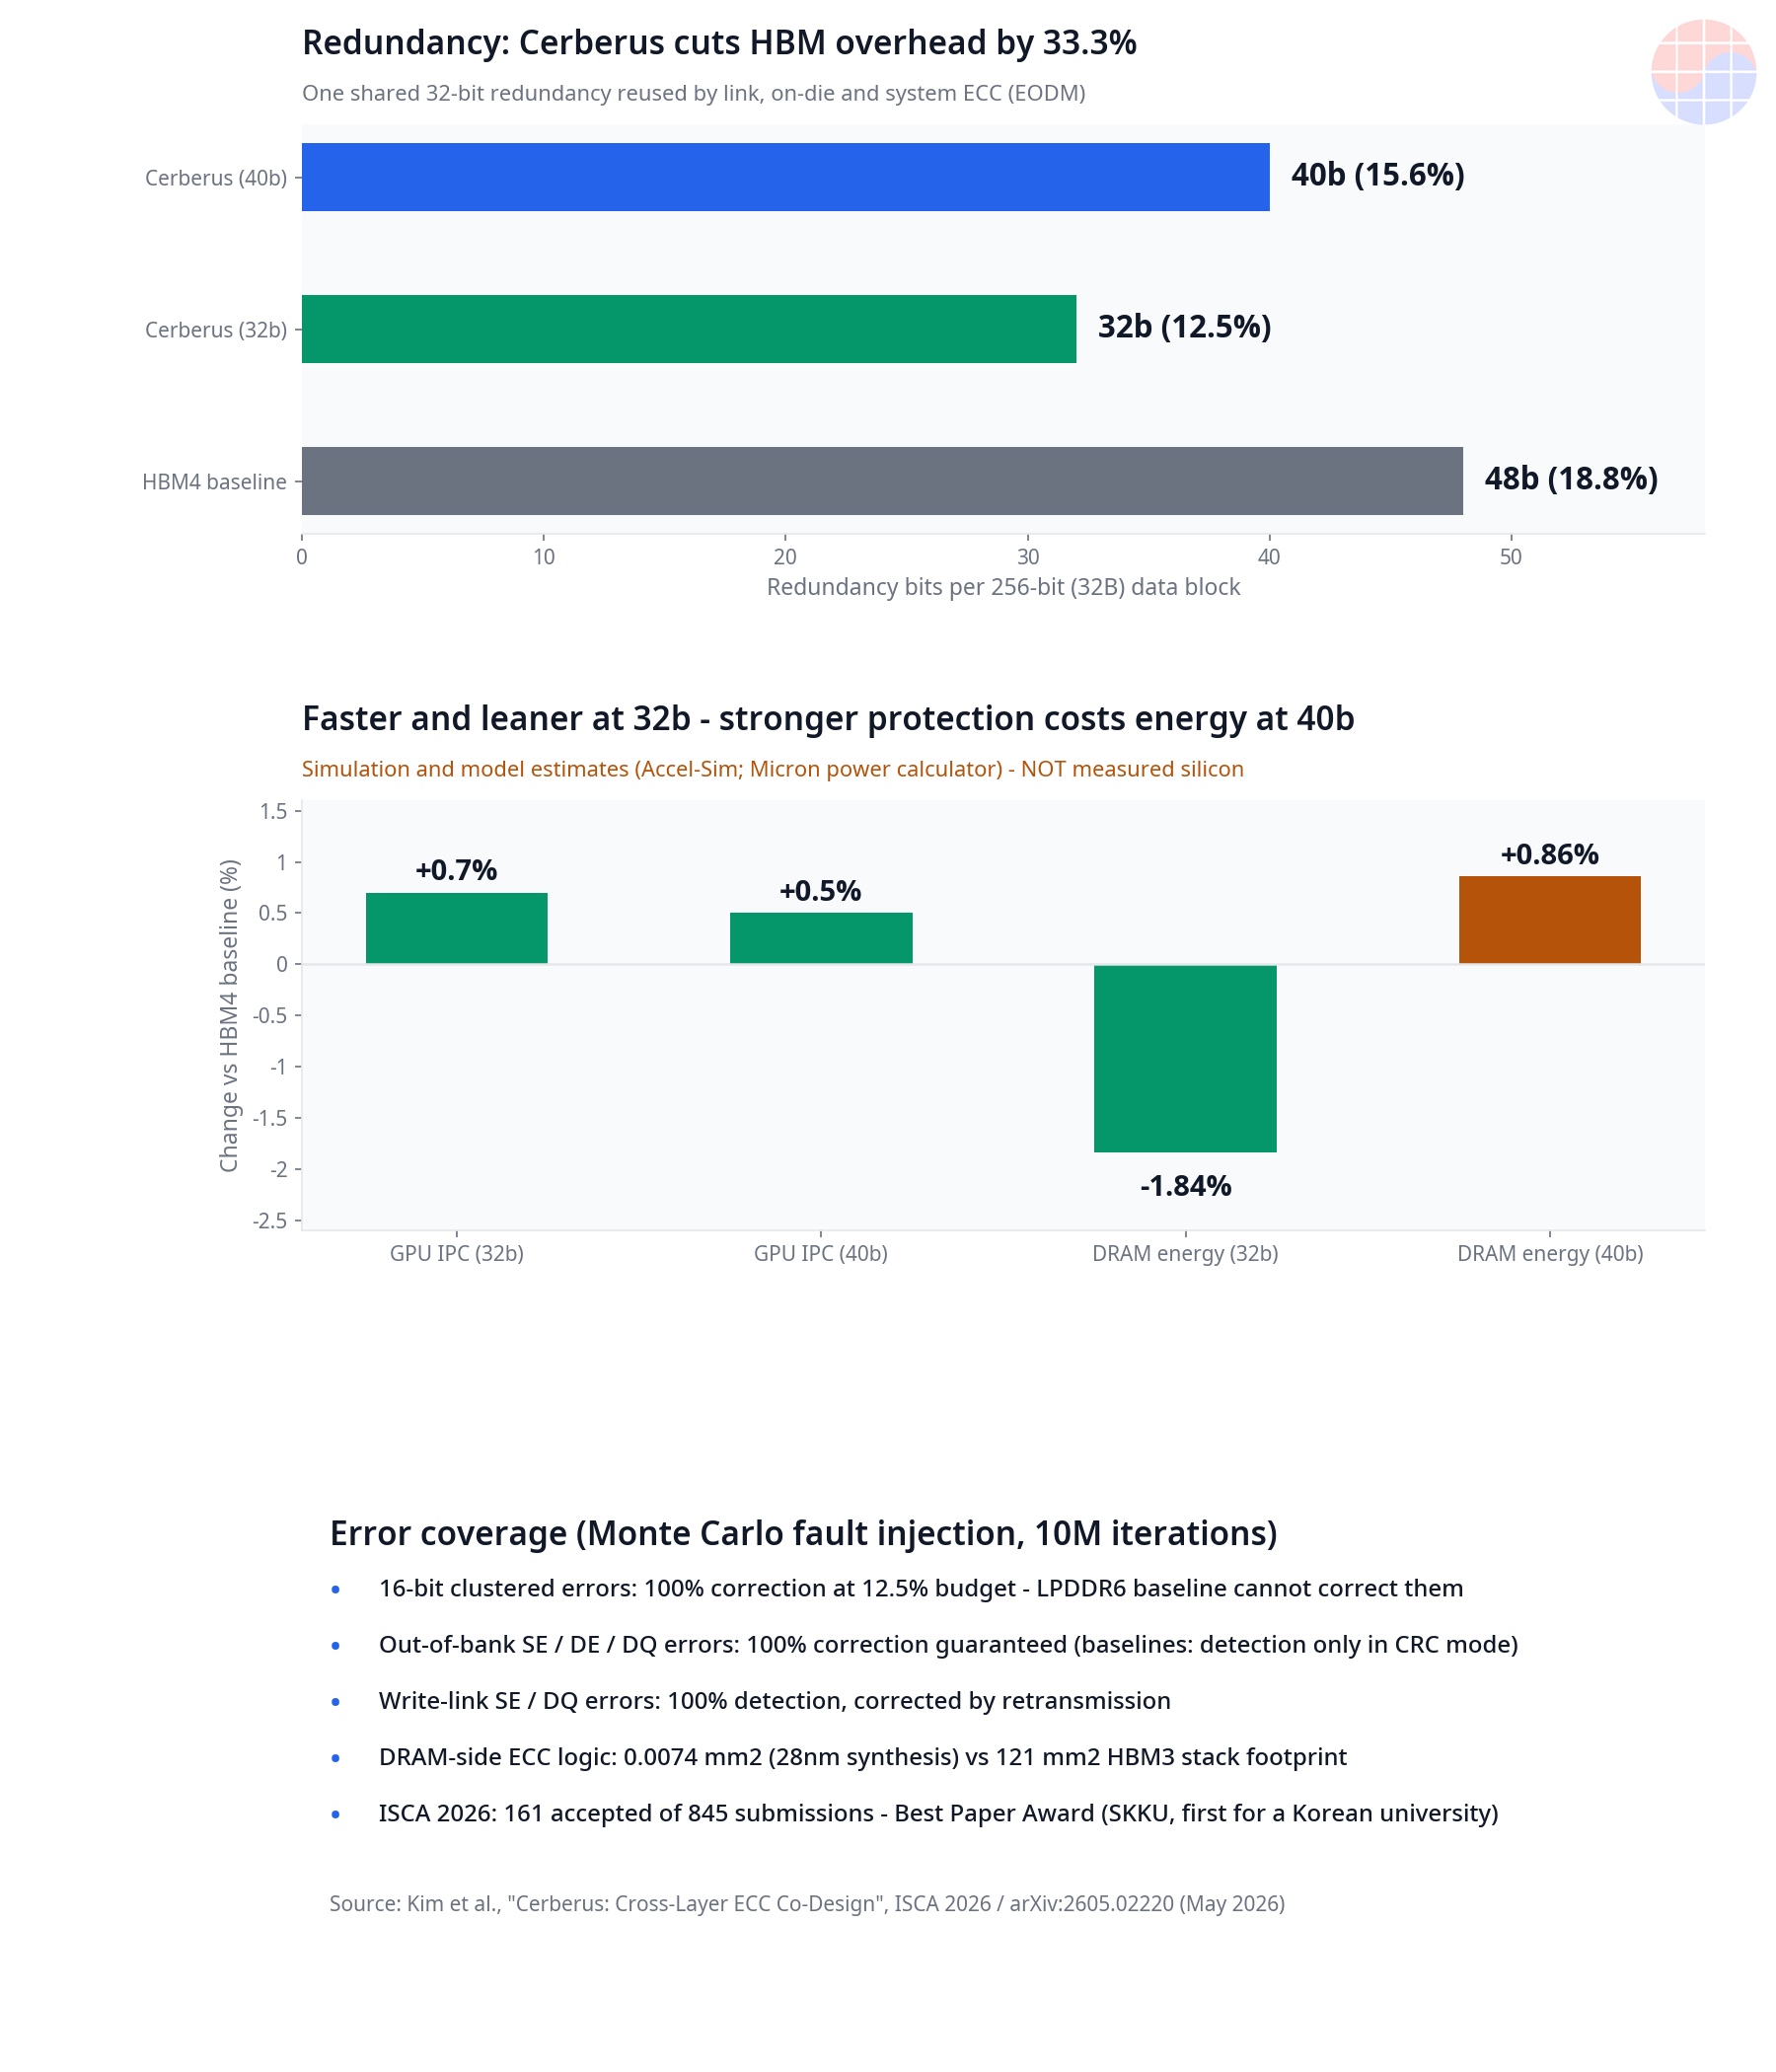
성균관대학교 연구팀의 Cerberus가 ISCA 2026(2026년 6월 27일~7월 1일, 미국 Raleigh) Best Paper Award를 받았다. 한국 대학 최초라는 것이 성균관대의 설명이다. 핵심은 따로 놀던 3개 ECC 층(on-die·link·system)을 하나의 redundancy로 묶는 Encode-Once, Decode-Many(EODM) 공동 설계다. HBM4 기준 redundancy를 48비트에서 32비트로 33.3% 줄이면서 신뢰성은 오히려 높였다. 단, 모든 수치는 시뮬레이션과 오류 주입 실험 결과이며 측정된 실리콘이 아니다.
왜 이 논문을 골랐나
이번 회차 후보는 네 건이었다. ISSCC 2026 LPDDR6(삼성전자·SK하이닉스), Hot Chips 2026 Intel Diamond Rapids, DAC 2026으로 알려졌던 MFIT 열모델링, 그리고 이 Cerberus다. Cerberus를 고른 이유는 세 가지다. 첫째, 검증 가능성이다. 네 후보 중 유일하게 논문 전문이 arXiv에 무료 공개되어 있어 모든 수치를 원문 표로 직접 확인할 수 있었다. LPDDR6는 원논문이 IEEE 페이월 뒤에 있고 2차 기사 사이에 수치가 엇갈렸으며, MFIT는 확인 결과 DAC 논문이 아니라 ACM TODAES 저널 논문이었다. 둘째, HBM 직결성이다. AI 가속기의 병목이 연산에서 메모리 신뢰성으로 번지는 지금, HBM4의 ECC 구조를 다시 짜는 논문은 독자의 실무와 바로 닿는다. 셋째, 수상 이력이다. ISCA 2026에는 845편이 투고되어 161편이 채택됐고, Cerberus는 2026년 6월 30일 발표된 Best Paper Award 2건 중 하나다.
Background: ECC가 세 층이 됐는데, 서로 말을 안 한다
DRAM이 고밀도·고속화될수록 데이터가 깨질 확률은 올라간다. 셀 전하는 femtocoulomb 수준으로 줄었고, 타이밍 마진은 sub-nanosecond이며, 링크는 pin당 multi-gigabit으로 돈다. 특히 HBM과 LPDDR는 채널 하나를 DRAM 소자 하나가 전담하는 single-device-per-channel(SDPC) 구조라, 소자 하나의 결함이 채널 전체를 무너뜨릴 수 있다. 게다가 최소 fetch 단위가 32B로 줄면서 ECC에 쓸 수 있는 redundancy 예산도 좁아졌다. SDPC 메모리는 보통 32B 블록당 2B(6.25%)만 할당하는데, DDR의 64B당 8B(12.5%)와 비교하면 절반이다.
업계의 답은 층을 쌓는 것이었다. 소자 안에서 제조 결함을 고치는 on-die ECC(O-ECC), 전송 오류를 실시간으로 잡는 link ECC(L-ECC), 컨트롤러에서 end-to-end 복구를 맡는 system ECC(S-ECC). 문제는 이 세 층이 서로 독립적으로 진화했다는 점이다. redundancy는 중복되고, 커버리지에는 구멍이 생기며, 최악의 경우 서로 방해한다. 대표 사례가 miscorrection이다. O-ECC가 자기 정정 범위를 넘는 오류를 만나면 멀쩡한 비트까지 잘못 고쳐 오류를 키울 수 있고, 그렇게 증폭된 패턴은 S-ECC도 못 고치는 형태가 된다. 고치려다 더 망가뜨리는 셈이다.
숫자로 보면 구조적 한계가 더 분명하다. 논문이 정리한 HBM4 구성에서 redundancy는 32B 데이터 블록당 총 48비트(18.8%)에 이르지만, 정작 S-ECC 몫은 2B뿐이라 SEC-DED나 CRC16 중 하나를 골라야 한다. LPDDR6는 32B 블록당 S-ECC 2B, O-ECC 2B, L-ECC 2B로 총 12.5%를 쓰지만 층마다 예산이 쪼개져 있어, 16비트 clustered 오류는 O-ECC가 정정하지 못하고 SEC-DED 기반 구성에서는 silent data corruption(SDC) 비율까지 높아진다.
논문 핵심 포인트: 한 번 인코딩하고, 세 번 디코딩한다
Cerberus의 제안은 단순하다. 층마다 따로 인코딩하지 말고, 컨트롤러가 한 번만 인코딩해 만든 redundancy를 세 층이 나눠 쓰자는 것이다. 저자들은 이를 Encode-Once, Decode-Many(EODM)라 부른다. HBM 구성 기준 총 redundancy는 32비트(256비트 데이터 대비 12.5%)이며, 이 중 16비트는 link 층이 쓰기 경로 오류 검출에, 같은 16비트를 device 층이 소자 내 single-error correction에 재사용하고, system 층은 전체 32비트로 symbol 단위 정정까지 수행한다.
재사용이 안전하려면 두 가지 장치가 필요하다. 첫째, generator matrix와 parity-check matrix를 층 간에 맞물리도록 행렬 수준에서 공동 설계하는 것. 둘째, O-ECC에 bounded-fault 제약을 거는 것이다. 소자 내 디코더가 오정정을 하더라도 그 피해가 원래 고장 난 16비트 symbol 안에 갇히게 만들어, system 층이 받을 오류 부담이 절대 늘지 않게 보장한다. 여기에 디코더 순서와 정정 예산 배분까지 함께 설계해 miscorrection amplification 자체를 구조적으로 차단한다. 시스템 층의 최종 무기는 SSC+DEC로, 16비트 symbol 오류 1개 또는 서로 다른 symbol에 걸친 비트 오류 2개를 정정하고, 그보다 심한 패턴도 99.97% 확률로 안전하게 검출한다.
산업 관점에서 중요한 대목이 하나 더 있다. Cerberus는 DRAM 내부 오류를 호스트에 그대로 노출하지 않는다. 학계의 단일 층 강화안(Unity ECC, DUO)은 신뢰성은 높지만 소자 내부 결함 정보를 밖으로 드러내야 해서, 결함을 감추고 싶어 하는 DRAM 벤더의 관행과 충돌한다. Cerberus는 on-die error concealment이라는 벤더의 native role을 유지한 채 공동 설계하므로, 논문이 스스로 강조하듯 custom HBM 같은 실제 제품 협업 구조와 양립 가능하다.
엔지니어 심층 분석: 방법론과 수치, 그리고 한계
평가 방법 — 실리콘이 아니라 주입 실험과 합성이다
먼저 방법론부터 분명히 하자. 이 논문에는 측정 칩이 없다. 신뢰성 평가는 Monte Carlo 오류 주입 실험 1,000만 회로 수행됐다. 오류 위치는 in-bank(셀·주변 회로), write link(전송 경로), out-bank(읽기 경로·periphery·I/O) 세 곳으로 나누고, single error부터 16비트·32비트 clustered 오류, data pin 오류, data strobe 오류까지 위치별 패턴을 주입했다. 성능은 GPU 사이클 시뮬레이터 Accel-Sim에 NVIDIA V100 모델(HBM 채널 32개, HBM4 6.4Gb/s)과 Rodinia·Parboil·GraphBIG·PolyBench 16개 워크로드로 측정했고, 면적은 SystemVerilog 모델을 Synopsys Design Compiler와 UMC 28nm 라이브러리로 합성해 구했다. DRAM 에너지는 HBM2E 데이터시트 전류와 Micron DDR4 power calculator를 쓴 모델 추정이다. 즉 아래 수치는 전부 시뮬레이션·모델 기반이며 실측이 아니다.
결과 1 — redundancy를 줄이고 커버리지는 넓혔다
핵심 결과는 trade-off의 역전이다. HBM4 베이스라인 대비 redundancy를 48비트에서 32비트로 33.3% 절감했는데도, 단일 위치 오류에서 Cerberus는 16비트 clustered 오류를 같은 12.5% 예산으로 100% 정정한다. LPDDR6 베이스라인은 이 예산에서 16비트 오류를 정정하지 못한다. 읽기 경로(out-bank)에서는 single·double·DQ 오류 모두 100% 정정을 보장하는데, CRC 모드 베이스라인은 검출만 할 뿐 정정하지 못한다. 쓰기 링크에서는 single·DQ 오류 100% 검출 후 재전송으로 정정한다. 세 위치에 동시에 오류가 나는 다중 위치 시나리오에서도 Cerberus는 거의 100%에 가까운 정정률을 유지했다. 더 강한 보호가 필요하면 40비트(15.6%) 구성이 있고, 검출 능력은 더 올라간다.
결과 2 — 성능과 에너지
인코딩 단계가 하나로 합쳐지면서 지연이 줄었다. Accel-Sim 기준 GPU IPC는 HBM4 대비 Cerberus(32b)가 geomean +0.7%, Cerberus(40b)가 +0.5% 개선됐다. 합성으로 구한 S-ECC 추가 지연은 32b 기준 0.85ns 수준이다. DRAM 에너지는 32b 구성이 평균 -1.84%로 줄지만, 40b 구성은 더 강한 보호의 대가로 +0.86% 늘어난다. 면적은 DRAM 측 디코더 2개를 합쳐 14,693 NAND2 equivalent, 28nm 기준 0.0074mm²로 HBM3 스택 footprint 121mm²와 비교하면 무시할 수준이고, 프로세서 측 encoder와 S-ECC를 합쳐도 127,583 NAND2 equivalent에 그친다.
한계 — 무엇을 아직 모르는가
한계도 명확하다. 첫째, 오류 모델은 field study 문헌에서 도출한 패턴 기반 주입이라 실제 HBM4 실리콘의 결함 분포와 다를 수 있다. 둘째, 에너지 수치는 HBM2E 전류값을 빌려 쓴 모델 추정치다. 셋째, 표준화 문제가 남는다. Cerberus는 컨트롤러와 DRAM 양쪽의 ECC 행렬을 함께 바꿔야 하므로, JEDEC 표준 HBM에 그대로 꽂을 수 없고 custom HBM처럼 호스트와 메모리 벤더가 공동 설계하는 경우에 현실적이다. 논문이 겨냥점도 정확히 그 지점이다.1
Chase's Take: 신뢰성이 HBM 경쟁의 다음 전선이다
이 논문의 산업적 의미는 ECC 기법 자체보다 그 방향에 있다. HBM 경쟁은 대역폭과 적층 단수에서 신뢰성과 수율로 번지고 있다. AI 학습 클러스터가 수만 개 가속기 규모로 커지면, 메모리 오류 하나가 silent data corruption으로 번져 학습 전체를 오염시키는 비용이 폭증한다. 하이퍼스케일러가 custom HBM을 요구하는 흐름과 Cerberus가 정확히 맞물리는 이유다. 호스트 SoC와 메모리를 함께 설계할 수 있는 고객만이 이 종류의 cross-layer 최적화를 가져갈 수 있다.
삼성전자와 SK하이닉스 관점에서는 양날의 검이다. redundancy 33.3% 절감은 곧 다이 면적과 비용의 절감이고, on-die 결함을 감추는 concealment를 유지한다는 점은 벤더 친화적이다. 반면 행렬 공동 설계는 고객 SoC 팀과의 깊은 협업을 요구하므로, 메모리 벤더의 역할이 부품 공급에서 공동 설계 파트너로 이동한다는 신호이기도 하다. EDA 관점에서는 ECC 행렬 공동 설계와 bounded-fault 검증 같은 과제가 signoff 플로우의 새 항목이 될 수 있다. 오류 주입 기반 신뢰성 검증은 이미 메모리 설계에서 커지는 영역이고, 이런 구조가 표준 논의에 들어가면 검증 방법론 수요도 따라온다.
과장 없이 보자. 이것은 학회 논문이고, 제품 로드맵이 발표된 것이 아니다. 그럼에도 ISCA가 Best Paper로 이 논문을 택한 것은, 컴퓨터 아키텍처 커뮤니티가 메모리 신뢰성을 대역폭만큼 중요한 1급 설계 변수로 취급하기 시작했다는 방증이다. 다음 관전 포인트는 후속 연구와 벤더의 표준화 논의에서 EODM 같은 공유 redundancy 구조가 실제로 언급되는지 여부다.
Implications
- 메모리 벤더(삼성전자·SK하이닉스): custom HBM 차별화 카드로 cross-layer ECC 공동 설계를 검토할 가치가 있다. redundancy 절감은 비용, concealment 유지는 고객 신뢰와 직결된다.
- AI 가속기·SoC 설계자: 메모리 신뢰성을 부품 스펙이 아니라 호스트-메모리 공동 설계 변수로 다루는 흐름에 대비해야 한다. ECC 예산 배분이 시스템 아키텍처 초기 결정 사항이 된다.
- EDA·검증 엔지니어: 오류 주입 기반 신뢰성 검증, bounded-fault 형식 검증 같은 방법론 수요가 늘어난다. STA·signoff 엔지니어에게도 신뢰성 검증은 인접 영역으로 확장 중이다.
- 하이퍼스케일러: 대규모 학습에서 SDC 비용을 정량화하고, custom HBM 요구 스펙에 ECC 공동 설계를 포함할지 판단할 근거가 생겼다.
FAQ
Cerberus는 실제 칩으로 검증됐나?
아니다. 신뢰성은 Monte Carlo 오류 주입 1,000만 회 실험, 성능은 Accel-Sim 시뮬레이션, 면적은 UMC 28nm 논리 합성, 에너지는 전류 모델 추정으로 평가됐다. 측정 실리콘 결과는 없으며, 수치는 전부 시뮬레이션·모델 기반이다.
Redundancy 33.3% 절감은 정확히 무엇을 줄인 것인가?
HBM4 구성에서 256비트(32B) 데이터 블록당 붙는 총 redundancy가 48비트(18.8%)에서 Cerberus의 32비트(12.5%)로 줄어든 것이다. 세 층이 각자 redundancy를 갖는 대신, 한 번 인코딩한 32비트를 link·on-die·system 층이 공유해 재사용하기 때문에 가능하다.
기존 HBM4나 LPDDR6 제품에 바로 적용할 수 있나?
바로 적용할 수는 없다. 컨트롤러와 DRAM 양쪽의 ECC 인코더·디코더 구조를 함께 바꿔야 하기 때문이다. 그래서 논문도 범용 표준 제품이 아닌 custom HBM 같은 공동 설계 시나리오를 적용 대상으로 제시한다. JEDEC 표준 반영 여부는 아직 논의된 바 없다.
왜 ISCA Best Paper를 받았나?
학회 공식 발표 기준으로 Cerberus는 ISCA 2026 Best Paper Award 2건 중 하나다(845편 투고, 161편 채택). 세 ECC 층의 중복과 간섭이라는 구조적 문제를 행렬 공동 설계로 풀고, redundancy를 줄이면서 신뢰성을 높인 점이 평가받은 것으로 보인다. 성균관대에 따르면 한국 대학의 ISCA Best Paper 수상은 처음이다.
논문 작성 도구: 이런 수준의 논문을 직접 쓰거나 후속 연구로 이어갈 계획이라면, 영문 초안 교정에는 학술 글쓰기 전용 도구인 Paperpal을 활용할 수 있습니다. 할인 코드 PAP20을 쓰면 20% 할인이 적용됩니다. 이 링크로 구매 시 수수료가 발생할 수 있습니다.
출처
- 논문: Junhwan Kim, Seunghyun Kim, Yesin Ryu, Saeid Gorgin, Jungrae Kim, "Cerberus: Cross-Layer ECC Co-Design for Robust and Efficient Memory Protection", ISCA 2026 (53rd IEEE/ACM International Symposium on Computer Architecture, 2026년 6월 27일~7월 1일, Raleigh, NC), arXiv:2605.02220 (2026년 5월 4일 제출, v2 5월 14일)
- 학회: ISCA 2026 공식 사이트(iscaconf.org) — Best Paper Award 발표(2026년 6월 30일), 투고 845편·채택 161편
- 대학 발표: Sungkyunkwan University / Newswise 보도자료(2026년 7월 23일) — 한국 대학 최초 ISCA Best Paper 수상
- 수치 검증: arXiv HTML 전문(Table I~VI, Section V~VI) 직접 대조 — redundancy 48b→32b, IPC +0.7%, 에너지 -1.84%/+0.86%, 면적 0.0074mm²
1 근거 한계: 본 글의 모든 정량 수치는 논문의 시뮬레이션·오류 주입·합성·모델 추정 결과이며 측정 실리콘 데이터가 아니다. 수상 관련 "한국 최초"는 성균관대 발표 기준이다.
📩 VLSI Korea 뉴스레터 구독하기
매일 발행되는 반도체 심층 분석을 이메일로 가장 먼저 받아보세요. 구독은 무료입니다.


