 VLSI Korea
Quad SPI를 달아도 센서가 빨라지지 않는 이유
TinyProbe의 새 연구를 출발점으로, 핀 수보다 먼저 따져야 할 전송 길이·컨트롤러·버퍼·무선 경로의 처리량을 계산한다.


센서의 데이터를 읽는 SPI 선을 늘리면 데이터 구간에서 한 번에 옮길 수 있는 비트는 늘어난다. 그러나 사용자가 받는 프레임까지 같은 비율로 빨라지는 것은 아니다.
명령을 보내는 시간, 선택한 컨트롤러의 클록, 버퍼가 차는 속도, 다음 전송 단계와 겹쳐 일할 수 있는지가 함께 바뀌어야 한다. 보드를 다시 설계하기 전에 할 일은 어느 구간의 시간을 줄이면 완성 데이터가 더 자주 도착하는지 계산하는 것이다.
| Boundary | Keep fixed | Record |
|---|---|---|
| Pins | Board, voltage, lane mode, clock | Pattern errors, timing conditions |
| Transaction | Payload length, command format, gaps | Useful bytes and elapsed time |
| Host delivery | Acquisition setting, network load | Complete frames, loss and latency |
Table 1. Editorial test framework, not a claim that these tests were performed here.
2026-10-01 제출된 TinyProbe 다중 선 SPI 프리프린트는 이 질문을 구체적으로 보여준다. 저자들은 실제 IGLOO2·SiWG917 구성에서 Dual SPI를 5 MHz로 검증했고, 별도 Kria K26·STM32N6 시험대에서는 Quad SPI를 66 MHz까지 시험했다고 보고한다.
후자의 데이터 구간 원시 비트율은 264 Mbit/s지만 완성 프로브의 무선 처리량은 아니다. 논문 원문
VLSI Korea view: 넓은 버스의 가치는 최대 비트율보다, 시스템의 가장 느린 대기 시간을 얼마나 줄이는지로 판단해야 한다.
이 글은 FPGA에서 센서 데이터를 꺼내는 엔지니어가 버스 폭과 버스트 길이를 정하고, 시스템 책임자가 펌웨어 수정과 컨트롤러 교체 중 어디에 개발비를 쓸지 판단하도록 돕는다. 핵심 계산은 특정 제품의 벤치마크가 아니라, 자신의 측정값을 넣어 다시 사용할 수 있는 설계 예제다.
같은 비트라도 측정하는 경계가 다르다
센서 경로를 데이터 생성, 임시 저장, 보드 내 전송, 네트워크 전달로 나누면 속도라는 말의 분모가 선명해진다. ADC의 샘플링 속도는 입력을 수치로 바꾸는 능력이고, SPI의 비트율은 정해진 선 위에서 데이터를 이동하는 능력이다.
호스트의 처리량은 그중 실제로 도착하고 유효하다고 인정된 데이터가 차지하는 양이다. 앞쪽 숫자가 크다는 이유로 뒤쪽 숫자도 커지는 관계는 성립하지 않는다.
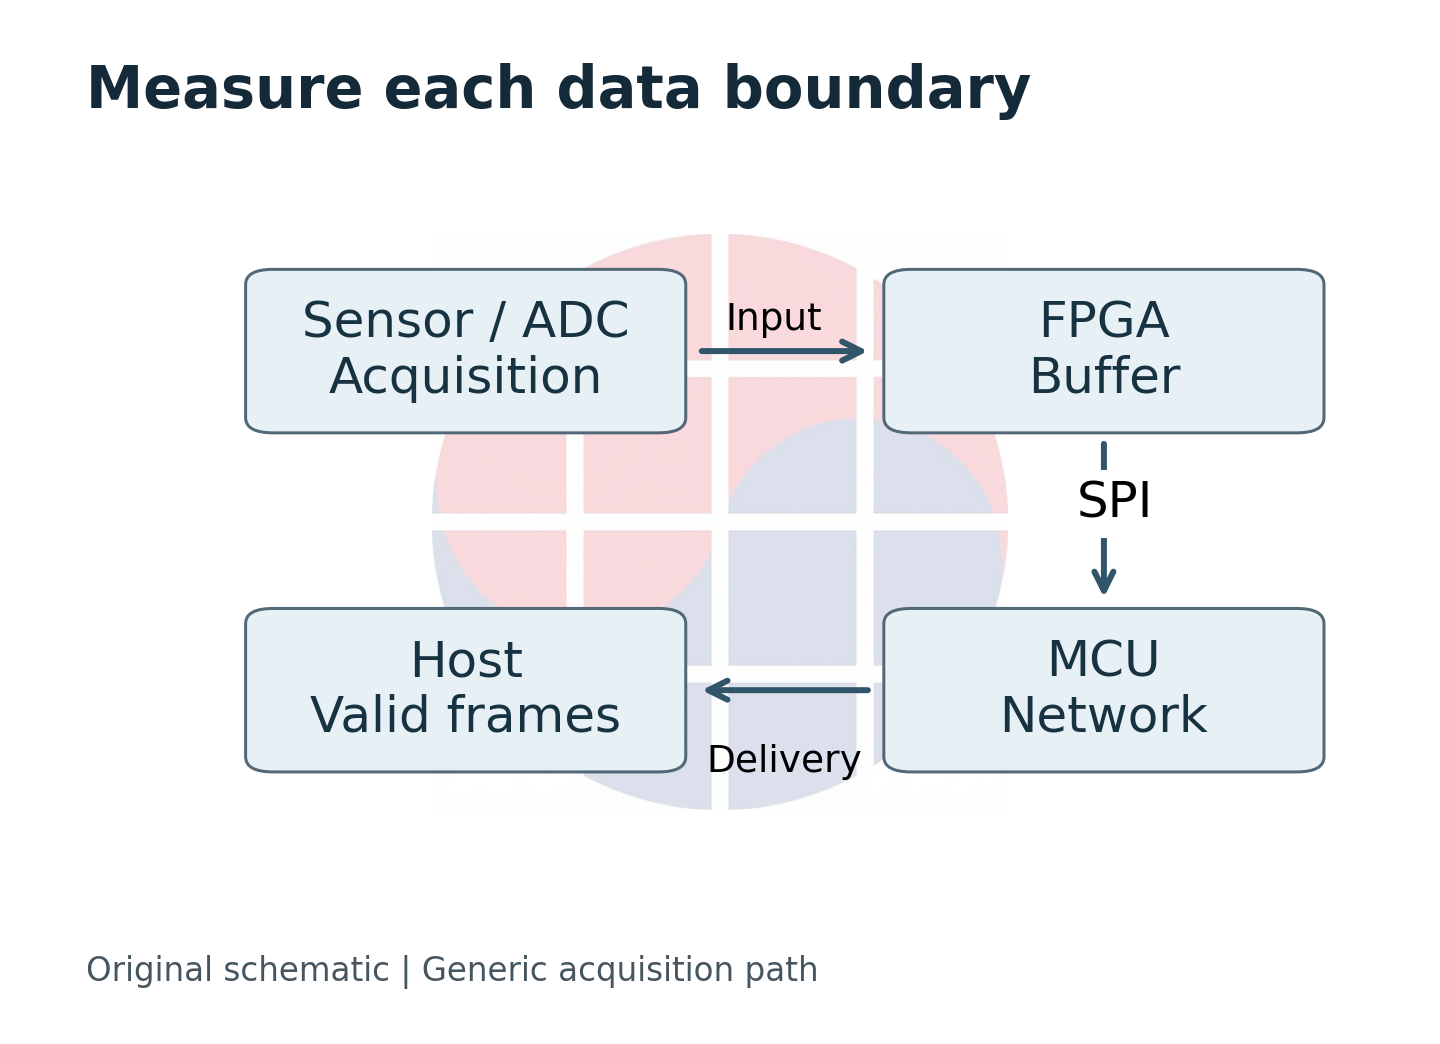
예를 들어 TI AFE5832LP 제품 자료는 32개 입력 채널과 LVDS 출력을 설명한다. 이것은 아날로그 수신부가 디지털 수집 회로에 연결되는 경계다.
같은 제품 자료의 샘플 속도를 뒤에 붙는 MCU의 SPI 속도와 직접 나누어 시스템 프레임률을 구하면, 채널 선택·수집 시간·저장 형식·전송 간격을 모두 생략하게 된다. 부품의 최대 사양과 장치의 운용 조건을 구분해야 하는 이유다. TI 제품 자료
실무에서는 먼저 처리량의 정의를 고정하는 편이 좋다. 획득한 원시 샘플을 셀 것인지, 헤더를 제외한 버퍼를 셀 것인지, 호스트가 완전히 조립한 프레임을 셀 것인지 정한다.
그 뒤 동일한 시작·종료 조건으로 시간을 잰다. 재전송된 바이트를 다시 성과에 더하거나, 송신 함수가 반환한 순간을 호스트 도착 시점으로 취급하면 같은 시스템에서도 서로 다른 성능표가 나온다.
이는 측정 장비보다 먼저 해결할 계약이다.
선 수를 늘릴 때 클록과 방향도 확인해야 한다
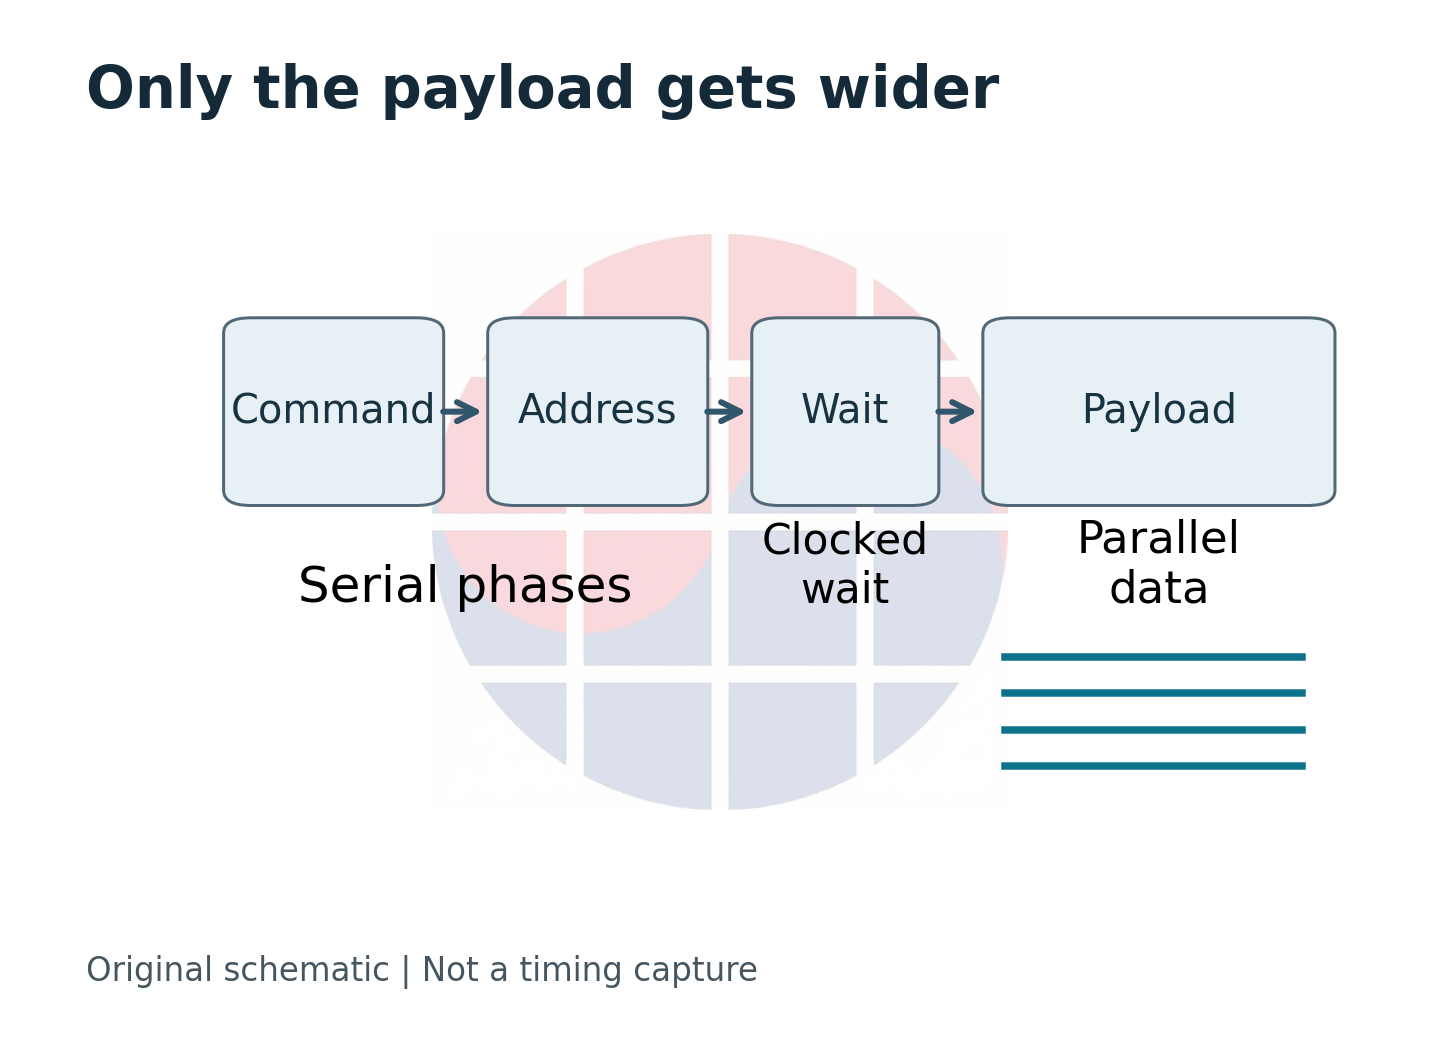
일반적인 단일 데이터 선의 SDR 전송은 클록 주기마다 해당 방향으로 비트를 하나 옮긴다. Dual·Quad 방식은 데이터 구간에서 병렬로 쓰는 선을 늘린다.
이때 명령과 주소까지 같은 폭으로 전송되는지는 별도 조건이다. Silicon Labs의 SSI 구조 문서는 명령·주소·대기·데이터 구간을 구분하고 각각의 전송 형식을 설정하도록 설명한다.
따라서 “Quad 지원”이라는 표기만으로 전체 거래가 모두 넓어진다고 읽어서는 안 된다. SSI 구조 문서
또 하나의 함정은 모드마다 허용 클록이 같다고 가정하는 것이다. Silicon Labs의 917 개발자 가이드 v1.0.3 FAQ는 일반 SPI에 최대 40 MHz, Dual·Quad에 최대 10 MHz를 명시한다.
그런데 같은 버전의 구조 설명에는 DMA 조건을 넣은 Quad 22.5 MHz 계산 예제도 있어, 문서 전체가 하나의 조건 없는 상한으로 정리되지는 않는다. 제품·SDK·핀 설정을 묶은 확인이 필요하며, 여기서는 FAQ의 숫자를 보편적인 실측 한계로 확대하지 않는다. FAQ
배선 검토에서는 신호 이름보다 각 구간의 구동 주체를 추적한다. 단일 SPI에서 출력으로 쓰던 선이 다중 선 읽기에서는 입력으로 바뀔 수 있다.
양쪽이 동시에 구동하면 논리 값의 문제가 아니라 전기적 충돌이 된다. 반대로 전환 시점이 늦으면 첫 데이터가 사라진다.
기다리는 사이클, 샘플링 에지, 칩 선택 신호의 유지 조건을 양 끝에서 맞춰야 한다. 설정 메뉴에 표시되는 최대값만 옮기는 것으로 호환성이 확보되지는 않는다. SSI 설정 가이드
짧은 전송에서는 명령이 데이터보다 비싸다
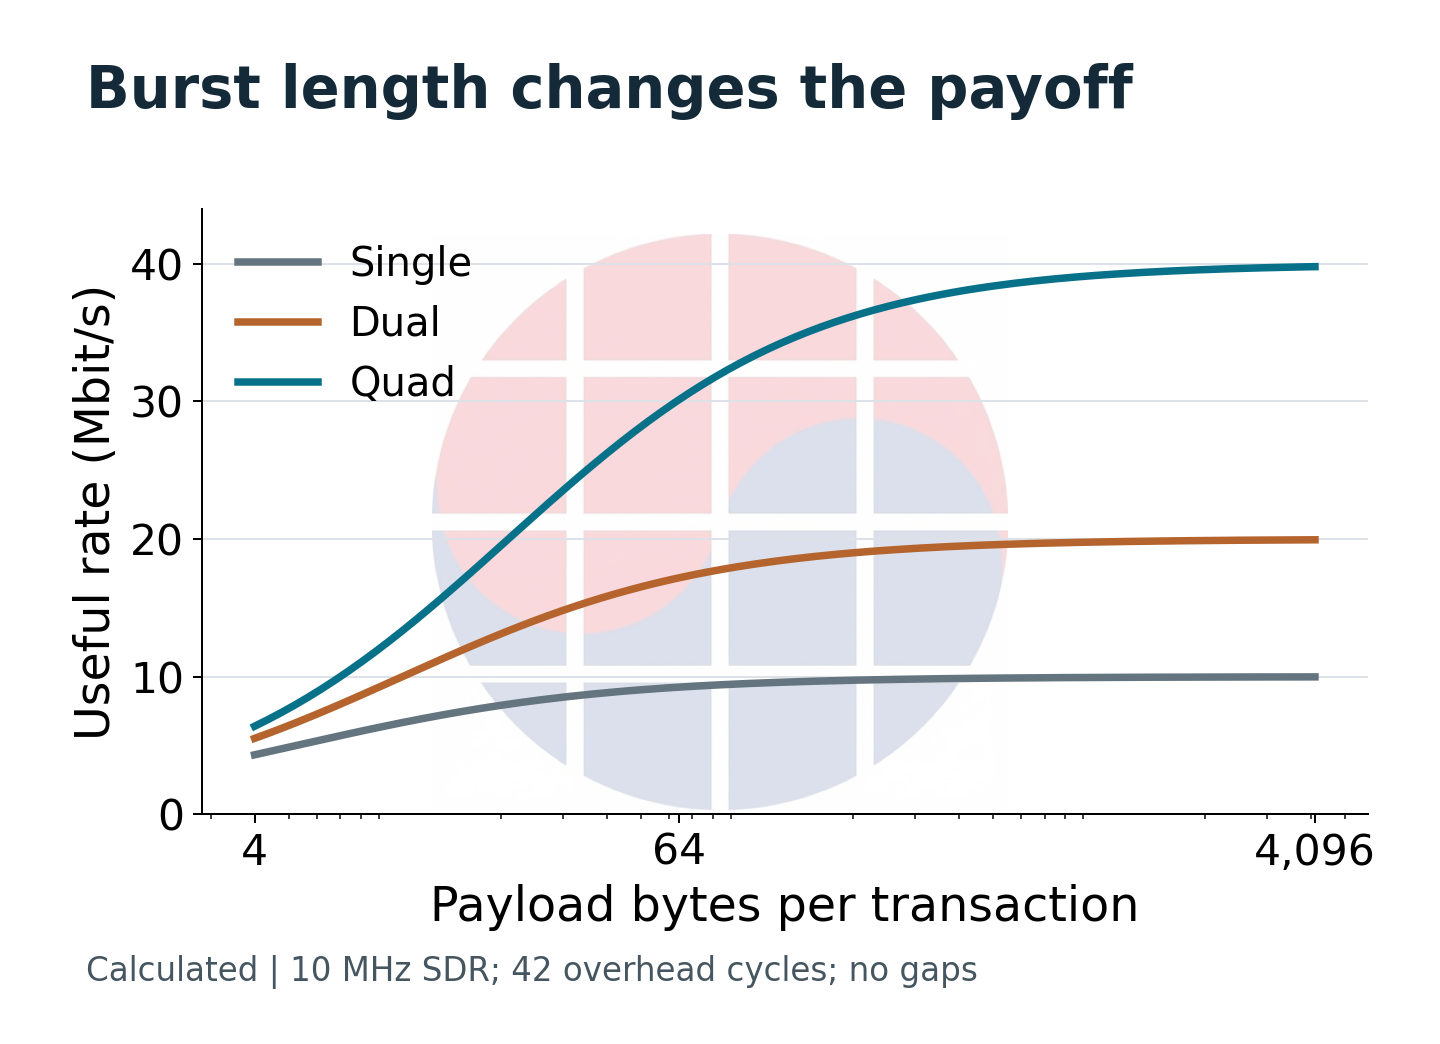
폭의 효과를 분리하기 위해 다음과 같은 가상 읽기를 정의하자. 클록은 모든 모드에서 10 MHz, 명령은 단일 선으로 8비트, 주소는 단일 선으로 24비트, 대기는 10사이클이다.
데이터 구간만 선 수 L에 따라 넓어진다. 이는 비교를 위한 공통 조건이며 특정 MCU에서 모든 조합이 그대로 동작한다는 보장은 아니다.
칩 선택 사이의 공백과 소프트웨어 지연은 우선 제외한다.
N바이트를 읽는 거래의 클록 수는 42 + 8N/L이다. 따라서 유효 페이로드 비트율은 8N × f / (42 + 8N/L)로 계산한다. f는 초당 클록 수다.
분자의 비트와 분모의 시간을 구분하면 MHz를 Mbit/s로 잘못 쓰는 실수도 줄어든다. 제품 설명의 원시 비트율 L × f는 데이터 구간만 계속 이어질 때 접근하는 값이다.
4바이트를 읽으면 단일 선은 약 4.32 Mbit/s, Dual은 5.52 Mbit/s, Quad는 6.40 Mbit/s다. 선이 늘어도 이미 지불한 명령·주소·대기 시간은 줄지 않는다.
반면 4,096바이트를 한 번에 읽는 Quad 예제는 약 39.80 Mbit/s로 원시 비트율 40 Mbit/s에 가까워진다. 같은 “Quad”가 작은 레지스터 읽기와 큰 샘플 버퍼 읽기에서 전혀 다르게 보이는 이유다.
| Payload per transaction | Single, Mbit/s | Dual, Mbit/s | Quad, Mbit/s |
|---|---|---|---|
| 4 bytes | 4.32 | 5.52 | 6.40 |
| 64 bytes | 9.24 | 17.18 | 30.12 |
| 4,096 bytes | 9.99 | 19.95 | 39.80 |
Table 2. The same illustrative assumptions as Figure 3; values rounded to 2 decimal places.
물론 버스트를 무한정 늘리는 것이 답은 아니다. 수신 버퍼를 점유하는 시간과 다른 작업의 대기 시간이 길어진다.
긴 거래 도중 오류가 나면 다시 보내야 하는 범위도 커질 수 있다. 제어 명령의 응답 기한이 촉박하면 데이터 덩어리를 나누는 선택이 더 낫다.
먼저 허용 지연을 정하고, 그 안에서 고정 오버헤드를 충분히 희석할 만큼의 크기를 고르는 것이 실무적인 순서다.
FIFO는 평균 속도의 불균형을 없애주지 않는다
버퍼는 생산자와 소비자가 서로 다른 순간에 일할 수 있게 한다. 하지만 평균 유입량이 평균 유출량보다 크면 유한한 버퍼는 결국 찬다.
이 차이를 클록 도메인 교차, 즉 CDC의 정확성 문제와 구분해야 한다. CDC가 안전하더라도 용량은 부족할 수 있고, 용량이 넉넉해도 상태 신호를 잘못 넘기면 데이터가 깨질 수 있다.
AMD의 Embedded FIFO Generator PG327은 쓰기·읽기 인터페이스의 신호를 각자의 클록 도메인에서 사용하고 full·empty 상태를 지키도록 요구한다. 독립 클록 FIFO의 상태 해제에는 동기화 지연도 있다.
방금 공간을 비웠다고 해서 반대편이 즉시 그 공간을 사용할 수 있는 것은 아니다. 이는 해당 IP의 동작 설명이며 TinyProbe에 이 IP가 들어갔다는 뜻은 아니다. 동기화 설명, 상태 플래그 설명
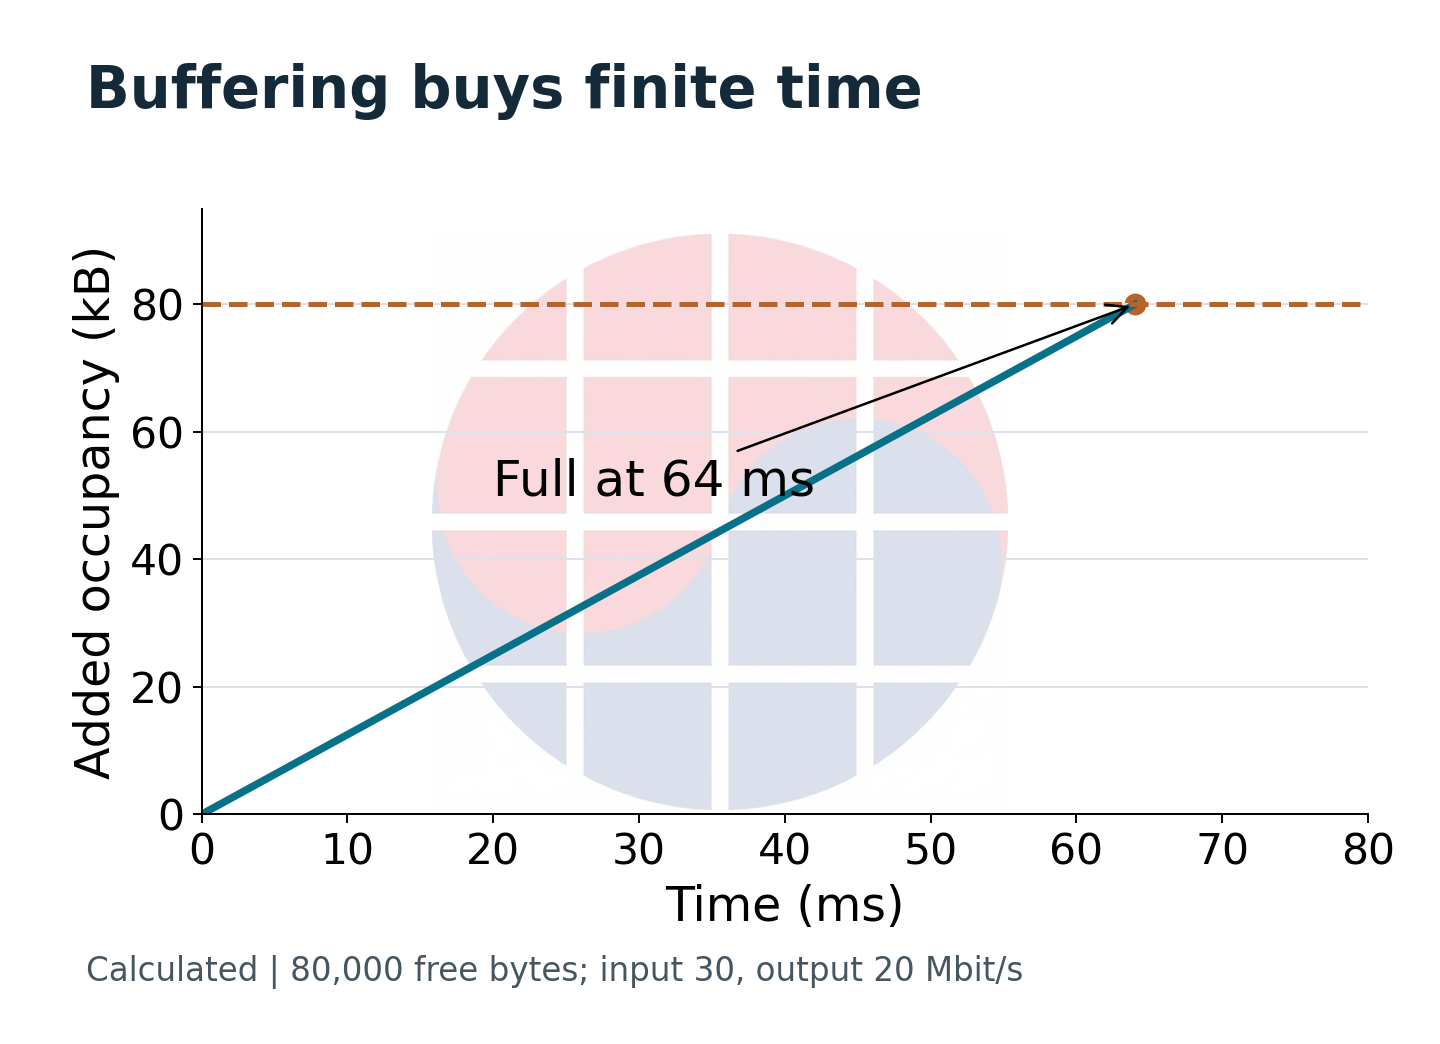
그림의 예제에서 남은 공간 80,000바이트는 640,000비트다. 유입 30 Mbit/s와 유출 20 Mbit/s의 차이로 나누면 64 ms 뒤에 여유가 사라진다.
처음부터 일부가 차 있거나 DMA 서비스가 멈추면 더 빨라진다. 따라서 필요한 것은 깊이 하나가 아니라 최악의 서비스 공백, 허용 손실, 멈출 수 있는 생산자인지에 대한 조건이다.
수집을 멈출 수 없다면 버퍼 증설은 유예 시간을 사는 선택이지 지속 처리량을 높이는 선택이 아니다.
데이터 단위도 함께 살펴야 한다. 샘플 폭과 메모리 저장 폭이 다르면 패딩이나 재포장이 생긴다.
전송한 바이트를 센서의 유효 비트로 계산할 때는 이 비율을 반영해야 한다. DMA를 쓰더라도 메모리 복사, 캐시 관리, 완료 통지 처리는 남을 수 있다.
이런 비용을 빼고 SPI만 측정하면 펌웨어 변경의 실제 가치를 비교하기 어렵다.
무선 경로와 겹쳐 보내는지가 전체 속도를 바꾼다
보드 안의 SPI가 빨라진 다음에는 MCU에서 호스트까지의 경로를 본다. 여기서 “가장 느린 링크가 전체 속도를 결정한다”는 표현도 조건을 갖는다.
여러 단계가 서로 다른 데이터 묶음을 동시에 처리하는 정상 상태라면 느린 단계가 상한을 정한다. 그러나 버퍼 전체를 읽은 뒤에야 네트워크 전송을 시작하고 그동안 다음 읽기를 멈춘다면 각 단계의 시간이 더해진다.
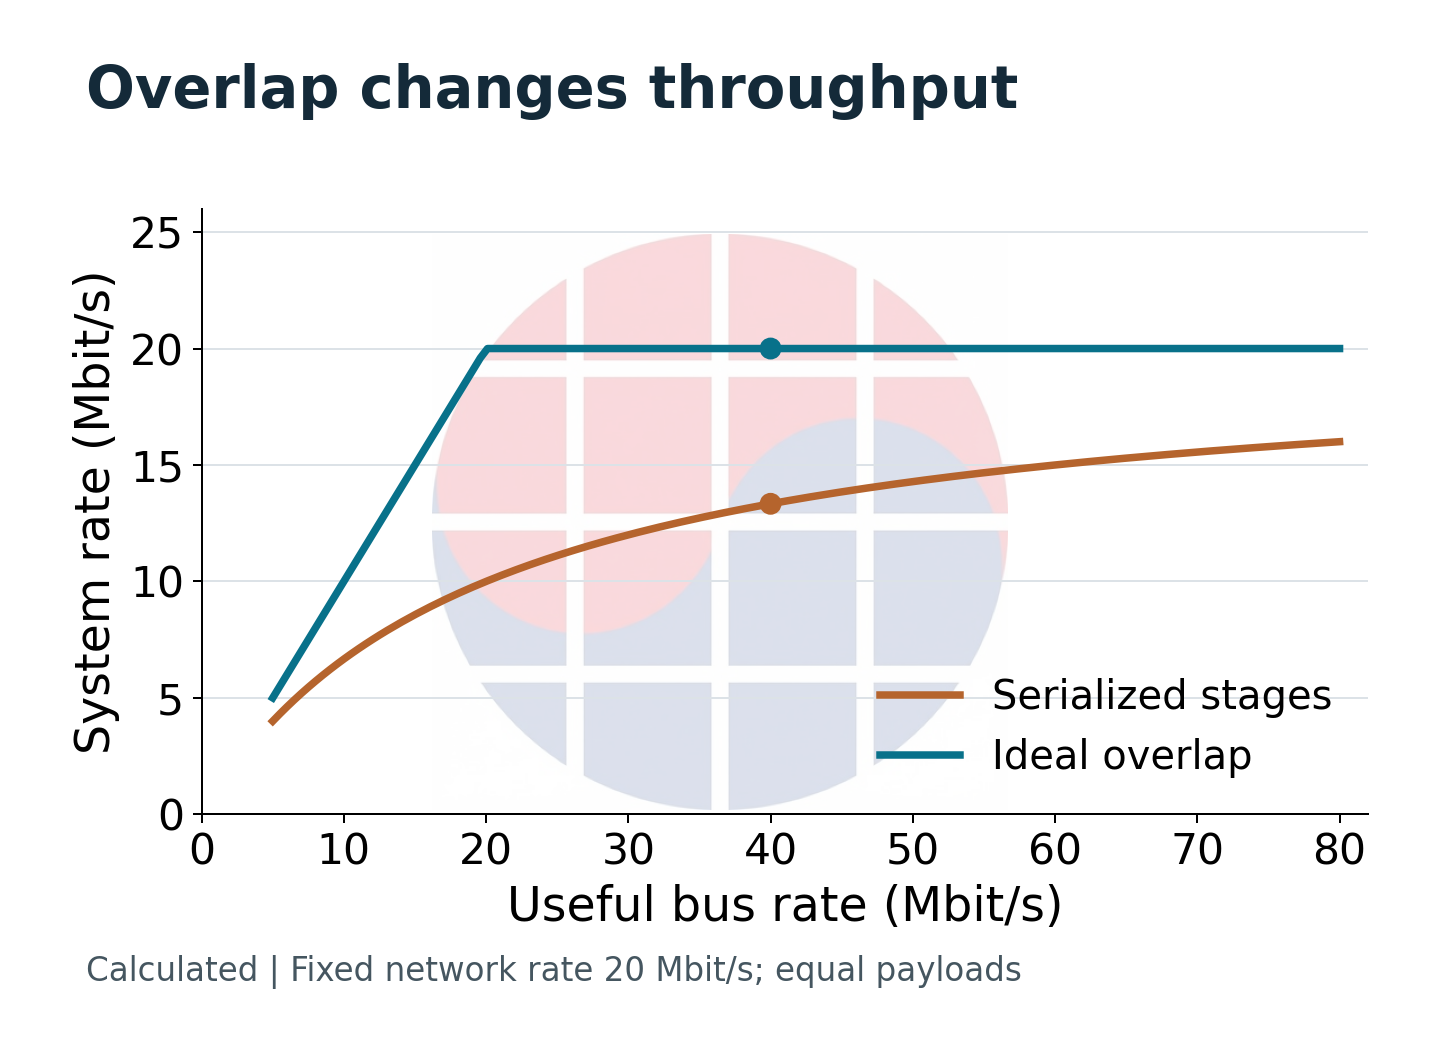
이를 보기 위해 같은 크기의 유효 데이터를 옮기는 버스가 40 Mbit/s, 네트워크가 20 Mbit/s라고 가정하자. 단계가 완전히 직렬이면 처리량은 1 / (1/40 + 1/20)인 약 13.33 Mbit/s다.
충분한 독립 버퍼와 자원이 있어 겹쳐 처리할 수 있다면 정상 상태의 이상적인 상한은 20 Mbit/s다. 이 숫자는 TinyProbe의 측정값이 아니며, 프로토콜 비용과 수집 시간도 제외한 별도 예제다.
| Scheduling | Model denominator | Limiting condition |
|---|---|---|
| Serialized | Sum of stage times | Each batch waits for the next stage |
| Overlapped | Slowest stage in steady state | Independent resources and buffers |
Table 3. Original model comparison. First-frame latency still includes every required stage.
이 차이는 무엇을 고칠지 바꾼다. 데이터 전송을 겹칠 수 없었던 구조라면 핀을 더 쓰기 전에 버퍼 소유권과 DMA 완료 경로를 바꾸는 편이 효과적일 수 있다.
이미 충분히 겹치고 네트워크가 포화된 구조라면 보드 내 버스의 추가 속도는 프레임률보다 여유 시간이나 지연의 일부에 기여할 수 있다. 같은 최적화라도 전제에 따라 제품 가치가 달라진다.
Boundary condition: 파이프라인의 처리량 상한을 첫 프레임의 도착 시간으로 읽으면 안 된다. 겹쳐 일해도 각 프레임은 필요한 단계를 모두 지나야 한다.
무선이라는 이유만으로 모든 공백을 전파 환경 탓으로 돌리는 것도 위험하다. MCU의 복사 작업, 공유 메모리 접근, 패킷을 쌓아두는 정책이 버스와 네트워크를 번갈아 쉬게 할 수 있다.
데이터 생성·읽기 완료·송신 인계·호스트 조립 완료의 타임스탬프를 연결하면, 더 빠른 무선 부품이 필요한지 현재 자원을 덜 기다리게 해야 하는지 구별할 수 있다.
시험대를 통과한 속도를 제품 사양으로 옮기는 조건
앞서 본 TinyProbe 연구의 의미는 서로 다른 시험을 분리해서 읽을 때 명확해진다. 독립 시험대는 인터페이스의 가능 범위를 조사하고, 통합 장치는 실제로 연결된 구성의 동작을 확인한다.
서로 다른 FPGA와 컨트롤러를 썼다면 그 결과를 하나의 성능 향상 배수로 묶을 수 없다. 또한 시험 중 오류가 관찰되지 않았다는 보고는 모든 온도·전압·배선 조건에서의 오류율 보증과 다르다.
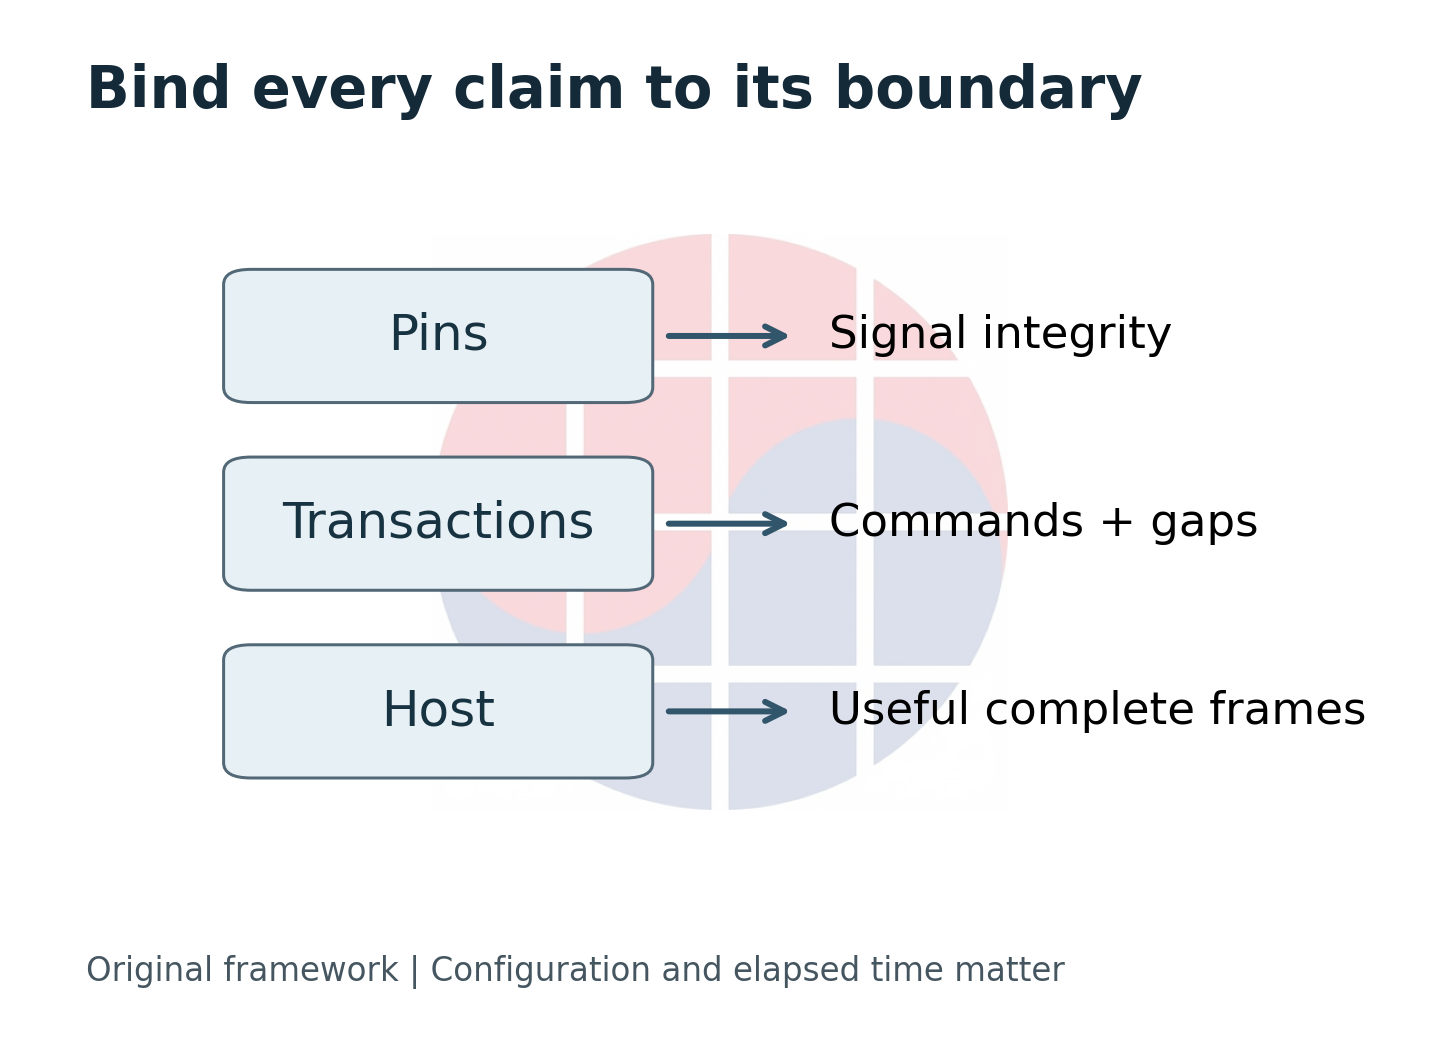
설계 검토용 성능표에는 적어도 세 경계를 남기는 것이 좋다. 핀의 데이터 구간, 명령과 공백을 포함한 거래, 호스트에서 완성된 유효 데이터다.
각 경계를 연결하면 버스 내부 개선과 시스템 개선을 동시에 설명할 수 있다. 버스가 빨라졌는데 호스트 수치가 그대로인 결과도 실패한 측정이 아니라 병목 위치를 알려주는 관찰이 된다.
처음에는 반복 패턴으로 배선과 비트 순서를 확인하고, 다음에는 실제 샘플 형식과 버퍼 경계를 넣는다. 마지막에는 네트워크 부하와 서비스 공백을 함께 주어 버퍼가 넘칠 때 무엇을 잃고 어떻게 회복하는지 확인한다.
매번 조건 전체를 바꾸면 개선 원인을 분리할 수 없으므로, 비교할 변수를 정하고 다른 조건은 유지한다. 성공한 짧은 전송만 고르면 장시간 수집의 취약점을 놓치기 쉽다.
국내 설계팀이 먼저 바꿀 것은 성능표의 분모다
국내 센서 모듈·FPGA·임베디드 제품팀에도 이 문제는 부품 선택과 일정 관리의 문제다. 더 넓은 인터페이스를 쓰면 추가 핀과 배선, 새 드라이버, 검증 범위가 따라온다.
컨트롤러를 바꾸면 전력 상태와 소프트웨어 자산까지 영향을 받을 수 있다. 반대로 버스트 병합이나 전송 중첩으로 해결되는 병목이라면 기존 보드의 가치를 더 오래 유지할 수 있다.
어느 쪽이 저렴한지는 구매 단가만으로 결정되지 않는다.
| Observed constraint | Candidate intervention | Tradeoff |
|---|---|---|
| Short transactions | Aggregate bursts | Control latency and buffer occupancy |
| Stages take turns | Overlap transfers | Buffer ownership and memory contention |
| Bus stays saturated | Wider or faster interface | Pins, power and validation effort |
Table 4. Editorial decision framework. Choose the intervention only after measuring the stated constraint.
그래서 설계팀이 구매·사업 담당자에게 전달할 숫자는 최대 클록 하나보다, 목표 데이터가 도착하는 시간과 이를 달성한 구성이어야 한다. “이번 변경으로 어디의 공백이 줄었는가”, “같은 입력과 손실 조건에서 완성 프레임이 더 많이 도착하는가”를 함께 묻는다. 부품 교체의 명분은 넓어진 버스 자체가 아니라 필요한 작업을 더 적은 지연이나 자원으로 끝내는 데 있다.
앞으로 6–12개월의 관찰점은 높은 클록의 재시연보다 통합 경로의 데이터다. TinyProbe 후속 공개 자료가 컨트롤러·펌웨어 버전을 특정하고, 버퍼 정책과 호스트 유효 처리량을 연결한다면 버스 변경의 제품 가치를 더 정확히 판단할 수 있다.
다음 점검 기준일은 2027-04-03이다. 이것은 출시 예고가 아니라 편집상의 재평가 시점이다.
이 글의 판단을 바꿀 조건도 분명하다. 동일한 입력·네트워크·전력 조건에서 현재 버스가 계속 포화돼 있고, 전송을 충분히 겹쳐도 호스트가 데이터를 기다린다는 측정이 나오면 버스 확장은 직접적인 우선순위가 된다.
그 전에는 선 수를 정하기보다 경계를 정하고 시간을 나누어 재는 편이 낫다. 좋은 인터페이스 설계는 더 큰 숫자를 얻는 데서 끝나지 않고, 그 숫자가 독자의 장치에서 무엇을 줄여주는지 설명한다.
Sources
- TinyProbe multi-wire SPI paper, arXiv v1. 프리프린트 본문 확인. 제출 이력의 IUS 2026 채택 표기는 저자 제공 정보이며 IEEE 최종 게재를 별도로 확인한 것은 아니다.
- Silicon Labs SSI developer guide v1.0.3, FAQ, configuration. 같은 제조사의 문서 묶음이다.
- TI AFE5832LP product documentation. 공개 제품 페이지를 확인했다.
- AMD PG327 synchronization and flags, version 1.0, 2023-05-16.
- TinyProbe official repository, photo authorship, image license. 사진은 Sergei Vostrikov의 실제 TinyProbe 사진이며 CC BY 4.0에 따라 사용한다. 논문의 새 인터페이스가 사진의 보드에 설치됐음을 입증하는 이미지는 아니다.
본문 계산·도식은 VLSI Korea의 설명용 모델이며 실험을 수행했다는 의미가 아니다. AI를 활용해 원고·번역·설명 자료를 준비했다.
Disclosure
본 글은 정보 제공만을 목적으로 하며, 특정 증권의 매수 또는 매도를 권유하는 것이 아닙니다. 본 글에 포함된 수치와 사실은 기업 공시, 언론 보도, 시장 조사 등 공개적으로 이용 가능한 자료를 바탕으로 작성되었으며, 해당 자료 또는 작성 과정에서 오류가 발생할 수 있습니다. 필자는 언급된 기업의 주식을 보유하고 있을 수 있습니다. 모든 투자 결정 및 그에 따른 결과는 독자의 책임입니다.


