 VLSI Korea
TLB 프리페치, 미스가 줄어도 메모리는 더 바쁠 수 있다
주소 변환을 미리 읽는 설계의 손익은 정확도·도착 시점·추가 트래픽에서 갈린다. 자체 계산 예제로 MMU와 플랫폼 팀의 판단 기준을 짚는다.


TLB 프리페치는 다음에 필요할 주소 변환을 먼저 준비해 대기를 줄인다. 그러나 미스가 줄었다고 메모리의 일이 줄었다고 볼 수는 없다. 쓰이지 않은 예측, 너무 일찍 도착해 쫓겨난 변환, 예측 이력을 갱신하는 쓰기가 모두 자원을 소비하기 때문이다. 설계의 목표는 미스율 최소화가 아니라, 실제 실행을 막는 주소 변환 대기를 전체 비용보다 많이 줄이는 것이다.
VLSI Korea view: 번역을 먼저 시작했다는 사실과 번역 비용을 없앴다는 사실은 다르다. 프리페처는 정확도와 함께 도착 시점, 메모리 트래픽, 오래된 변환의 폐기까지 설계해야 한다.
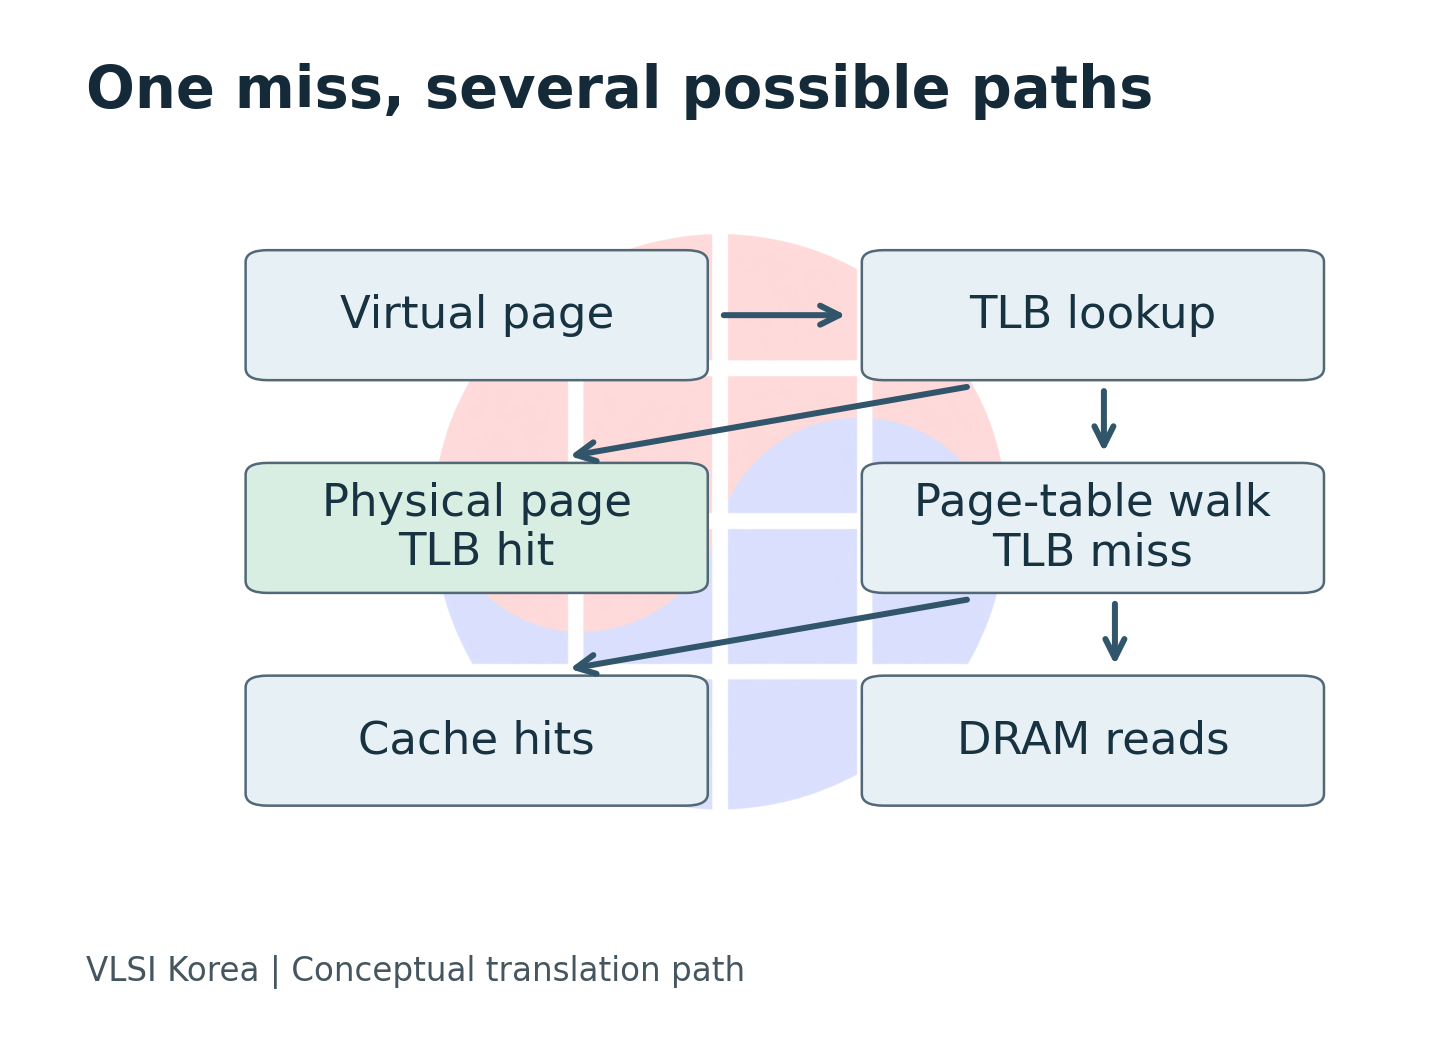
미스 하나가 곧 DRAM 왕복 하나는 아니다
주소 변환 캐시인 TLB는 가상 페이지와 물리 페이지의 대응을 빠르게 공급한다. 여기서 찾지 못하면 주소 변환 절차가 페이지 테이블을 따라 필요한 항목을 구한다. 그 과정의 읽기도 캐시 계층을 이용할 수 있다. 따라서 마지막 단계 TLB 미스 수, 페이지 테이블 탐색 수, 실제 DRAM 읽기 수는 서로 다른 계수다. 이를 하나로 취급하면 프리페치가 옮겨 놓은 일을 없앤 일로 오해하기 쉽다. Agile TLB Prefetching의 배경과 설계는 이미 가져온 캐시 라인 안의 이웃 PTE를 선택적으로 활용하는 접근을 보여 준다.
실제 칩 사례로 대표 사진의 Baikal-T1을 보자. ZeptoBars가 2017-02-28 공개한 분해 사진은 MIPS P5600 코어를 사용한 이 칩의 다이를 보여 준다. Linux v6.17의 CPU 탐지 코드에는 P5600을 위한 FTLB 활성화와 설정 경로가 있다. 이는 주소 변환 구조가 실리콘과 시스템 소프트웨어 사이의 구체적 접점임을 보여 준다. 사진만으로 TLB 용량이나 프리페처 유무를 알아낼 수는 없으며, 이 역사적 칩에 아래 연구 기법이 구현됐다는 뜻도 아니다.
| Event | What it establishes | What it does not establish |
|---|---|---|
| Last-level TLB miss | Cached translation was unavailable | DRAM was accessed |
| Page-walk cache hit | Part of the traversal was reused | The final translation was cached |
| Prefetch used | Demand consumed a prediction | It arrived early enough to remove all waiting |
MMU 설계자는 먼저 어떤 대기가 긴지 구분해야 한다. 변환이 늦어 코어가 멈췄는지, 변환은 끝났지만 데이터 응답을 기다리는지에 따라 같은 미스 감소의 가치가 달라진다. 여러 요청이 겹쳐 처리되는 시스템에서는 개별 탐색 지연의 합이 전체 실행시간과 같지도 않다. 없앤 탐색의 상당수가 다른 작업 뒤에 가려져 있었다면 미스 계수는 좋아져도 프로그램은 거의 빨라지지 않을 수 있다.
플랫폼 엔지니어의 첫 결정도 여기서 갈린다. 할당 정책을 바꿀지, 캐시 크기를 바꿀지, 프리페처를 추가할지 결정하기 전에 동일한 작업의 주소 변환 대기와 데이터 대기를 분리해 보아야 한다. 프리페치를 켠 실행에서 작업량이나 페이지 배치까지 바뀌면 개선 원인이 섞인다. 동일 작업·동일 배치와 실제 배치 변화에 대한 실험은 별개의 질문으로 다루는 편이 판단하기 쉽다.
| Mechanism | State to retain | Cost to inspect |
|---|---|---|
| Spatial prediction | Nearby-page relationship | Unused neighboring translations |
| Per-instruction history | Previous region per instruction | Aliasing and phase changes |
| Page-associated history | Successor hints near translation state | Metadata writes and compatibility |
예측 이력을 어디에 두느냐가 설계를 바꾼다
최근의 출발점은 Trail 프리프린트다. 제출 시각은 2026-10-06 15:00:44 UTC이며, 이번 조사에서는 다음 날 공개 목록에서 확인했다. 연구진은 같은 명령어에서 이어진 영역 간 이동을 학습하고, 이전 영역의 페이지 테이블 항목에 다음 영역을 가리키는 델타를 저장한다. 다시 그 항목을 읽을 때 예측 단서도 함께 얻는 방식이다. 사용 가능한 비트는 하드웨어와 소프트웨어의 합의를 전제로 하며, 부족하면 외부 델타 테이블을 쓰는 변형을 제안한다. 본문의 설계 설명을 확인했으며 여기서는 시뮬레이션 수치를 제품 성능으로 옮기지 않는다.
왜 명령어별 이력이 도움이 될 수 있을까. 설명용으로 명령어 A가 영역 10을 읽고, B가 40을 읽고, 다시 A가 14를 읽는 순서를 만들자. 전체 순서만 보면 이동은 +30과 −26이다. A의 이력만 보면 +4다. 이는 예측값이 메모리의 물리적 이동 거리와 같은 것이 아니라, 무엇을 같은 흐름으로 묶었는지에 따라 바뀌는 학습 표현이라는 뜻이다.
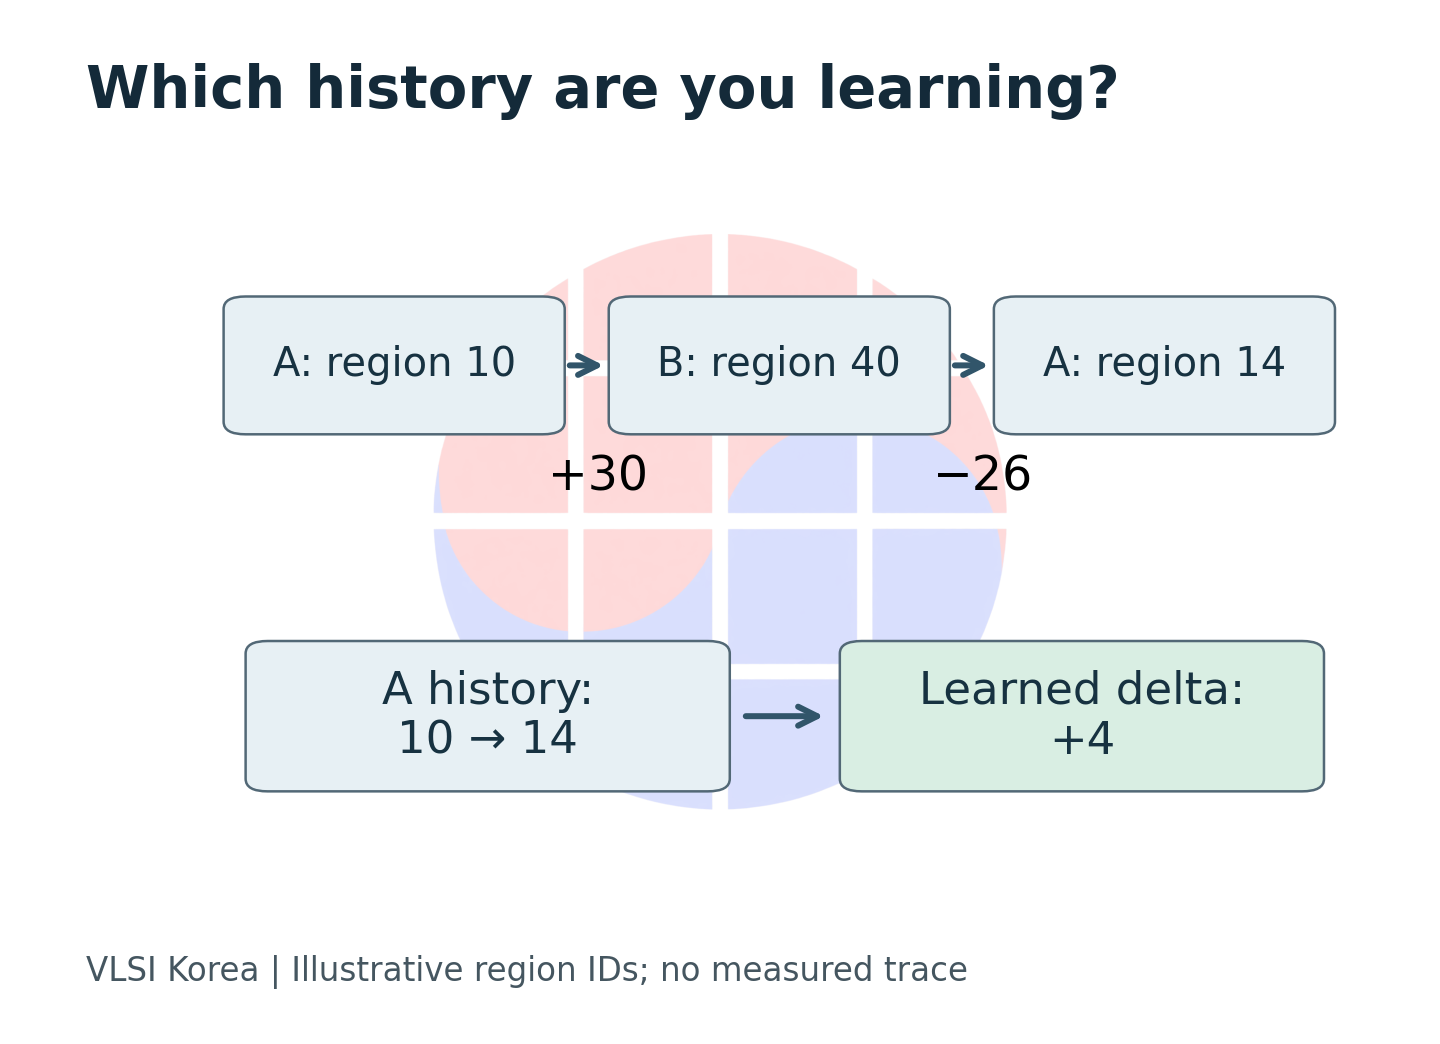
이 예제에서 +4가 다음에도 맞는다는 보장은 없다. A가 다른 자료구조를 처리하기 시작하면 같은 명령어라도 패턴이 바뀐다. 영역을 크게 묶으면 기억해야 할 종류는 줄 수 있지만, 그 영역의 변환을 얼마나 실제로 쓰는지는 별도로 따져야 한다. 반대로 작은 영역을 사용하면 불필요한 선행 읽기를 줄이는 대신 더 많은 이력이 필요할 수 있다. 이 선택은 주소 공간의 압축과 유용한 예측의 보존 사이의 교환이다.
이력의 저장 위치를 바꾸는 발상도 같은 관점에서 평가할 수 있다. 전용 테이블을 작게 만든 효과만 보면 매력적이지만, 학습한 내용을 어디서 읽고 언제 수정하는지까지 따라가야 한다. 기존 읽기에 편승하는 메타데이터 접근과, 새 예측을 실행하기 위해 일으키는 접근은 별개의 비용이다. 메타데이터가 가까이 있다는 이유만으로 목적지의 변환까지 공짜로 얻는 것은 아니다. 설계 검토에서는 저장 바이트, 갱신 빈도, 예측 발행률을 다른 항목으로 남기는 것이 좋다.
| Cost path | Question |
|---|---|
| Hint read | Already fetched? |
| History update | Dirty line written back? |
| Predicted walk | Extra hierarchy requests? |
같은 작업을 놓고 메모리 장부를 다시 써 보자
다음은 논문 재현이 아닌 VLSI Korea의 설명용 계산이다. 프리페처를 끈 동일 작업에서 수요 변환 100건이 모두 탐색을 일으키고, 각 탐색이 캐시를 거친 뒤 평균 2회의 DRAM 읽기를 만든다고 가정한다. 기준 비용은 200회다. 프리페처가 제때 유용한 변환 U건을 공급하면 남은 수요 읽기는 (100−U)×2다. 여기에 프리페치 자체가 일으킨 DRAM 읽기와 메타데이터 쓰기 되돌림을 더한다.
선별적 설정은 예측 20건 중 16건을 제때 공급한다고 가정한다. 예측 한 건의 평균 DRAM 읽기를 0.5회로 두면 예측 읽기는 10회다. 메타데이터 쓰기 되돌림 10회를 더한 합계는 188회다. 공격적 설정은 60건을 예측해 36건을 제때 공급하지만, 예측당 DRAM 읽기가 2회라면 합계가 258회로 늘어난다. 두 설정 모두 수요 미스는 줄지만 전체 메모리 거래의 방향은 반대다.
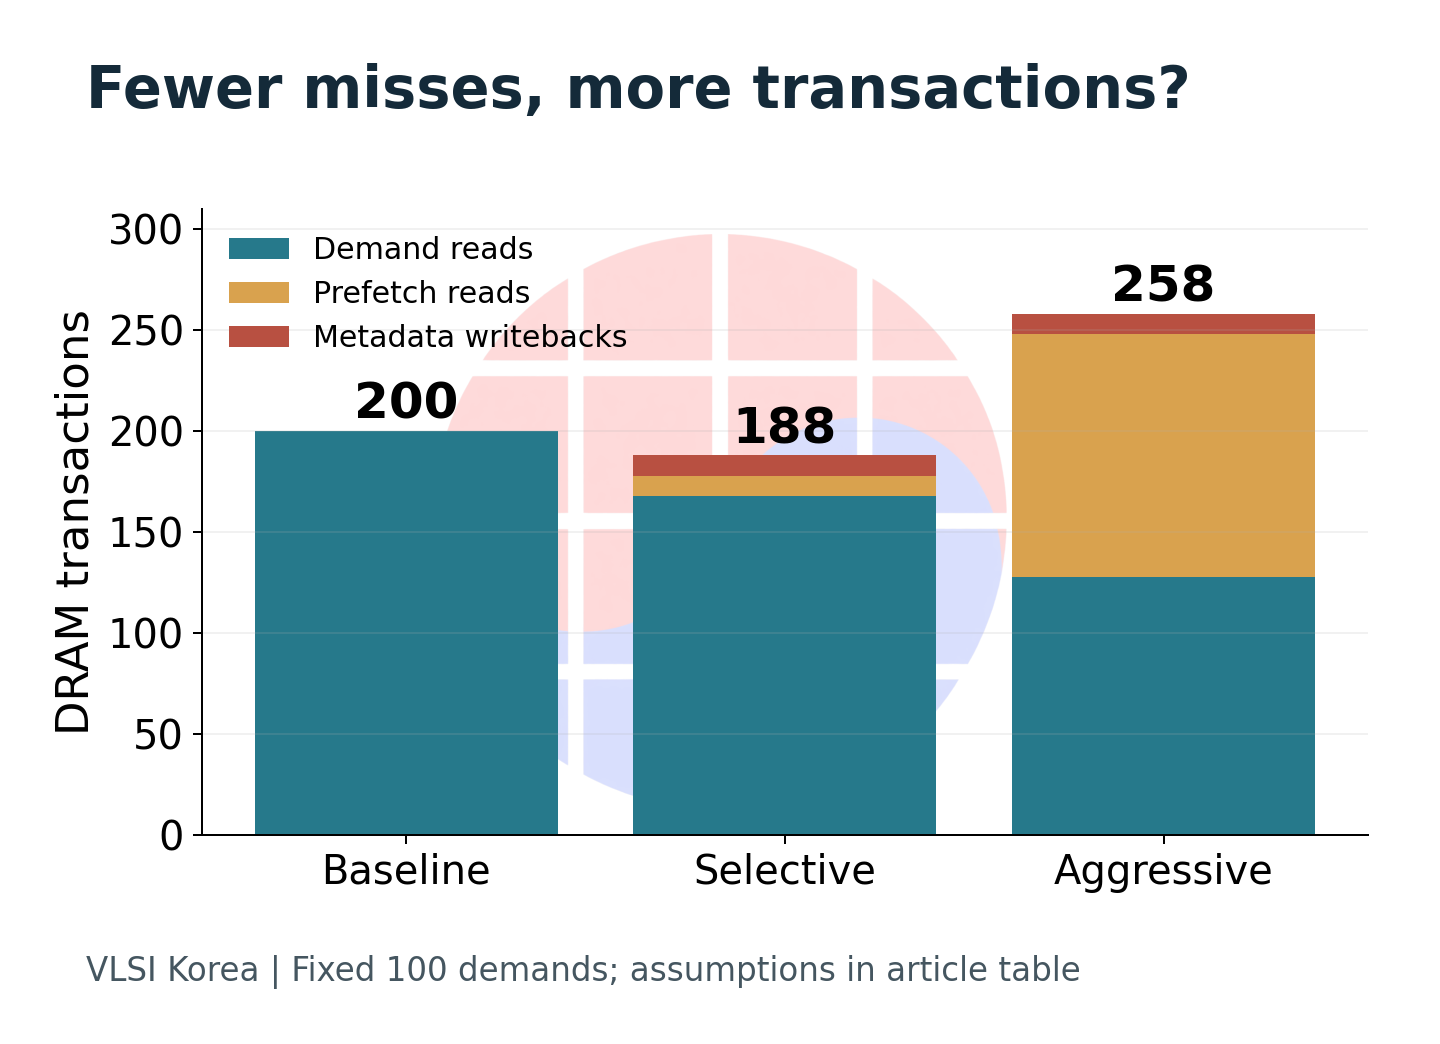
여기서 거래 수는 읽기와 쓰기 되돌림을 각각 한 건으로 센 단순 장부다. 같은 크기의 거래라도 읽기·쓰기 전환, 대기열, 뱅크 병렬성과 우선순위에 따라 시간이 달라지므로 이 합계를 지연이나 전력으로 바로 바꾸면 안 된다. 계산은 기존 데이터 트래픽을 고정하고 변환 관련 추가분만 비교하며, 프리페치가 데이터 캐시의 유용한 줄을 밀어내는 효과도 제외했다. 실제 시스템에서는 그 효과를 다시 포함해야 한다.
특히 ‘유용함’을 언제 판정했는지가 중요하다. 나중에 한 번 쓰인 예측이라도 수요 요청보다 늦게 끝났다면 이미 발생한 대기를 전부 없애지 못한다. 너무 일찍 도착한 예측은 사용 전에 축출될 수 있다. 따라서 정확도, 수요 미스를 제때 막은 비율, 늦은 예측, 사용 전 축출을 구분해야 한다. 같은 정확도에서도 요청 간 간격과 큐의 혼잡 정도가 달라지면 체감 성능은 달라질 수 있다.
VLSI Korea view: 이 계산의 반증 조건은 명확하다. 줄인 수요 대기보다 추가 읽기·쓰기·경합의 비용이 커지면, 더 많은 미스를 막는 설정도 채택할 이유가 없다.
| Toy case | Issued prefetches | Timely useful prefetches | Residual demand reads | Prefetch reads | Metadata writebacks | Total |
|---|---|---|---|---|---|---|
| Baseline | 0 | 0 | 200 | 0 | 0 | 200 |
| Selective | 20 | 16 | 168 | 10 | 10 | 188 |
| Aggressive | 60 | 36 | 128 | 120 | 10 | 258 |
큰 페이지는 예측과 다른 비용을 바꾼다
큰 페이지는 한 변환 항목이 덮는 주소 범위를 넓힌다. 프리페치는 필요한 변환을 얻는 시점을 앞당긴다. 두 방법을 같은 ‘TLB 개선’으로 묶더라도 실제 변경하는 것은 다르다. Linux 6.17의 Transparent Hugepage 문서는 큰 페이지의 TLB 이점과 함께, 일부만 사용하는 영역에서 메모리 낭비가 생길 수 있고 할당·압축 과정이 지연을 만들 수 있음을 설명한다. 문서의 페이지 크기는 아키텍처별로 달라질 수 있는 예시다.
용량 효과만 떼어 보기 위해 가상의 TLB를 64항목으로 고정하자. 각 항목이 서로 다른 4 KiB 페이지를 나타내면 이상적인 커버리지는 256 KiB다. 2 MiB 페이지라면 128 MiB이며 비율은 512배다. 이것은 접근 가능한 가상 주소 범위를 세는 계산이지, 처리량이 그 비율만큼 증가한다는 예측이 아니다. 중복·충돌·교체 정책과 여러 페이지 크기의 혼재도 이 단순 계산에서 제외했다.
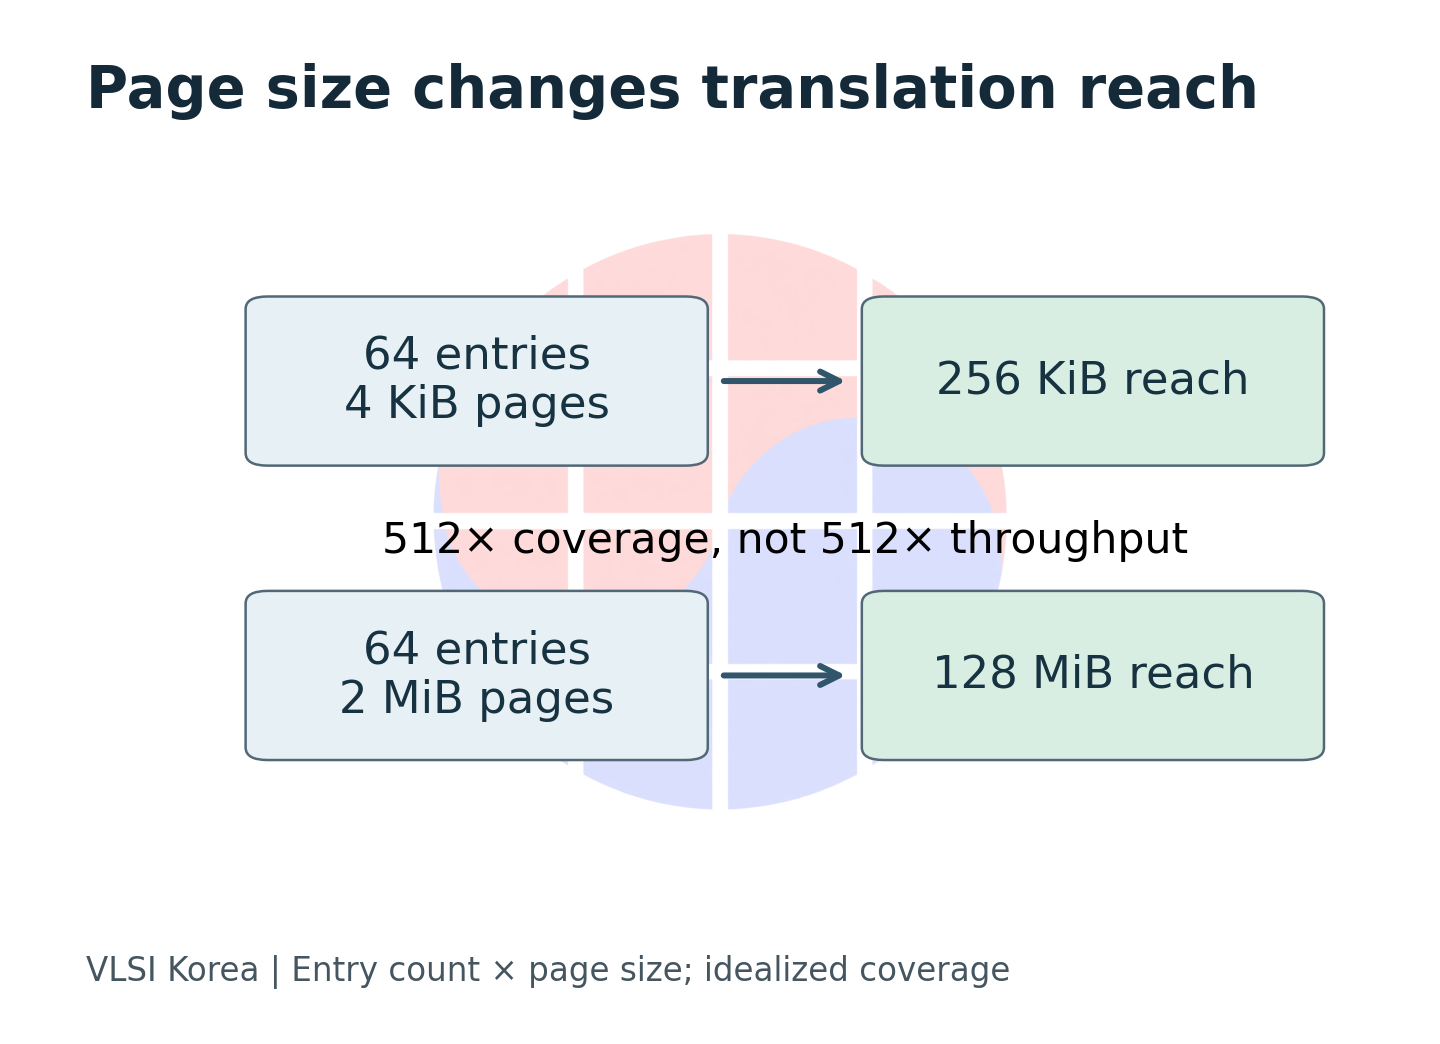
그래서 비교 기준에는 현재 배포에서 실제로 얻는 페이지 크기를 써야 한다. 큰 페이지가 늘어난 환경에서는 남은 변환 미스의 성격 자체가 달라질 수 있다. 전체 요청에서 적은 비중을 차지하지만 매우 불규칙한 주소만 남았다면 과거의 예측 정확도를 그대로 적용하기 어렵다. 반대로 큰 페이지를 얻기 어려운 짧은 수명의 할당이 많다면 다른 결과가 나올 수 있다. 크기별 요청 분포와 할당 수명을 함께 보아야 한다.
실무에서 바꿀 결정은 ‘큰 페이지를 항상 켠다’가 아니다. 지연에 민감한 요청의 할당 비용까지 포함했을 때 어느 메모리 영역에 적용할지를 정하는 것이다. 프리페처의 평가도 동일한 페이지 정책 아래에서 시작해야 한다. 이후 큰 페이지와 함께 쓸 때의 추가 이득을 별도로 측정하면, 같은 병목을 이미 줄인 두 기능의 효과를 중복 계산하는 실수를 피할 수 있다.
| Choice | Potential benefit | Counter-cost to include |
|---|---|---|
| Larger pages | More bytes covered per translation | Allocation, compaction, unused space |
| More TLB entries | More simultaneously retained translations | Lookup structure and replacement behavior |
| Prefetch | Translation work starts earlier | Extra walks, contention, early eviction |
PTE의 빈 비트보다 먼저 주소의 수명을 보자
PTE에 쓸모없는 것처럼 보이는 비트가 있어도 구현자가 임의로 써도 된다는 뜻은 아니다. RISC-V Supervisor ISA 1.13 문서는 소프트웨어용 RSW와 미래 표준용 예약 비트를 구별한다. 지정된 예약 비트가 설정되면 페이지 폴트가 생기는 경우가 있고, SFENCE.VMA의 동기화 범위도 로컬 hart에 한정된다. 따라서 ‘현재 안 쓰는 것 같다’는 관찰은 이식 가능한 메타데이터 저장 계약을 대신하지 못한다.
더 본질적인 질문은 예측이 주소의 재사용을 어떻게 견디는가다. 가상 주소 V가 물리 페이지 P를 가리키던 동안 시작한 선행 탐색을 생각하자. 운영체제가 V를 Q로 바꾸고 기존 변환을 무효화한 뒤, 오래된 탐색 결과가 도착한다면 어떨까. 그 결과를 다시 유효한 변환으로 설치해서는 안 된다. Linux의 캐시·TLB 무효화 문서가 정의하는 갱신 후 가시성은 프리페처를 추가해도 보존해야 하는 기준이다.
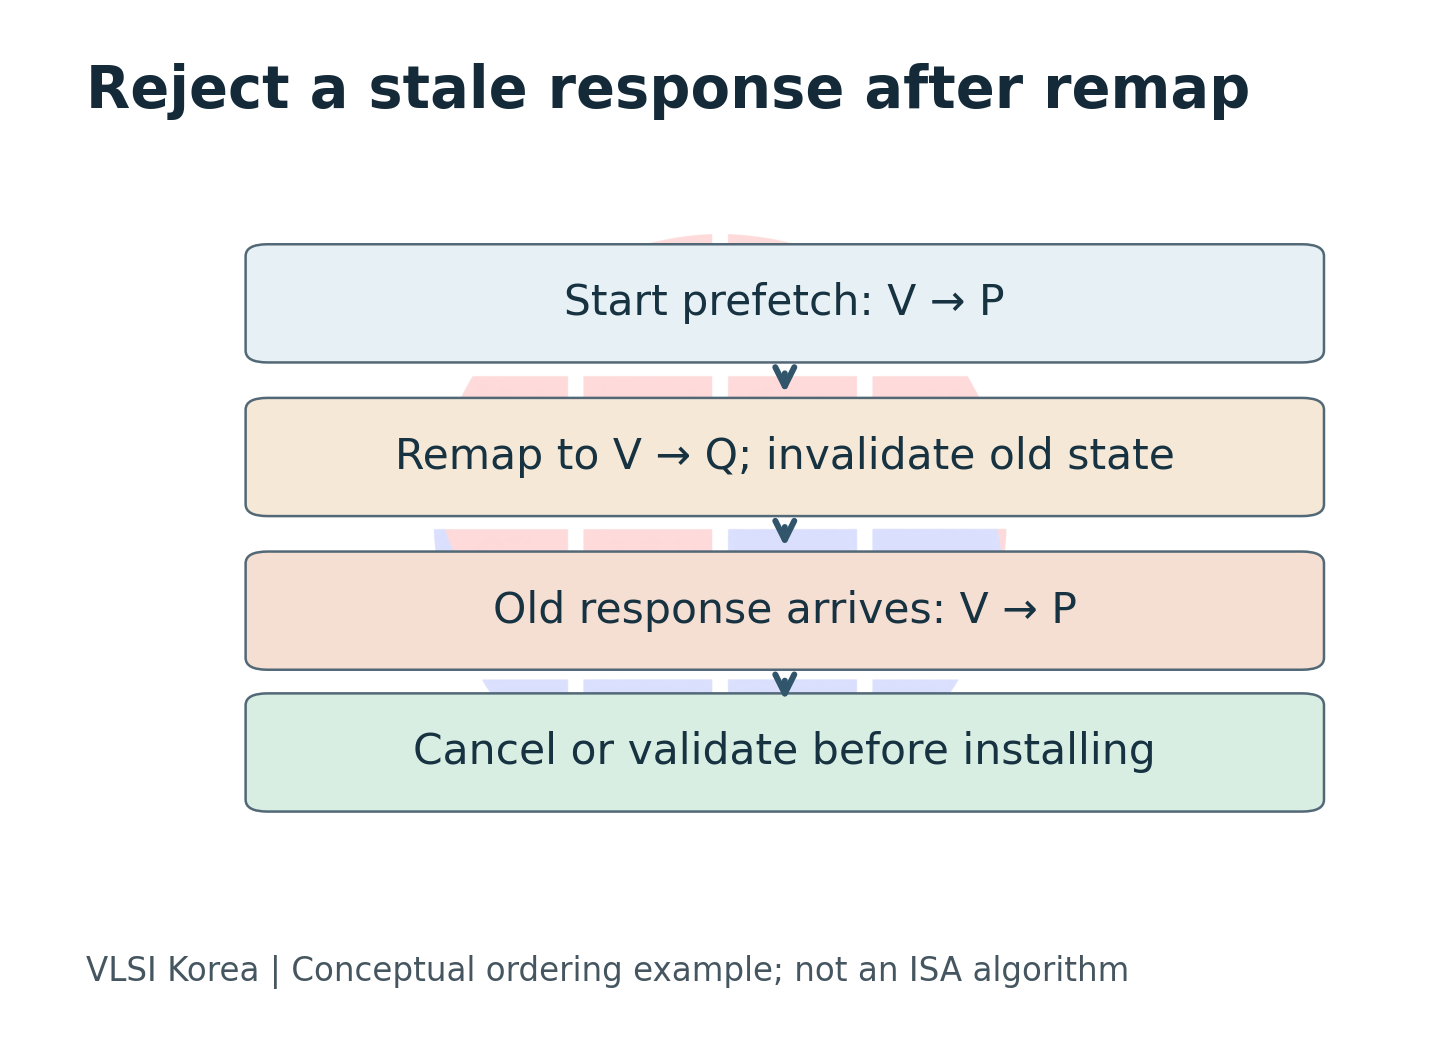
설명 가능한 설계 선택은 진행 중인 작업을 취소하거나, 결과가 도착했을 때 주소 공간과 무효화 세대가 여전히 유효한지 확인하는 것이다. 이것은 특정 명령어 집합이 세대 카운터를 요구한다는 주장이 아니라, 오래된 응답을 구별하기 위한 구현 선택의 예다. 단순히 큐만 비우는 것으로 충분한지는 큐 밖에 이미 나간 메모리 요청과 복귀 경로까지 추적해야 알 수 있다.
예측 힌트와 접근 권한도 분리해야 한다. 잘못된 힌트는 원칙적으로 성능 손실로 끝나도록 설계하고, 실제 변환의 주소·권한 확인을 대신하게 해서는 안 된다. 프로세스 전환, 주소 공간 식별자 재사용, 페이지 크기 변경은 이 분리가 흔들리기 쉬운 상황이다. 기능 검증에서는 요청을 보낸 순간만 보지 말고, 무효화와 응답 도착 순서를 바꾸어 같은 주소가 다른 의미를 갖는 장면을 만들어야 한다.
| State | Who owns its meaning? | Required separation |
|---|---|---|
| Architectural PTE fields | ISA and operating system | Address, permission and status |
| Prediction hint | Agreed hardware/software extension | Advisory value, never access authority |
| Cached translation | Translation subsystem | Address-space and invalidation scope |
한국의 설계·플랫폼 팀이 나눠 맡을 결정
한국의 CPU·SoC·가속기 개발팀에 이 문제는 코어 내부 최적화와 메모리 시스템의 경계를 함께 보라는 요구다. MMU 담당자는 작은 예측 테이블의 면적만 제시하기보다, 발행 큐와 중복 제거, 무효화 경로까지 포함한 설계 비용을 설명해야 한다. 플랫폼 담당자는 실제 프로그램의 할당 수명과 페이지 배치를 제공해야 한다. 한쪽의 이상적인 주소 흐름만으로 다른 쪽의 제품 이득을 보증할 수는 없다.
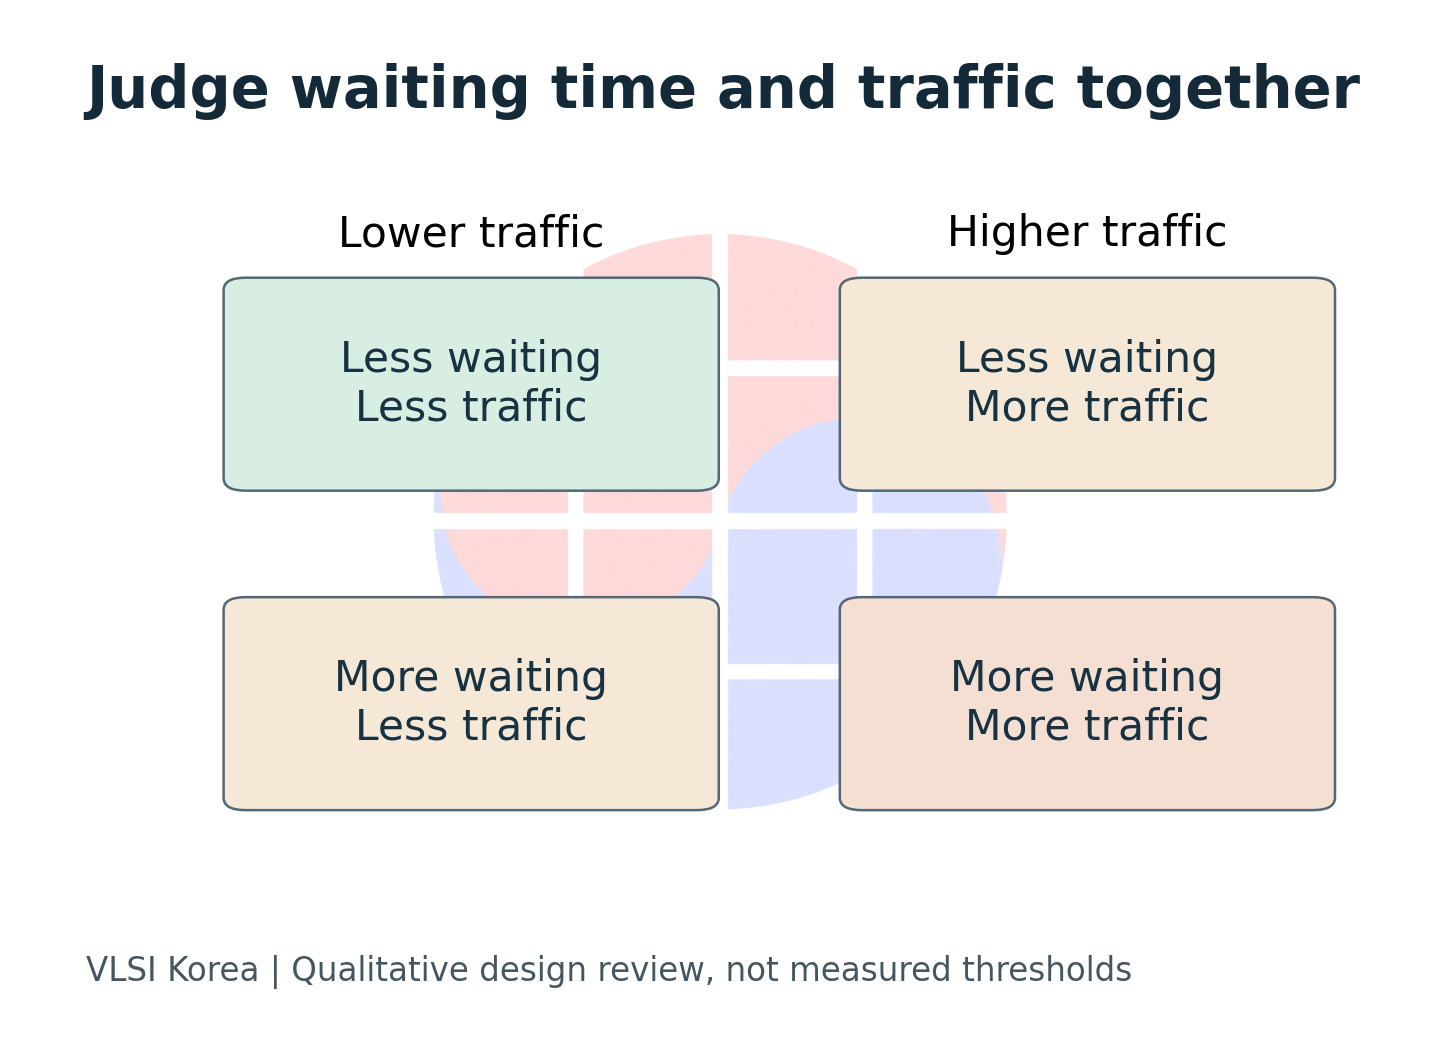
메모리 시스템을 평가하는 팀에는 또 다른 의미가 있다. 더 빠른 메모리를 붙인 뒤 성능이 좋아졌더라도 애플리케이션 데이터와 주소 변환 트래픽을 구분해야 한다. 변환 관련 읽기가 경합을 키우는 경우라면 프리페처를 억제하는 편이 우선일 수 있다. 반대로 대역폭 여유가 있고 변환 대기가 노출된다면 추가 거래를 허용할 근거가 생긴다. 어느 경우인지는 같은 작업의 완료시간과 트래픽을 함께 보아야 판정할 수 있다.
| Reader job | Immediate decision | Evidence that can reverse it |
|---|---|---|
| MMU architect | Budget queue, state and issue rate | Timely coverage falls under contention |
| Platform engineer | Tune page policy or prefetch first | Allocation tail cost exceeds saved stalls |
| Memory-system engineer | Attribute bandwidth pressure | Page-walk traffic, not application bytes, rises |
앞으로 6–12개월의 관찰점은 최고 미스 감소율 하나가 아니다. 공개 구현에서 주소 공간 전환과 매핑 변경을 포함한 결과가 나오는지, 동일한 페이지 정책과 메모리 제약에서도 이득이 남는지, 데이터와 예측 트래픽이 분리돼 보고되는지를 보자. 연구용 프로토타입을 검토하는 팀이라면 자신의 자료구조·수명·경합 조건으로 결과가 뒤집히는 경계부터 찾는 편이 낫다.
TLB 프리페치는 미래를 맞히는 작은 장치처럼 보이지만, 실제로는 메모리의 일을 언제·어디서 수행할지 재배치하는 설계다. 좋은 예측은 유용한 변환을 제때 공급하고, 그 과정에서 더 중요한 요청을 방해하지 않으며, 주소가 바뀐 뒤에는 과거의 답을 버린다. 채택 판단을 바꿔야 할 숫자는 줄어든 미스 수 하나가 아니라 동일 작업의 대기시간, 전체 거래와 올바른 변환의 수명이다.
Sources
- Trail, arXiv v1: metadata and submission time; public design text. Preprint; no conference acceptance claim is made here.
- Agile TLB Prefetching, ISCA 2021, author-hosted paper. Background and mechanism, not a matched performance baseline.
- Linux 6.17: Transparent Hugepage Support.
- RISC-V Supervisor ISA 1.13, specification snapshot v20260120.
- Linux: Cache and TLB Flushing.
- Linux v6.17: MIPS CPU capability probing.
- ZeptoBars: Baikal-T1 die photograph, publisher reuse terms, CC BY 3.0.
Disclosure
본문의 거래 수와 가상 TLB 용량 계산, 도식은 VLSI Korea의 설명용 구성이다. 실제 칩 측정이나 논문 재현 결과가 아니다. Trail은 공개 프리프린트의 설계를 읽은 범위에서 다뤘으며 상용 채택을 확인한 것은 아니다. 대표 사진은 과거 Baikal-T1의 실제 다이 사진으로, 원본을 수정하지 않았고 해당 연구의 실험 장치로 표시하지 않는다. 원고와 번역·설명 도식의 준비에 AI를 사용했다.


