 VLSI Korea
웨이퍼 검사 샘플링: 불량을 놓칠 확률과 차단 지연을 따로 계산하자
유한 lot, 공간 군집, 검출 sensitivity와 feedback 지연을 분리해 웨이퍼 검사 샘플 수와 위치, 노출량을 계산합니다.


웨이퍼 검사에서 샘플을 더 뽑았다는 사실과 불량을 덜 놓쳤다는 결론 사이에는 계산이 필요합니다. 가령 25장 중 2장이 영향을 받은 lot에서 3장을 무작위로 검사하면, 둘 다 놓칠 확률은 77%입니다. 이 숫자는 실제 fab의 실적이 아니라, 완벽한 검출을 가정한 유한 모집단 계산입니다.
VLSI Korea view: 샘플링 계획을 승인할 때는 검사율 하나 대신 모집단, 공간적 선택, 검출 성능, 차단 지연을 각각 확인해야 합니다.
여기서 말하는 wafer inspection sampling은 lot, wafer, die 또는 검사 영역 중 일부를 정해 관측하는 선택 규칙입니다. 검사 장비가 이미 본 이미지를 분류하는 일과도, 최종 출하품의 defect level을 보증하는 일과도 범위가 다릅니다.
1. 검사율에 분모를 다시 붙이자
공정 엔지니어가 풀 일은 두 가지입니다. 주어진 inspection capacity로 어떤 excursion을 발견할지 정하고, 발견 뒤 어느 장비에서 언제 생산을 멈출지 정해야 합니다. 이 글은 샘플 수와 위치를 고르는 결정, 검사 확대와 feedback 단축 중 어디에 자원을 쓸지 고르는 결정을 돕습니다.
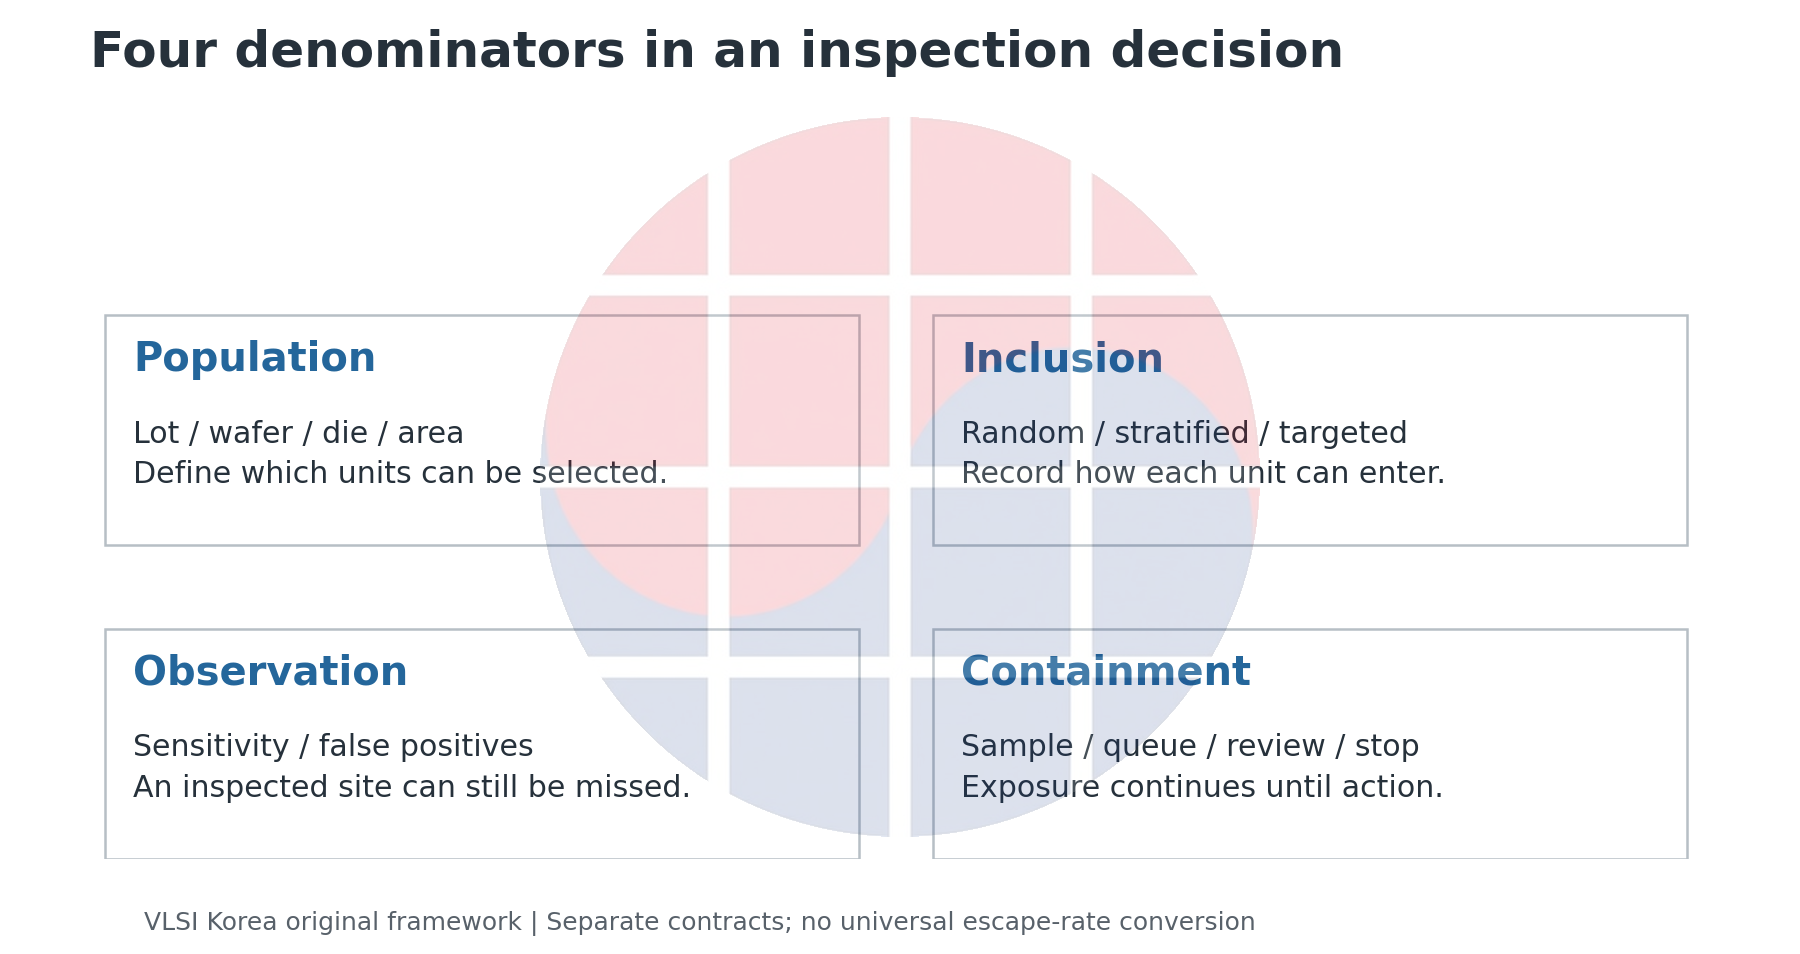
먼저 샘플의 단위를 고정합시다. lot을 고르는 비율, 선택한 lot 안에서 wafer를 고르는 비율, wafer 위에서 관측하는 면적은 서로 다른 분모를 가집니다. 앞단에서 제외된 wafer의 결함은 뒷단의 이미지 분류기가 정확해져도 직접 관측되지 않습니다.
이 글에서는 이 구분을 모집단·선택·관측·차단 프레임워크로 부릅니다. 순서는 간단합니다. 검사할 수 있는 전체 집합을 정하고, 표본이 들어오는 규칙을 기록한 다음, 들어온 불량을 실제로 검출할 조건과 생산 차단까지의 시간을 붙입니다.
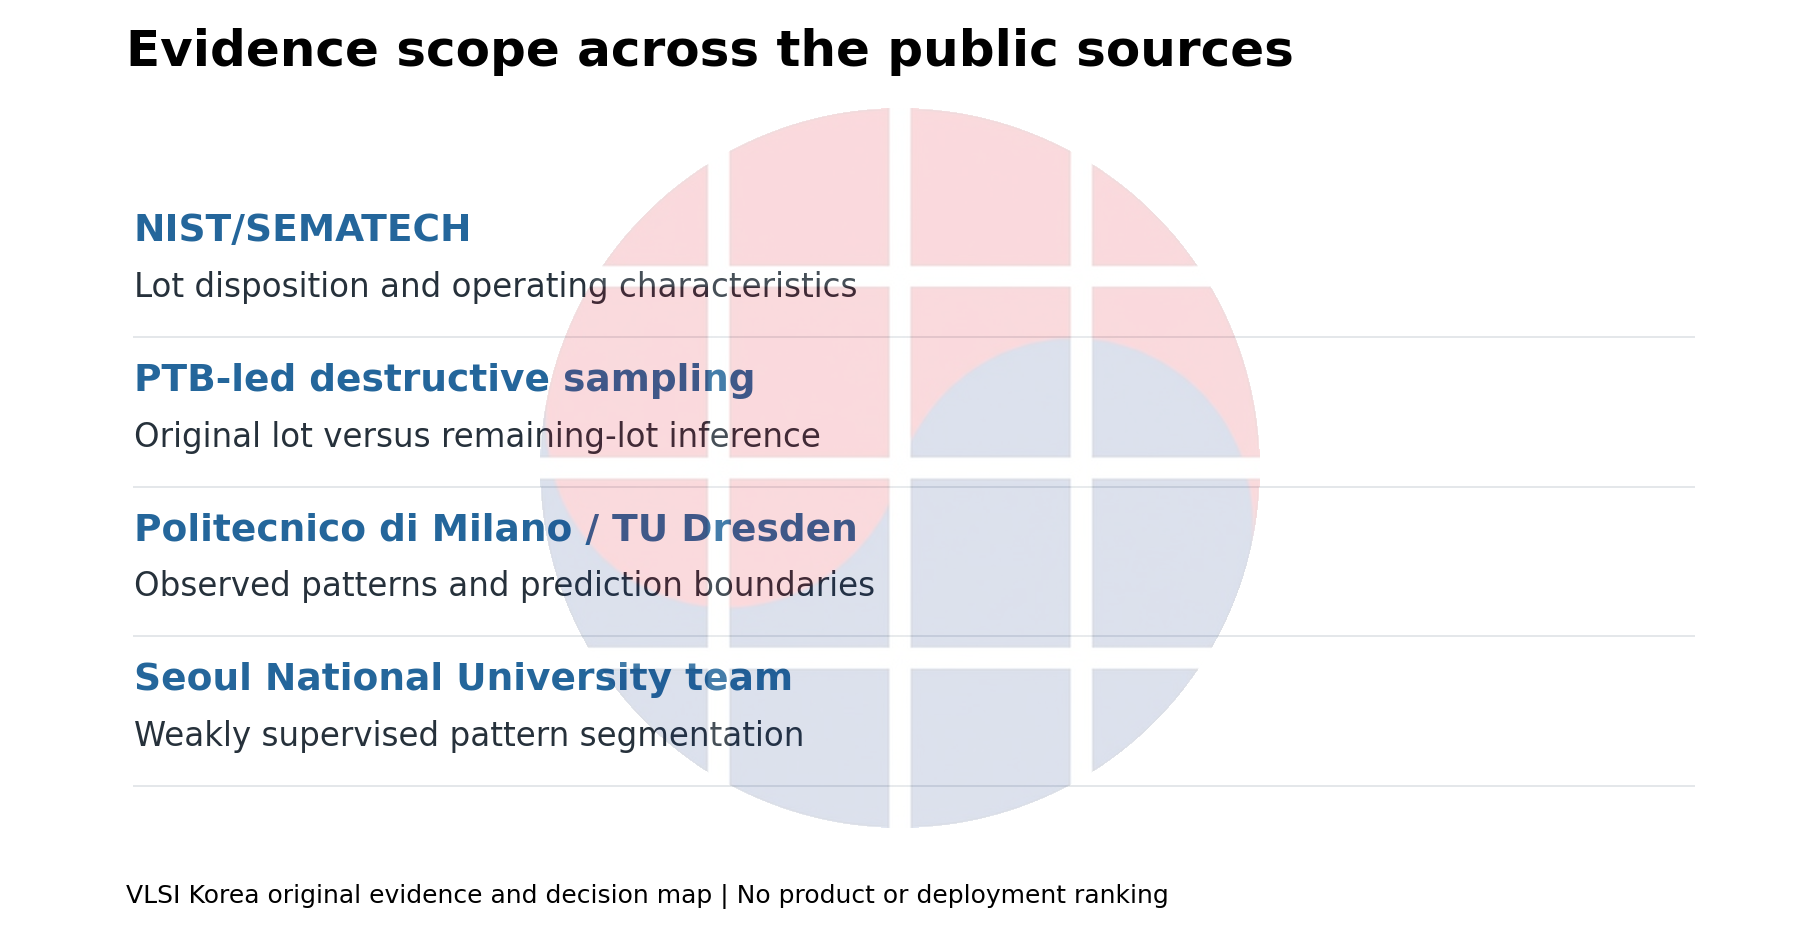
NIST/SEMATECH의 acceptance sampling 설명은 lot의 수락 여부를 정하는 목적과 lot 품질을 추정하는 목적을 구분합니다. 따라서 ‘sample pass’라는 판정만 받아서는 어떤 모집단에 대해 어떤 위험을 제한했는지 알 수 없습니다.
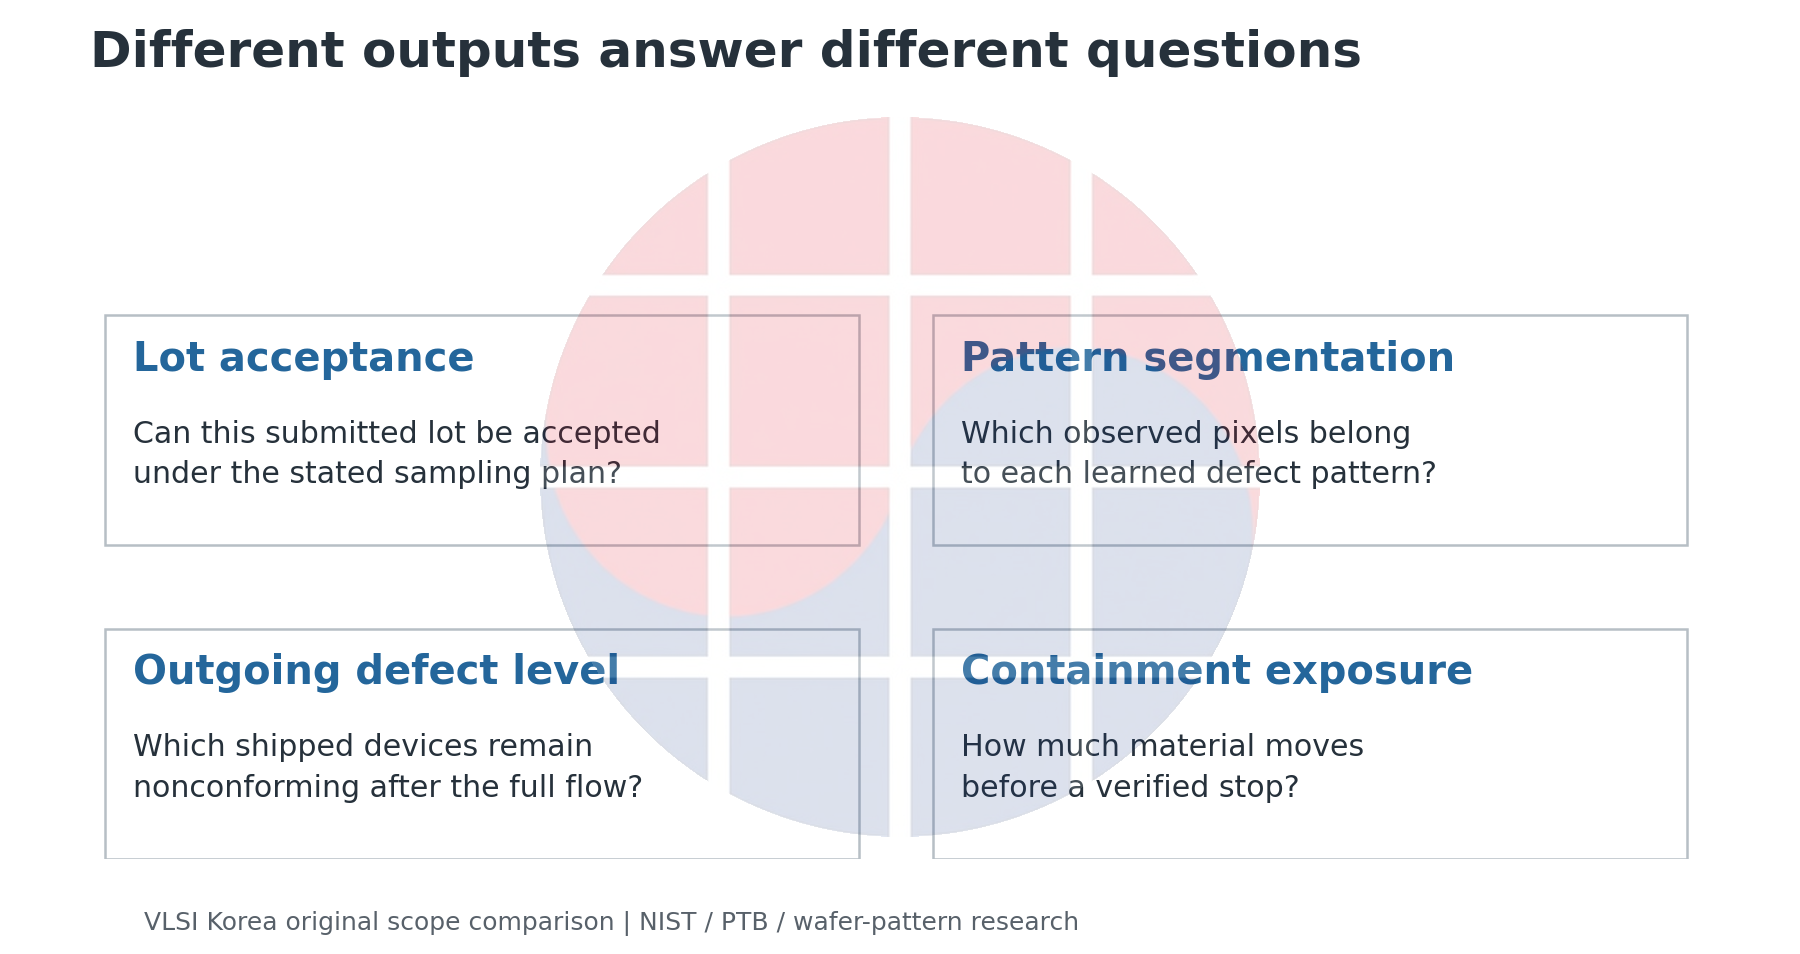
최종 test의 fault coverage와 출하 후 defect level이 궁금하다면 기존 yield·binning·defect level 분석이 먼저입니다. 이번 글의 확률은 그 defect level로 바로 환산하지 않습니다. 전기적으로 불량인 die와 공정 이상을 알리는 particle은 같은 사건이 아닙니다.
왜 지금 이 구분이 필요할까요. 2026-08-31 공개된 SePArate 연구는 이미지 단위 label에서 pixel 단위 defect pattern을 분리하는 방법을 제시합니다. 이미 관측한 데이터의 해석이 정교해질수록, 관측하지 않은 공간과 시간까지 검증했다는 착각을 경계해야 합니다. 이것은 해당 논문의 성능 주장이 아니라 VLSI Korea의 운영상 해석입니다.
2. 25장 중 3장 검사는 무엇을 놓치나
계산의 모집단을 N=25장, 그중 영향을 받은 wafer를 K=2장으로 고정합니다. n장을 복원 없이 균등하게 선택하고, 선택된 affected wafer는 반드시 검출한다고 가정합니다. ‘놓친다’는 사건은 표본에 affected wafer가 하나도 들어오지 않는 경우입니다.
가능한 전체 선택은 C(N,n), 모두 정상인 선택은 C(N−K,n)개입니다. 따라서 P(miss)=C(N−K,n)/C(N,n)입니다. C는 조합의 수이며, 정상 wafer 수보다 표본이 크면 분자는 0입니다. 실제 lot에 K가 알려져 있다는 뜻은 아닙니다. 가정한 excursion에 계획이 얼마나 취약한지를 계산하는 방식입니다.
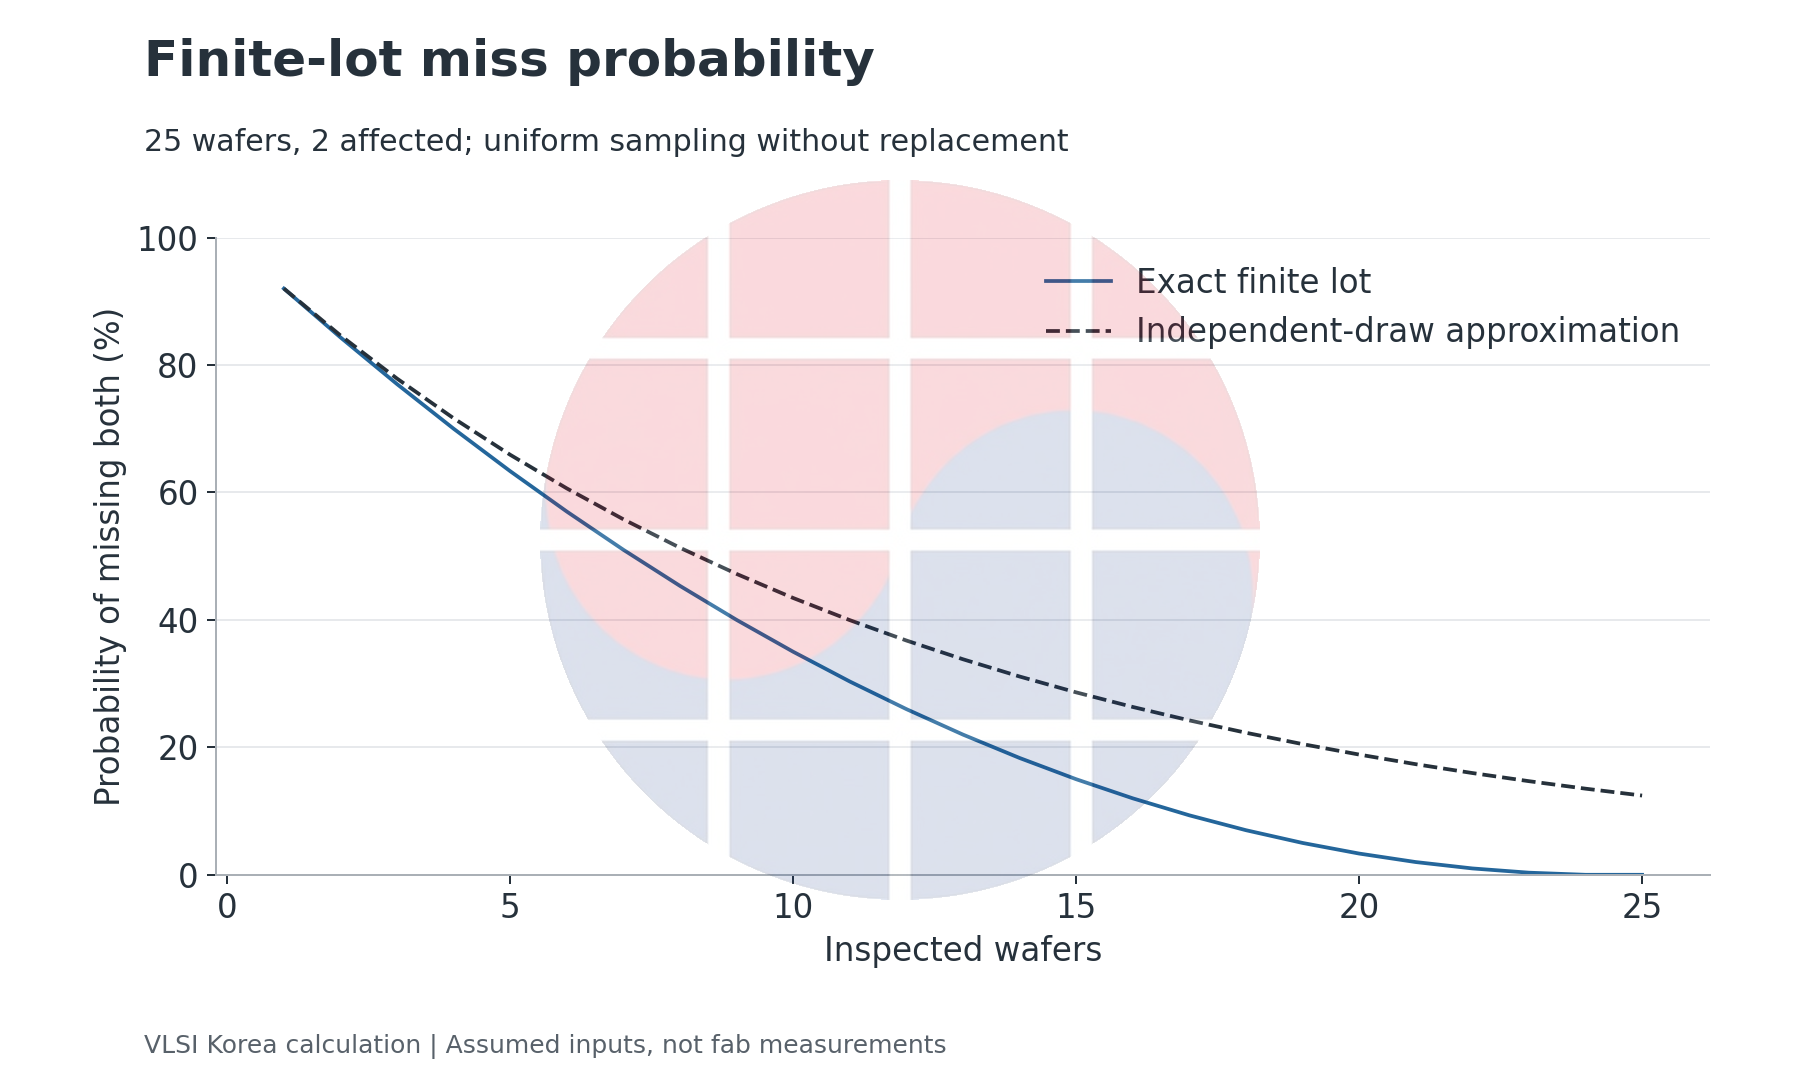
n=3이면 77%, n=5이면 63.33%, n=10이면 35%입니다. 샘플을 늘리면 이 가정 아래의 miss는 줄지만, 작은 표본이 충분하다는 결론은 나오지 않습니다. 검사 계획에 필요한 것은 ‘몇 장 보았다’는 보고보다 ‘어떤 규모의 excursion을 어느 확률까지 놓쳐도 되는가’라는 요구사항입니다.
모집단이 매우 클 때 사용하는 독립 추출 근사 (1−K/N)^n과도 차이가 납니다. 유한 lot에서 정상 wafer를 하나 뽑으면 남아 있는 정상 wafer가 줄어듭니다. 표본 비중이 커질수록 같은 성공 확률을 계속 곱하는 근사의 오차를 무시하기 어렵습니다.
NIST의 OC curve는 n뿐 아니라 허용 불량 수 c에 따라 lot 수락 확률이 달라짐을 보여줍니다. 여기의 any-detection 계산은 c=0인 단순 조건입니다. 불량을 발견해도 수락하는 계획으로 바꾸면 같은 식을 그대로 적용하면 안 됩니다.
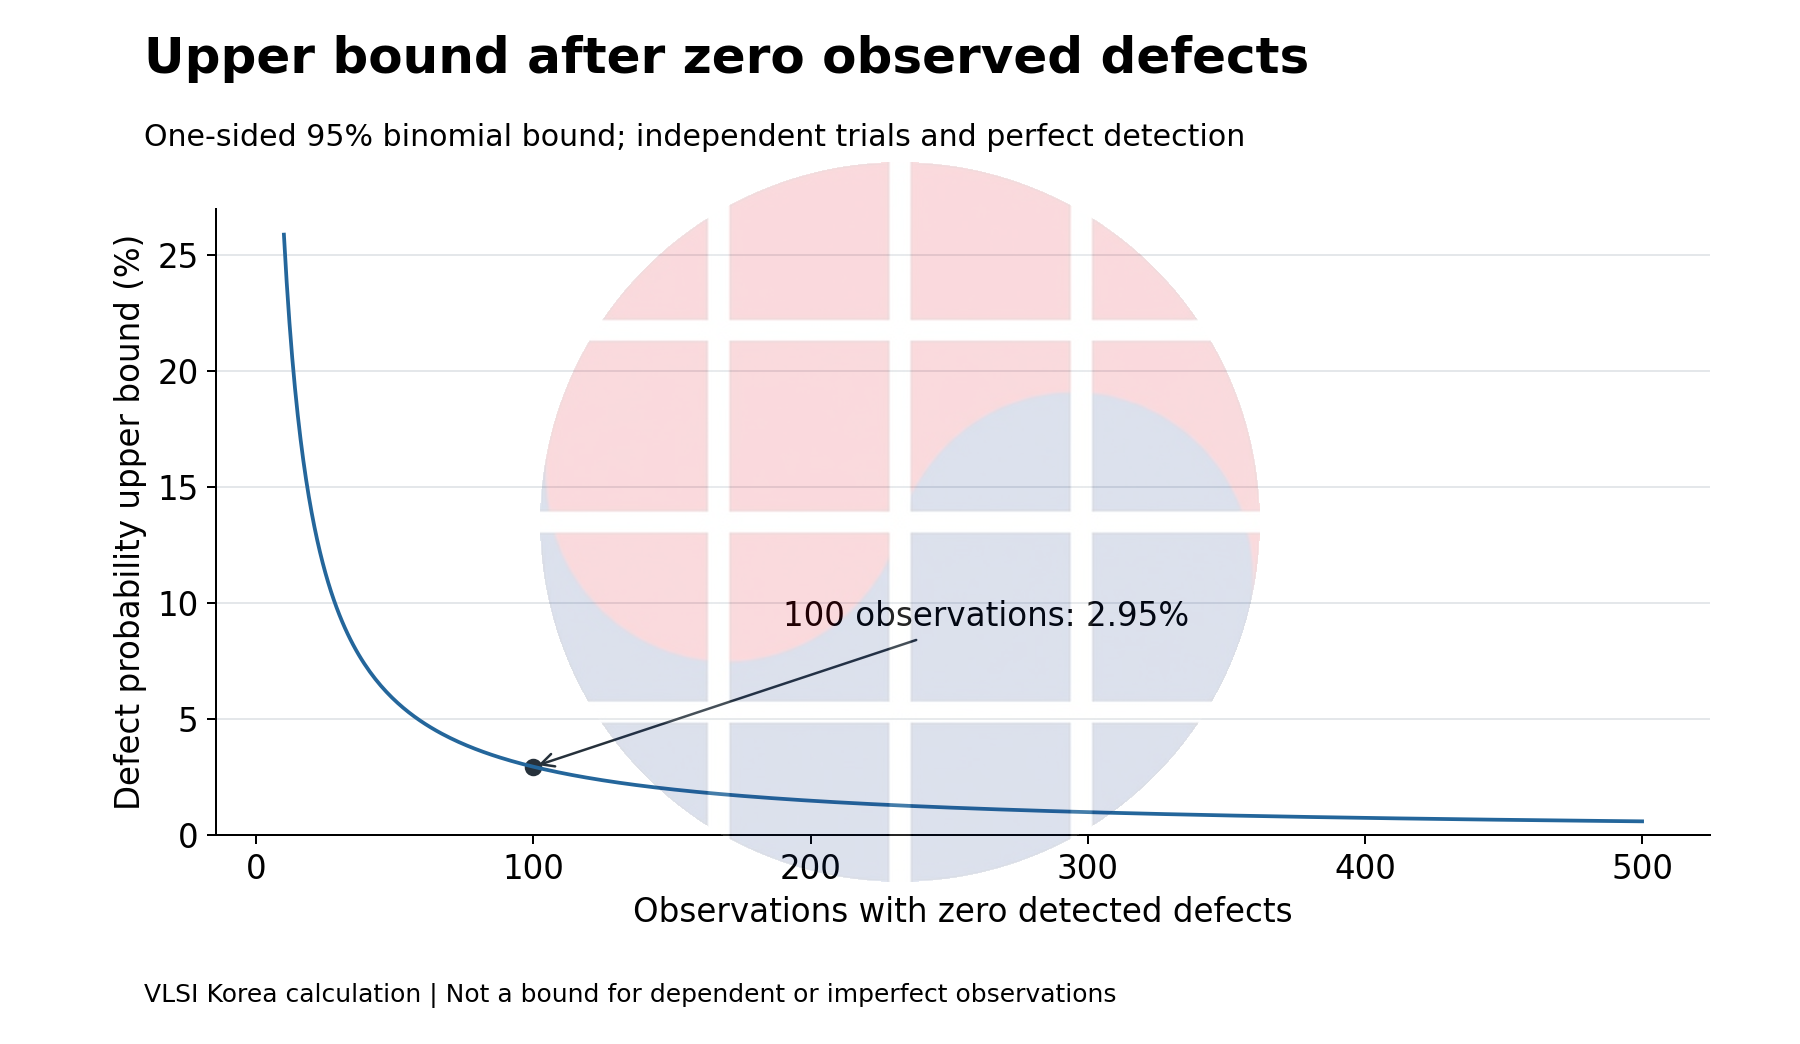
검사 결과가 모두 깨끗했다는 사실도 별개입니다. 독립 Bernoulli 표본과 완벽한 검출을 가정하면, 100개에서 검출이 0일 때 단측 95% 상한은 1−0.05^(1/100), 약 2.95%입니다. 관측 불량이 0이라는 말은 모집단 불량률이 0이라는 뜻이 아닙니다. 이 상한 역시 상관된 공간 표본에 그대로 붙이지 않습니다.
3. 샘플에 들어왔어도 검출되지 않을 수 있다
이번에는 유한 lot 예제와 다른 모델을 씁니다. 각 site가 독립적으로 불량일 확률을 p=0.01, 불량 site를 관측했을 때 검출할 sensitivity를 s=0.8로 둡니다. 정상 site의 false positive는 없고, 한 번이라도 검출하면 경보를 낸다고 가정합니다.
site 하나에서 검출이 일어날 확률은 ps, n개에서 검출이 전혀 없을 확률은 (1−ps)^n입니다. 이것은 정해진 p를 가진 독립 모집단에서의 무조건부 zero-detection 확률입니다. 나쁜 lot이 수락될 조건부 확률이나, pass를 본 뒤 그 lot이 좋을 확률을 뜻하지 않습니다.
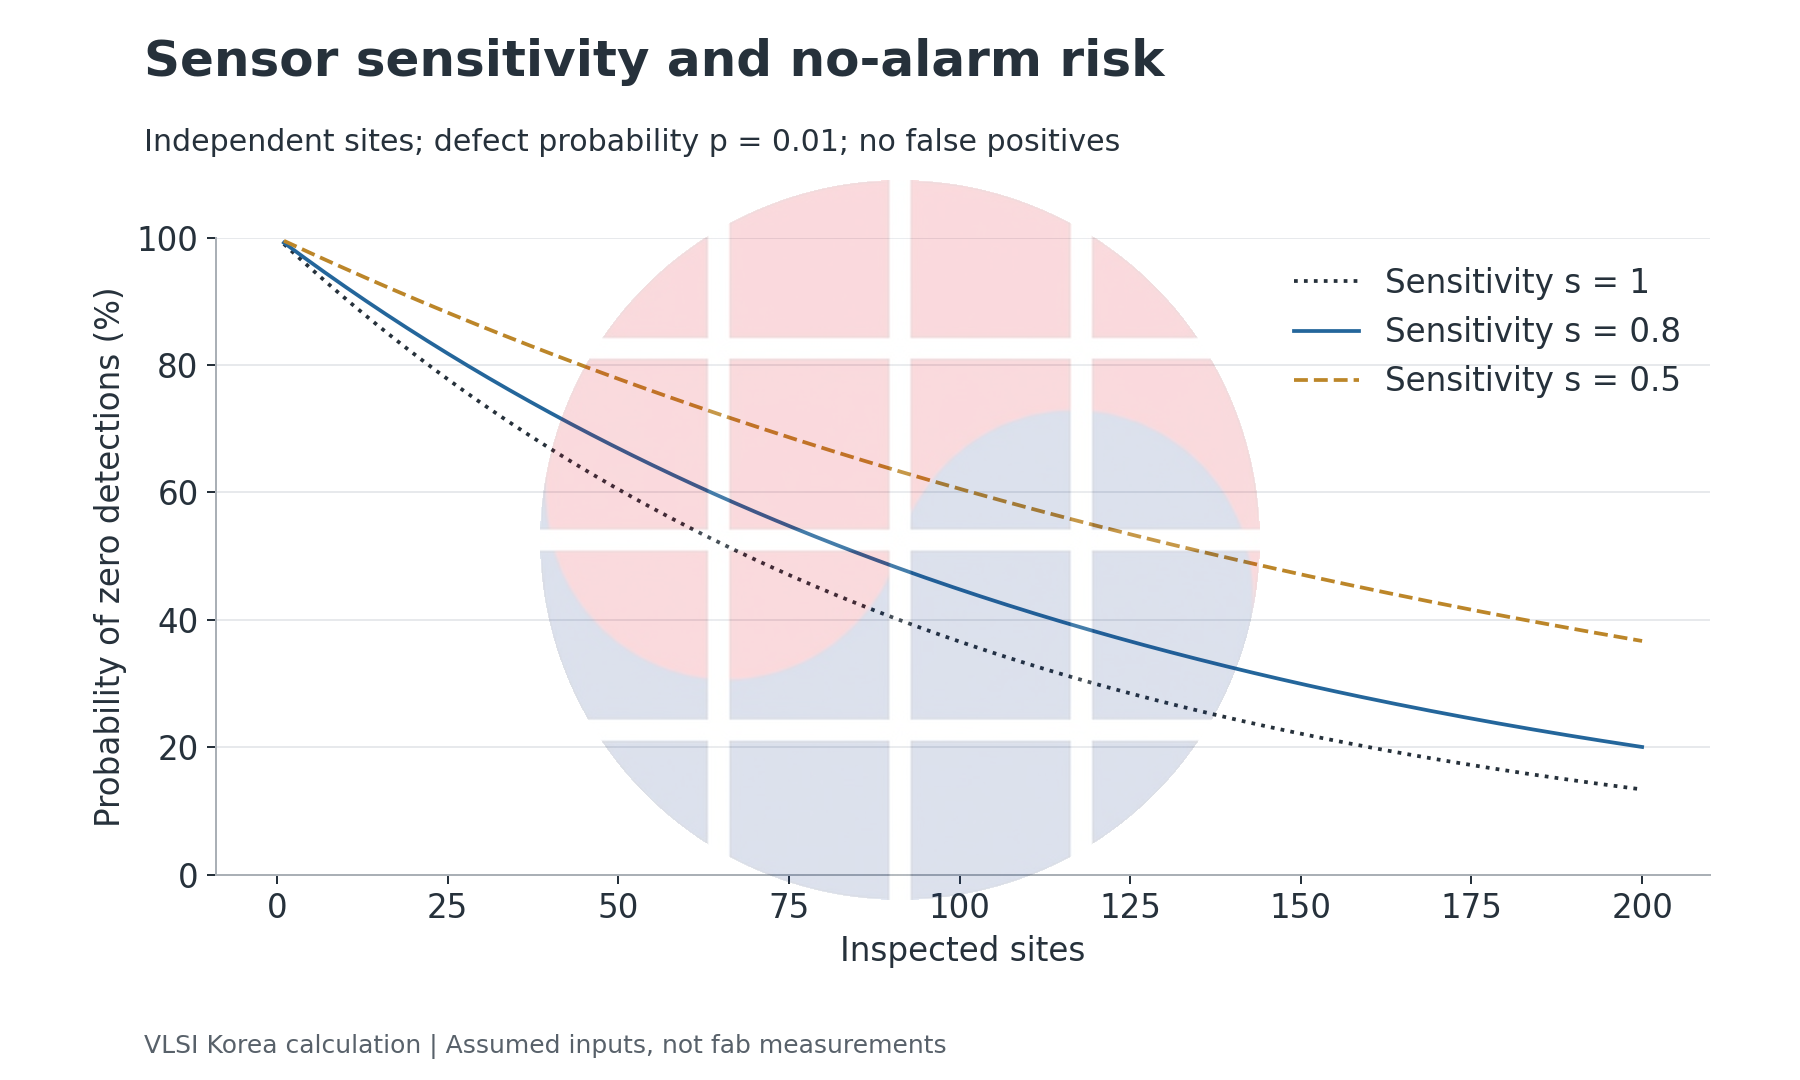
이 모델에서 n=50, 100, 200의 zero-detection 확률은 각각 66.92%, 44.79%, 20.06%입니다. 이를 5% 이하로 낮추려면 적어도 373개가 필요합니다. 하지만 이 수를 실제 검사 recipe에 바로 넣으면 안 됩니다. p와 s의 정의, 공간 독립성, 동일 조건 반복 가능성을 먼저 측정해야 합니다.
s는 회사 brochure의 정확도 한 줄로 대체할 수 없습니다. 검출 대상으로 정한 defect class와 크기, 관측 조건, threshold가 달라지면 따로 확인해야 하는 값입니다. 관측되지 않은 결함의 ground truth를 확보하지 못했다면 sensitivity는 미확인입니다. 표본에서 발견한 것만으로 놓친 것의 수까지 알 수는 없습니다.
반대편 비용도 있습니다. 정상 site 하나의 false-positive 확률을 q=0.001로 가정하고, 모든 site가 정상이며 서로 독립이라면 적어도 한 번 잘못 경보를 낼 확률은 1−(1−q)^n입니다. n=50, 100, 200에서 각각 4.88%, 9.52%, 18.14%가 됩니다.
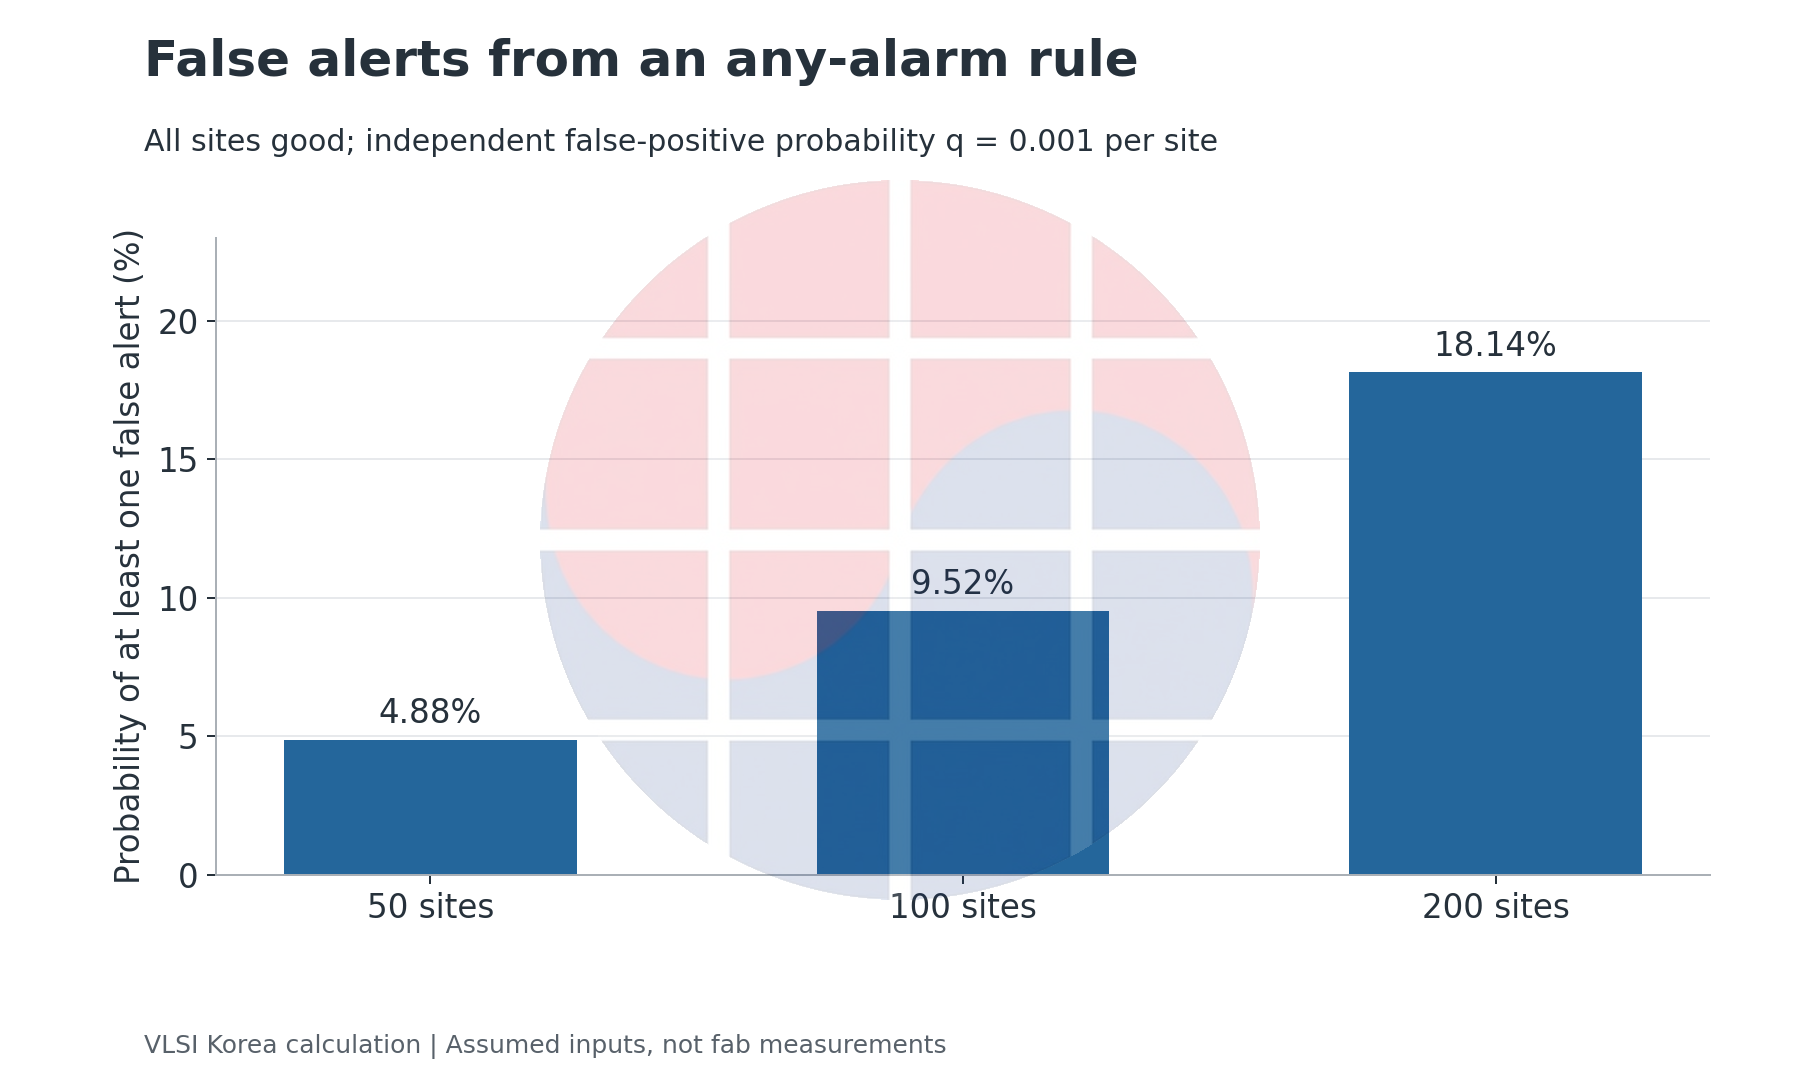
이는 sample 확대가 나쁘다는 뜻이 아닙니다. any-alarm 정책에서 표본을 늘릴 때 review capacity와 재확인 규칙도 같이 설계해야 한다는 뜻입니다. 불필요한 hold가 검사 대기열을 늘리면, 진짜 excursion을 확인하는 시간까지 늦어질 수 있습니다. 이 연결은 뒤에서 별도의 시간 모델로 계산합니다.
TU Dresden의 distribution-analysis 연구도 불량 검출과 정상 chip의 잘못된 배제를 나누고, front-end 관측으로 back-end 상태를 예측하는 문제를 별도로 다룹니다. 그 연구의 결과를 특정 fab의 s나 q로 가져오지 않습니다. 서로 다른 label과 공정 시점 사이에 성능을 옮기려면 별도 검증이 필요합니다.
4. 같은 10개라도 어디를 고르느냐가 다르다
공간적 군집을 보기 위해 실제 wafer 모양 대신 10×10 격자를 만들었습니다. 전체 100개 cell 중 한 행의 10개가 모두 affected 상태이고, 검출은 완벽하다고 둡니다. 모든 전략의 샘플 수는 10개입니다. 물리적인 wafer defect map을 재현한 그림은 아닙니다.
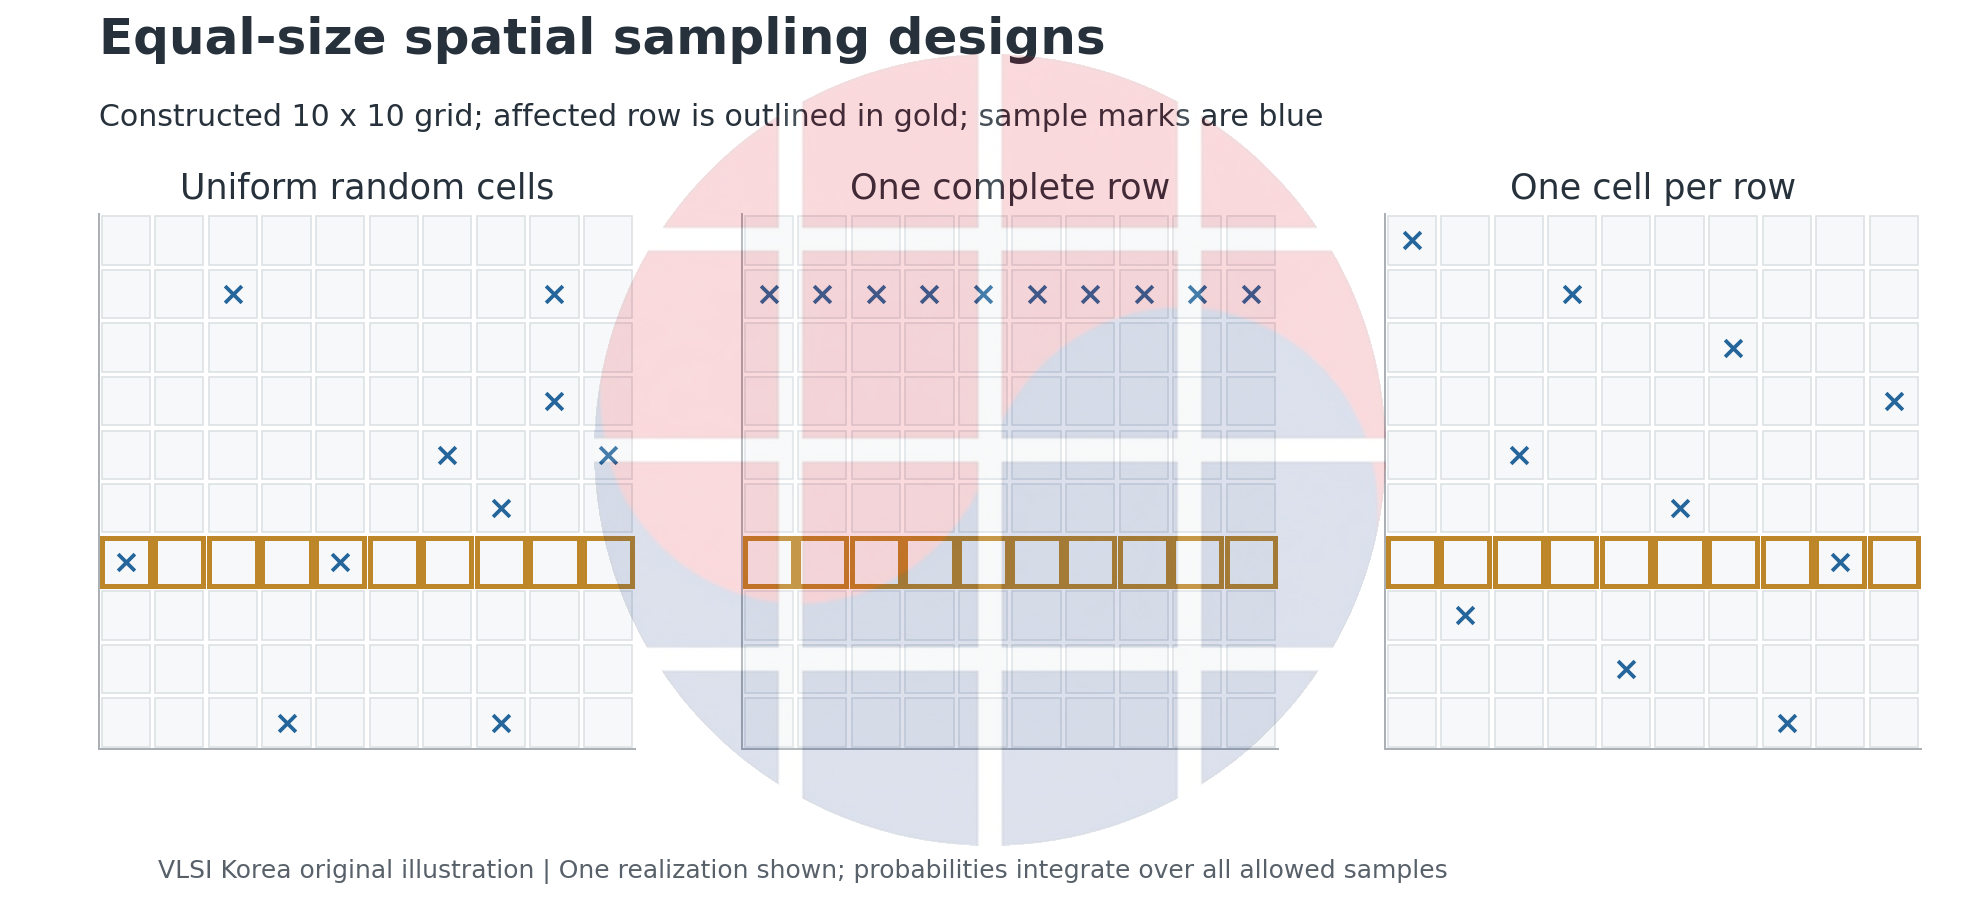
전체에서 10개 cell을 균등하게 복원 없이 고르면 miss 확률은 C(90,10)/C(100,10), 약 33.05%입니다. 반면 한 행을 무작위로 골라 그 행 전체를 보면, affected 행을 피할 확률인 90%가 됩니다. 각 행에서 cell 하나를 균등 무작위로 선택하고 행 사이의 선택을 독립적으로 수행하면 이 특정 예제의 miss는 0%입니다.
세 전략에서 개별 cell이 선택될 주변 확률은 모두 0.1입니다. 차이는 어떤 cell들이 함께 선택되는가에 있습니다. 한 행을 통째로 읽는 방식은 같은 국소 환경에 관측을 몰아주고, 행별 선택은 그 의존성을 끊습니다. 검사율이 같다는 이유만으로 정보량이 같다고 보면 안 되는 이유입니다.
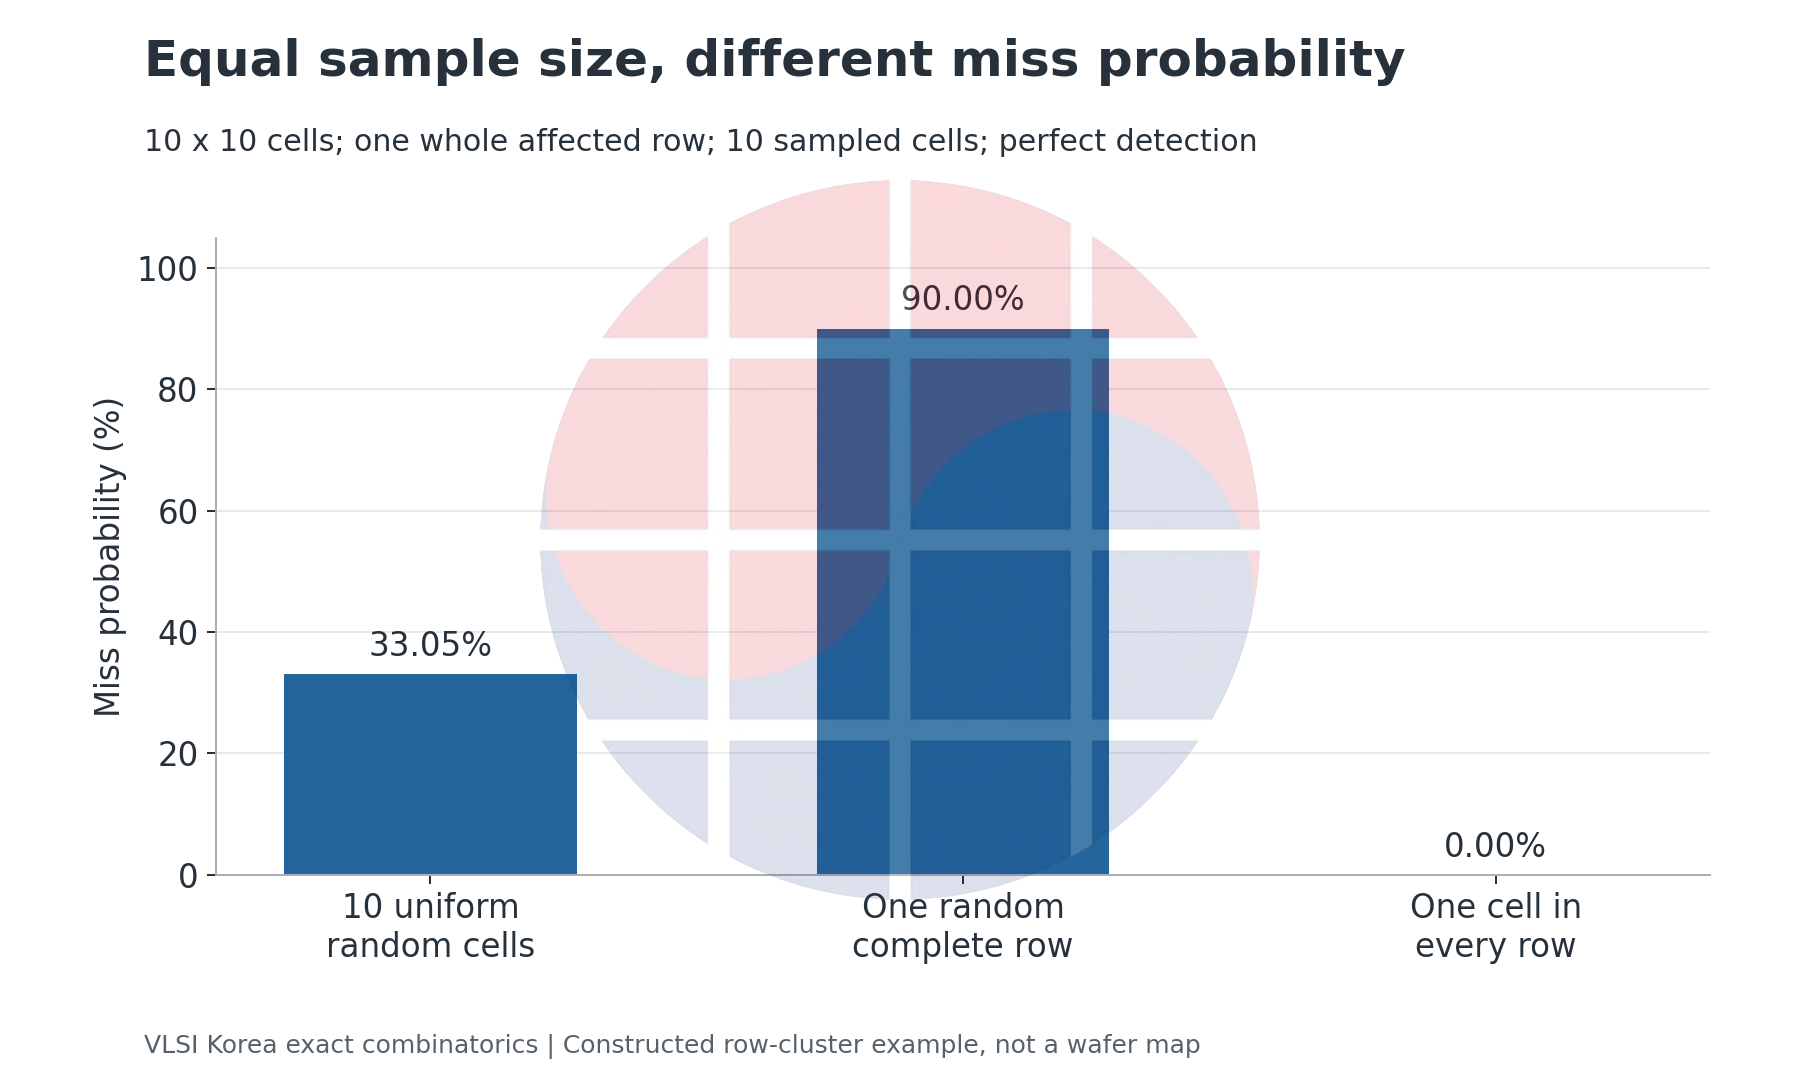
그렇다고 stratified sampling이 언제나 정답은 아닙니다. 0%는 ‘한 행 전체가 불량’이라는 강한 조건과 완벽한 검출에서만 나옵니다. 작은 국소 cluster, 비스듬한 scratch, 선택 지점 사이에 놓인 패턴으로 바꾸면 결론이 달라집니다. 실제 geometry를 모른다면 어느 한 toy pattern에만 유리한 설계는 불완전합니다.
실무에서는 wafer 좌표만이 아니라 chamber, lot 순서, wafer slot, 시간 구간을 어떤 층으로 나눌지 정해야 합니다. 층을 너무 많이 만들면 각 층의 샘플은 얇아집니다. 같은 수의 샘플로 어디까지 대표성을 주장할지, 무엇을 포기했는지 문서에 남겨야 합니다.
Politecnico di Milano와 공동 연구진의 open-set wafer monitoring은 관측된 defect 좌표에서 알려진 패턴 분류와 새로운 패턴 탐지를 구분합니다. VLSI Korea의 해석은 이렇습니다. 과거에 배운 패턴을 잘 맞히는 것과 새 excursion을 발견하는 것은 다른 검증 과제입니다. 미래 lot과 새로운 recipe를 분리한 시험이 필요한 이유입니다.
5. 분류기의 좋은 점수를 검사 coverage로 바꾸지 말자
SePArate는 서로 섞인 defect pattern을 pixel mask로 분리합니다. 논문의 MATDefects는 DRAM mat의 bit 단위, MixedWM38은 wafer의 die 단위 데이터입니다. 같은 흑백 pixel이라도 물리적 분모가 다릅니다. 아래 그림은 저자들이 공개한 예시이며, 이 글의 표본 실험 데이터가 아닙니다.
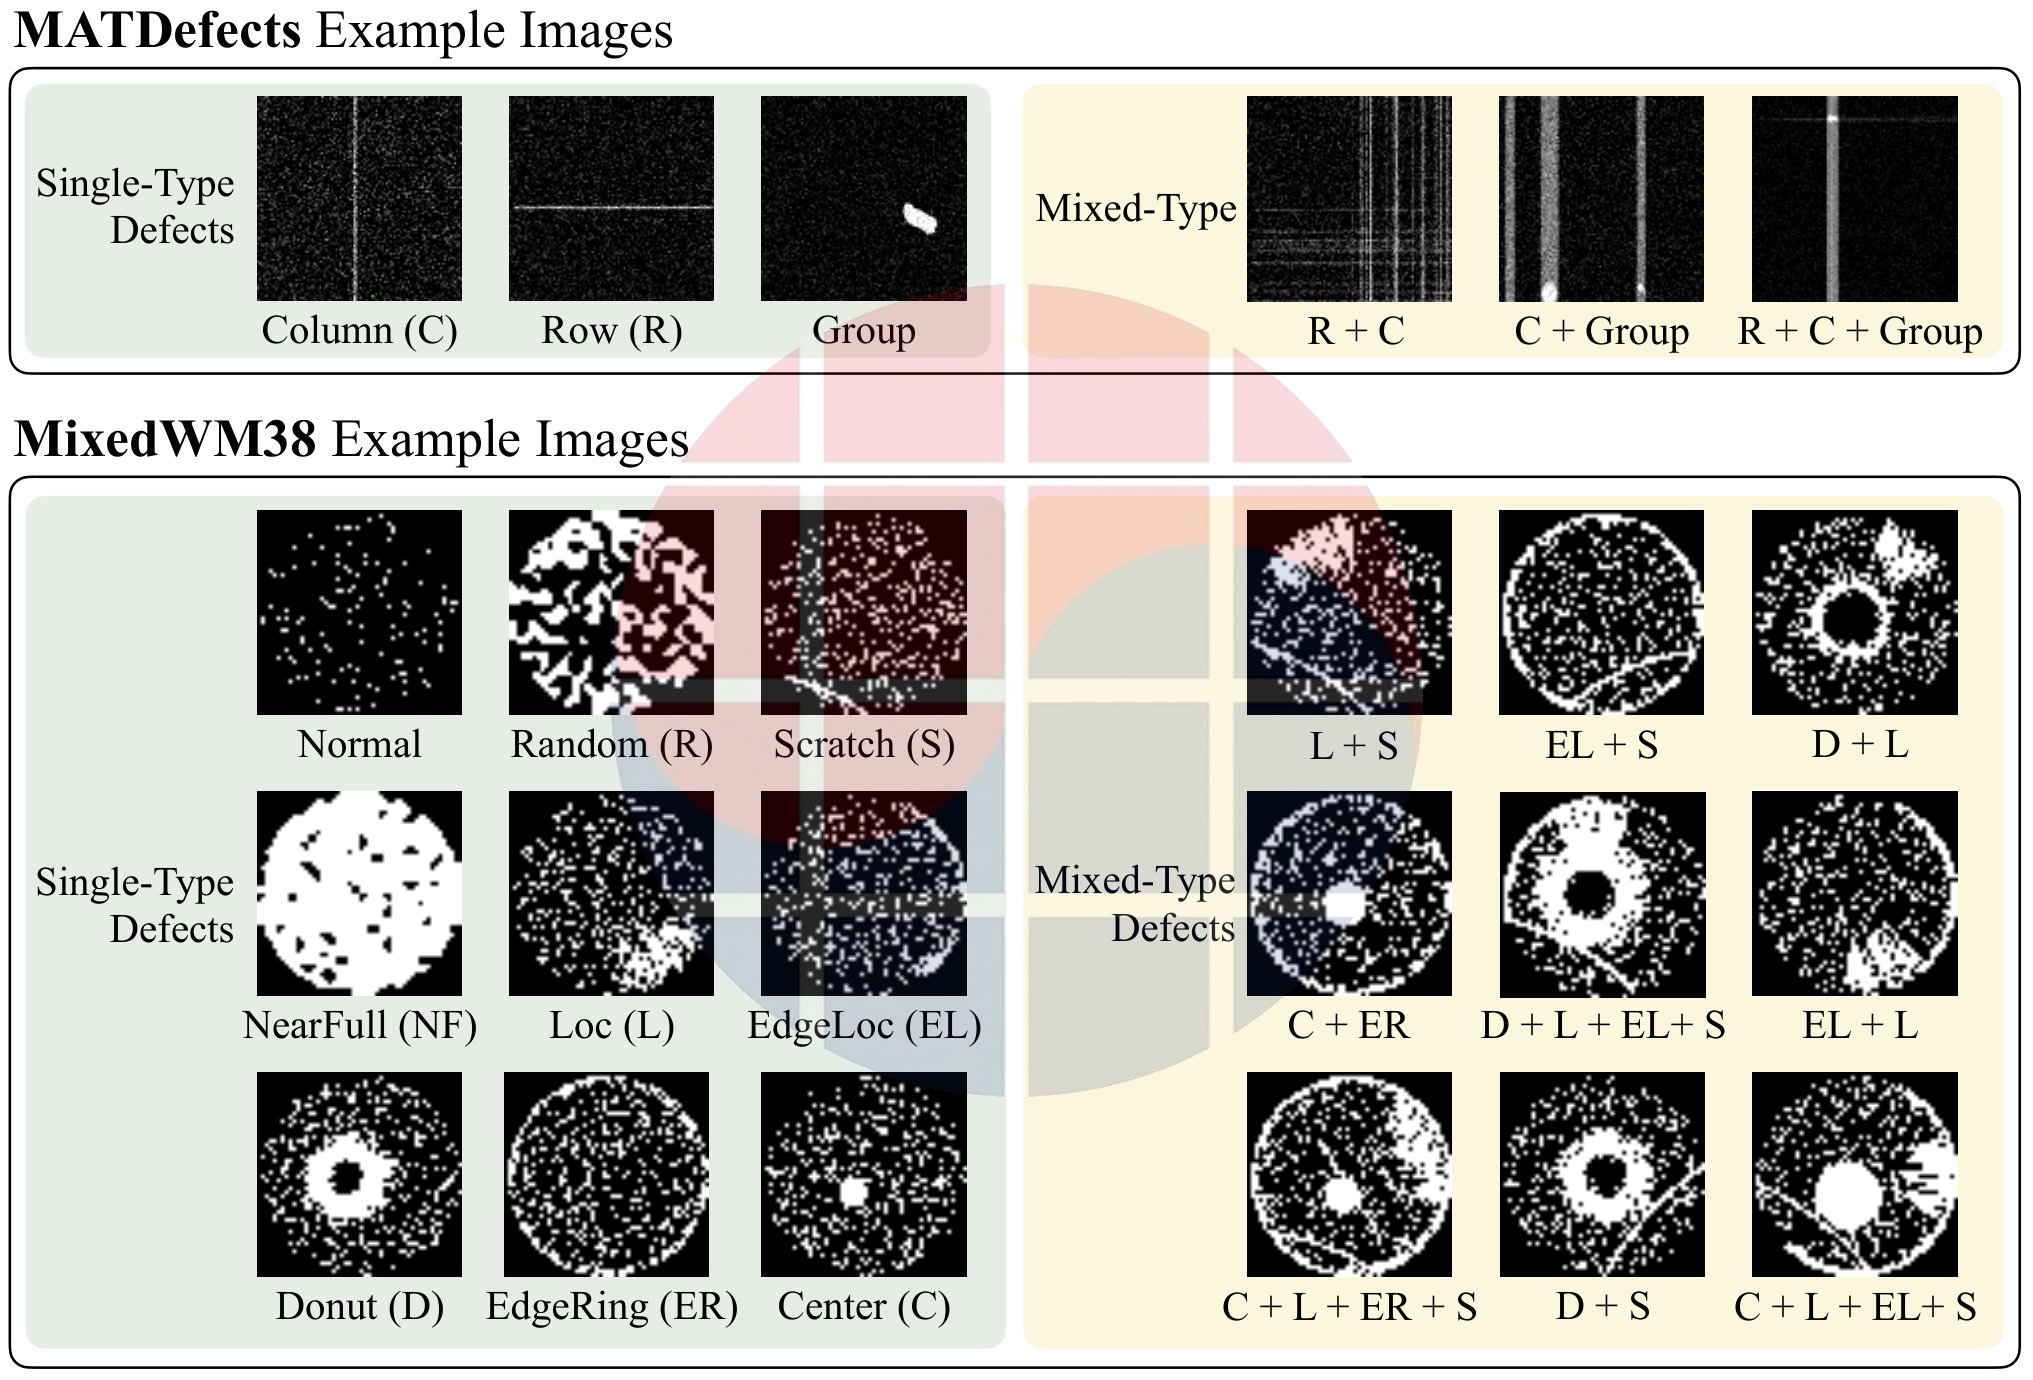
이 차이는 검사 알고리즘을 도입할 때의 acceptance criterion을 바꿉니다. 이미 불량으로 관측된 위치를 여러 패턴으로 나누는 모델이라면, 검증할 것은 mask의 품질과 그 결과로 개선되는 후속 판단입니다. 측정하지 않은 wafer가 정상이라는 근거를 그 점수에서 얻을 수는 없습니다.
SePArate는 encoder 학습, 공간 정보 전달, 합성된 mixed-defect 데이터 학습을 연결합니다. 아래는 저자들의 합성 데이터 생성 도식입니다. 실제 계측 원자료로 오인하지 않아야 합니다. 원문은 공개 논문에서 확인할 수 있습니다.
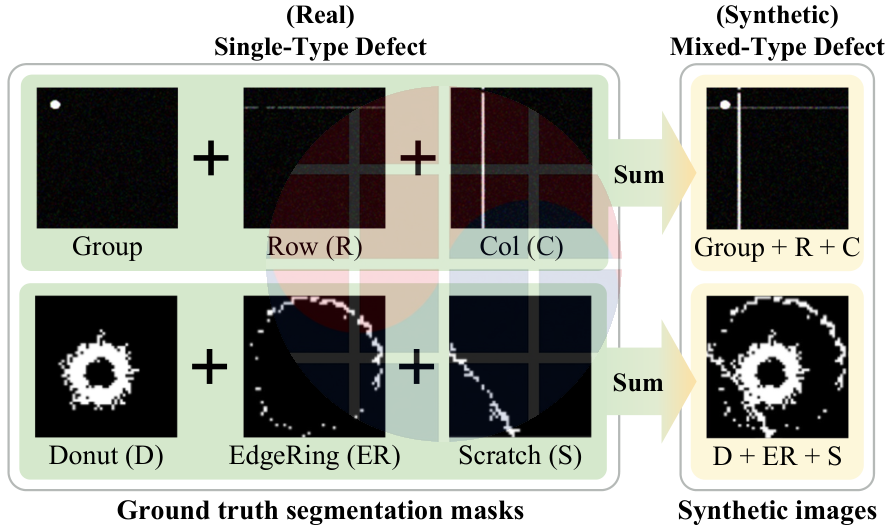
VLSI Korea가 요구하는 현장 시험은 모델의 이름과 관계없이 같습니다. 관측 지점을 고르는 정책을 고정한 채 classifier만 비교하고, 반대로 classifier를 고정한 채 선택 정책만 비교합니다. 둘을 동시에 바꾸면 누가 효과를 냈는지, 어느 변경이 새로운 사각지대를 만들었는지 추적하기 어렵습니다.
학습용 random split의 성능만으로 미래 생산 구간의 성능을 약속하지 않습니다. 시간, 장비, recipe 변화가 분리된 평가를 추가하고, 새 패턴을 사람이 확인할 경로를 남겨야 합니다. 합성 패턴이 실제 excursion의 빈도와 기하를 대표하는지도 독립 질문입니다. 여기서는 논문의 fab 배포나 수율 개선을 주장하지 않습니다.
6. 발견해도 늦으면 노출 wafer가 늘어난다
sample의 선택과 검출이 충분해도 생산 차단이 늦을 수 있습니다. 이 모델에서는 지속되는 excursion이 다음 검사에서 반드시 발견된다고 가정합니다. inspection 간격을 Δ, 검사 시점 이후 결과·review·interlock까지 걸리는 시간을 d, 일정한 생산률을 r로 둡니다.
excursion 시작 시점이 검사 간격 안에서 균등하면 평균 노출량은 r(Δ/2+d), 가장 불리한 시작 시점의 상한은 r(Δ+d)입니다. 시간의 단위는 서로 맞춰야 합니다. 이 식은 검사를 반복해서 놓치는 상황, batch 단위 이동, 재진입 flow와 variable queue를 포함하지 않습니다.
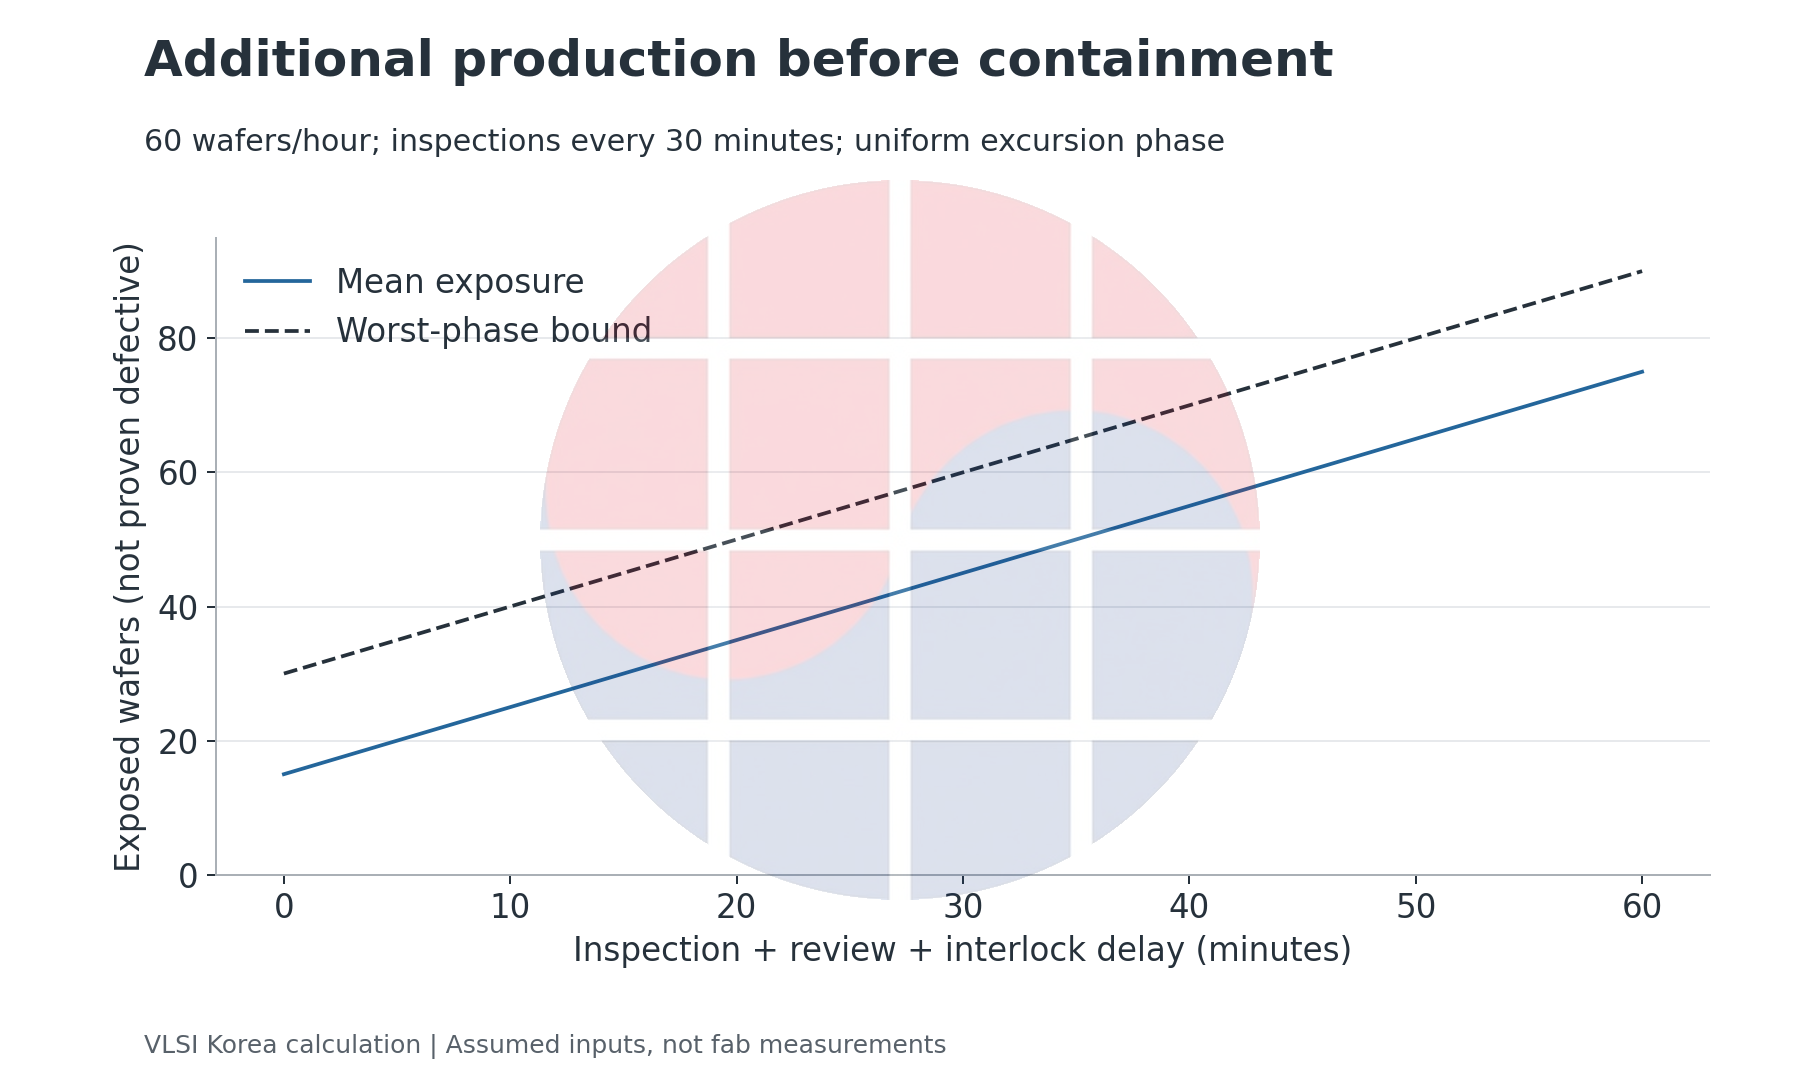
r=60장/시간, Δ=30분으로 두겠습니다. d=5분이면 평균 노출량은 20장, d=45분이면 60장입니다. 같은 검사 간격인데 feedback 지연 차이로 40장이 추가 노출됩니다. 이 wafer가 전부 불량이거나 폐기된다는 뜻은 아닙니다. 추가 확인과 disposition 대상의 크기를 나타냅니다.
wafer당 이미 투입된 가치를 $2,000으로 가정하면, 추가 40장의 gross WIP 노출은 $80,000입니다. 실제 손실액이 아닙니다. 회수 가능성, 결함의 영향, 후공정 비용과 폐기 판단이 없으므로 revenue, margin 또는 free cash flow로 변환하지 않습니다. 수치의 역할은 의사결정에 필요한 추가 입력을 드러내는 것입니다.
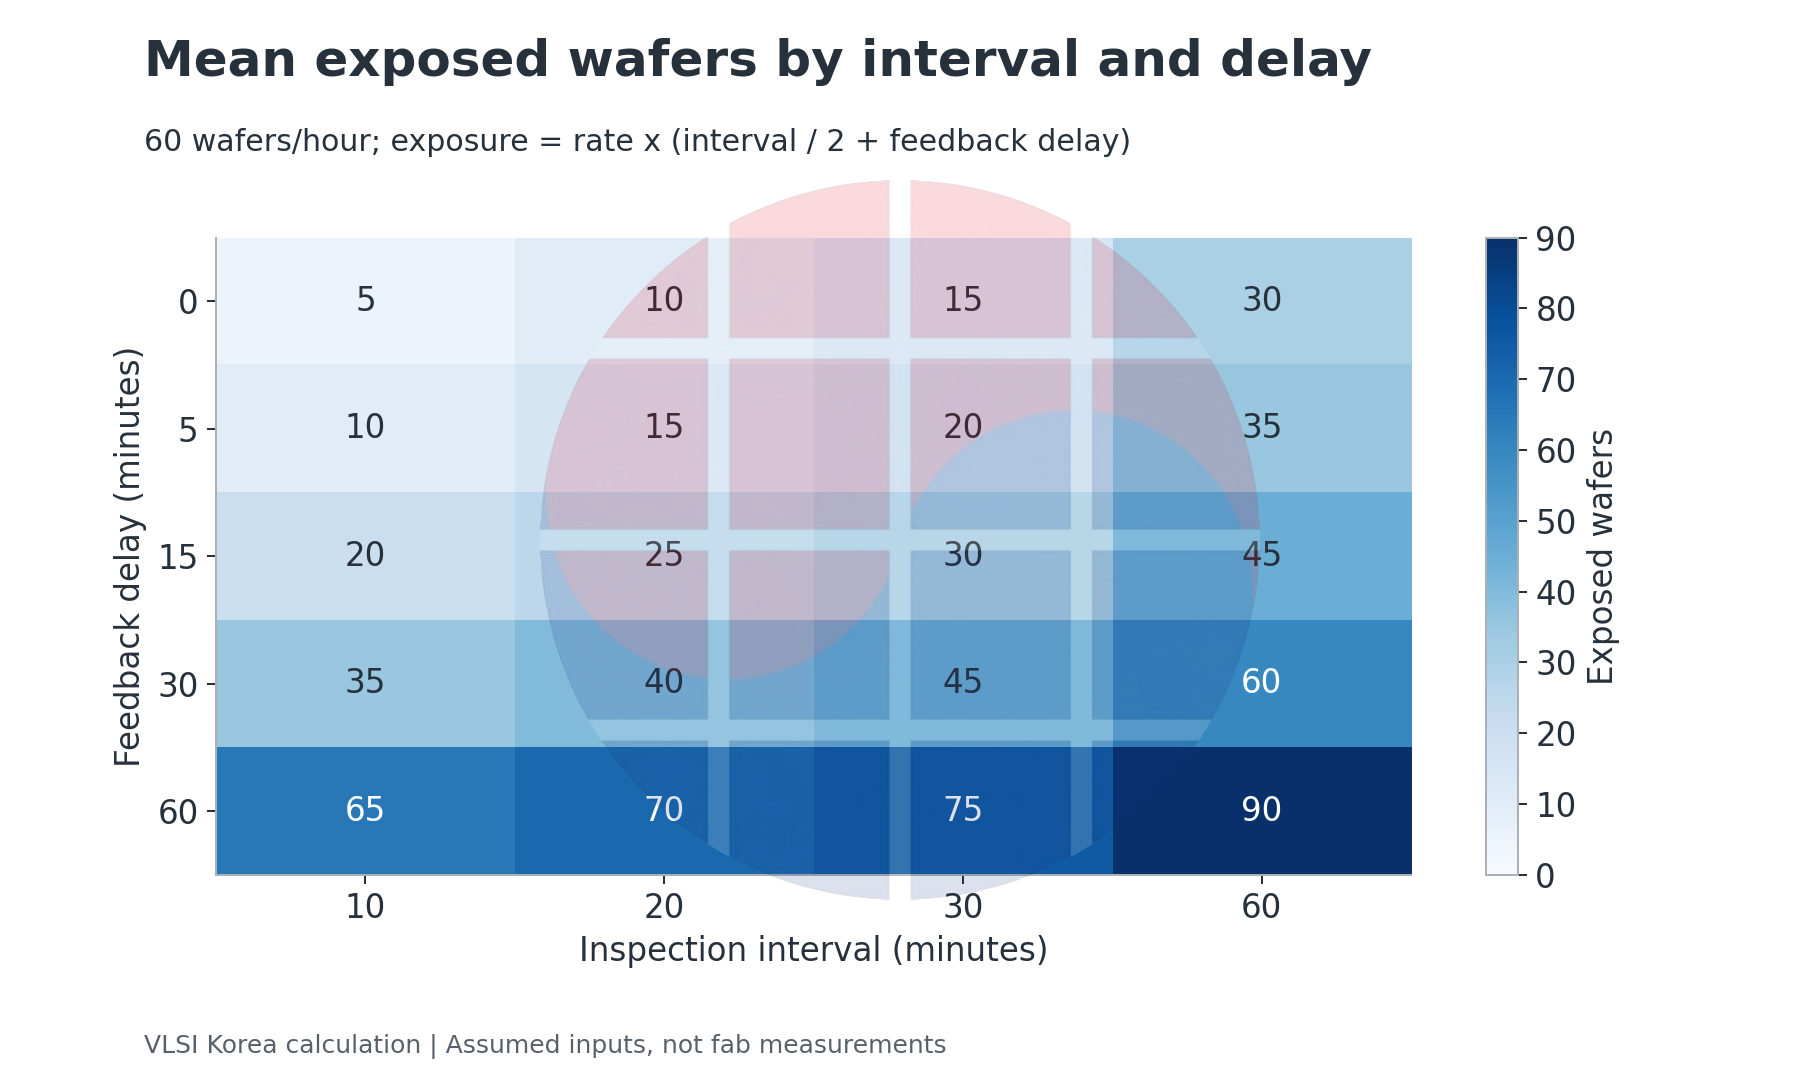
이 조건에서는 d를 줄이는 일이 검사율을 높이는 일만큼 중요할 수 있습니다. 반대로 excursion이 드물고 대부분의 hold가 false alert라면, 검사를 늘린 뒤 생긴 review 병목이 전체 효과를 상쇄할 수 있습니다. 먼저 sample 완료, 경보 생성, 담당자 판정, 해당 chamber의 실제 차단 시각을 같은 시간축에 남겨야 합니다.
평균만 보지 않는 것도 중요합니다. 대기시간이 가끔 길게 늘어난다면 평균 d를 대입한 값은 tail exposure를 설명하지 못합니다. production rate도 일정하지 않을 수 있습니다. 그때는 실제 event timestamp와 lot 이동 이력을 이용해 노출 집합을 다시 구성해야 합니다. 단순 모델이 편리하다는 이유로 복잡한 flow를 지워서는 안 됩니다.
7. 한국 fab의 체크리스트와 반증 조건
국내 공정·수율·검사 담당자가 함께 볼 문서는 검사율 목표표보다 구체적이어야 합니다. 먼저 어떤 공정 이상을 발견할 것인지, affected wafer와 affected die를 어떻게 정의할 것인지 합의합니다. 좌표 기준과 chamber history가 어긋나면 표본이 어디를 대표하는지부터 틀립니다.
다음으로 p와 s를 분리합니다. p는 가정한 불량 발생 모델의 입력이고, s는 불량이 들어왔을 때의 관측 성능입니다. confidence threshold를 바꾸면 false-alert burden도 다시 봐야 합니다. 불량률이 낮아 보인다는 이유로 detector의 미검출까지 낮다고 추론하지 않습니다.
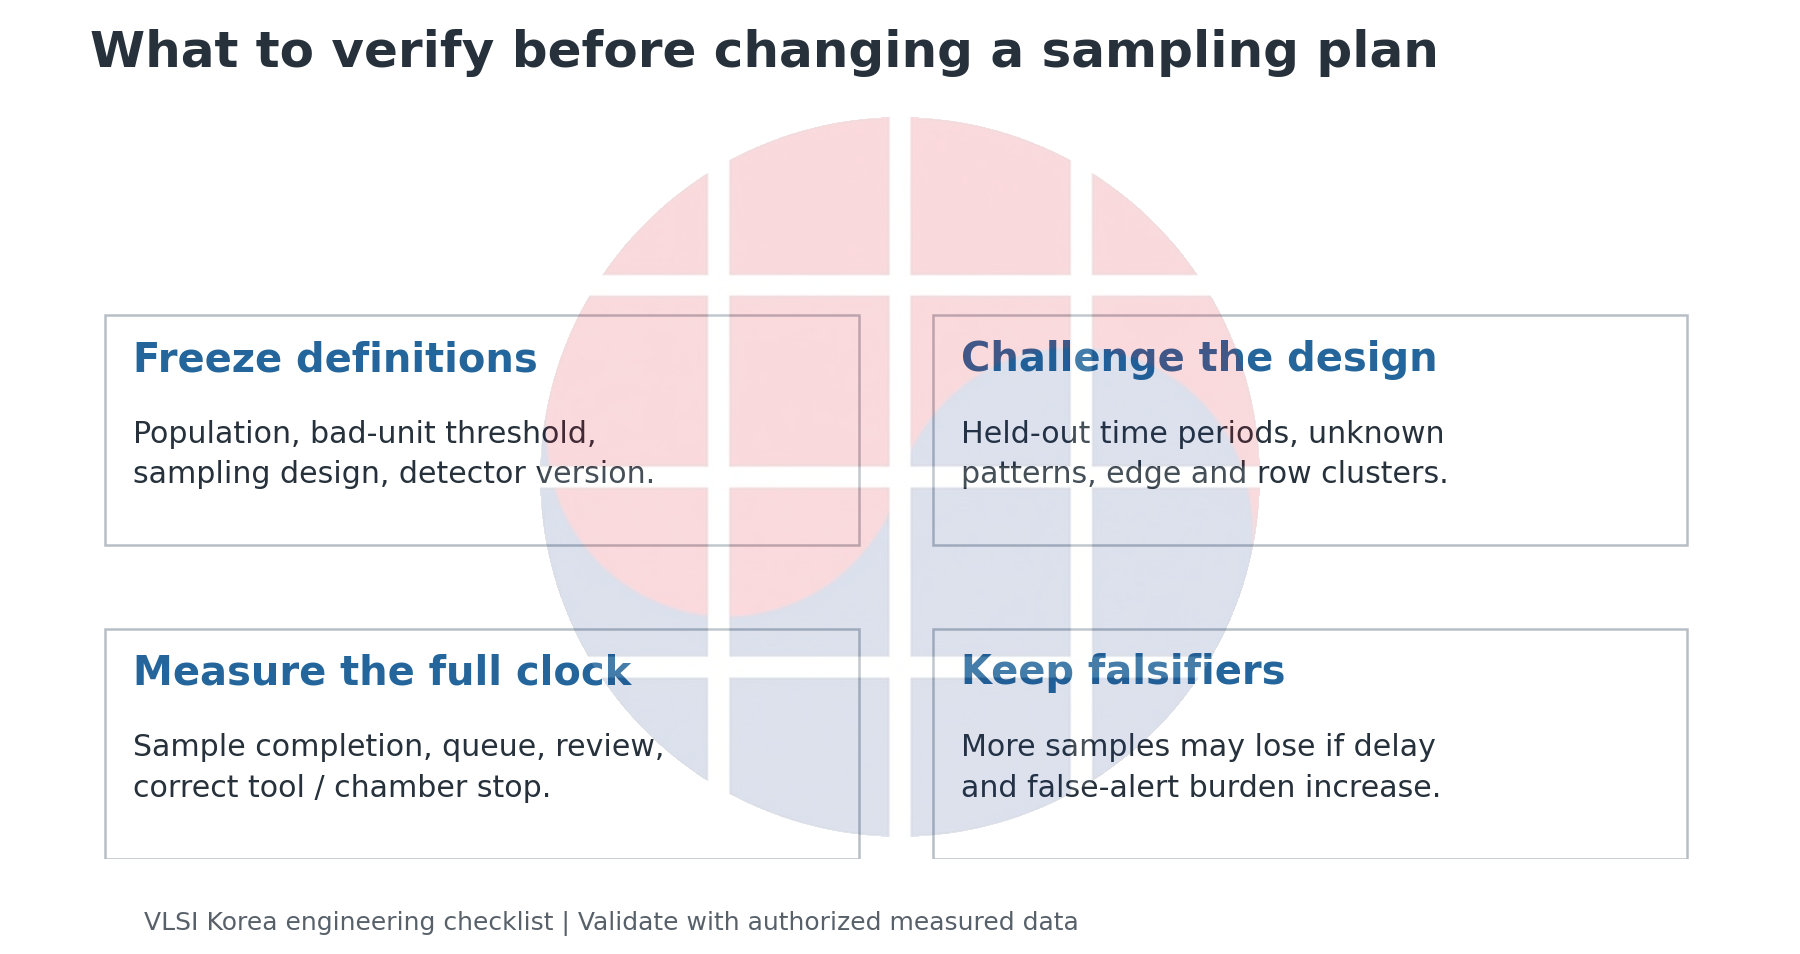
실행 순서는 모집단과 표본 규칙 동결, 독립적인 기준 검사로 sensitivity 확인, 공간·시간 holdout 평가, feedback 시각 검증입니다. 검사 공정의 맥락은 Yield Engineering의 역할과 workflow와 연결해 읽을 수 있습니다. 특정 업체의 양산 recipe나 비공개 data를 이 글에 대입하지 않았습니다.
파괴 검사에는 한 가지 질문이 더 붙습니다. sample 자체가 사라질 때 평가 대상이 원래 lot인지, 남은 lot인지 정해야 합니다. PTB 연구진의 2025-08-07 공개 preprint는 이 차이를 다룹니다. 이는 앞의 유한 모집단 조합식이 틀렸다는 뜻이 아니라, 그 식으로 답하는 사건과 출하할 잔여 lot의 질문이 다를 수 있다는 뜻입니다.
Boundary condition: 표본에서 검출되지 않았다는 결과를, 관측하지 않은 제품의 정상 판정으로 바꾸려면 별도의 추론과 검증이 필요합니다.
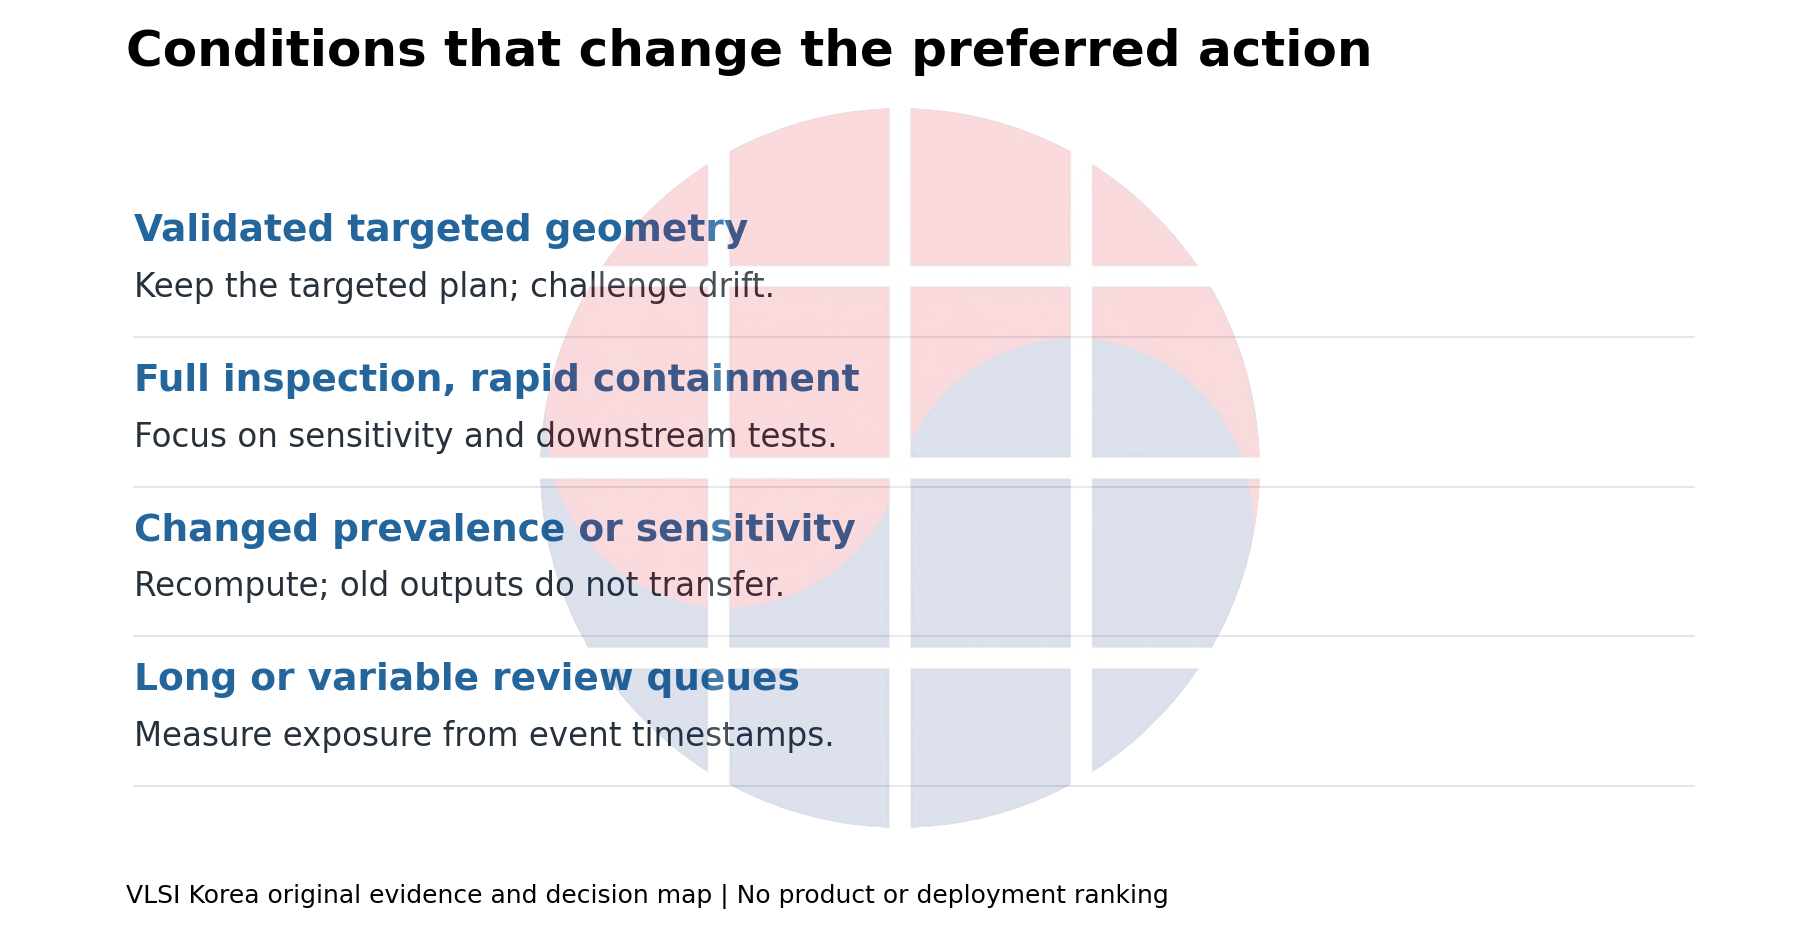
가장 강한 반론은 targeted sampling이 이미 충분히 검증된 현장입니다. 알려진 defect geometry에 대해 좁게 검사하는 방식이 무작위 검사보다 훨씬 효율적일 수 있습니다. 그러면 이 글의 toy comparison은 그 정책을 교체할 근거가 아닙니다. 새로운 geometry나 drift가 들어왔을 때도 이점이 유지되는지를 확인하는 시험 설계로 사용해야 합니다.
또 하나의 반증 조건은 전수 검사와 거의 즉시 작동하는 차단입니다. 표본 선택과 지연이 주요 병목이 아니라면 우선순위를 detector sensitivity, 오분류 또는 downstream test로 옮겨야 합니다. 반대로 p, s, 공간 상관이 가정과 달라졌다면 계산 결과는 즉시 재산출해야 합니다.
다음 관측일은 제품 roadmap이 아니라 편집상의 검증 기준입니다. 2027-03-07에는 defect class별 sensitivity와 공간 holdout의 miss를, 2027-06-07에는 queue·review·interlock의 시간 기록을, 2027-09-07에는 recipe 변경 뒤 새 패턴의 누락을 다시 확인할 항목으로 둡니다. 해당 자료의 공개나 결과 개선을 예고하는 일정은 아닙니다.
승인할 것은 검사율 숫자가 아니라, 그 숫자로 제한하려는 위험과 적용 조건입니다. 표본의 선택 확률, 검출 조건, 실제 차단 시각이 연결돼야 검사 자원을 늘릴지, 위치를 바꿀지, feedback을 줄일지 판단할 수 있습니다.
Sources and method
Evidence checked: 2026-09-07. Models and inputs in this article are illustrative; no private fab data or measured deployment performance is asserted.
- What is Acceptance Sampling? (NIST/SEMATECH). Living handbook; page-specific publication date unavailable.
- Choosing a Sampling Plan with a given OC Curve (NIST/SEMATECH). Living handbook; page-specific publication date unavailable.
- Plans for acceptance sampling by attributes when observations are destructive (Physikalisch-Technische Bundesanstalt). 2025-08-07.
- Deep Open-Set Recognition for Silicon Wafer Production Monitoring (Politecnico di Milano). 2022-08-30.
- SePArate: Segmenting Patterns from Defects in Wafer Manufacturing Using Weak Supervision (Seoul National University). 2026-08-31.
- Defect Detection on Semiconductor Wafers by Distribution Analysis (Technische Universitat Dresden). 2021-11-05.
Source figures: Dain Kwon, Changmin Shin, Sunjong Park, Kanghyun Choi, Hyeyoon Lee, Jaewon Jang, Minseok Choi and Jinho Lee, SePArate. CC BY 4.0. Figures 2 and 5 reproduced from the public paper with a single VLSI Korea watermark added on 2026-09-07. No endorsement is implied.
자료 조사, 계산, 번역과 편집에 AI를 사용했습니다. VLSI Korea의 가정과 해석은 원출처의 연구 결과와 구분했습니다.





