 VLSI Korea
Microsoft anuncia Maia 300: um milhão de chips próprios que mudam o negócio de semicondutores
A Microsoft apresentou o Maia 300, seu chip de IA próprio de terceira geração, e planeja implantar mais de um milhão em 2027. O maior comprador de GPUs do mundo vira concorrente: a economia do token, não os FLOPS, é o novo campo de batalha.


O anúncio de chips mais importante de outubro de 2026 não é sobre um acelerador mais rápido. É sobre quem tem o direito de ser uma empresa de chips. Em 12 de outubro de 2026, a Microsoft apresentou o Maia 300, a terceira geração de seu silício de IA próprio, e disse que planeja implantar potencialmente mais de um milhão desses chips em 2027 como o sistema de inferência principal de seus próprios produtos e serviços (Reuters, 16 de outubro de 2026). O maior comprador mundial de GPUs de IA está se tornando, na margem, um concorrente das GPUs — e cada consulta de inferência que migra para o Maia é gasto que não passa mais pela NVIDIA.
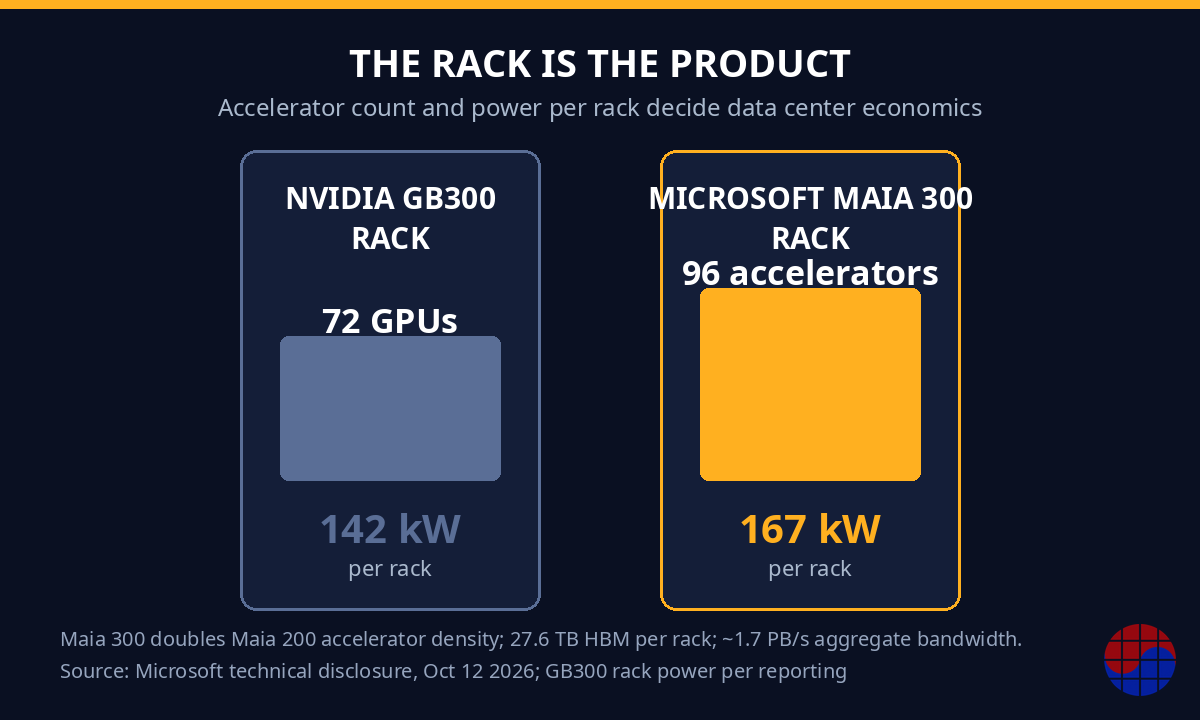
As especificações já são sérias: um encapsulamento chiplet com computação em silício de classe 2 nanômetros da TSMC, oito pilhas de HBM4 com 288 GB e 18,0 TB/s de pico, em um envelope de 950 watts, montados em racks de 96 aceleradores de cerca de 167 quilowatts (Microsoft, 12 de outubro de 2026). A Microsoft afirma ~40% mais tokens por megawatt do que os principais sistemas baseados em GPU, e até 7 vezes o rendimento por rack de seu antecessor, o Maia 200. Mas a história estratégica é maior do que qualquer benchmark: a Microsoft está integrando verticalmente a camada mais cara do stack de IA — a inferência — e fazendo isso em uma escala que reescreve a economia de foundries, fabricantes de memória e fornecedores de chips comerciais.
O que a Microsoft realmente anunciou
O anúncio veio em um blog de Scott Guthrie, vice-presidente executivo de Cloud e IA, na segunda-feira, 12 de outubro de 2026. O CEO Satya Nadella chamou-a de "a maior aposta até agora no nosso próprio silício": a empresa escalará a família Maia para múltiplos gigawatts desde 2027, como o sistema de inferência principal de seus próprios produtos e serviços (Microsoft, 12 de outubro de 2026).
Os principais compromissos, todos datados e registrados:
- O Maia 300 é focado em inferência. Não é um acelerador de treinamento: foi projetado para as cargas que a Microsoft realmente monetiza — assistência de codificação, raciocínio de contexto longo, IA conversacional em tempo real e tarefas de agentes em várias etapas.
- As implantações de produção começam em 2027, com escalonamento para múltiplos gigawatts. A Reuters informou que a empresa pode implantar mais de um milhão de chips Maia no próximo ano.
- O Maia 200 já está em produção, executando os modelos de IA próprios da Microsoft e os modelos da OpenAI entregues no Azure, implantado nos Estados Unidos, Europa e Austrália. O Microsoft 365 Copilot roda sobre ele hoje; o GitHub Copilot e o Microsoft Foundry estão programados para seguí-lo até o fim de 2026.
- A alegação de eficiência divulgada do Maia 200: até 1,7 vez mais tokens por watt do que sistemas alternativos baseados em GPU — a linha de base contra a qual se mede o ganho de 7 vezes no rendimento de tokens por rack do Maia 300.
Duas ressalvas: a alegação de 40% mais tokens por megawatt é medida contra "principais sistemas baseados em GPU" sem nome — é uma alegação do fornecedor, não um benchmark independente. E a Microsoft continua comprando GPUs da NVIDIA em grande escala: o impacto de curto prazo é uma mudança na composição do gasto com inferência, não um deslocamento da noite para o dia.
O chip, em números
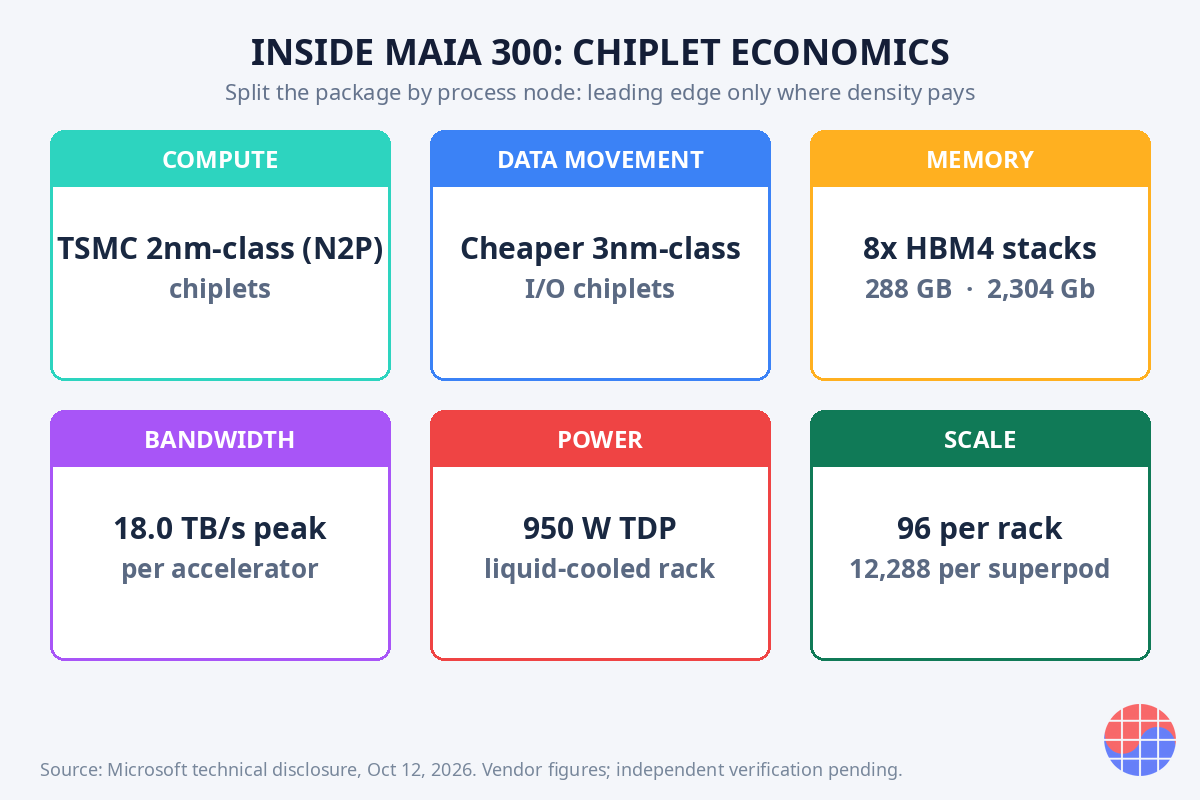
Segundo a divulgação técnica da Microsoft (12 de outubro de 2026), o Maia 300 é um encapsulamento multi-chiplet que divide o dado pela economia, não apenas pela função:
| Bloco | Detalhe |
|---|---|
| Chiplets de computação | Silício de classe 2 nm da TSMC (N2P) para funções-chave de computação |
| Chiplets de movimentação de dados | Silício de classe 3 nm mais barato para mover dados para fora do processador |
| Memória | 8 pilhas de HBM4, 288 GB (2.304 Gb) por acelerador |
| Largura de banda de memória | 18,0 TB/s de pico |
| Energia | 950 W de TDP por acelerador |
| Rack | 96 aceleradores, ~167 kW, 27,6 TB de HBM por rack |
| Largura de banda do rack | ~1,7 PB/s de largura de banda de memória agregada |
| Escalonamento | Fabric Ethernet de dois níveis, até 128 racks = 12.288 aceleradores por superpod |
Três números merecem uma segunda olhada. 288 GB de HBM4 por chip são 2.304 Gb: com mais de um milhão de chips, isso sinaliza demanda por mais de 8 milhões de pilhas de HBM4 — cerca de 288 petabytes — somente na implantação de 2027. 950 watts por acelerador colocam o Maia 300 na mesma classe térmica das GPUs comerciais de ponta, o que significa as mesmas cadeias de suprimentos de refrigeração líquida e entrega de energia. E 96 aceleradores por rack a 167 kW dobram a densidade de aceleradores do Maia 200 — a unidade de competição não é mais o chip, é o rack.
O fabric de escalonamento é a pista silenciosa. O Maia 300 usa um fabric Ethernet de dois níveis — enlaces elétricos dentro do rack, ópticos entre racks — unindo até 128 racks em um superpod de 12.288 aceleradores, com largura de banda realocável pelos agendadores de trabalhos e capacidade reserva a quente de racks vizinhos. É uma aposta arquitetural direta contra interconexões de escalonamento proprietárias: Ethernet, o padrão commodity, versus jardins murados no estilo NVLink. Para a Broadcom, a Marvell e o ecossistema Ethernet, a vitória de design mais relevante do ano.
Por que inferência e por que agora: a lógica da economia dos tokens
O treinamento fica com as manchetes; a inferência paga as contas. Cada consulta do Copilot, cada ciclo de agente, cada sessão de raciocínio de contexto longo é inferência cobrada da própria estrutura de custos da Microsoft. À medida que os custos de servir modelos caem — inteligência mais barata por token — o dinheiro se concentra em quem serve tokens mais barato em escala.
É exatamente para isso que o Maia 300 é otimizado: 40% mais tokens por megawatt e novos formatos de dados sub-3-bit e MXFP4 aprimorado que extraem mais trabalho útil de cada watt. A Microsoft não está tentando superar a NVIDIA em FLOPS de pico. Está tentando vencer a métrica que decide seu próprio resultado: o custo por milhão de tokens servidos, dentro de centros de dados que já possui, em cargas de trabalho que já controla.
A lógica MBA em uma linha: quando você detém tanto a demanda (Copilot, Azure) quanto a oferta (silício Maia, centros de dados), a integração vertical converte um custo variável — comprar GPUs alheias com a margem de outro — em um ativo de custo fixo que se deprecia. O plano do milhão de chips é a Microsoft depreciando a inferência.
A leitura do engenheiro: chiplets são uma decisão de rendimento
Sem o marketing, o encapsulamento do Maia 300 é uma lição de manual de economia de nós avançados: daquelas que se aprendem no chão de fábrica do tape-out, não em um deck de estratégia.
Colocar a computação no N2P de classe 2 nm da TSMC e as funções de controlador de memória e E/S em um nó de classe 3 nm mais barato é, antes de tudo, uma jogada de rendimento (yield) e custo. Nos nós de ponta a densidade de defeitos mais dói e os preços de wafer mais mordem: ali vai apenas a lógica que realmente precisa da densidade; o resto fica em um nó maduro de alto rendimento. A economia de dados bons conhecidos (known-good-die) então decide o rendimento do encapsulamento, não um único dado monolítico gigante.
Segundo, a interface HBM4 é o verdadeiro desafio de signoff. Oito pilhas a 18,0 TB/s significa que a PHY, o roteamento do interposer e o trabalho de integridade de energia em torno do subsistema de memória dominam o esforço de projeto físico — muito mais do que o fechamento de temporização da lógica pura. Quem já fez signoff de STA em um SoC grande conhece o padrão: o número de manchete é a largura de banda, mas o risco do tape-out mora nas interfaces.
Terceiro, o co-design em nível de rack é o novo floorplan. Com refrigeração líquida absorvendo a maior parte da carga térmica de um rack de 167 kW, encapsulamentos de 950 W e enlaces ópticos entre racks, a rede de entrega de energia e o envelope térmico condicionam a arquitetura antes do RTL. A equipe de chips que não co-projeta com a de racks entrega uma peça que o centro de dados não consegue abrigar.
O que significa para a NVIDIA
O risco de curto prazo para a NVIDIA é limitado: a Microsoft continua comprando suas GPUs em grande escala, e o treinamento — o bastião da NVIDIA — não é tocado por um chip focado em inferência. Mas a direção é inconfundível. Cada consulta do Copilot que migra para o Maia é receita de inferência que não flui mais pelo stack da NVIDIA: nem a GPU, nem a HBM acoplada a ela, nem as redes.
Mais estruturalmente, o Maia 300 legitima o escalonamento Ethernet na maior escala da indústria. Se o fabric de dois níveis entregar em escala de 12.288 aceleradores, enfraquece o argumento de que apenas interconexões proprietárias sustentam um cluster de ponta — e o aprisionamento por interconexão é um pilar do fosso da NVIDIA.
O efeito de terceira ordem é o poder de preços. Uma alternativa interna crível muda cada negociação dos grandes compradores com os fornecedores comerciais. A Microsoft não precisa que o Maia supere a melhor GPU comercial em cada carga de trabalho; precisa que o Maia seja bom o suficiente nas cargas de trabalho da Microsoft para limitar o que paga pelo resto.
O que significa para memória e foundry
Memória: 8 pilhas de HBM4 por chip com mais de um milhão de chips é um sinal de demanda incremental de mais de 8 milhões de pilhas para 2027 — para SK hynix, Samsung e Micron, todos correndo para qualificar HBM4. A disciplina de unidades importa: 288 GB por acelerador são 2.304 Gb, e a aritmética em nível de rack (27,6 TB por rack) é como os planejadores de centros de dados compram. A corrida de suprimento de HBM4 acabou de ganhar sua maior âncora de demanda.
Foundry: os chiplets de computação no N2P da TSMC fazem da Microsoft um dos primeiros clientes em grande escala da família N2, ao lado dos nomes habituais de mobile e HPC. A alocação antecipada de N2P nesse volume é declaração tecnológica e negociação de capacidade ao mesmo tempo — e aprofunda a liderança da TSMC como o foundry da era da IA.
O clube do silício próprio já está cheio. O Google tem TPUs, a AWS tem Trainium, a Meta tem MTIA e a OpenAI persegue seu próprio chip. O plano de um milhão de unidades do Maia 300 é o maior compromisso de implantação individual entre eles: o silício vertical passou de experimento a estratégia de compras.
O que observar a seguir
- Benchmarks independentes. A alegação de 40% não nomeia nenhuma GPU de referência: aguarde medições de terceiros com limites de potência definidos e cargas reais.
- Suprimento de HBM4. Se a Microsoft garante mais de 8 milhões de pilhas de HBM4 para 2027 com a memória escassa — e qual dos três fornecedores vence a qualificação.
- Clientes externos. A Microsoft diz que o Maia é para seus próprios produtos e serviços. Se um cliente externo algum dia obtiver acesso, o Maia se torna um concorrente comercial, não apenas uma jogada de custos.
- A aposta Ethernet. Se o fabric de escalonamento de dois níveis aguenta em escala de 12.288 aceleradores — o resultado ecoará no roteiro de cada fornecedor de redes.
A conclusão: o Maia 300 não é um lançamento de chips. É uma estratégia de compras com foto de dado. A Microsoft olhou para a maior linha do seu resultado de IA — a computação de inferência — e decidiu fabricá-la. Para a indústria de semicondutores, a mensagem é que o cliente agora também é o concorrente, e a negociação acontece em tokens por megawatt.
Perguntas frequentes
O que é o Microsoft Maia 300?
O Maia 300 é o acelerador de IA próprio de terceira geração da Microsoft, anunciado em 12 de outubro de 2026 e projetado para cargas de trabalho de inferência como assistência de codificação, raciocínio de contexto longo e tarefas agênticas. Ele usa uma arquitetura chiplet com dados de computação em silício de classe 2 nm da TSMC, oito pilhas de HBM4 (288 GB, 18,0 TB/s), em um envelope de 950 W, implantado em racks de 96 aceleradores.
Quantos chips Maia 300 a Microsoft implantará?
A Reuters informou (16 de outubro de 2026) que a Microsoft planeja implantar potencialmente mais de um milhão de chips Maia em 2027, escalando a família Maia para implantações de múltiplos gigawatts como o sistema de inferência principal de seus próprios produtos e serviços. As implantações de produção começam em 2027.
Como o Maia 300 se compara às GPUs da NVIDIA?
A Microsoft afirma cerca de 40% mais tokens por megawatt do que "principais sistemas baseados em GPU" sem nome, e até 7 vezes o rendimento de tokens por rack de seu antecessor Maia 200 — ambas alegações do fornecedor aguardando verificação independente. Arquiteturalmente, o Maia 300 aposta em um fabric Ethernet de escalonamento de dois níveis versus interconexões proprietárias, e mira a eficiência de custo de inferência em vez de FLOPS de pico de treinamento.
O que o Maia 300 significa para os fornecedores de HBM e foundry?
Com 8 pilhas de HBM4 por chip e mais de um milhão de chips planejados, a implantação de 2027 implica demanda por mais de 8 milhões de pilhas de HBM4 (~288 petabytes) — uma importante âncora de demanda para as rampas de HBM4 da SK hynix, Samsung e Micron. Os chiplets de computação no nó N2P da TSMC também fazem da Microsoft um dos primeiros clientes em grande escala da capacidade de classe 2 nm da TSMC.
Divulgação: esta análise se baseia no anúncio da Microsoft de 12 de outubro de 2026 e em reportagens subsequentes (Reuters, 16 de outubro de 2026); os números de desempenho são alegações da Microsoft e não foram verificados de forma independente. O autor não detém posições nas empresas mencionadas. Os números refletem o divulgado em 17 de outubro de 2026.


