 VLSI Korea
微軟 Maia 300 發布:百萬顆自研 AI 晶片改寫半導體商業版圖
微軟發布第三代自研 AI 晶片 Maia 300,計畫 2027 年部署超過一百萬顆。全球最大 GPU 買家轉身成為競爭者,新的戰場不是 FLOPS,而是 token 經濟學。


2026 年 10 月最重要的晶片發布,不是關於更快的加速器,而是關於誰有資格成為晶片公司。2026 年 10 月 12 日,微軟發表了第三代自研 AI 晶片 Maia 300,並表示計畫在 2027 年部署超過 100 萬顆,作為自家產品與服務的主力推論系統(路透社,2026 年 10 月 16 日)。全球最大的 AI GPU 買家,如今正在成為 GPU 競爭者——每一個轉移到 Maia 的推論查詢,都是不再經過輝達的營收。
規格本身也相當扎實:運算小晶片採用台積電 2 奈米級矽晶圓,8 層 HBM4 堆疊提供 288GB 記憶體、18.0TB/s 峰值頻寬,封裝功耗 950W,96 個加速器組成一個約 167kW 的機櫃(微軟技術公告,2026 年 10 月 12 日)。微軟宣稱每百萬瓦詞元數比主流 GPU 系統高出約 40%,機櫃級詞元吞吐量最高可達前代 Maia 200 的 7 倍。但比基準測試數字更重要的,是背後的戰略:微軟正在垂直整合 AI 堆疊中最昂貴的一層——推論——而且規模大到足以改寫晶圓代工、記憶體與第三方晶片廠商的經濟學。
微軟實際宣布了什麼
這次發表來自 2026 年 10 月 12 日(週一)雲端與 AI 執行副總裁斯科特·古斯里(Scott Guthrie)的部落格文章。執行長薩蒂亞·納德拉(Satya Nadella)稱這是微軟「在自研晶片上最大的一次押注」,表示將從 2027 年起把 Maia 家族擴展到多 GW 規模,成為自家產品與服務的主力推論系統(微軟,2026 年 10 月 12 日)。
以下是已載入紀錄的關鍵承諾:
- Maia 300 以推論為優先。 不同於訓練加速器,它是為微軟真正賺錢的工作負載設計的:程式碼輔助、長上下文推理、即時對話式 AI,以及多步驟代理任務。
- 2027 年開始量產部署,擴展到多 GW 規模。路透社報導,微軟明年可能部署超過 100 萬顆 Maia 晶片。
- Maia 200 已在量產,運行微軟自家 AI 模型與 Azure 上提供的 OpenAI 模型,部署於美國、歐洲與澳洲。Microsoft 365 Copilot 今天就運行在它上面;GitHub Copilot 與 Microsoft Foundry 預計在 2026 年底前跟進。
- Maia 200 已公開的能效數據:每瓦詞元數最高為其他 GPU 系統的 1.7 倍——Maia 300 的 7 倍機櫃級吞吐量,就是以此為基準衡量的。
嚴肅的讀者應該記住兩個但書:微軟「每百萬瓦多 40% 詞元」的說法,比較對象是未具名的「主流 GPU 系統」,因此是廠商說法,而非獨立基準測試。而且微軟仍在大量採購輝達 GPU——短期內對輝達的影響是推論支出的結構轉移,而非一夜之間的取代。
用數字看 Maia 300
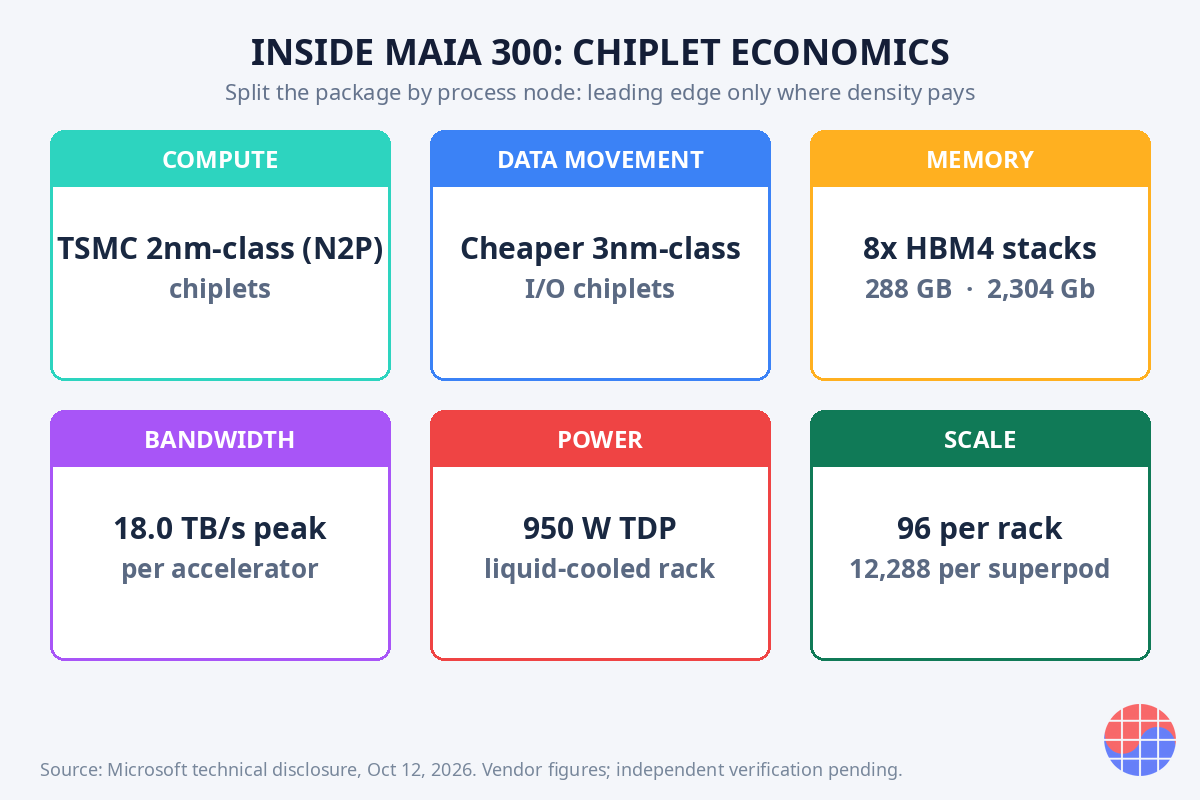
根據微軟的技術公告(2026 年 10 月 12 日),Maia 300 是一個多小晶片封裝,分割晶粒的依據是經濟學,而不只是功能:
| 區塊 | 細節 |
|---|---|
| 運算小晶片 | 台積電 2 奈米級(N2P),負責關鍵運算功能 |
| 資料搬移小晶片 | 成本較低的 3 奈米級矽晶圓,負責處理器外部的資料搬移 |
| 記憶體 | 8 層 HBM4 堆疊,每個加速器 288GB(2,304Gb) |
| 記憶體頻寬 | 峰值 18.0TB/s |
| 功耗 | 每個加速器 950W TDP |
| 機櫃 | 96 個加速器,約 167kW,每機櫃 27.6TB HBM |
| 機櫃頻寬 | 總計約 1.7PB/s 記憶體頻寬 |
| 擴展架構 | 雙層乙太網路架構,最多 128 個機櫃 = 每個 superpod 12,288 個加速器 |
有三個數字值得再看一眼。每顆晶片 288GB 的 HBM4 就是 2,304Gb——以超過 100 萬顆的部署計畫,光是 2027 年的部署就釋放了超過 800 萬層 HBM4 堆疊、約 288PB HBM4 的需求訊號。每個加速器 950W 讓 Maia 300 與旗艦級第三方 GPU 同屬一個散熱等級,意味著共用同一套液冷與供電供應鏈。而每機櫃 96 個加速器、167kW 是 Maia 200 兩倍的加速器密度——競爭的單位不再是晶片,而是機櫃。
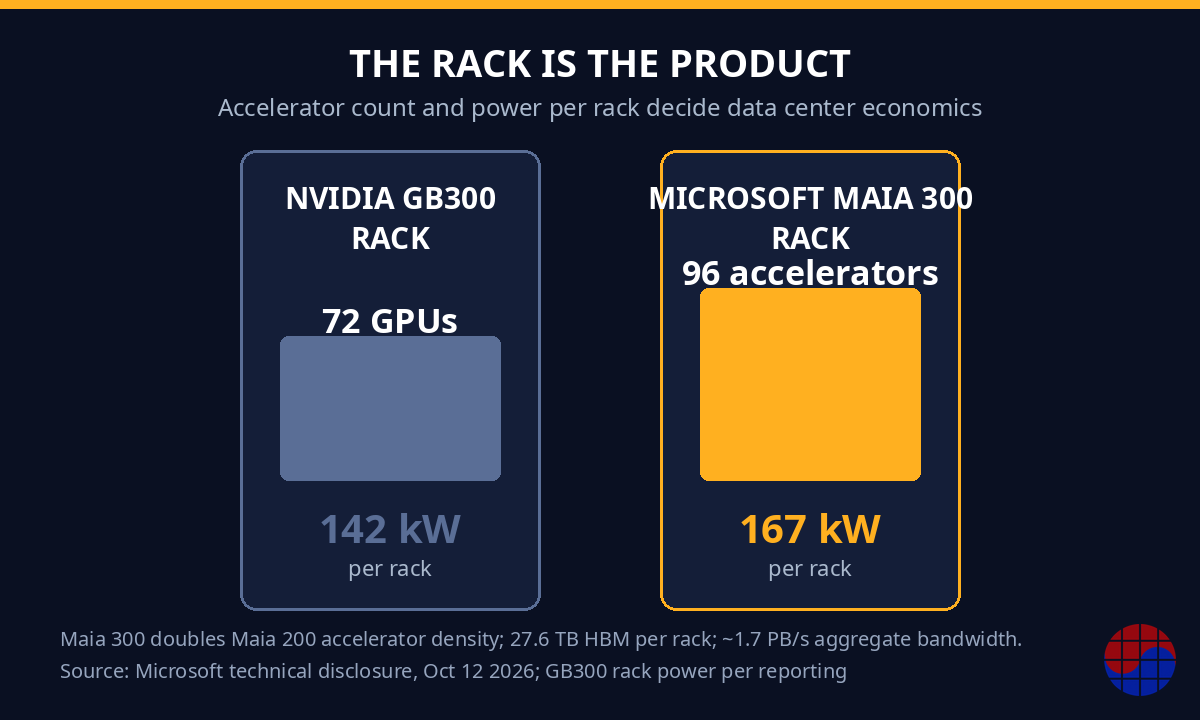
擴展架構(scale-up fabric)是低調卻關鍵的訊號。Maia 300 採用雙層乙太網路架構——機櫃內用電氣鏈路,機櫃間用光學鏈路——最多 128 個機櫃組成 12,288 個加速器的 superpod,頻寬可由工作排程器重新分配,熱備援容量可向鄰近機櫃借用。這是對專有擴展互連的直接架構押注:商品化標準的乙太網路,對上 NVLink 式的封閉花園。對博通、邁威爾與整個乙太網路生態系而言,這是今年最重要的 design win。
為什麼是推論,為什麼是現在:詞元經濟學
訓練搶走頭條,推論賺走鈔票。每一次 Copilot 查詢、每一圈代理迴路、每一次長上下文推理會話,都是直接計入微軟自身成本結構的推論工作負載。模型服務成本越低——每詞元的智慧越便宜——資金就越往能以最低成本大規模提供詞元的人集中。
這正是 Maia 300 優化的方向:每百萬瓦多 40% 的詞元,以及 sub-3-bit 與增強版 MXFP4 資料格式,讓每一瓦擠出更多有效工作。微軟不是要在峰值 FLOPS 上打敗輝達,而是要在決定自身損益(P&L)的指標上獲勝:在自己擁有的資料中心裡、在自己掌控的工作負載上,每百萬詞元的服務成本。
用 MBA 的邏輯一句話說:當你同時擁有需求(Copilot、Azure)與供給(Maia 晶片、資料中心),垂直整合就把變動成本——用別人的利潤買別人的 GPU——轉換成可以折舊的固定成本資產。100 萬顆計畫,就是微軟在為推論做攤銷。
工程師的解讀:小晶片是良率決策
拿掉行銷話術,Maia 300 的封裝是先進製程經濟學的教科書案例——那種在投片現場學到、而非在策略投影片裡學到的。
把運算放在台積電 2 奈米級 N2P 上,記憶體控制器與 I/O 功能留在成本較低的 3 奈米級節點,首要考量是良率與成本。最先進的節點是缺陷密度最痛、晶圓價格最貴的地方;只有真正需要密度的邏輯才放上去,其餘留在成熟的高良率節點。封裝的良率於是由良品裸晶(KGD)的經濟學決定,而非由一顆巨大的單體晶粒決定。
第二,真正的簽核難題在 HBM4 介面。8 層堆疊、18.0TB/s 意味著 PHY、中介層繞線、記憶體子系統周邊的電源完整性工作,將主導物理設計的投入——遠超過純邏輯的時序收斂。做過大型 SoC 靜態時序簽核的人都懂這個模式:頭條數字是頻寬,但投片風險住在介面裡。
第三,機櫃級協同設計是新的佈局規劃。承載 167kW 機櫃大部分熱負載的液冷、950W 封裝、機櫃間光學鏈路——供電網路與散熱包絡現在比 RTL 更早約束架構。不跟機櫃團隊協同設計的晶片團隊,做出的是資料中心裝不下的零件。
對輝達的意義
對輝達的短期風險有限:微軟仍在大量採購其 GPU,而訓練——輝達的大本營——不在推論專用晶片的射程內。但方向毫不含糊。每一個轉移到 Maia 的 Copilot 查詢,都是不再流經輝達堆疊的推論營收:不是 GPU,不是它上面的 HBM,也不是網路。
更結構性的影響是,Maia 300 在業界最大規模上為乙太網路擴展路線背書。如果雙層乙太網路架構在 12,288 個加速器的規模上跑得起來,「只有專有互連才能撐起前沿級叢集」的論點就會弱化——而互連鎖定正是輝達平台護城河的支柱之一。
第三層效應是議價能力。一個可信的自研替代方案,會改變每一家大買家與第三方廠商的談判。微軟不需要 Maia 在所有工作負載上打敗最好的第三方 GPU;只要在微軟自己的工作負載上「夠好」,就能為其餘的採購設下價格天花板。
對記憶體與晶圓代工的意義
記憶體: 每顆晶片 8 層 HBM4 堆疊、100 萬顆以上,就是 2027 年超過 800 萬層 HBM4 堆疊的增量需求訊號——對正在競逐 HBM4 認證的 SK 海力士、三星、美光而言皆然。注意單位紀律:每個加速器 288GB 就是 2,304Gb,而機櫃級算法(每機櫃 27.6TB)才是資料中心規劃者真正的採購單位。HBM4 供給競賽迎來了最大的需求錨。
晶圓代工: 運算小晶片採用台積電 N2P,意味著微軟成為最早的大規模 N2 家族客戶之一,與常見的手機與 HPC 大客戶並列。這個量級的早期 N2P 產能分配,既是技術宣示,也是產能談判——並加深了台積電作為 AI 時代晶圓代工龍頭的領先。
自研晶片陣營如今已經相當擁擠。 谷歌有 TPU、AWS 有 Trainium、Meta 有 MTIA,OpenAI 也在推進自己的晶片計畫。Maia 300 的 100 萬顆計畫是其中最大的單一部署承諾——這是垂直晶片從實驗走向採購策略的訊號。
接下來看什麼
- 獨立基準測試。 微軟「每百萬瓦多 40% 詞元」的說法沒有具名 GPU 基準。留意定義了功耗邊界、跑真實工作負載的第三方量測。
- HBM4 供給。 在記憶體吃緊的情況下,能否為 2027 年確保超過 800 萬層 HBM4 堆疊——以及三家記憶體廠中誰拿下認證。
- 外部客戶。 微軟說 Maia 只供自家產品與服務。一旦外部客戶能用,Maia 就從成本手段變成第三方競爭者。
- 乙太網路押注。 雙層擴展架構在 12,288 個加速器規模上撐不撐得住——結果將迴盪在每一家網路廠商的產品藍圖上。
結論:Maia 300 不是晶片發布,而是一份貼著晶粒照片的採購策略。微軟看著 AI 損益表上最大的一項——推論算力——決定自己來造。對半導體產業的訊息很明確:客戶如今也是競爭者,而談判的單位是每百萬瓦的詞元數。
常見問題
什麼是微軟 Maia 300?
Maia 300 是微軟第三代自研 AI 加速器,於 2026 年 10 月 12 日發表,專為程式碼輔助、長上下文推理、代理任務等推論工作負載設計。採用小晶片架構,運算晶粒使用台積電 2 奈米級製程,8 層 HBM4 堆疊(288GB、18.0TB/s),封裝功耗 950W,以 96 個加速器為單位組成機櫃部署。
微軟會部署多少顆 Maia 300?
路透社報導(2026 年 10 月 16 日),微軟計畫在 2027 年部署超過 100 萬顆 Maia 晶片,將 Maia 家族擴展到多 GW 規模,作為自家產品與服務的主力推論系統。量產部署自 2027 年開始。
跟輝達的 GPU 相比如何?
微軟宣稱每百萬瓦詞元數比未具名的「主流 GPU 系統」高出約 40%,機櫃級詞元吞吐量最高為前代 Maia 200 的 7 倍——兩者都是有待獨立驗證的廠商說法。架構上,Maia 300 押注雙層乙太網路擴展架構而非專有互連,瞄準的是推論成本效率,而非峰值訓練 FLOPS。
對 HBM 與晶圓代工供應商有什麼意義?
每顆晶片 8 層 HBM4 堆疊、100 萬顆以上的計畫,意味著 2027 年的部署將帶來超過 800 萬層 HBM4 堆疊(約 288PB)的需求——是 SK 海力士、三星、美光 HBM4 量產爬坡的重要需求錨。台積電 N2P 節點上的運算小晶片,也讓微軟成為台積電 2 奈米級產能最早的大規模客戶。
揭露:本分析基於微軟 2026 年 10 月 12 日的公告及後續報導(路透社,2026 年 10 月 16 日);效能數據為微軟的說法,尚未經獨立驗證。作者未持有文中提及公司的部位。數據反映截至 2026 年 10 月 17 日的公開資訊。


