 VLSI Korea
DeepX conecta su NPU al software de Intel: la apuesta por el ecosistema de una startup coreana de chips de IA
DeepX está integrando su NPU en OpenVINO de Intel como procesador seleccionable; los primeros resultados llegarán a comienzos del próximo año. Las conversaciones con AMD están abiertas, pero en fase inicial. La tesis: en las NPU de borde, la barrera es la fricción del ecosistema, no los TOPS.


🆓 Artículo gratuito · Cualquiera puede leerlo gratis

Resumen en 30 segundos
DeepX, una startup fabless surcoreana que diseña unidades de procesamiento neuronal (NPU) de bajo consumo, está integrando su chip DX-M1 en el kit de herramientas de software OpenVINO de Intel como un procesador de inferencia seleccionable, dijo su director ejecutivo, Kim Nok-won, en una entrevista el 15 de octubre de 2026. Se esperan los primeros resultados a principios del próximo año, seguidos de un anuncio formal de la alianza. La empresa también ha abierto conversaciones a nivel operativo con AMD tras una mesa redonda celebrada el 7 de octubre en Seúl con la directora ejecutiva de AMD, Lisa Su, aunque ambas partes describen las conversaciones como una definición de dirección más que como una alianza cerrada. Al mismo tiempo, el chip de próxima generación de DeepX, el DX-M2 fabricado con el proceso de 2 nm de Samsung Foundry, realiza su tape-out este mes, con el primer silicio previsto para marzo-abril de 2027. El hilo común es estratégico: DeepX apuesta a que, en los chips de IA para el borde, el campo de batalla decisivo no es el rendimiento bruto en TOPS, sino la poca fricción que un chip genera dentro de las pilas de software y los canales de distribución de otras empresas.
Antecedentes
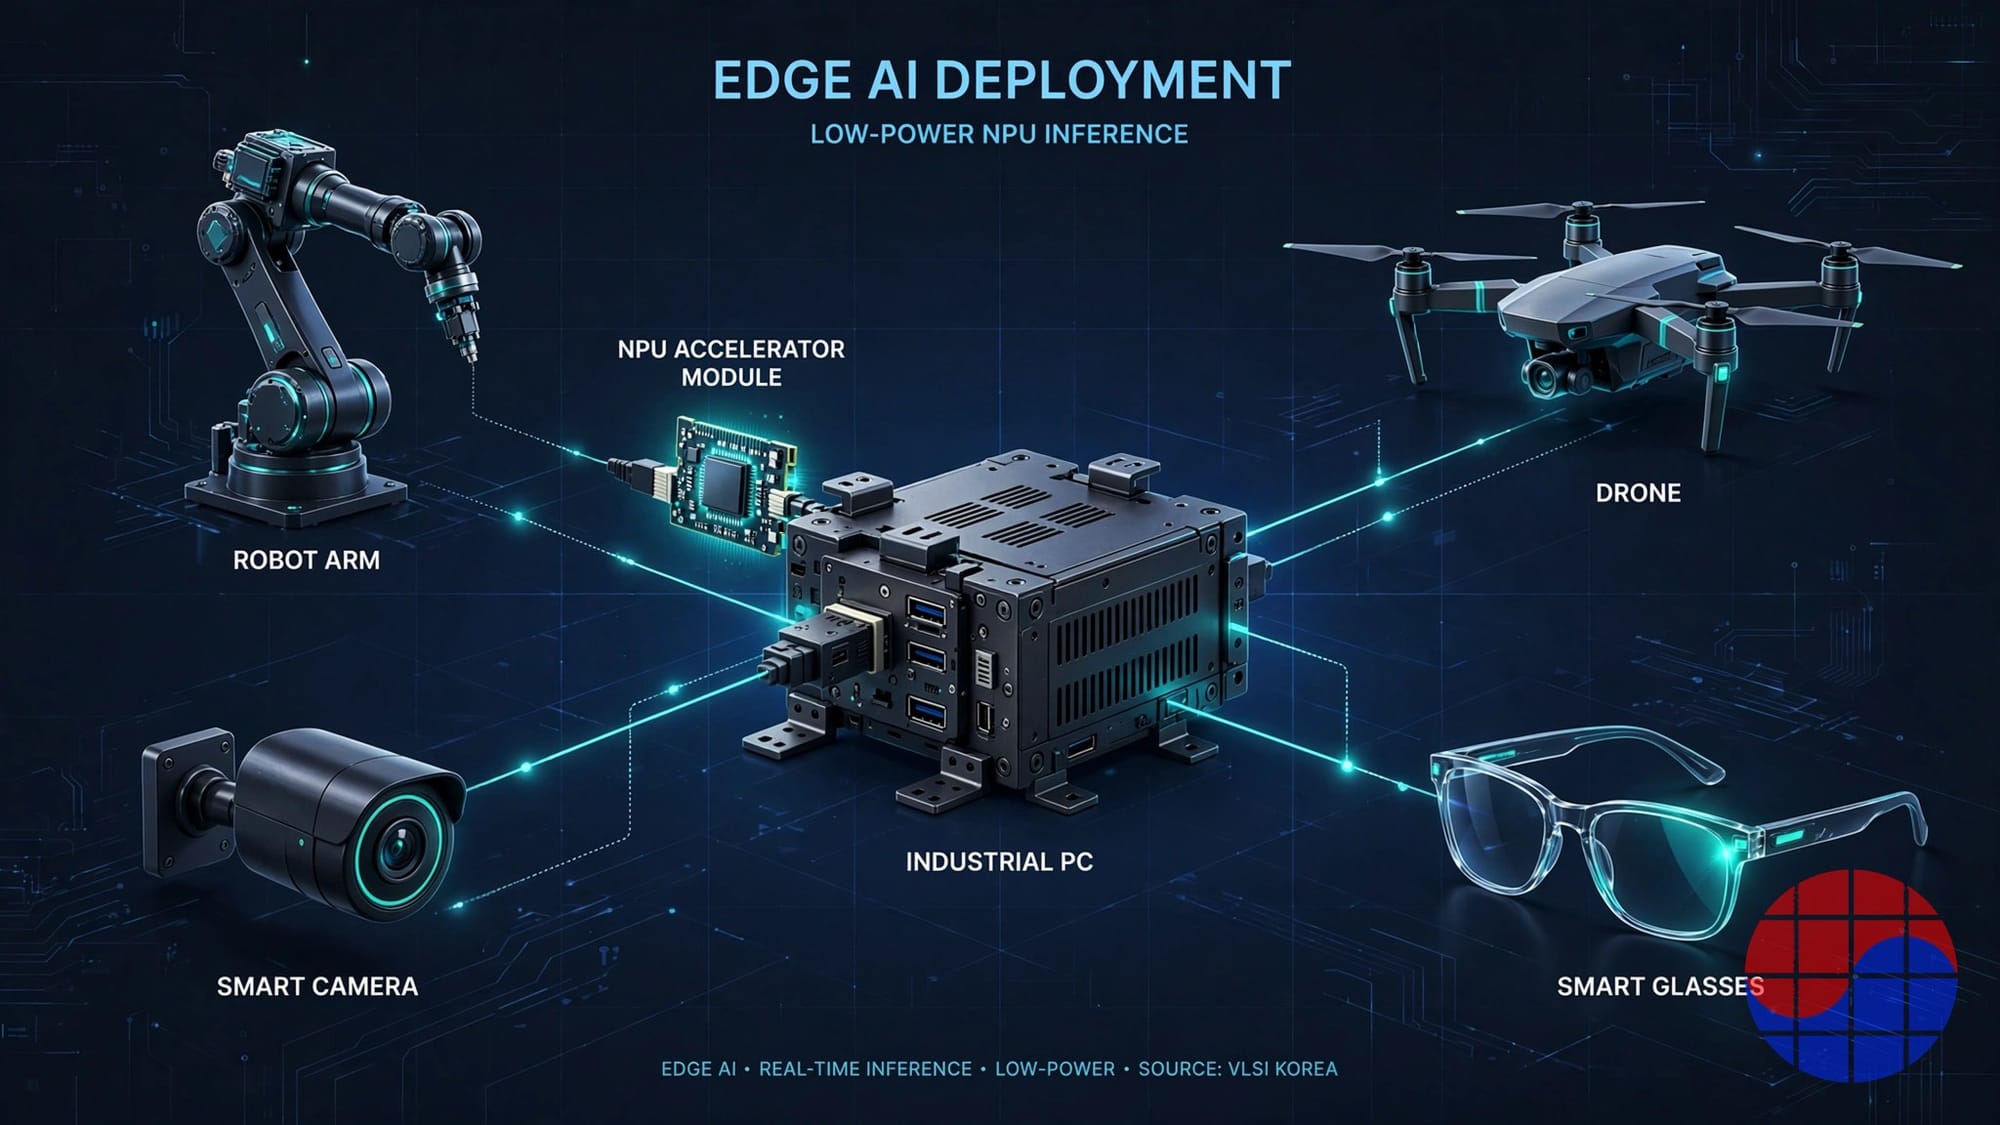
DeepX fue fundada en 2018 por Kim Nok-won, quien tiene un doctorado en ingeniería eléctrica por UCLA y trabajó anteriormente en Broadcom, Cisco e IBM. La empresa es un diseñador fabless: desarrolla chips de inferencia de IA y externaliza la fabricación. Sus productos están dirigidos a la IA en el dispositivo y en el borde — robots, drones, PC industriales, cámaras inteligentes y gafas inteligentes — donde los dispositivos deben ejecutar modelos de IA de forma local, con unos pocos vatios, sin conexión a la nube.
Su producto insignia, el DX-M1, entró en producción en masa en agosto de 2025 con el proceso de 5 nm de Samsung Foundry. Ofrece hasta 25 TOPS de cómputo de IA con 3–5 W, se suministra como un módulo M.2 que se inserta en sistemas existentes y tiene un precio inferior a 100 dólares por chip, según la empresa. DeepX informa de un rendimiento (yield) de producción en masa del 91.1 % para el chip — una cifra divulgada por la propia empresa, pero relevante porque respalda el precio bajo.
La tracción comercial es medible. Entre agosto de 2025 y julio de 2026, DeepX registró 77 órdenes de compra de clientes en más de 10 países, por un valor acumulado de 18.300 millones de wones (unos 13 millones de dólares). Alrededor de 300 empresas en todo el mundo — más de 100 de ellas en Corea — están evaluando sus chips, y la empresa ha firmado 27 acuerdos de distribución, con oficinas previstas en Japón y Europa. Los ingresos declarados aumentaron de 3.300 millones de wones en 2025 a más de 20.000 millones de wones en 2026. Entre los clientes y socios de plataforma divulgados se incluyen el negocio de robótica de Hyundai Motor Group, los líderes en computación industrial Advantech y AAEON, Lenovo y Baidu.
La financiación ha acompañado a esa tracción. DeepX captó 110.000 millones de wones en una Serie C en mayo de 2024, y una Serie D está en curso en 2026; en octubre, Samsung Securities y SVIC 33, una sociedad gestionada por Samsung Venture Investment, suscribieron una asignación de nuevas acciones por 12.3 millones de dólares estadounidenses.
Análisis detallado del negocio
Qué cambia realmente la integración con OpenVINO
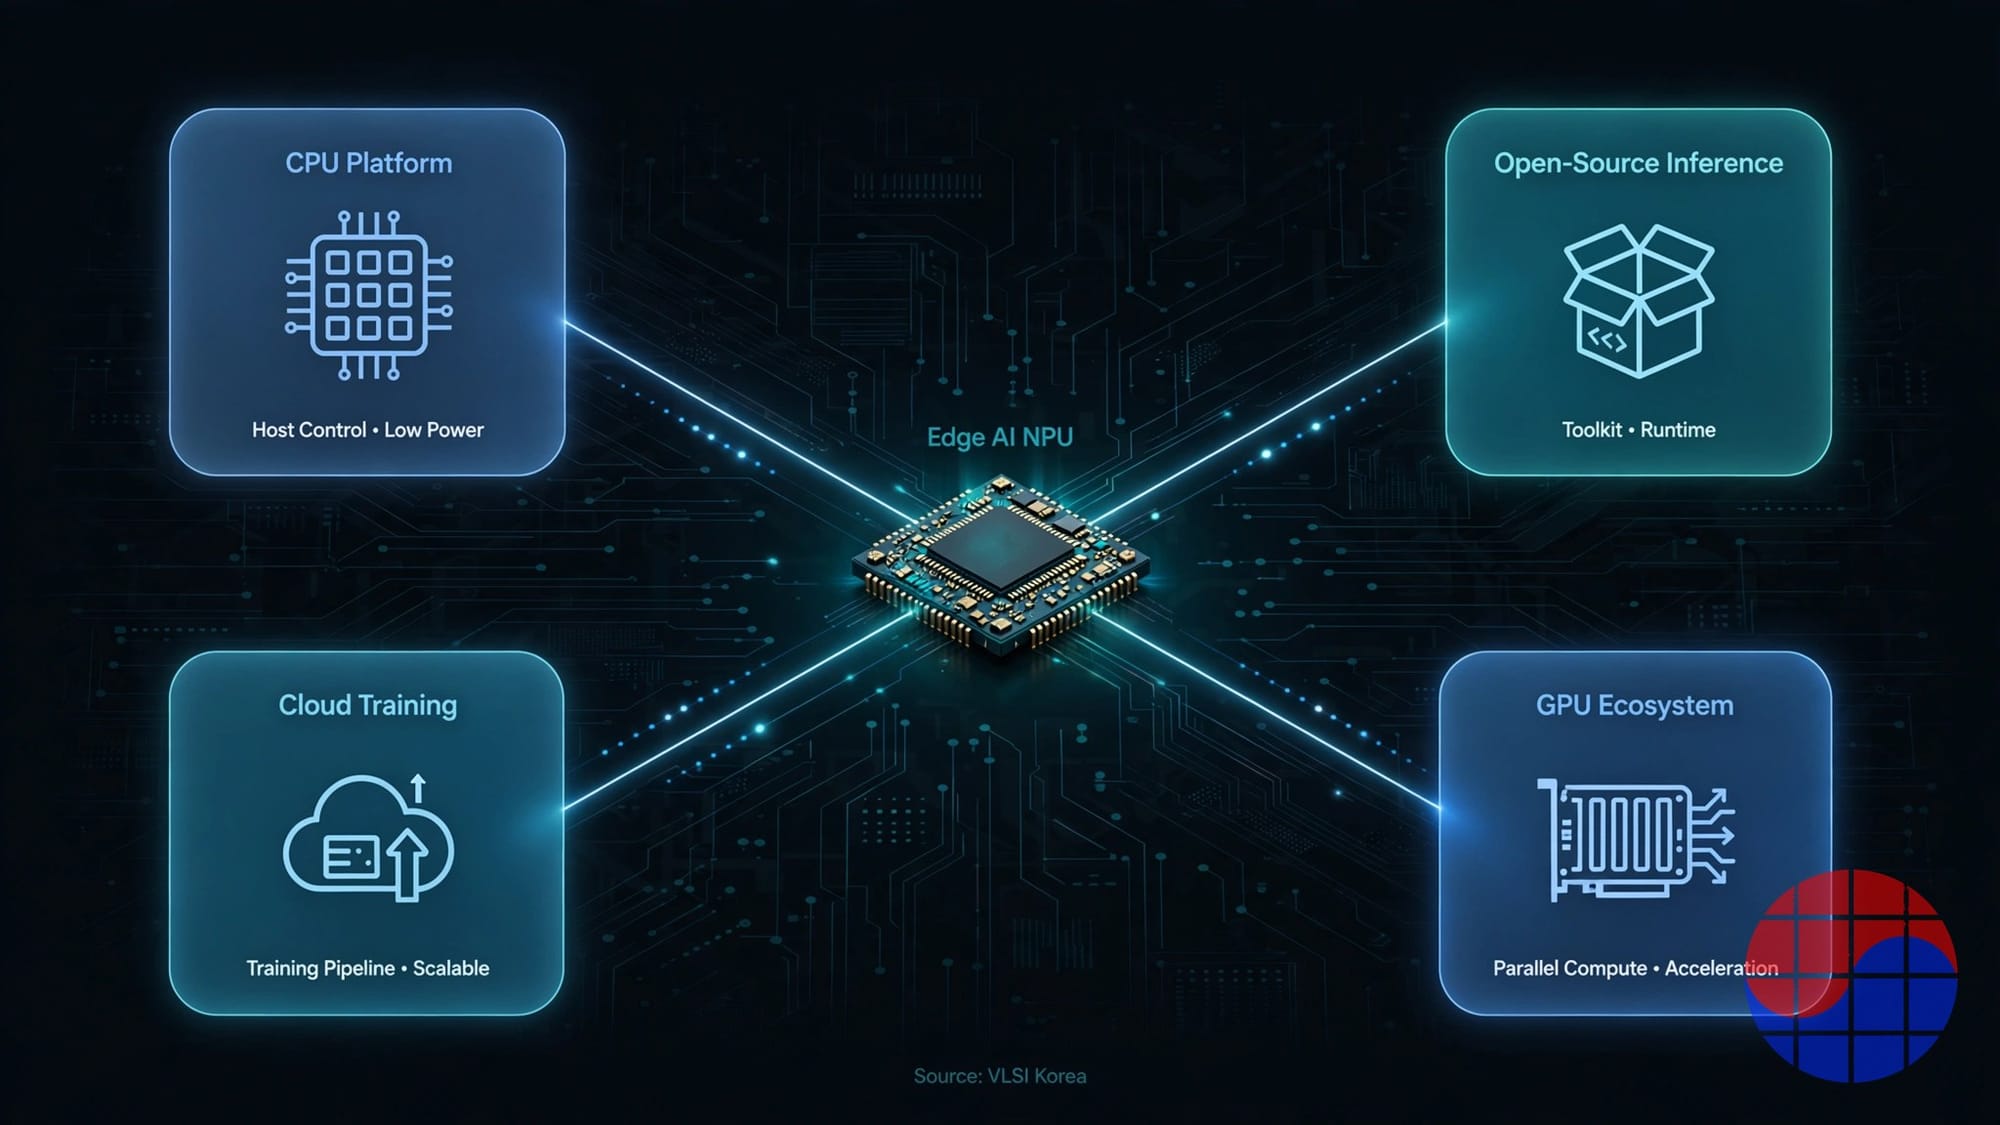
OpenVINO es el kit de herramientas de código abierto de Intel para desplegar inferencia de IA en CPU, GPU y aceleradores. Los desarrolladores escriben una sola vez para sus API y su formato de modelos, y luego eligen el dispositivo de hardware en tiempo de ejecución. DeepX está añadiendo su NPU como uno de esos dispositivos seleccionables, y está realizando el trabajo de optimización de modelos y de herramientas para desarrolladores necesario para que esa vía tenga calidad de producción.
La importancia práctica se entiende mejor desde el lugar que ya ocupan los chips de DeepX. Las NPU de DeepX ya están diseñadas en PC industriales basados en procesadores Intel — pero hoy el integrador tiene que instalar y conectar manualmente el software de DeepX. Cada paso manual es un impuesto a la adopción: horas de ingeniería para el OEM, una carga de soporte para DeepX y una razón para que un diseño se quede en «evaluación» en lugar de pasar a producción. Convertirse en un dispositivo nativo de OpenVINO elimina ese impuesto. Un desarrollador que ya usa OpenVINO — la pila de inferencia por defecto en gran parte del mundo de los PC industriales basados en Intel — puede dirigir su trabajo al silicio de DeepX cambiando una cadena de dispositivo, no adoptando un SDK nuevo.
Por eso importa la secuencia. DeepX dice que anunciará formalmente la alianza con Intel solo después de que la integración produzca resultados, con los primeros resultados previstos para principios del próximo año. Es una postura de resultados primero, y señala que la integración es un trabajo de ingeniería en curso, no un memorando.
Qué gana Intel con esto
El valor estratégico de OpenVINO para Intel crece con cada acelerador de IA que admite. La hoja de ruta de silicio de la propia Intel no aborda directamente el nicho de los aceleradores complementarios discretos de menos de 5 W: como señaló Kim en la mesa redonda de AMD, las NPU integradas en las CPU alcanzan 40–50 TOPS, pero rara vez en componentes de la clase de 5 W, por lo que los robots y los dispositivos de campo necesitan un acelerador complementario de bajo consumo junto a la CPU. Si OpenVINO se convierte en la capa a través de la cual se programan esos chips complementarios — incluidos chips que Intel no fabrica — Intel mantiene el estándar de software incluso donde no gana el silicio. Para DeepX, la ecuación es simétrica: toma prestadas la base instalada y los hábitos de los desarrolladores de Intel en lugar de construir una pila propietaria desde cero, que es precisamente la pelea que una startup con un equipo de software finito no puede permitirse perder lentamente.
Las conversaciones con AMD: sustancia real, límites claros
La historia de AMD necesita una calibración cuidadosa. El evento del 7 de octubre en Seúl fue una mesa redonda organizada en torno a un memorando entre el Gobierno coreano y AMD firmado en julio; 13 empresas coreanas de infraestructura de IA — incluidas FuriosaAI, Rebellions y Mobilint — se sentaron con Lisa Su. La agenda fue estructural: computación heterogénea que combina CPU y GPU de AMD con NPU coreanas, participación en el ecosistema de software abierto ROCm de AMD y diseños de referencia que el Gobierno quiere validar en el país y exportar. AMD se comprometió a abrir un centro de investigación de IA en Corea dentro del año.
Dentro de ese marco, el seguimiento bilateral de DeepX es genuino, pero temprano. Kim dijo que confirmó la disposición de AMD a trabajar con empresas externas en un ecosistema abierto de IA física; el equipo técnico de AMD hizo un seguimiento por correo electrónico; y DeepX planeaba reunirse con el responsable de AMD en Corea la semana siguiente para discutir detalles. El propio Kim caracteriza la etapa como una confirmación de dirección mediante conversaciones a nivel operativo. No hay ninguna colaboración técnica anunciada, ningún producto conjunto ni ningún compromiso de integración con ROCm para el silicio de DeepX.
Dos hechos mantienen la historia con los pies en la tierra. Primero, la coexistencia a nivel de canal ya existe: productos que combinan sistemas AMD con NPU de DeepX ya están en el mercado a través del distribuidor Avnet. Segundo, la lógica estructural es real — la estrategia de ecosistema abierto de AMD necesita que aceleradores que no son de AMD se conecten a sus CPU y GPU, y las NPU coreanas necesitan la gravedad de distribución de una plataforma global. Lo que existe hoy es una puerta abierta con un Gobierno sosteniéndola, no una alianza firmada.
El mapa coreano de NPU: dos juegos diferentes
Las startups coreanas de NPU suelen agruparse juntas, pero juegan a deportes diferentes. Rebellions y FuriosaAI apuntan a la inferencia en centros de datos: el RNGD de FuriosaAI es un acelerador PCIe de 180 W para servidores, y ambas empresas venden rendimiento por vatio a escala de rack a compradores de nube y empresariales, frente a la gravedad del ecosistema de Nvidia. DeepX y Mobilint apuntan al borde: vatios de un solo dígito, precios inferiores a 100 dólares y compradores que son OEM de dispositivos y fabricantes de PC industriales, en lugar de operadores de centros de datos.
La lógica de la ventaja competitiva difiere en consecuencia. Los actores de centros de datos deben sobrevivir a una guerra de software — la madurez del compilador frente a CUDA. Los actores del borde deben sobrevivir a una guerra de distribución: espacio en las plataformas de Advantech y AAEON, acuerdos con distribuidores entre 27 socios y compatibilidad con las cadenas de herramientas que los integradores ya utilizan. Los movimientos recientes de DeepX son todos movimientos de distribución y de cadena de herramientas. Ha completado el trabajo de software con Amazon Web Services para que los modelos entrenados en la nube puedan desplegarse en dispositivos DeepX, y planea un software para robots compatible con la plataforma Isaac de Nvidia dentro del año. OpenVINO, las canalizaciones de AWS, la compatibilidad con Isaac — ninguno de ellos es un anuncio de silicio. Todos reducen el número de razones que un integrador puede dar para decir que no.
La hoja de ruta de silicio avanza en paralelo, como segundo frente. El DX-M2, con el proceso de 2 nm de Samsung Foundry, realiza su tape-out en octubre de 2026, con los primeros chips previstos para marzo-abril de 2027 y la producción en masa como objetivo para más adelante en 2027; la empresa apunta a hasta 80 TOPS en la misma clase de bajo consumo. DeepX es también una fabless coreana emblemática en los nodos avanzados de Samsung, mientras que la mayoría de sus pares fabrica en TSMC — un posicionamiento que la alinea con el impulso de política de IA soberana de Corea, y que vive o muere según la ejecución de Samsung en 2 nm. Kim ha expresado públicamente su confianza en que los rendimientos (yield) de 2 nm pueden comenzar en el rango bajo del 70 % y superar el 80 % en un año; la afirmación se pondrá a prueba con el aumento de producción del DX-M2.
Chase's Take
El mercado de la IA en el borde no lo ganará el mejor chip. Lo ganará el chip que le cueste a un integrador menos horas de ingeniería. La dirección de DeepX entiende claramente lo que vende en realidad: no un procesador, sino una partida en la lista de materiales de otra empresa. El comprador en Advantech, AAEON o Lenovo no pregunta primero «¿cuántos TOPS?». Pregunta «¿cuánto trabajo supone incluir esto en mi equipo, y quién lo respalda?». Cada anuncio de DeepX este año — integración con OpenVINO, canalización de despliegue en AWS, software para robots compatible con Isaac, 27 distribuidores — es una respuesta a esa segunda pregunta.
Ese encuadre también valora correctamente las conversaciones con AMD. Son una opción, no un activo: valiosas porque el impulso de ecosistema abierto de AMD es real y cuenta con respaldo gubernamental, sin valor hasta que exista un alcance técnico. El trabajo con OpenVINO es lo contrario — poco llamativo, específico y dirigido al punto exacto de fricción en los diseños ya ganados por DeepX basados en Intel. Si tuviera que ordenar qué mueve los ingresos de DeepX en 2027, sería OpenVINO entregado a tiempo, el DX-M2 con muestras puntuales y las cerca de 300 empresas en evaluación convirtiéndose en órdenes de compra — en ese orden. La salida a bolsa, que Kim dice que le gustaría llevar a cabo en tres años como máximo, es un hito que sigue a esos tres, no un sustituto de ellos.
Implicaciones
- Para los OEM de dispositivos y los integradores: una opción de inferencia de menos de 5 W y menos de 100 dólares que apunta a las pilas de software ya en uso — OpenVINO para PC industriales basados en Intel, AWS para el despliegue de modelos entrenados en la nube — reduce el coste de cambio de probar un acelerador de IA que no es de Nvidia en el borde.
- Para la política coreana de chips de IA: el programa de IA soberana está produciendo vientos de cola en distribución, no solo subsidios. El formato de la mesa redonda de AMD — titular de la plataforma, Gobierno como convocante, startups locales — es una plantilla con la que se medirá a otras empresas de plataformas.
- Para los competidores de NPU para el borde: el espacio en el canal es la contienda. Los rivales globales del borde compiten por la misma lista de dispositivos de OpenVINO, las mismas plataformas de PC industriales y los mismos distribuidores. La presencia en la cadena de herramientas se está convirtiendo en un requisito previo, no en un diferenciador.
- Para los inversores: la pregunta pasa de «¿puede el chip ganar diseños?» — 77 órdenes de compra dicen que sí — a «¿pueden las victorias en diseños convertirse en fidelización de plataforma antes de que la generación de 2 nm reinicie la carrera?». La ejecución de la Serie D y los resultados de OpenVINO de principios de 2027 son los dos próximos puntos de control.
| Plataforma / socio | Qué está ocurriendo | Estado / plazos |
|---|---|---|
| OpenVINO (Intel) | DX-M1 añadido como dispositivo de inferencia seleccionable en OpenVINO | Resultados iniciales a principios del próximo año; el anuncio formal de la alianza, después |
| AMD | Conversaciones de trabajo tras la mesa redonda del 7 de octubre en Seúl con la CEO Lisa Su | Solo fijación de dirección; sin colaboración técnica anunciada ni compromiso de integración con ROCm |
| AWS | Trabajo de software para desplegar en dispositivos DeepX modelos entrenados en la nube | Completado |
| NVIDIA Isaac | Software de robot compatible con la plataforma Isaac | Previsto dentro del año |
| DX-M2 (Samsung Foundry 2nm) | Chip de próxima generación con objetivo de hasta 80 TOPS | Tape-out en octubre de 2026; primer silicio en marzo–abril de 2027 |
FAQ
Q: ¿Qué está integrando exactamente DeepX en OpenVINO de Intel? A: DeepX está añadiendo su NPU como un procesador de inferencia seleccionable dentro de OpenVINO, el kit de herramientas de despliegue de Intel, junto con optimización de modelos y soporte de herramientas para desarrolladores. Se esperan los primeros resultados a principios del próximo año, y la empresa planea un anuncio formal de la alianza después de que esos resultados estén disponibles. Hoy, usar chips de DeepX en PC industriales basados en Intel requiere instalar y conectar manualmente el software de DeepX.
Q: ¿Se está asociando DeepX con AMD? A: Todavía no. Tras la mesa redonda del 7 de octubre de 2026 en Seúl con la directora ejecutiva de AMD, Lisa Su, ambas partes abrieron conversaciones a nivel operativo y el equipo técnico de AMD hizo un seguimiento por correo electrónico. El director ejecutivo Kim Nok-won describe la etapa como una confirmación de dirección. No se ha anunciado ninguna colaboración técnica ni producto conjunto — aunque productos que combinan sistemas AMD con NPU de DeepX ya se venden a través del distribuidor Avnet.
Q: ¿Cuáles son las especificaciones del DX-M1 y del próximo DX-M2? A: El DX-M1 está fabricado con el proceso de 5 nm de Samsung Foundry, ofrece hasta 25 TOPS con 3–5 W y está en producción en masa desde agosto de 2025. El DX-M2 utiliza el proceso de 2 nm de Samsung, realiza su tape-out en octubre de 2026, con los primeros chips previstos para marzo-abril de 2027 y la producción en masa como objetivo para más adelante en 2027; DeepX apunta a hasta 80 TOPS en un margen de bajo consumo similar.
Q: ¿Cuándo saldrá DeepX a bolsa? A: No se ha fijado ninguna fecha. Kim ha dicho que le gustaría completar una salida a bolsa en tres años como máximo, describiéndola como una herramienta y un hito hacia convertirse en un líder global del sector. La empresa ha indicado anteriormente que consideraría primero una cotización en el mercado doméstico coreano.
Nota: Las cifras de pedidos, ingresos y rendimiento (yield) citadas arriba son divulgaciones de la empresa realizadas en entrevistas y sesiones informativas y no han sido auditadas de forma independiente.
📩 Suscríbete a VLSI Korea
Recibe primero en tu correo nuestros análisis diarios de semiconductores. La suscripción es gratuita.
Lecturas relacionadas


