VLSI Korea
왜 글로벌파운드리가 TSMC용 실리콘 인터포저를 만드는가 — CoWoS 병목의 내막
🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다 작성: 2026-10-09 · Chase (Synopsys Staff Product Engineer, PrimeTime STA signoff · 파운드리 실무) 30초 요약 2026년 10월 8일, GlobalFoundries(GF)가 TSMC와 silicon interposer 공급 계약을 발표했다. 규모는 $2 billion, 초기 계약 기간 5년. GF는 뉴욕 Malta(Fab 8)에 생산 능력을 증설해 TSMC의 CoWoS(Chip-on-Wafer-on-Substrate) advanced


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
작성: 2026-10-09 · Chase (Synopsys Staff Product Engineer, PrimeTime STA signoff · 파운드리 실무)
30초 요약
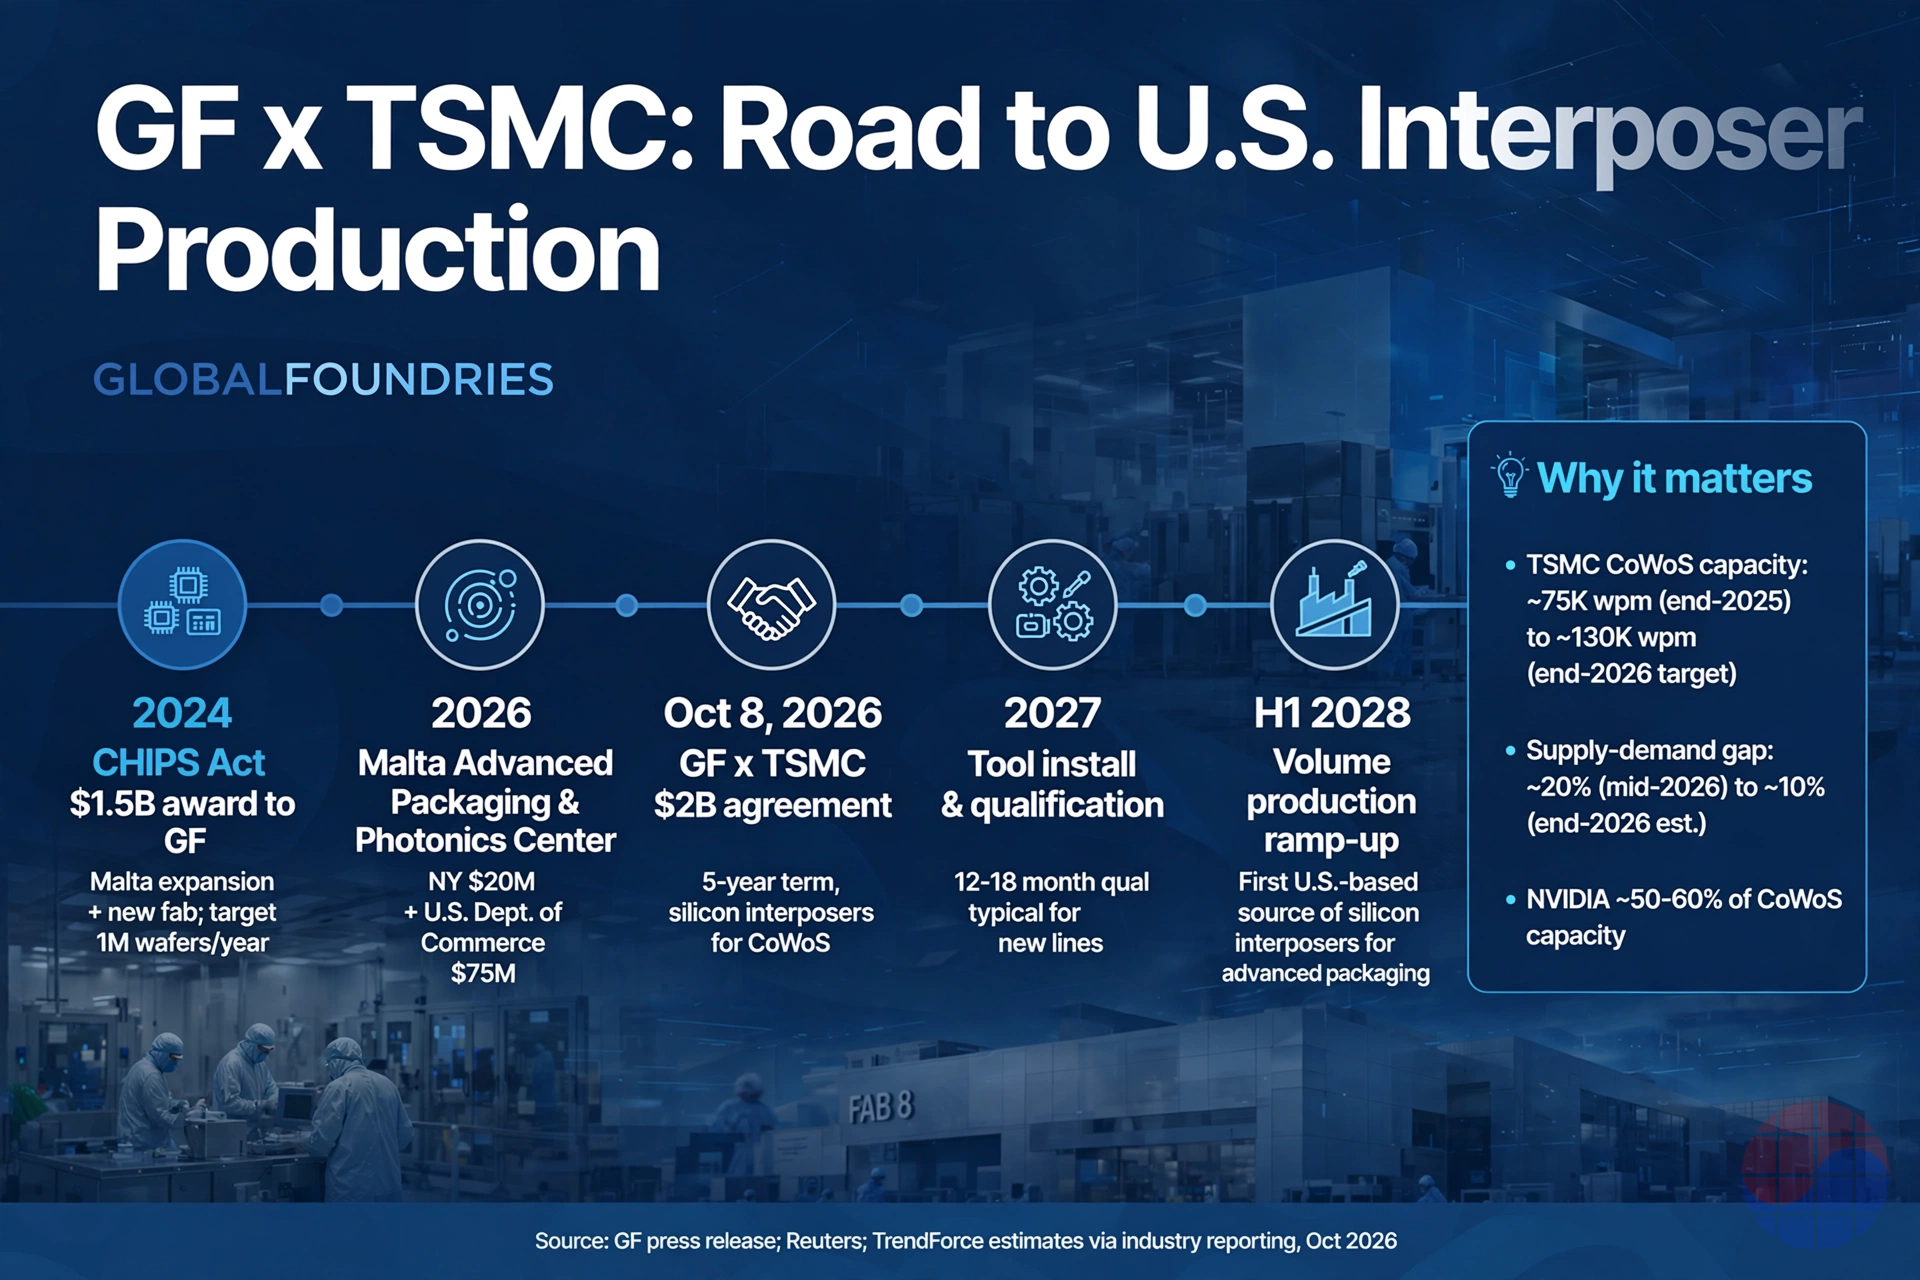
2026년 10월 8일, GlobalFoundries(GF)가 TSMC와 silicon interposer 공급 계약을 발표했다. 규모는 $2 billion, 초기 계약 기간 5년. GF는 뉴욕 Malta(Fab 8)에 생산 능력을 증설해 TSMC의 CoWoS(Chip-on-Wafer-on-Substrate) advanced packaging 생태계에 들어갈 silicon interposer를 제조한다. 양산 ramp-up은 2028년 상반기(H1 2028) 목표. GF에 따르면 이는 미국 최초의 advanced packaging용 silicon interposer 생산 거점이 된다(GF 공식 발표, Reuters).
이 뉴스가 중요한 이유: CoWoS는 TSMC의 2.5D packaging 기술로, GPU logic die와 HBM stack을 하나의 패키지로 묶는 AI 가속기의 표준 공정이다. 2024년 이후 AI 수요 폭증으로 TSMC의 CoWoS 캐파는 수급율 20%대까지 벌어졌던 supply-demand gap을 여전히 메우지 못하고 있고(exponentialindustry, temperature2), 2026년 7월 실적 발표에서 C.C. Wei CEO는 packaging capacity가 고객의 성장을 제한하고 있다고 직접 언급했다(techtimes). 파운드리 라이벌이던 GF가 TSMC의 supply chain 안으로 들어온 것은, advanced packaging이 병목의 중심이 됐음을 보여주는 상징적 사건이다.
발표 당일 GF 주가(GFS)는 프리마켓에서 약 +4% 상승했고, 장중에는 +6%에 육박했다는 보도도 있다(Reuters, Stocktwits).
Background
발표된 계약의 실체
GF가 2026년 10월 8일 발표한 내용의 핵심을 정리하면 다음과 같다(GF 공식 발표).
- 거래 구조: GF는 TSMC에 manufacturing service를 제공한다. 즉, TSMC가 고객(customer)이고 GF가 공급자다. GF는 TSMC의 advanced packaging(또는 logic) 파운드리를 대체하는 것이 아니라, CoWoS 패키지를 구성하는 하나의 component — silicon interposer — 를 만드는 역할이다.
- 장소: 뉴욕 Malta의 Fab 8에 capacity를 추가 증설한다.
- 금액·기간: Multi-year $2 billion agreement. 초기 기간 5년, 수요 증가에 따른 추가 증설 framework 포함.
- 일정: 2028년 상반기에 volume production ramp-up 시작 목표.
- 기술 범위: Silicon interposer는 물론, "embedded deep trench capacitor components"도 포함된다. 고성능 칩의 power efficiency 개선용이다.
- 미국 최초: 미국 기반(USA-based)의 advanced packaging용 silicon interposer 공급원으로는 처음이라고 GF는 밝혔다.
GF의 Ed Kaste(Senior Vice President, CMOS Business)는 발표문에서 advanced packaging이 next-generation AI 시스템의 performance·power efficiency·scale을 달성하는 데 점점 더 중요해지고 있다고 강조했다.
주의할 점: 물량(wafers per month)과 단가는 공개되지 않았다. $2B는 5년간의 계약 규모이고, 2028년 ramp-up 이전에는 실질 출하가 없다. 이 거래가 병목을 "지금" 해소하는 거래가 아니라, 2028년 이후의 공급 구조를 바꾸는 선제적 배치라는 점을 이해해야 한다.
왜 지금인가 — CoWoS 캐파의 실제 양상
TSMC의 CoWoS capacity 궤적은 가파르지만, 수요가 더 가파르다. TrendForce 추정과 업계 보도를 종합하면(exponentialindustry, temperature2, wiles-wiki):
| 시점 | TSMC CoWoS 월간 캐파 (wafers/month, 연말 run-rate) |
|---|---|
| 2024년 말 | ~35,000–40,000 |
| 2025년 말 | ~75,000–80,000 |
| 2026년 말 (목표) | ~120,000–140,000 |
2년도 안 돼 약 4배로 늘렸는데도 supply-demand gap은 2026년 중반 약 20%에서 연말 약 10%로 좁혀지는 수준에 그칠 것으로 보인다. Morgan Stanley 추정 기준으로 CoWoS 수요(단위)는 2025년 689,000 → 2026년 1,394,000 → 2027년 2,694,000으로, 2년 만에 거의 4배가 된다(gate.com). 캐파가 CAGR 80%를 넘게 성장하는데도 수요를 따라잡지 못하는 구조다.
특히 NVIDIA 하나가 2025~2026년 TSMC CoWoS 캐파의 50~60%를 점유하고 있다(wiles-wiki, aistockwire). 남는 40%를 AMD, Broadcom·Marvell 계열 custom ASIC, AWS Trainium 등이 나눠 갖는 형국이다. 2026년 7월 실적 콜에서 C.C. Wei CEO는 "packaging capacity가 너무 타이트해서 이제는 고객의 성장을 제한하고 있다(so tight that now it's limiting my customers' growth)"고 말했다(techtimes). TSMC의 대만 Chiayi(AP6/AP7) 패키징 허브가 세계 최대 규모로 확장 중이지만(exponentialindustry), 신규 라인은 12~18개월의 qualify 기간이 필요해 병목 해소 시점은 2027년 이후로 밀려 있다.
GF Malta(Fab 8)는 어떤 팹인가
Malta, New York의 Fab 8은 GF의 flagship 팹이다. 뉴욕주 발표에 따르면 현재 연간 약 400,000 웨이퍼를 생산하고 있고, GF는 Fab 8에 $15 billion 이상을 투자해 왔다(governor.ny.gov). 공정은 12nm FinFET부터 FD-SOI(22FDX), 28/40/55nm 등 mature node 중심이다.
Malta 캠퍼스의 확장 계획은 이미 크다:
- 미국 CHIPS and Science Act 직접 지원 $1.5 billion — GF의 미국 확장에 배정됨(tomshardware, GF 공식). 이 자금은 기존 Malta fab 확장과 Malta 캠퍼스 내 신규 fab 건설에 쓰이며, 두 프로젝트 합쳐 Malta 캠퍼스 capacity를 10년+ 기간에 걸쳐 3배, 연간 1 million wafers까지 늘리는 것이 목표다.
- 뉴욕주 Green CHIPS 프로그램의 수억 달러급 지원, 그리고 2026년 5월 보도에 따르면 추가로 약 $375 million의 연방 자금이 확보됐다(constructionreviewonline).
- GF의 전체 미국 투자 계획은 $16 billion 규모(Malta + Vermont Essex Junction)이며, Malta에는 New York Advanced Packaging and Photonics Center도 들어선다(뉴욕주 $20M + 미 상무부 $75M 지원, governor.ny.gov).
여기에 GF는 이미 advanced packaging 포트폴리오(2.5D/3D integration, interposer, wafer-to-wafer bonding, die-to-wafer bonding, TSV, assembly, test)를 미국과 싱가포르에서 운영하고 있다(bitcoinversus.tech). 즉, interposer를 찍을 공정 인프라는 GF 안에 이미 있었던 셈이다.
Deep Dive
Silicon interposer란 — CoWoS 2.5D 패키지 스택의 구조
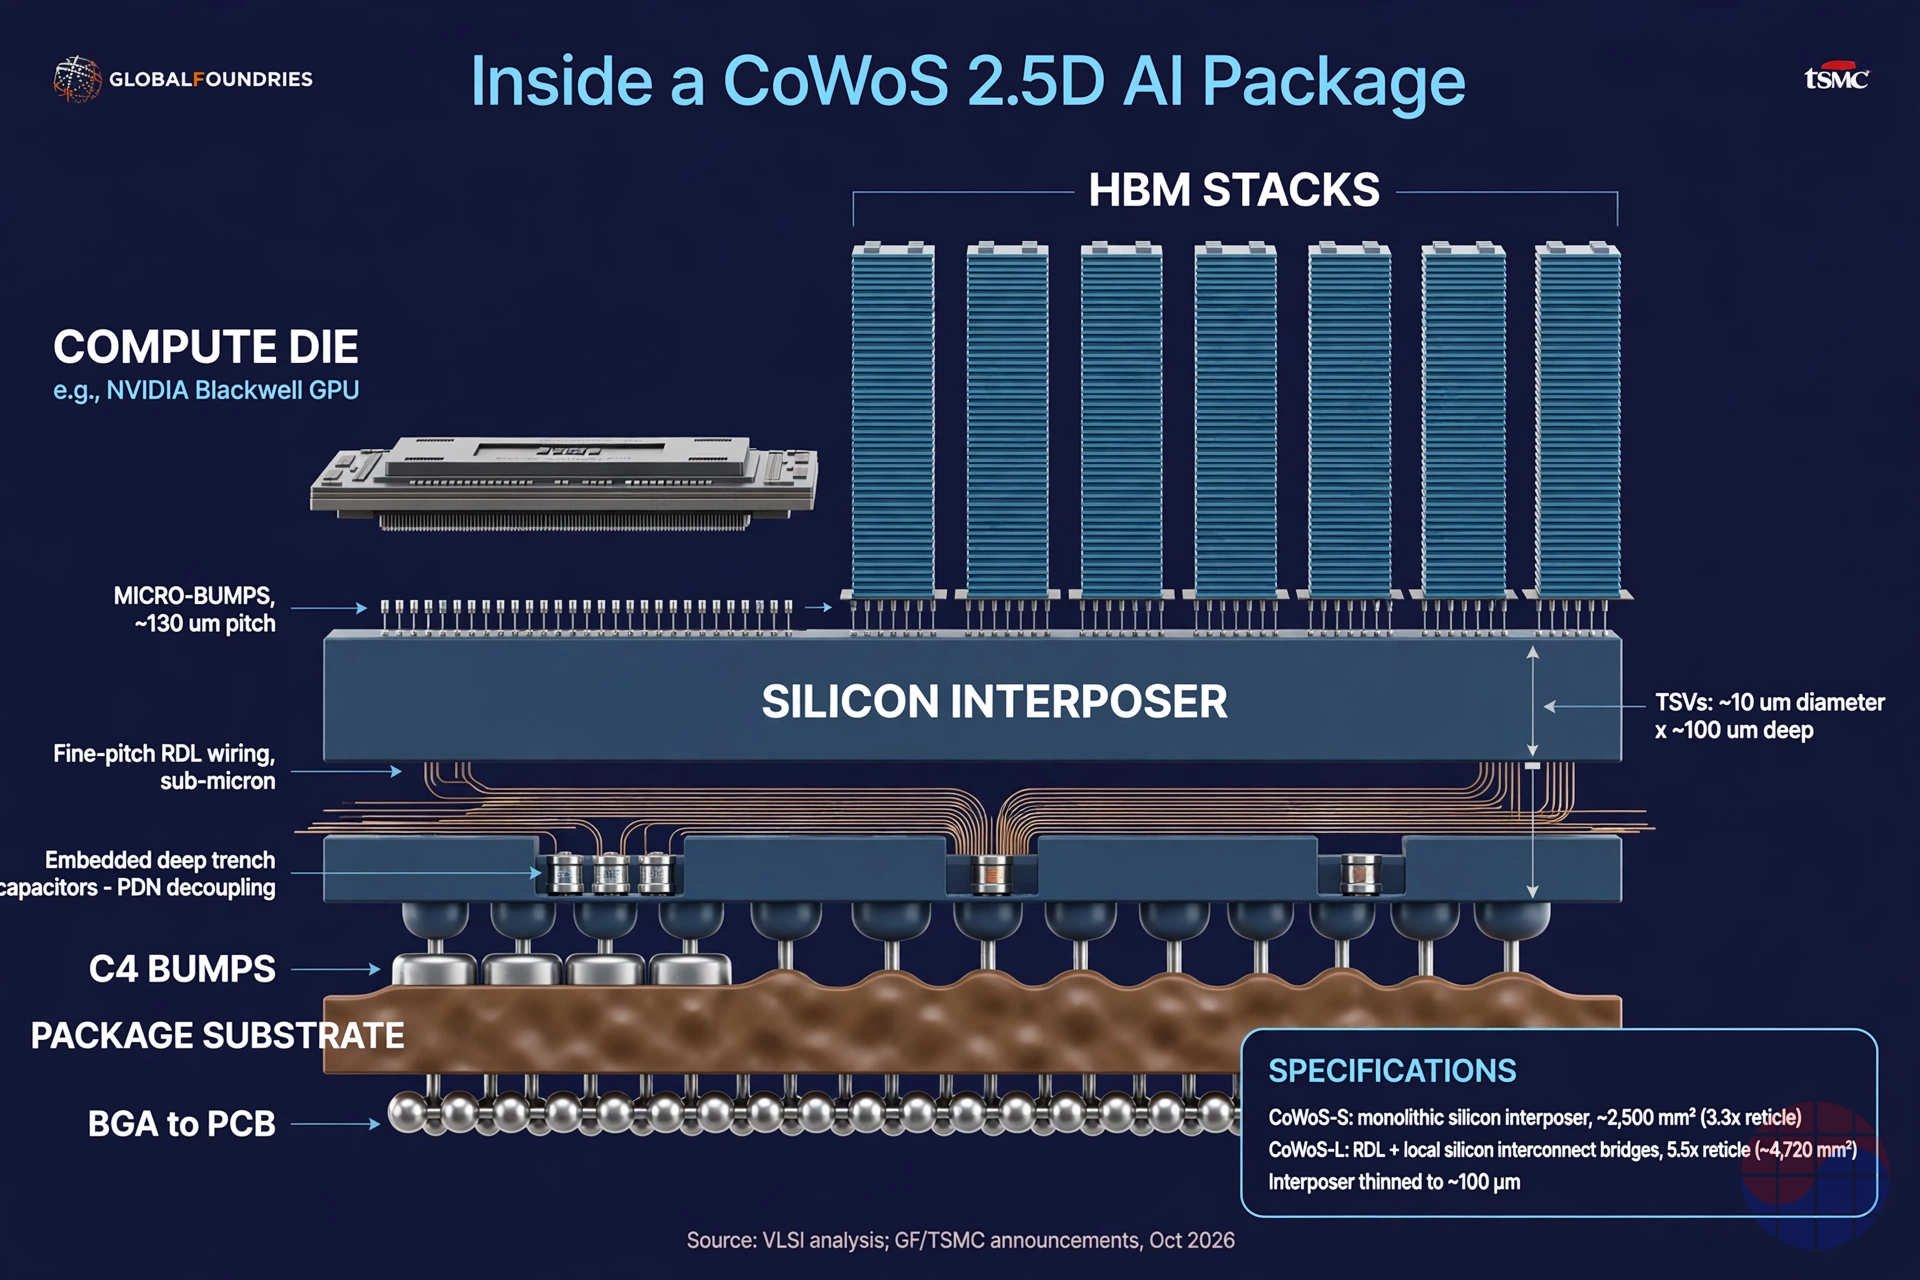
Silicon interposer를 이해하려면 CoWoS(Chip-on-Wafer-on-Substrate) 패키지 스택을 위에서부터 아래로 따라가면 된다.
- 최상단: chiplets (side-by-side). 하나의 GPU logic die(예: NVIDIA Blackwell의 compute die)와 그 옆에 여러 개의 HBM stack이 나란히 놓인다. 칩릿들은 micro-bump(범프 피치 ~130µm급)를 통해 interposer에 본딩된다.
- 중간: silicon interposer. 칩릿들 아래에 깔리는 대형 실리콘 기판이다. 표면에는 촘촘한 RDL(redistribution layer) 배선, 그리고 기판을 관통하는 TSV(through-silicon via) 가 있다. 2.5D interposer의 TSV는 통상 지름 ~10µm, 깊이 ~100µm급이고, interposer 자체는 thinning으로 ~100µm 두께까지 얇게 만든다(Amkor TSV 기술 문서). Logic die ↔ HBM stack 사이의 수천 개 신호는 이 interposer의 미세 배선을 타고 전달된다.
- 최하단: package substrate. Interposer는 C4 범프를 통해 organic package substrate에 본딩되고, substrate가 PCB와 연결된다.
핵심 포인트: interposer는 "패키지 안의 초미세 PCB"다. PCB trace가 수십 µm 단위라면, interposer 배선은 sub-micron급 BEOL 수준의 선폭으로 그어진다. HBM의 각 pin이 HBM3E에서 6.4 GT/s 이상, HBM4에서는 8 GT/s 이상으로 토글될 때, logic die와 메모리 stack 사이의 전기적 거리를 수백 µm 이내로 유지하지 않으면 bandwidth가 나오지 않는다. Interposer는 바로 이 "물리적 근접성"을 제공하는 부품이다. 메모리 세대가 올라갈수록 이 부담은 커진다. HBM3E(12-high, die당 24Gb 기준 stack당 288Gb)에서 HBM4(16-high, stack당 384Gb급)로 가면 stack당 pin 수와 per-pin data rate(8 GT/s 이상)가 함께 올라가, interposer가 감당해야 할 동시 스위칭 전류와 신호 무결성 마진이 동시에 악화된다. Interposer가 단순한 "배선판"이 아니라 SI·PI 설계의 최전선인 이유다.
CoWoS-S vs CoWoS-L — interposer가 커지는 이유
TSMC는 interposer 기술로 CoWoS의 세대 변천을 겪었다(exponentialindustry, webpronews).
| CoWoS-S | CoWoS-L | |
|---|---|---|
| Interposer base | Full silicon (monolithic) | RDL + local silicon interconnect (LSI) bridge |
| Wiring density | Ultra-fine (sub-micron) | Fine (at bridges) |
| 최대 패키지 크기 | ~2,500 mm² (약 3.3× reticle) | 5.5× reticle (약 4,720 mm²), 2026년 양산 |
| 대표 제품 | NVIDIA H100, AMD Instinct MI300 | NVIDIA Blackwell B200/GB200, Vera Rubin |
왜 -S에서 -L로 갔는가? Reticle limit 때문이다. 리소그래피 장비가 한 번에 노광할 수 있는 최대 영역(reticle, 32×26mm ≈ 832 mm²)을 stitching으로 이어 붙여도, monolithic silicon interposer는 대략 3.3× reticle(약 2,500~2,700 mm²) 를 넘기면 warpage와 crack 문제로 수율이 무너진다(webpronews). 그런데 AI 가속기는 더 커지고 싶다. NVIDIA Blackwell B200은 GPU die 2개 + HBM3E stack 8개를 한 패키지에 넣는데, 이게 3.3× reticle에 들어가지 않는다. Rubin은 interposer가 5.5× reticle 수준으로, 300mm 웨이퍼에서 겨우 7개의 패키지만 뽑히고 면적 활용률도 45%에 그친다(gate.com).
그래서 나온 해법이 CoWoS-L: 전체를 실리콘으로 만들지 않고, organic RDL interposer 위에 필요한 곳에만 작은 silicon bridge(LSI)를 박는 구조다. Bridge는 reticle limit 안에 들어가고, RDL은 panel급으로 크게 만들 수 있다. TSMC의 2026 Technology Symposium에서 5.5× reticle 버전의 수율이 98%를 넘었다는 경영진 발언이 보도됐다(webpronews). 로드맵은 2027년 9× reticle(7,700 mm²+), 2028년 9.5×, 그 뒤 14×까지 간다.
그렇다면 GF가 만드는 interposer는 어느 쪽인가? 공식 발표는 "silicon interposers for TSMC's CoWoS advanced packaging ecosystem"이라고만 하고 -S인지 -L용 silicon bridge인지는 명시하지 않았다. 하지만 "silicon interposer"라는 표현과 embedded deep trench capacitor 언급을 볼 때, CoWoS-S 스타일의 monolithic silicon interposer(또는 CoWoS-L의 LSI bridge용 silicon component) 생산을 GF가 맡는 것으로 읽힌다. 어느 쪽이든, 대형 실리콘 가공 + TSV + deep trench가 GF Malta의 공정 포트폴리오 안에 들어간다.
병목의 물리적 원인 — 왜 "웨이퍼가 아니라 패키지"가 막히는가
병목은 세 층위로 설명된다.
첫째, 캐파 산술의 왜곡. CoWoS 캐파는 보통 "wafers per month"로 발표되지만, interposer가 커질수록 12인치 carrier wafer에서 뽑을 수 있는 패키지 수가 급감한다. 5.5× reticle이면 7개. 즉, 동일한 wpm 숫자라도 effective capacity(실제 패키지 수) 는 interposer 크기에 반비례한다. 캐파 지표가 실제 공급 능력을 과대평가하는 구조다.
둘째, 공정 단계의 길이. Interposer 제조 자체는 front-end 팹에서 하는 일이지만, 그 뒤에 CoW(chip-on-wafer: 칩릿 본딩·thinning·mold), WoS(wafer-on-substrate: substrate 본딩·test) 단계가 이어진다. 어느 한 단계의 tool이 모자라도 전체 라인이 선다. 특히 large interposer의 warpage 관리는 carrier wafer 기반 공정으로 해결해야 하고(Amkor TSV 문서), test coverage도 wafer-level에서 확보해야 한다.
셋째, 집중도. TSMC는 leading-edge 2.5D CoWoS 캐파의 약 **95%**를 점유한다(exponentialindustry). ASE의 CoWoP, Amkor의 S-SWIFT/S-Connect가 overflow로 qualify 중이지만(wiles-wiki), AI 가속기용으로는 아직 first-time-at-scale의 yield ramp을 겪는 중이다. 즉, interposer를 찍을 수 있는 qualified 팹이 전 세계에 사실상 TSMC 자신뿐이었던 것이 병목의 근본 원인이었고, 이번 GF 계약은 그 "qualified 팹"을 하나 더 만드는 작업이다.
Embedded deep trench capacitor — 왜 굳이 언급했는가
발표문에서 GF가 interposer와 함께 명시한 "embedded deep trench capacitor components"는 그냥 장식이 아니다. AI 가속기의 TDP가 수백 W에서 1kW급으로 올라가면서, 패키지 PDN(power delivery network)의 impedance 관리가 PPA에 직접 영향을 준다.
원리는 이렇다. Logic die가 수십 A/ns급의 di/dt로 전류를 끌어당기면(supply noise), 패키지 PDN의 impedance peak에서 전압 강하(droop)가 발생한다. 이걸 막는 decoupling capacitor는 부하에 가까울수록 효과적이다. Interposer 안에 deep trench capacitor를 박아 넣으면 — trench 구조라 단위 면적당 capacitance density가 크다 — decoupling을 logic die 바로 밑 수백 µm 이내에 배치할 수 있다. Die-level decap보다 PDN loop inductance가 작고, discrete capacitor on substrate보다 훨씬 가깝다. 결과적으로 first-droop 억제 → IR drop 개선 → 같은 power envelope에서 더 높은 frequency(또는 같은 frequency에서 더 낮은 Vmin) 확보로 이어진다.
GF가 이 기술을 들고나올 수 있었던 배경에는 GF의 deep trench heritage가 있다. GF는 eDRAM용 deep trench capacitor를 45nm SOI 등에서 양산해 온 이력이 있는 회사다. 성숙 노드 팹에서 하던 일을 interposer에 이식한 셈이다. Interposer 제조는 leading-edge EUV가 필요 없다. 10µm급 TSV와 sub-micron급 RDL 배선은 mature node의 lithography와 BEOL 장비로 충분히 찍힌다. GF가 TSMC의 logic 파운드리를 넘보지 않고도 이 게임에 들어올 수 있었던 기술적 이유가 바로 여기에 있다.
Chase's Take
Interposer는 이제 PPA 방정식의 일부다
PrimeTime STA signoff를 하는 엔지니어의 관점에서 보면, interposer 시대의 timing closure는 die boundary에서 끝나지 않는다. Logic die와 HBM stack 사이의 die-to-die interface — NVIDIA든 AMD든 내부적으로는 UCIe 계열이든 proprietary D2D PHY든 — 는 interposer 배선의 insertion delay와 crosstalk를 timing budget에 반영해야 한다. Interposer RDL trace는 on-die wire보다 저항·커패시턴스 특성이 다르고, TSV는 수직 방향의 추가 기생성분을 만든다. 이 구간을 "zero-delay"로 가정하고 signoff를 때리면 silicon에서 깨진다.
내가 현장에서 보는 실무적 시사점은 두 가지다. 첫째, package-aware STA의 중요성이 커진다. PrimeTime 같은 signoff tool은 이미 S-parameter 기반의 package model을 받아들일 수 있지만, 실제로 interposer model까지 포함한 full-path signoff를 돌리는 디자인 하우스는 아직 많지 않다. 둘째, PDN co-design이다. 위에 설명한 deep trench decap이 interposer에 들어오면, die-level의 IR-drop signoff(RedHawk류)와 package PDN 해석을 분리해서 보던 기존 workflow로는 전체 그림이 안 나온다. Interposer decap의 위치·용량을 die의 power map과 함께 최적화해야 진짜 PPA가 뽑힌다. GF가 deep trench capacitor를 interposer에 내장하겠다고 명시한 것은, 이 공방전이 이제 패키지 레벨에서 벌어진다는 신호로 읽힌다.
GF의 선택은 "게임을 바꾸지 않고 판에 끼는" 최적 수다
솔직히 말하면, GF가 TSMC와 손잡은 이 딜에서 가장 영리한 부분은 자신의 약점을 드러내지 않은 점이다. GF는 2018년 7nm 개발을 중단한 이후 leading-edge logic 경쟁에서 완전히 빠져 있다. TSMC의 CoWoS 고객이 원하는 것도 GF의 7nm가 아니라, "TSMC 스펙대로 찍히는 interposer"다. Interposer는 mature node로 충분하고, GF Malta는 이미 그 장비들을 갖고 있다. GF 입장에서는 기존 fab의 utilization을 올리면서 AI supply chain의 티켓을 받는 것이고, TSMC 입장에서는 qualified capacity를 하나 더 확보하는 것이다. Win-win이 아니라 bottleneck-sharing에 가깝다.
또 하나 주목할 점은 금액의 성격이다. $2B/5년이면 연간 $400M 수준의 run-rate인데, 2028년 ramp-up 전에는 매출 기여가 없다. 시장이 +4%로 반응한 것은 당장의 실적이 아니라 "GF가 AI packaging supply chain의 qualified supplier가 됐다"는 지위 변화에 대한 repricing이다. 다만 물량·단가 미공개 상태이므로, 2028년 실제 수율과 TSMC의 allocation이 확인되기 전까지는 밸류에이션에 신중해야 한다.
Onshoring의 진짜 의미 — "미국 최초"라는 문구의 무게
GF는 Malta가 미국 최초의 advanced packaging용 silicon interposer 생산 거점이 될 것이라고 했다. 이 문구는 CHIPS Act의 정책 목표와 정확히 맞물린다. TSMC의 CoWoS 캐파 95%가 대만에 집중된 구조(exponentialindustry)는 지정학적 리스크 그 자체다. TSMC Arizona가 front-end를 미국으로 가져오고 있지만, advanced packaging의 미국 내 거점은 2028~2029년 이전에는 병목을 풀어주지 못한다는 분석이 지배적이었다(exponentialindustry). GF Malta의 2028년 H1 ramp-up은 그 타임라인과 정확히 일치한다.
다만 한 가지 검증이 필요한 부분: GF의 "first U.S.-based source"는 회사 측 주장이다. Intel의 EMIB/Foveros, Amkor의 미국 내 advanced packaging 투자 등도 존재한다. CoWoS ecosystem 한정으로는 맞는 말일 가능성이 크지만, "미국 내 advanced packaging 전체"로 확대 해석하면 틀릴 수 있다. 기사에서 이 구분을 흐리는 보도가 많으니 독자는 주의해야 한다.
Implications
1. TSMC의 CoWoS 병목은 2028년까지 구조적으로 이어진다. 2026년 말 120k~140k wpm, 2027년 말 ~200k wpm 목표에도 불구하고 수요 증가율이 더 빠르다. GF Malta의 ramp-up(2028년 H1)은 2028년 이후 수급 완화에 기여하는 첫 번째 "비(非)-TSMC 팹"발 공급원이 된다. 그 전까지는 ASE CoWoP·Amkor S-SWIFT의 overflow qualify 속도가 관건이다.
2. OSAT와 IDM의 경계가 흐려진다. 전통적으로 interposer는 TSMC가 in-house에서 찍었다. 이제 GF라는 foundry가 TSMC의 packaging supply chain에 component supplier로 들어왔다. 이는 Samsung의 I-Cube, Intel의 EMIB 진영에도 시사하는 바가 크다 — advanced packaging의 merchant 시장이 열리기 시작했다는 신호다. 앞으로 "interposer 전문 파운드리"라는 카테고리가 생길 수 있다.
3. 한국 업계에 주는 시사점. 직접적으론 SK hynix·Samsung의 HBM 사업에 중립적이다(메모리 스택 자체의 수요는 그대로다). 하지만 두 가지 각도에서 봐야 한다. 첫째, CoWoS 캐파가 곧 HBM 출하량의 상한이므로, interposer 공급 확대는 HBM 수요 실현률을 높이는 방향이다. HBM4(16-high, 24Gb die 기준 stack당 384Gb급)로 갈수록 stack당 bandwidth·pin 수가 늘어나 interposer의 SI/PDN 부담이 커지는데, deep trench decap 같은 기술이 이를 떠받친다. 둘째, 국내 후공정·장비 업체 관점에서는 TSV·micro-bump·wafer thinning 장비와 interposer용 검사(metrology) 수요가 미국 Malta로도 확대된다는 의미다. Camtek·Onto·Besi 같은 inspection/metrology 장비사가 packaging 라인의 필수 요소로 꼽히는 이유다(aistockwire).
4. 투자 관점의 체크포인트. GFS +4%는 지위 변화에 대한 repricing이지 실적 반영이 아니다. 확인할 것은 ① 2027년 중 tool install·qualify 진척, ② 2028년 H1 ramp-up 시 수율, ③ TSMC의 실제 allocation 물량이다. TSMC가 같은 날 발표한 2026년 3분기 매출 $46.71B(전년 대비 +50%)는 AI 수요의 강도를 재확인해 준다(Stocktwits).
5. 지정학. 미국 내 CoWoS용 interposer 생산 거점은 CHIPS Act $1.5B 지원의 연장선에 있다. Malta 캠퍼스의 Advanced Packaging and Photonics Center(뉴욕주 $20M + 상무부 $75M)와 함께, 미국은 "front-end(TSMC Arizona) + interposer(GF Malta) + OSAT(Amkor Arizona $7B 캠퍼스)"의 패키징 삼각편대를 갖추는 그림이다. 2028년이 분수령이다.
FAQ
Q1. Silicon interposer는 정확히 무엇인가요?
A. AI 패키지 안에서 GPU logic die와 HBM memory stack 아래에 깔리는 대형 실리콘 기판입니다. 표면의 미세 배선(RDL)과 기판을 관통하는 TSV를 통해 칩릿들을 초고속으로 연결하는 "패키지 안의 초미세 회로기판" 역할을 합니다. TSMC CoWoS 패키지의 핵심 부품입니다.
Q2. GlobalFoundries가 TSMC의 칩을 대신 만드는 건가요?
A. 아닙니다. GF는 TSMC의 logic 칩이나 패키징 전체를 만드는 게 아니라, CoWoS 패키지를 구성하는 부품 중 하나인 silicon interposer를 TSMC에 공급하는 manufacturing service 계약을 맺었습니다. TSMC가 고객이고, 최종 패키지 조립·통합은 TSMC가 합니다.
Q3. 왜 하필 GlobalFoundries인가요?
A. Interposer 제조에는 최첨단 EUV가 필요 없고, 성숙 노드의 리소그래피·BEOL·TSV·deep trench 공정으로 충분합니다. GF Malta(Fab 8)는 이미 그 장비와 deep trench capacitor 양산 이력을 갖추고 있어, TSMC 스펙에 맞는 interposer를 찍을 수 있는 몇 안 되는 qualified 팹 후보였습니다.
Q4. 이 계약이 AI 칩 부족을 바로 해소하나요?
A. 아닙니다. 양산 ramp-up은 2028년 상반기 목표이고, 물량·단가도 미공개입니다. 단기 병목(2026~2027년)은 TSMC 자체 증설과 ASE·Amkor의 overflow 대응에 달려 있고, GF Malta는 2028년 이후 공급 구조를 바꾸는 중장기 카드입니다.
본 글의 사실관계는 2026년 10월 8~9일 공개된 보도와 GF 공식 발표문을 기준으로 하며, 계약 물량·단가·TSMC의 실제 allocation 등 미공개 정보는 포함하지 않았습니다. 수치는 보도 원문에서 확인된 것만 사용했습니다.
관련 글