VLSI Korea
銅的最後抵抗:448G PAM6、PTFE 為何延後光轉換點
576 張 GPU 進一台機櫃的時代,真正的勝負是訊號完整性。448G PAM6、PTFE 基板、主動銅為銅多爭取 1~2 世代,把 CPO 經濟性推向 2028~2030 年交叉區間。


🆓 免費文章 · 任何人都可以免費閱讀
30 秒摘要
- AI 基礎設施爭論焦點總在 GPU 與 HBM。但 576 張 GPU 進一台機櫃的時代——NVIDIA Vera Rubin Ultra NVL576(預定 2027 年推出)——來臨,真正的勝負不是運算,而是 訊號完整性(signal integrity)。
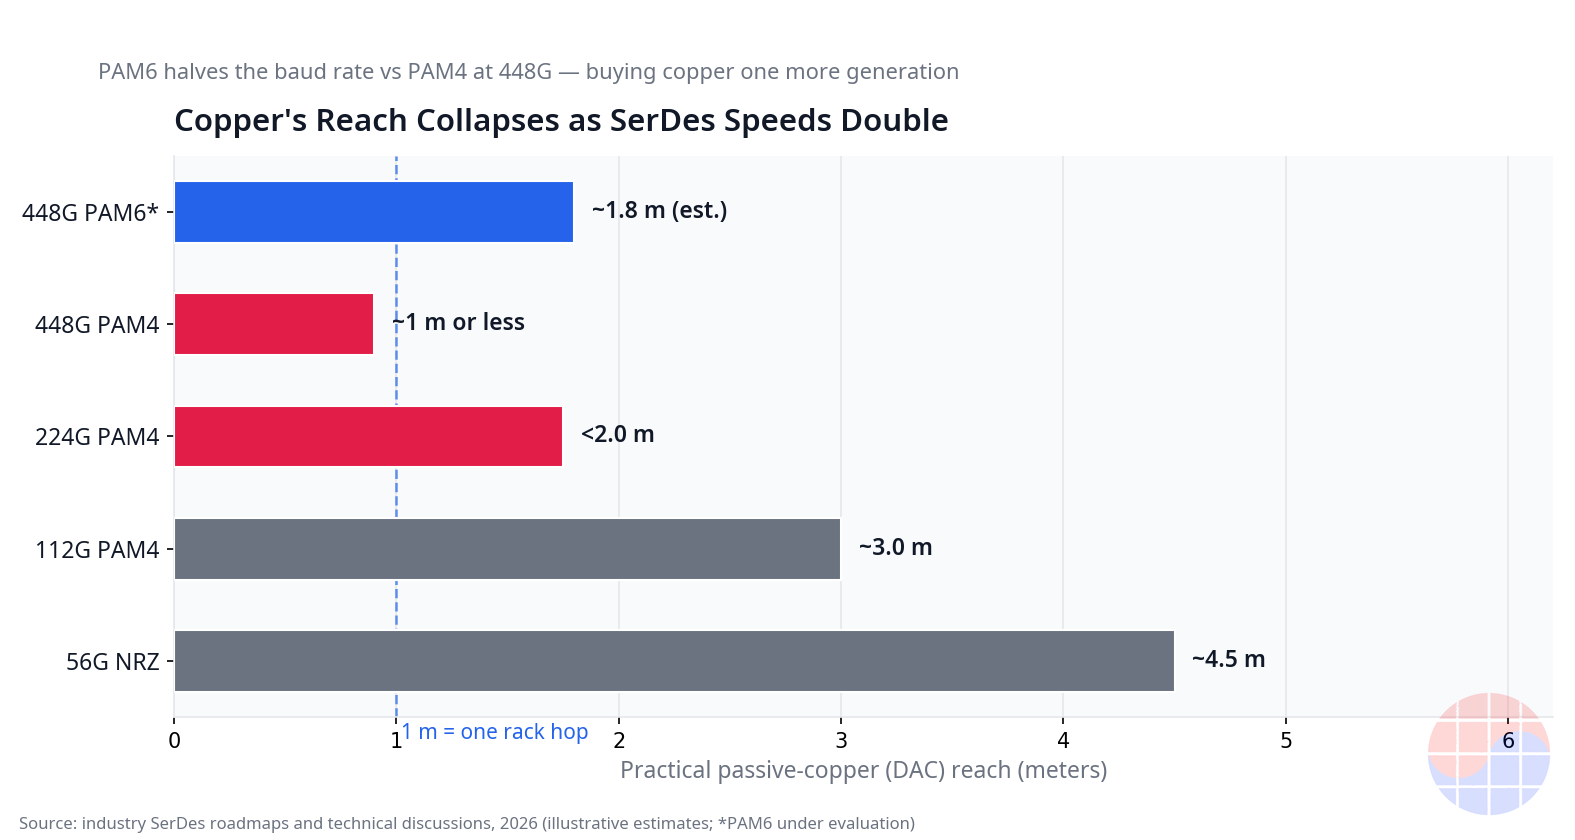
- 物理很冷酷。224G SerDes 被動銅纜(DAC)有效距離不到 2m,448G 估計 1m 以下(2026 年業界技術討論基準)。是集膚效應(skin effect)與 Nyquist 頻率定的極限。連一台機櫃都難以連接的距離。
- 因此業界選擇延長而非投降。救 448G 銅的三件武器——PAM6 調變、低損耗高頻基板材料 PTFE、高密度纜線組裝——齊聚 2026 年 10 月 OCP Global Summit 的 NVIDIA MGX 生態系展覽。
- 光陣營也踩油門。MACOM 的 448G/lane PAM4 驅動器(120GHz 以上 RF 頻寬,2026 年 3 月發表)、Keysight、NTT Innovative Devices、Lumentum 的 224GBaud PAM4 基礎 448G 光傳輸展示(OFC 2025)、TSMC COUPE 的 2026 年 CoWoS 基礎 CPO 整合目標是代表。
- 但本文核心論點只有一個。CPO 量產門檻不是光子學本身,而是測試處理量。晶圓級 PIC 測試、雙面探測(double-sided probing)、光纖貼合(fiber attach)決定量產 ramp 斜率。
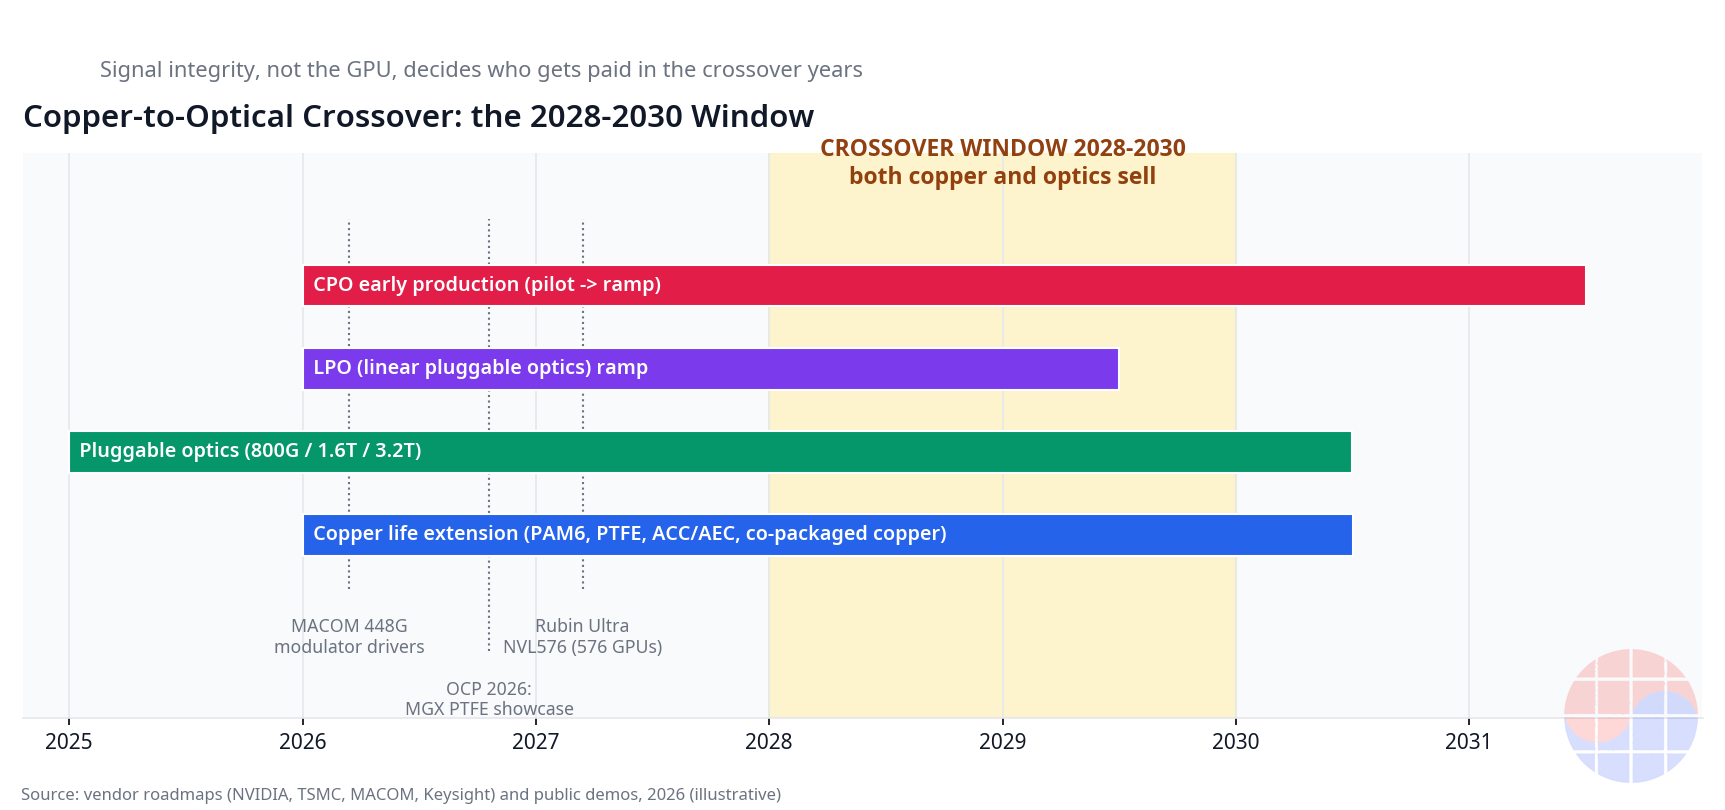
- 結論:銅到光的經濟轉換點(crossover)正被推向 2028~2030 年的「交叉區間」。在這個區間賺錢的不是 GPU 公司,而是 救活訊號的公司——SerDes、低損耗材料、主動銅、光測試設備陣營。
Background:機櫃即電腦的時代
2020 年資料中心單台機櫃平均電力是 8.2kW。2025 年 NVIDIA GB200 NVL72(72 張 GPU)以每櫃 132kW 拿下「史上最高電力伺服器」稱號。路線圖不停。經 Rubin NVL144(2026 年),Rubin Ultra NVL576(2027 年) 在一台機櫃放入 576 張 GPU。是 4 個 pod、每 pod 18 個 blade、每 blade 8 張 GPU 的結構。業界分析(2026 年)認為這台機櫃峰值電力將達 MW 等級。
同時推論架構也在變。把讀提示的 prefill(運算密集)與逐一抽 token 的 decode(記憶體頻寬密集)分離配置到不同 GPU 群的 disaggregated inference,成為 2026 年標準設計語言。NVIDIA Dynamo、AWS SageMaker HyperPod 2026 年更新、各種推論堆疊都朝這方向。prefill 節點算的 KV 快取以 RDMA 交給 decode 節點的結構,機櫃內與機櫃間資料量爆炸增加。
再疊 SerDes 路線圖。從 56G NRZ 到 112G PAM4,再到 224G PAM4(IEEE 802.3dj 標準化進行中)。下一個是 448G。經驗法則單純。速度翻倍,銅距離約減半。因為訊號集中導體表面的集膚效應損失隨頻率上升陡增,定頻率上限的是綁在調變方式的 Nyquist 頻率。
整理來說,AI 基礎設施現在處於三波同時撞擊點。(1)每櫃 GPU 數暴增,(2)prefill/decode 分離導致 fabric 頻寬暴增,(3)SerDes 速度 doubling 導致銅距離崩潰。這個交點上,「GPU 下一個瓶頸是什麼」的答案就是訊號完整性。
還要疊 fabric 雙重結構。GPU 直接綁的 scale-up(NVLink)是今天銅的領土。綁機櫃的 scale-out(Ethernet、InfiniBand)已是光的領土。224G 世代銅能撐,是因 scale-up 距離被關在機櫃內。但 576 GPU 機櫃與多櫃 NVLink 域開啟,scale-up 距離也拉長。銅領土被光領土侵蝕的點——本文經濟學從那條邊界開始。
Deep Dive
1. 銅撐住的方法:三件武器
銅要在 448G 存活,必須贏通道損失戰。業界拿出的武器有三。
第一,調變:認真研討 PAM6。以 PAM4 傳 448G,baud rate 是 224GBaud,Nyquist 頻率 112GHz。同樣 448G 以 PAM6 送,約 149GBaud,Nyquist 約 74.5GHz 下降。通道損失隨頻率比例增,降低 baud rate 對銅通道是直接損失削減。代價也明確。電平從 4 個增至 6 個,訊噪比(SNR)裕度減,FEC(forward error correction)與 DSP 負擔增。尤其強 FEC 增加延遲,scale-up fabric 延遲就是 GPU 閒置時間。PAM6 是「減損失、讓一點延遲」的交易。Keysight 在 2025 年 4 月新聞稿表示「448Gbps 初期 R&D 階段正探索包括 PAM4、PAM6、PAM8 的多種調變方式」。也就是 448G 銅調變方式尚未定。未定就是機會。標準固化前打開 1~2 世代設計窗口。
第二,材料:PTFE。在 224G/448G 通道,PCB 走線本身比連接器或纜線占通道損失更大比重。一般 FR-4 介電損失係數(Df)難以把 100GHz 等級訊號送數十 cm。介電常數(Dk)定訊號速度與阻抗,損失係數(Df)定漏成熱的能量比例。兩者越低越有利高頻,同時降低兩值的代表是氟樹脂系低損耗層壓板 PTFE。替代是 Megtron 等級低損耗 FR-4 系,但業界共識是超過 224G 到 448G,非 PTFE 等級材料難以滿足通道預算。2026 年 10 月 OCP Global Summit NVIDIA MGX 生態系展覽一軸是 「NVLink PTFE Board」 具象徵性。PCB、先進材料、連接器、纜線組裝 13 家列名的這個展覽,宣告 AI 基礎設施競爭已超越 GPU 擴展到基板材料與互連。基板材料選擇成為機櫃設計競爭力一部分。
第三,連接器與纜線:把銅拉近晶片。同展另一軸是 「Ultra Dense Interconnect Cable Cartridge」。概念單純而強大。以高密度 near-chip 連接器最小化 PCB 走線長度,以 twinax 基礎高密度纜線把銅直接拉到晶片附近。稱為 co-packaged copper。是繞過通道損失主犯 PCB 走線的發想。Molex 的 Impress co-packaged copper 解決方案支援 224Gbps PAM4,正朝 336G、448G 開發。再加上 主動銅(ACC/AEC) 延長 reach。在纜線兩端放 retimer、redriver DSP 多撐數 m,代價是多耗電。是付電買銅壽命。與被動銅以「0W 新增」美德撐住的哲學完全相反,但計算是與光模組 DSP 電力相比仍可能便宜。
這個延長策略並非虛妄。Alchip 與 Synopsys 在 2026 年 9 月共同發表,以系統級最佳化解 224Gbps SerDes 速度 scale-up 互連的 die edge 擁擠(escape routing)與封裝 breakout 問題,並表示此方法論是可擴展到 448G SerDes 的基礎。銅陣營手上還有牌。
2. 光陣營反擊:448G 光傳輸已出實驗室
銅撐住期間,光不會等。
Keysight、NTT Innovative Devices、Lumentum(2025 年 4 月,OFC 2025) 以 224GBaud PAM4 光技術成功展示 448Gbps 資料傳輸。以 Keysight M8199B 任意波形產生器 2 台與 NTT 頻域交錯器做 448Gbps 電訊號,以 Lumentum 的 InP EML(外部調變雷射)光傳輸。同硬體也展示 240GBaud PAM4 生成。目標明確。是高能效的 3.2T 光介面。
MACOM(2026 年 3 月 17 日,OFC 2026) 發表 448G/lane PAM4 調變器驅動器 2 種——MAOM-025408(Mach-Zehnder 驅動器)與 MAOM-022404(EML 驅動器)。兩產品都提供 超過 120GHz 的 RF 頻寬,支援矽光子、EML、TFLN 調變器。是為加速 1.6T 與 3.2T 光收發器市場進入的零件。光的每通道速度到達與銅下一代相同的 448G,意味兩陣營在相同 SerDes 物理上交戰。
中間地帶也開啟。LPO(linear pluggable optics) 是拿掉 DSP 以線性直接驅動降電力的可插拔光模組。維持既有可插拔生態系(現場可換、供應鏈成熟)只削電力的妥協。DSP 占光模組電力大比重,把它移給交換器 ASIC 端或以線性鏈替代,可大幅降模組電力。若 CPO 是「把光引擎放進封裝」的革命,LPO 是「保留可插拔但降電力」的改良。革命延遲區間改良賺錢,是本文一貫主張。
還有 CPO(co-packaged optics) 大圖。TSMC COUPE(Compact Universal Photonic Engine) 以 SoIC-X 晶片堆疊把電晶粒(EIC)直接疊在光子晶粒(PIC)上。路線圖是 2025 年 small-form-factor 可插拔 qualification,2026 年 CoWoS 基礎 CPO 整合。TSMC 提出數字是 5~10 倍電力效率改善與 10~20 倍低延遲。NVIDIA(GTC 2025) 以 Quantum-X、Spectrum-X CPO 網路交換器迎戰。以 micro-ring modulator 代替 Mach-Zehnder 提高密度,主張較既有網路 3.5 倍電力效率、10 倍韌性。三星電子也在 OFC 2026 提 2027 年光引擎、2029 年 turnkey CPO 服務,加入戰線。
甚至可插拔陣營也打出最後一張牌。OCP 2026(2026 年 10 月) NVIDIA 與 Cisco 發表的 USFP(Ultra-Dense Small Form Factor Pluggable) 是 400G/lane、每模組 16 通道(6.4T)、未來擴展 32 通道(12.8T)的新規格。前面板密度到極限,重新設計模組本身。值得注意 USFP 仍堅持「可插拔」。連 NVIDIA 當下也打開「去光,但 CPO 慢慢來」的中間路。
3. 真正的門檻是測試
CPO 爭論中最被低估的變數在此。不是光子晶粒物理。測試處理量(throughput)。
TSMC 封裝領導層在公開場合點名 CPO 量產三大難題。晶圓級測試、光纖陣列單元(fiber array unit)整合、高速光封裝組裝。三者中第一個勒住 ramp 脖子。
理由是結構性。COUPE 式堆疊中貼電晶粒與光子晶粒的混合鍵合 無法 rework。把不良引擎疊到數百萬至數千萬韓元交換器、GPU 封裝後才知不良,良率會碎裂。因此鍵合前必須分別測試兩晶粒,以引擎單位做光學探測。引擎良率是 EIC 良率 × PIC 良率 × 鍵合良率 × 耦合良率的乘積。是乘法詛咒。
📩 在持續關注這個主題嗎?
財報·報告·HBM供需的後續分析,每天10:30(KST)寄到您的信箱。 免費訂閱 →
測試設備業界已在動。FormFactor 與 Advantest 為矽光子、CPO 晶圓級測試單元開發締結戰略聯盟。骨幹是 9 軸奈米精密自動光對準、Advantest V93000 ATE 與 FormFactor Velox 探針站整合。FormFactor 預測 2026 年 CPO 相關營收將「大幅超過(significantly exceed)」2,000 萬美元(2026 年第 2 季財報電話)。Teradyne 在 OFC 2026 推出 Photon 100。是對應 COUPE 式堆疊——電接點在一面、光埠在另一面結構——的 雙面探測 設備。
整理來說,CPO 量產 ramp 斜率不是由「光子學做不做得到」定,而是 「測試設備鋪多快」 定。測試處理量就是 CPO 出貨量。這句話在後面投資意涵再次登場。
4. 交叉經濟學:轉換點不在技術,而在曲線交點
技術轉換歷史教一件事。贏的不是「更好的技術」,而是 「每 bit 成本、電力曲線先交叉的一方」。
把銅曲線往下壓的力量:PAM6(降 baud rate 減通道損失)、PTFE(減介電損失)、ACC/AEC(付電延長 reach)。把光曲線往下壓的力量:LPO(去 DSP 減電力)、CPO(封裝整合革新電力、密度)、USFP(可插拔密度革新)。
這裡核心問題。若銅在 448G 世代多撐 1~2 世代,會發生什麼? 答:光的經濟轉換點(crossover)往後移。CPO 變得「比銅便宜且高能效」的時點移向 2028~2030 年 「交叉區間」。這個區間是「兩者都賣」的區間。是銅陣營最後收穫期,也是光測試設備黃金期。LPO 是這個區間的外卡。維持可插拔生態系削電力,可能比 CPO 先提前交叉。
反論:「CPO 會更快來」陣營的論據
為公平,整理反方論據。
第一,電力。每櫃數百 kW、不久 MW 等級時代,互連吃的電力比重不可忽視。像 ACC/AEC「付電買銅」的交易反覆,某瞬間光在電力基準勝出。若 CPO 5~10 倍電力效率主張(TSMC)接近事實,電力是 CPO 最強武器。
第二,密度。576 張 GPU 放一櫃,前面板物理面積撞極限。若 USFP 等可插拔革新也不足,把光引擎放進封裝的 CPO 成唯一答案。NVIDIA 在 OCP 2026 以「以 CPO 基礎 NVLink fabric 連接 576 張 GPU」架構預覽 Rubin Ultra,是這個論據頂點。
對反論的反論。路線圖不是量產。CPO 在「做得到」與「以良率印出來」之間有 測試峽谷。而且連 NVIDIA 也同時打出 USFP 可插拔牌,意味他們也知道轉換區間長度。不是說 CPO 早期論錯,而是 早期論的時鐘必須對準測試處理量重調。
Chase's Take
用 PrimeTime 做過 signoff 的工程師會對這句點頭。「沒有覆蓋率的 timing pass 不能 tapeout。」
CPO 也完全相同。不是光子晶粒物理問題。「以測試證明的引擎良率」決定量產。CPO 的 signoff 是雙重結構。在電訊號完整性 signoff 上再疊光學良率 signoff。沒有測試覆蓋率的光 I/O 等於沒做 timing closure 的 netlist。不能出貨。是 tapeout 文法成為封裝文法的瞬間。
以 MBA 眼睛看,這是 交叉經濟學 教科書案例。贏家不是「最先進技術」,而是「吃轉換區間現金流者」。銅延長 1~2 世代是 SerDes/DSP、PTFE 層壓板、主動纜線業界最後超級循環。CPO 測試設備是光轉換的鐵鍬與鋤頭(picks and shovels)。這個區間的經濟租(economic rent)歸 救活訊號的公司,不是 GPU 公司。投資人與設計者該看的不是 GPU 路線圖下一章,而是訊號完整性的損益平衡點。
Implications:投資與經營意涵
給投資人。
- 銅延長受惠。SerDes IP/DSP、retimer、主動纜線、低損耗材料(PTFE 層壓板)。催化劑是 448G PAM6 標準化走向。若 PAM6 固化,銅壽命多一世代。
- 光測試設備。CPO ramp 領先指標且直接受惠。測試處理量就是 CPO 出貨量,測試單元稼動率與設備訂單比 CPO 本體先動。
- CPO 本體。2028 年前的積極押注有在「交叉區間」資本被綁的風險。LPO 作為中間地帶外卡有獨立追蹤價值。
給設計者與經營者。448G 通道設計必須從架構初期反映距離 1m 假設。PCB 堆疊與材料(PTFE 等)選擇不再是後順位決定,而是機櫃競爭力一部分。CPO 採用路線圖先行條件不是「確保光引擎」,而是 「確保測試供應鏈」。
韓國視角。2026 年是韓國 AI 基礎設施元年等級。國家 AI 運算中心(三星 SDS 聯盟,科技資訊通信部 2026 年 5 月發表——總 2.5 兆韓元規模,到 2028 年導入 AI 半導體 1.5 萬張目標)、三星春川模組化 AIDC(2026 年 7 月報導——NVIDIA Blackwell GPU 收容設計,2027 年 10 月完工目標)、SK-AWS 蔚山(103MW,GPU 約 6 萬張,2029 年完工目標)、Naver 各世宗(最大 270MW)。AI 資料中心特別法(2026 年 5 月國會處理)也加速非首都圈建設。
韓國暫時是「進口、建設機櫃」立場,但機會正在那點。Blackwell、Rubin 等級機櫃要求的高頻對應——高多層 PCB 低損耗材料應用、高密度纜線組裝、訊號完整性驗證——是「交叉區間」直接受惠領域。銅多撐 1~2 世代,也意味韓國互連供應鏈在光轉換前爭取做現金流的時間。如何用這段時間,是下一個 5 年的分岔。
FAQ
Q1. PAM6 為何有利 448G 銅? 以 PAM4 送 448G 需要 224GBaud,以 PAM6 約 149GBaud 即可。baud rate 降低,Nyquist 頻率下降,隨頻率比例的通道損失(集膚效應、介電損失)減少。代價是訊號電平增至 6 個,SNR 裕度減,FEC 與 DSP 負擔增。2026 年現在 448G 銅調變方式業界討論中,尚未確定。
Q2. PTFE 基板為何突然重要? 在 224G/448G 通道,PCB 走線本身比連接器、纜線占通道損失更大比重。PTFE 是氟樹脂系低損耗高頻層壓板,以低介電常數(Dk)與低損失係數(Df)大幅減少 100GHz 等級訊號介電損失。2026 年 10 月 OCP Global Summit NVIDIA MGX 生態系展覽出現「NVLink PTFE Board」,顯示基板材料選擇已成 AI 機櫃設計競爭力一部分。
Q3. LPO 與 CPO 差異是什麼? LPO(linear pluggable optics)是拿掉 DSP 以線性直接驅動降電力的可插拔光模組。是維持既有可插拔生態系(現場可換、成熟供應鏈)的改良案。CPO(co-packaged optics)是把光引擎直接放進交換器、GPU 封裝的方式,電力、密度革新大,但晶圓級測試與光纖貼合等量產難題大。
Q4. CPO 何時正式量產? TSMC COUPE 目標 2026 年 CoWoS 基礎 CPO 整合,NVIDIA、三星也公開 CPO 路線圖。但混合鍵合無法 rework 的特性下,晶圓級測試與雙面探測、光纖貼合處理量決定量產 ramp。考量測試設備(FormFactor、Advantest、Teradyne 等)普及速度,正式訂單看 2028 年後較合理。
本文距離、電力數字與時點為 2026 年 10 月基準公開資料與業界技術討論基礎的估計,實際產品規格與量產時程可能依業者不同。
Sources
- MACOM, "Two New 448G per Lane Drivers for 3.2T Data Center Connectivity" (2026-03-17, 官方新聞稿)
- Keysight·NTT Innovative Devices·Lumentum, "448 Gbps Data Transmission" joint demo (OFC 2025, 2025-04-02, 官方新聞稿)
- Alchip·Synopsys, "Address Scale Up and Out Bandwidth Constraints" (2026-09-23, 共同新聞稿)
- FormFactor·Advantest, silicon photonics wafer-level test cell 戰略聯盟 (共同發表)
- NVIDIA OCP Global Summit 2026 發表: MGX 1.2 貢獻, Vera Rubin Ultra 預覽, USFP(NVIDIA·Cisco)
- 江原日報, "三星在春川建 AI 資料中心" (2026-07-06)
- 亞洲經濟, "國家人工智慧運算中心業者三星 SDS 聯盟確定" (2026-05-11)
相關文章
- 光可能比 GPU 先贏:AI 互連新創
- Daily Silicon: SK 海力士 CPO、HBM: AI 半導體訂單 979 億美元
- Daily Silicon: NVIDIA 7,100 億美元: HBM、CPO、TSMC 供應鏈
- 當晶圓即電腦 ⑤: I/O 與記憶體牆
- 記憶體牆下一個是互連牆嗎:AI 封裝成為系統工程的理由
📩 今天錯過的分析,明天早上寄到您的信箱
每天10:30(KST)Daily Silicon與財報·機構報告核心解讀搶先送達。訂閱後可選擇韓語/英語/日語新聞通訊,中文深度分析每日在網站更新。
免費訂閱 →
免費 · 無垃圾郵件 · 隨時退訂