VLSI Korea
웨이퍼가 곧 컴퓨터가 될 때 ⑤: I/O와 메모리 월
웨이퍼를 하나의 컴퓨터로 만들면 내부 데이터 이동은 비약적으로 빨라진다. 대신 계산 자원은 면적에 비례해 늘고 외부 접점은 둘레에 묶인다. WSE-3의 21 PB/s SRAM, 214 Pbit/s 패브릭과 1.2 Tbit/s 시스템 I/O 사이의 간극은 웨이퍼 스케일의 장점이자 설계 제약이다.


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
핵심 주장: 웨이퍼 스케일의 I/O 문제는 포트 몇 개를 더 붙이는 문제가 아니다. 계산은 면적을 먹고 자라지만 외부 연결은 둘레에 갇히므로, 아키텍처가 외부 트래픽 자체를 줄이지 못하면 큰 웨이퍼가 오히려 더 비싼 데이터 대기실이 된다.
1. 웨이퍼를 키울수록 가장자리는 상대적으로 작아진다
정사각형 실리콘의 한 변을 L이라고 놓자. 코어와 SRAM을 배치할 수 있는 면적은 L²에 비례하고, 패드나 커넥터가 접근할 수 있는 외곽선은 4L에 비례한다. 한 변을 두 배로 늘리면 계산 자원은 이상적으로 네 배가 되지만 가장자리 길이는 두 배만 된다. 원형에 가까운 웨이퍼도 결론은 같다. 면적은 길이의 제곱, 둘레는 길이의 일차식으로 커진다.
물론 실제 WSE는 외곽선에만 모든 신호를 몰지 않는다. 재배선층과 수직 전력 공급, 패키지 보드, 커넥터가 면 전체를 활용한다. 그래도 실리콘 밖으로 나가는 고속 신호는 결국 PHY, 클록, 전력, 열과 패키지 escape routing의 예산을 먹는다. 코어 수처럼 단순 복제하기 어렵다. 이것이 perimeter I/O wall의 정확한 의미다.
이 법칙은 Cerebras만의 약점이 아니다. monolithic wafer, chiplet-on-wafer, 대형 interposer 모두 크기가 커질수록 내부 배선 밀도와 외부 포트 밀도의 증가율이 갈라진다. 그래서 웨이퍼 스케일의 첫 번째 설계 명령은 외부 링크를 빠르게 만들라는 것이 아니라 가능한 한 데이터를 밖으로 내보내지 말라는 것이다.
2. 21 PB/s, 214 Pbit/s, 1.2 Tbit/s는 같은 대역폭이 아니다
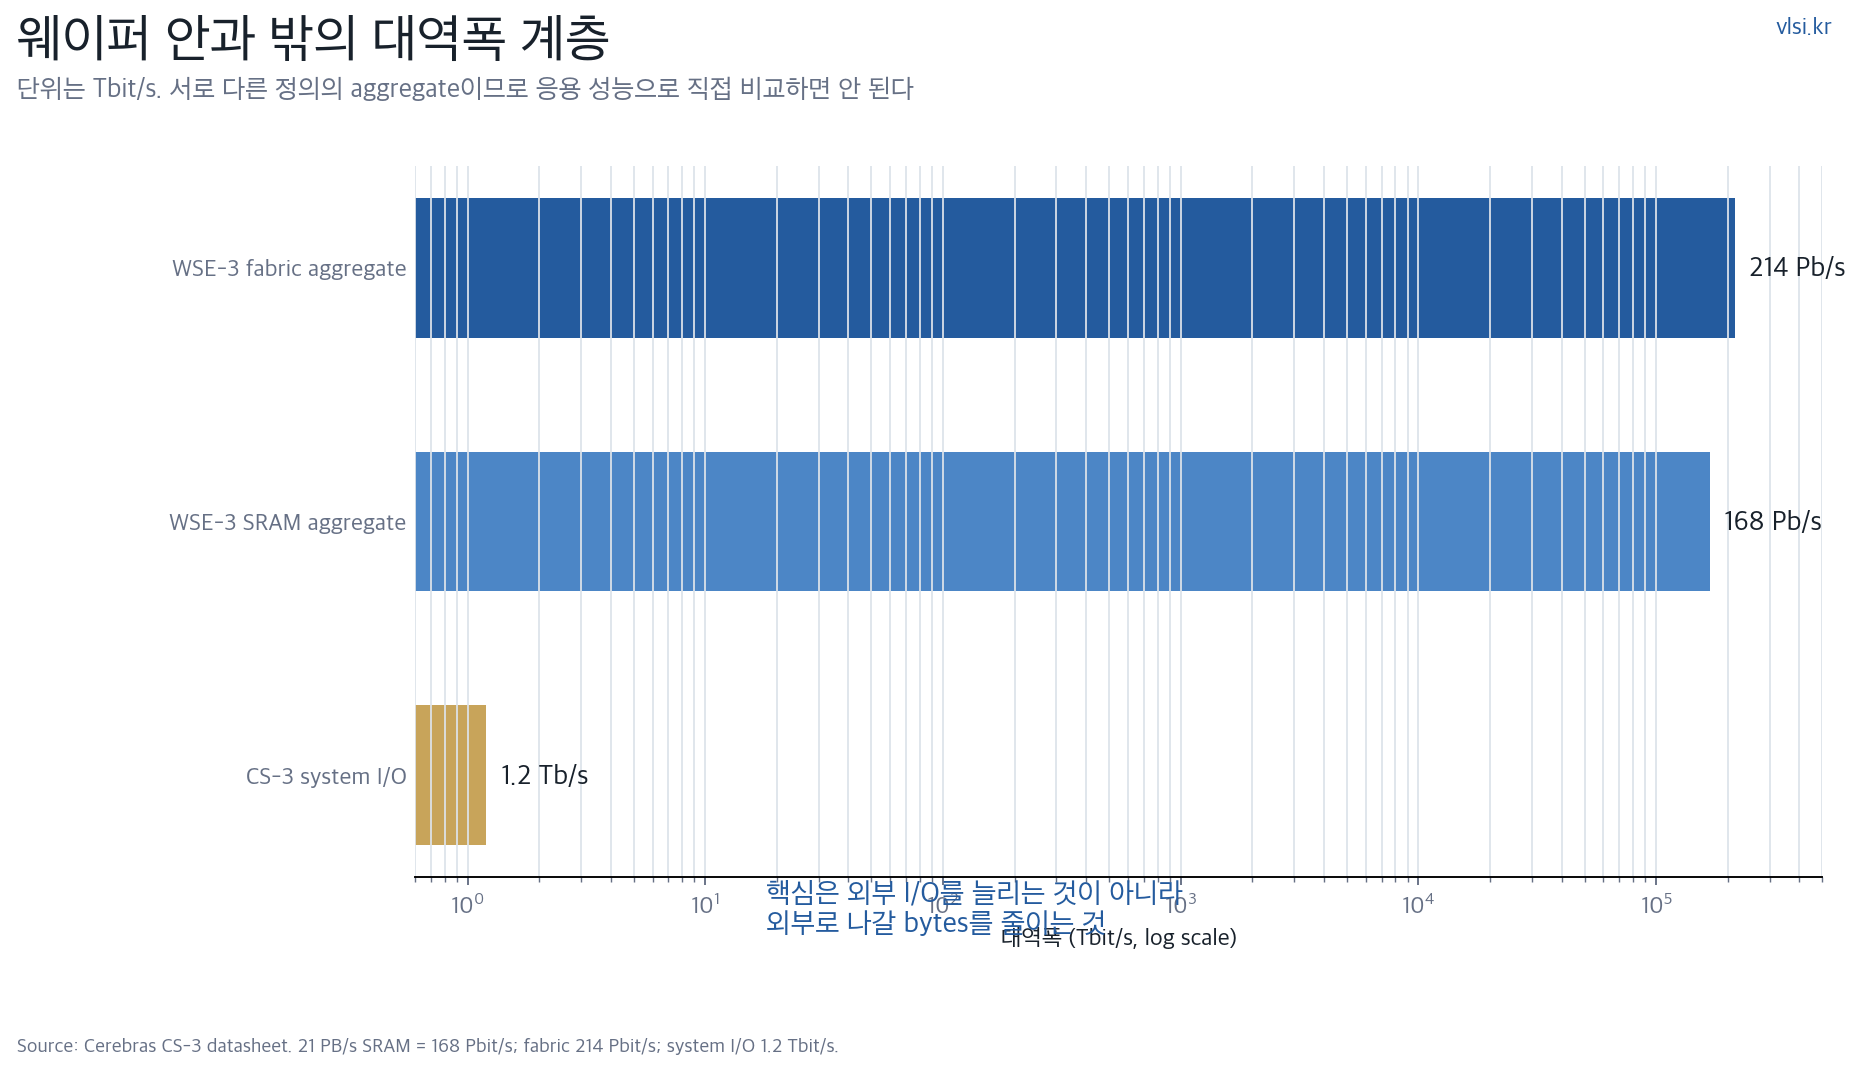
Cerebras CS-3 데이터시트는 WSE-3의 44 GB 온칩 SRAM, 21 PB/s 메모리 대역폭, 214 Pbit/s 패브릭 대역폭, 1.2 Tbit/s 시스템 I/O를 공개한다. 모두 회사가 제시한 최대 사양이다. 21 PB/s는 코어 가까이에 분산된 SRAM의 합산 접근 능력이고, 214 Pbit/s는 메시 링크를 넓게 합산한 fabric 수치이며, 1.2 Tbit/s는 시스템 경계를 통과하는 I/O다.
214 Pbit/s를 8로 나누면 표기상 26.75 PB/s이고, 1.2 Tbit/s는 이론상 150 GB/s다. 동일한 방향성, 인코딩, 동시 사용 조건이라고 가정하면 두 비트율의 단순 비는 약 178배다. 그러나 이 계산은 application speedup이 아니다. 로컬 링크 수천 개의 합과 한 시스템 경계의 트래픽을 비교한 크기 감각일 뿐이다. 읽기와 쓰기를 모두 더했는지, 양방향을 어떻게 셌는지, 프로토콜 overhead와 실제 동시 사용률이 얼마인지 공개 표만으로는 맞출 수 없다.
| 계층 | 회사 공개 수치 | 무엇을 합산했나 | 잘못 읽기 쉬운 해석 |
|---|---|---|---|
| 분산 SRAM | 44 GB, 21 PB/s | 웨이퍼 내 로컬 메모리 | 모든 코어가 임의 주소를 21 PB/s로 읽는다 |
| 온웨이퍼 fabric | 214 Pbit/s | 다수 메시 링크의 aggregate | 임의의 두 지점 사이 bisection도 214 Pbit/s다 |
| 시스템 I/O | 1.2 Tbit/s | CS-3 외부 경계 | 메모리 payload가 항상 150 GB/s로 지속된다 |
| MemoryX | 1.5 TB, 12 TB, 최대 1.2 PB 구성 | 시스템과 클러스터의 외부 메모리 용량 | 44 GB SRAM과 같은 latency tier다 |
3. 분산 SRAM은 메모리 월을 없애지 않고 위치를 바꾼다
WSE의 강점은 각 코어 가까이에 SRAM을 놓아 짧고 넓은 데이터 경로를 만드는 데 있다. 외부 HBM에서 매 연산마다 operand를 끌어오는 구조보다 weight, activation과 partial result를 로컬에 유지하기 쉽다. 데이터 이동 에너지는 거리와 스위칭 capacitance에 민감하므로, 메모리와 연산을 같은 타일에 붙이는 것이 웨이퍼 면적의 핵심 용도다.
하지만 44 GB가 무한한 것은 아니다. 예를 들어 700억 개 parameter를 parameter당 2 byte로만 저장해도 산술상 140 GB가 필요하다. optimizer state, gradient, activation은 이 계산에 들어 있지 않다. quantization과 sparsity를 쓰면 요구량은 달라지지만, 어떤 경우든 대형 모델은 외부 계층이나 여러 시스템에 걸쳐 배치될 가능성이 높다.
WSE-3 발표 자료는 1.5 TB, 12 TB와 1.2 PB까지 확장되는 MemoryX 구성을 제시한다. 여기서 중요한 단어는 용량이다. 공개 자료는 이 모든 구성이 온웨이퍼 SRAM과 동일한 지연, 대역폭, 동시성을 낸다고 말하지 않는다. MemoryX는 더 큰 model state를 보관하고 필요한 순서로 공급하는 계층이지 44 GB SRAM의 물리적 연장선으로 읽어서는 안 된다.
따라서 컴파일러가 tensor를 언제 가져오고 어느 코어에 놓으며 얼마나 오래 재사용할지 정해야 한다. parameter streaming, double buffering, activation recomputation, operator fusion과 static placement는 별도 최적화가 아니라 제품 성능의 중심이다. 메모리 계층을 숨기는 데 실패하면 90만 개 코어 중 많은 부분이 외부 데이터를 기다리게 된다.
4. 메시의 총합과 bisection은 다른 숫자다
2D mesh는 인접 타일끼리 짧은 링크를 반복할 수 있어 웨이퍼에 잘 맞는다. 코어를 추가하면 로컬 링크도 함께 늘어나 aggregate bandwidth가 크게 보인다. 반면 웨이퍼를 가운데로 잘랐을 때 절단면을 가로지르는 링크 수는 타일 총수보다 느리게 증가한다. 정사각형 N개 타일의 한 변이 대략 √N이므로 이상적인 2D mesh의 bisection link 수 역시 √N 규모로 생각할 수 있다.
이 차이는 all-to-all, global reduction, routing이 불규칙한 Mixture-of-Experts에서 드러난다. 모든 코어가 근처 데이터를 소비하면 214 Pbit/s의 로컬 합산 능력을 활용하기 쉽다. 반대로 한쪽에 모인 tensor를 웨이퍼 반대편으로 계속 보내면 중앙 단면이 혼잡해진다. 링크가 고장 나 우회 경로가 늘어나면 hotspot은 더 복잡해진다.
Hot Chips 2024 WSE-3 자료는 84개 reticle 영역에 걸친 2D mesh와 built-in redundancy, software에 보이는 균일한 논리 mesh를 설명한다. 이것은 고장 타일을 숨기는 장점인 동시에 물리 topology와 논리 topology 사이에 compiler 책임이 존재한다는 뜻이다. 공개 자료만으로는 실제 workload별 bisection utilization이나 congestion histogram을 알 수 없다.
5. 외부 인터커넥트는 scale-out의 마지막 세금이다
단일 웨이퍼에 model 전체가 들어가지 않으면 다음 단계는 여러 CS-3를 연결하는 것이다. Cerebras의 2024년 S-1은 100 Gb Ethernet과 SwarmX의 400G 또는 800G 연결, 최대 2,048대 CS-3 확장 구성을 설명한다. 이 역시 회사가 제시한 system architecture이며 고객 workload에서의 sustained scaling efficiency는 별도 문제다.
외부 링크가 느리다는 말로 끝내면 설계 포인트를 놓친다. 핵심은 어떤 traffic을 외부로 보내느냐다. parameter는 한 번 스트리밍한 뒤 웨이퍼 안에서 여러 번 재사용하고, gradient나 activation은 collective 순서를 최적화하며, checkpoint와 host I/O는 계산과 겹쳐야 한다. 동일한 800G 링크라도 통신과 연산을 overlap하면 체감 병목이 작고, fine-grained 동기화가 반복되면 지연시간이 전체 step time을 지배한다.
웨이퍼 스케일 시스템에 잘 맞는 workload는 공간적 또는 시간적 locality가 높고 graph를 정적으로 나누기 쉬운 경우다. stencil, dense tensor pipeline, 일정한 dataflow는 코어 주변에 데이터를 유지할 수 있다. expert routing이 시시각각 바뀌거나 작은 request가 불규칙하게 들어오는 서비스는 평균 대역폭보다 tail latency와 hotspot이 더 중요하다.
6. 설계 리뷰에서 물어야 할 다섯 질문
- resident set: 가장 자주 재사용되는 weight와 activation 중 44 GB 안에 실제로 남는 비율은 얼마인가.
- traffic locality: hop count의 평균뿐 아니라 95 percentile과 중앙 절단면의 peak utilization은 얼마인가.
- streaming schedule: 외부 메모리 fetch가 계산과 얼마나 겹치며 stall time이 step time의 몇 퍼센트인가.
- collective shape: reduction과 broadcast가 물리 mesh와 결함 우회 경로를 고려해 배치되는가.
- system boundary: 1.2 Tbit/s 중 실제 payload, protocol overhead, host traffic과 storage traffic의 몫은 각각 얼마인가.
현장에서 총 대역폭만 보고 architecture를 승인하면 대개 다음 단계에서 문제가 생긴다. 평균 링크 이용률이 낮아도 특정 seam이나 특정 MemoryX ingress가 포화될 수 있다. 반대로 peak 수치가 낮아 보여도 데이터 재사용률이 높으면 compute utilization은 충분할 수 있다. workload trace와 physical map을 함께 보지 않은 bandwidth 숫자는 절반짜리 사양이다.
7. 공개되지 않은 것
Cerebras는 주요 최대 사양과 확장 개념을 공개하지만, MemoryX tier별 sustained bandwidth와 latency, system I/O의 lane 구성과 protocol overhead, 실제 모델별 fabric utilization, 결함 우회 후 hop 증가량, MoE traffic의 tail latency는 공개하지 않았다. 1.2 PB 구성의 용량이 어떤 topology와 fault domain으로 나뉘는지도 투자자 문서만으로는 재현할 수 없다.
따라서 이 글은 제품 간 benchmark를 주장하지 않는다. 21 PB/s, 214 Pbit/s와 1.2 Tbit/s는 회사 공개 최대치이고, 178배는 단위만 맞춘 산술이다. 70B 모델의 140 GB 예시는 parameter당 2 byte를 둔 용량 계산이며 특정 모델의 실제 runtime memory 요구량이 아니다. 공개되지 않은 sustained 수치를 peak에서 역산하지 않았다.
Contrarian read: 외부 I/O wall은 생각보다 늦게 올 수 있다
내 결론의 가장 약한 지점은 모든 workload가 웨이퍼 밖으로 많은 데이터를 보낼 것이라는 가정이다. model을 dataflow에 맞게 배치하고 44 GB 안의 tensor를 충분히 재사용하면, 외부 링크는 step마다 모든 operand를 공급하는 memory bus가 아니라 epoch나 layer 경계에서 움직이는 staging path가 된다. 이 경우 1.2 Tbit/s의 절대값보다 스케줄의 예측 가능성이 중요하고, perimeter law는 제품 성능을 당장 막지 않을 수 있다.
또 quantization, sparsity, operator fusion과 speculative decoding이 외부 traffic 증가율을 연산 증가율보다 낮출 가능성도 있다. 반대로 irregular MoE와 대형 KV cache가 주류가 되고 fine-grained scale-out이 필요해지면 내 판단보다 I/O wall이 빨리 온다. 그래서 승부를 가르는 공개 지표는 peak fabric bandwidth가 아니라 workload별 SRAM hit 또는 reuse, external bytes per token, collective stall 비율이다.
Korean Lens: 한국 공급망이 볼 지점
한국 기업에 기회가 있는 곳은 웨이퍼 크기 logic을 그대로 복제하는 것만이 아니다. 고대역 메모리, package substrate, RDL, 고속 PHY, optical I/O, 전력과 열을 포함한 system test가 모두 외부 경계의 품질을 결정한다. 특히 chiplet-on-wafer 방식이 늘면 known-good-die와 memory hierarchy를 함께 설계하는 능력이 중요해진다.
다만 HBM을 많이 공급한다고 wafer-scale architecture의 주도권을 자동으로 얻는 것은 아니다. 어떤 tensor를 SRAM, HBM, rack memory에 둘지 결정하는 compiler와 system software, D2D protocol, congestion telemetry가 함께 있어야 한다. 국내 공급망의 약점은 component bandwidth가 아니라 workload trace를 package와 compiler 설계에 다시 넣는 폐쇄형 co-design loop다.
실무 적용 한 줄
Sources
- Cerebras, CS-3 system data sheet (제품 공개 사양, accessed 2026-07-15)
- Cerebras, WSE-3 at Hot Chips 2024 (기술 발표)
- Cerebras, WSE-3 announcement (회사 발표)
- Cerebras, Form S-1 filed in 2024 (발행사 공시)