VLSI Korea
웨이퍼가 곧 컴퓨터가 될 때 ⑦: 계층형 테스트와 burn-in
웨이퍼 스케일 칩은 pass와 fail 두 상태로 끝나는 제품이 아니다. 살아 있는 코어와 링크를 찾아 논리 mesh를 다시 구성해야 한다. 공개된 Cerebras의 970k physical·900k active core와 최종 system burn-in을 단서로, 실제 필요한 계층형 테스트 구조를 분석한다.


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
핵심 주장: 웨이퍼 스케일에서는 테스트 결과가 품질 보고서로 끝나지 않는다. 어느 코어를 끄고 어느 링크로 우회할지 정하는 배선도이자, 고객에게 보이는 컴퓨터의 실제 사양이 된다.
1. 다이 하나를 찍는 probe 방식이 왜 무너지는가
일반적인 die test는 wafer 위 각 die에 probe를 대고 scan, memory test와 I/O test를 수행한 뒤 known-good-die를 선별한다. wafer-scale monolithic system은 die 사이를 자르지 않고 reticle 경계를 넘어 동작한다. 검사 대상이 수십 개 reticle field, 수십만 core, 분산 SRAM과 수많은 fabric link를 포함한다.
ATE가 모든 내부 node를 외부 pin으로 관찰할 수는 없다. pin 수와 tester channel은 웨이퍼 내부 state보다 압도적으로 적고, 전체 회로를 at-speed로 켜면 높은 전류와 수랭 fixture가 필요하다. 긴 test vector를 직렬로 흘리면 장비 점유시간이 원가를 지배한다. 그래서 내부에 test pattern 생성, signature compression과 self-test를 넣고 여러 영역을 병렬로 검사해야 한다.
여기서 주의할 점이 있다. 공개된 Cerebras 자료는 redundant core와 fabric link, logical mesh 복구를 설명하지만 MBIST, LBIST, scan compression, probe card 구조와 diagnostic algorithm의 상세는 밝히지 않는다. 아래의 계층형 구조는 대규모 결함 허용 시스템에 필요한 일반적인 DFT 해석이지 Cerebras의 비공개 회로를 본 설명이 아니다.
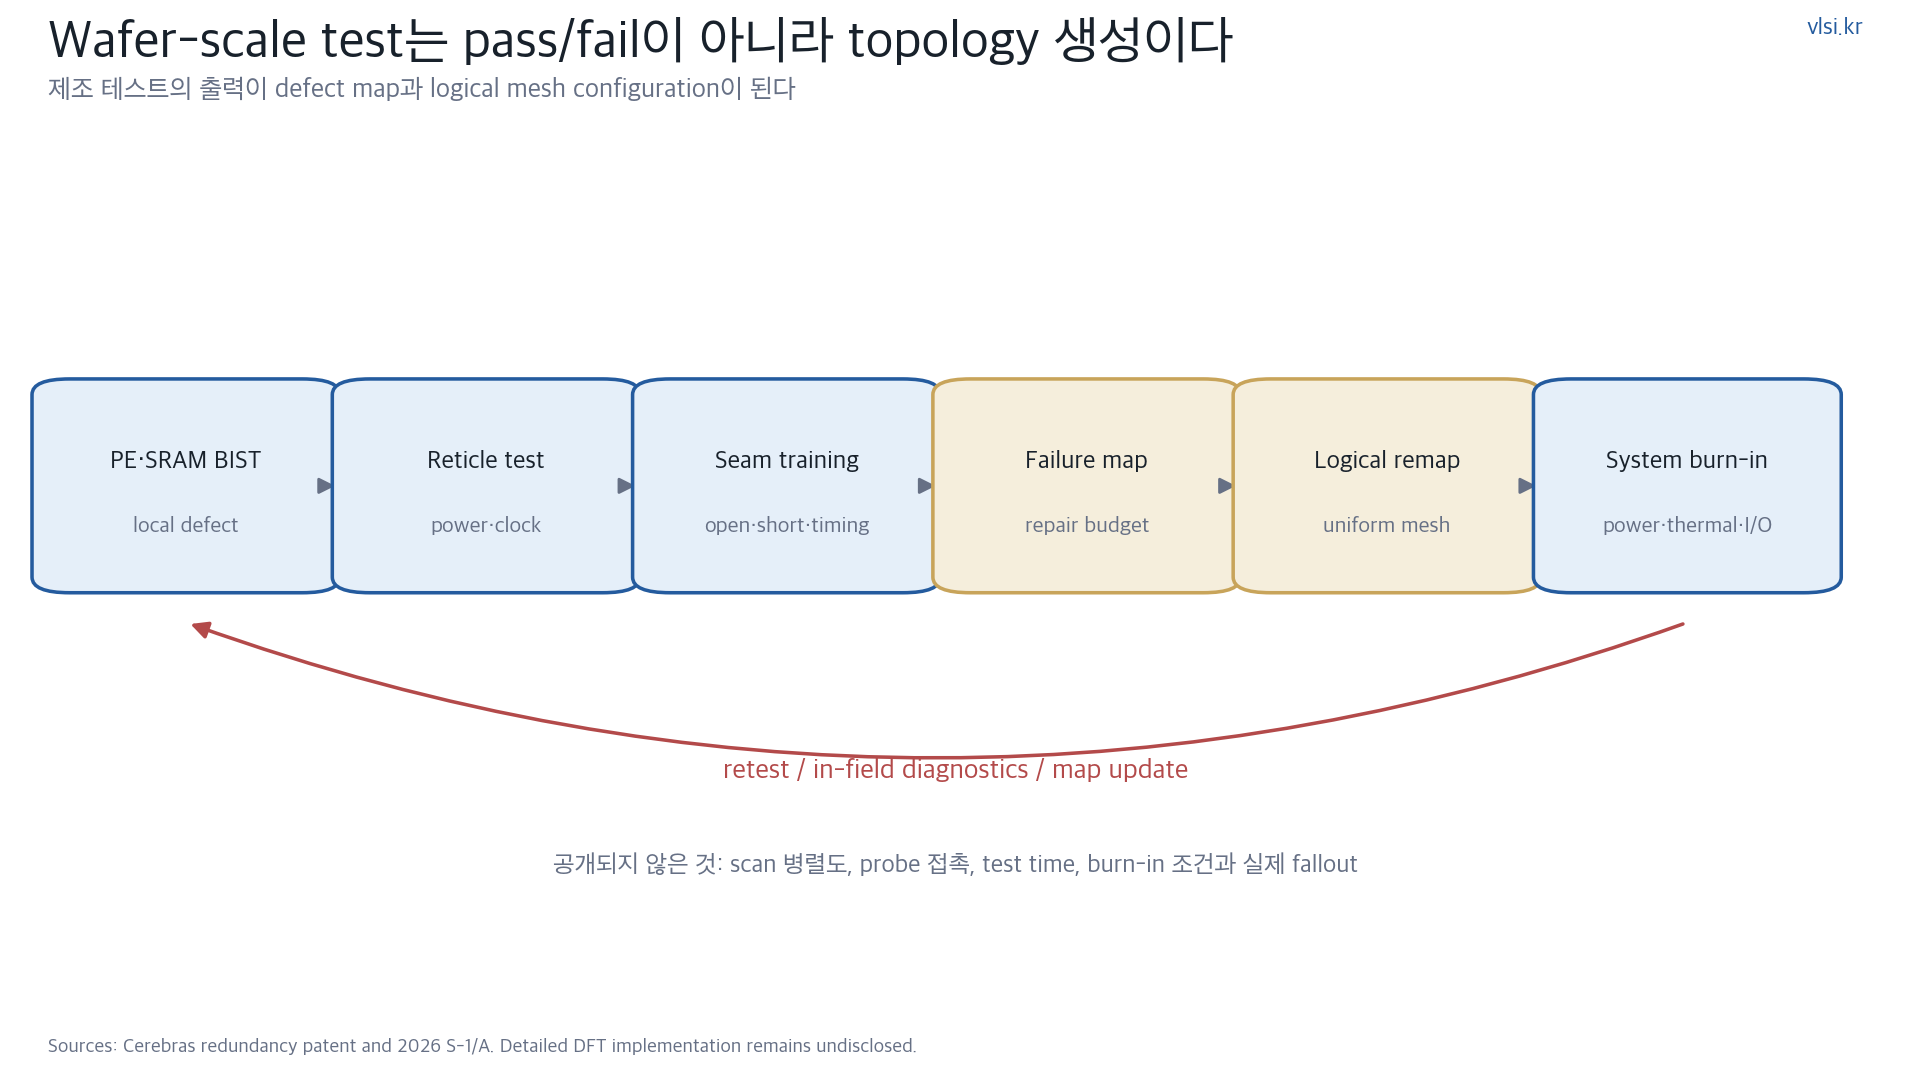
2. 테스트는 최소 여섯 계층으로 나뉜다
| 계층 | 주요 결함 | 가능한 검사 방식 | 산출물 |
|---|---|---|---|
| 공정·소자 | open, short, parametric drift | scribe monitor, inline metrology, wafer electrical test | 공정 이상 lot·영역 |
| core·SRAM tile | logic stuck-at, SRAM bit·row fault | scan, logic BIST, memory BIST, signature | 사용 가능 tile과 spare 할당 |
| reticle 내부 fabric | router·link fault, timing margin | loopback, walking pattern, at-speed path test | local route graph |
| reticle seam | stitch open·short, 경계 timing failure | 양방향 continuity와 stress pattern | seam별 usable lane |
| package·system | RDL, connector, power·cooling 문제 | functional test, full-load power, thermal soak | 출하 configuration과 bin |
| burn-in·field | 초기 고장, aging, intermittent fault | 장시간 workload, telemetry, periodic self-test | retire·reroute 이력 |
계층을 나누는 이유는 diagnosis resolution과 test time의 균형 때문이다. tile 수준 self-test가 실패 위치를 충분히 좁히면 wafer 전체 vector를 반복할 필요가 없다. 반대로 signature만 보고 pass를 선언하면 어느 링크가 marginal한지 모르고, 우회 route가 특정 seam에 traffic을 집중시킬 수 있다.
test access network 자체도 결함을 견뎌야 한다. 중앙 controller 하나와 단일 scan chain에 모든 tile을 매달면 그 경로의 한 open이 넓은 영역을 관찰 불능으로 만든다. 여러 entry point, partitioned chain, local signature와 대체 route가 필요하다. 테스트 인프라가 functional fabric을 공유한다면 functional defect가 diagnosis를 가리는 circular dependency도 검토해야 한다.
3. 970k physical, 900k active가 말하는 것과 말하지 않는 것
Cerebras의 defect-tolerance 설명은 WSE-3에 약 970,000개 physical core가 있고 900,000개를 active로 제공한다고 밝힌다. 차이는 70,000개로 physical core의 약 7.2%다. 회사는 이를 약 93% silicon utilization으로 설명한다.
이 숫자는 spare margin을 보여 주지만 제품 yield는 아니다. physical core 중 active로 쓰는 비율과, 제조된 wafer 중 최종 system test를 통과해 출하되는 비율은 분모가 다르다. wafer 전체를 폐기하게 만드는 global power fault, clock 문제, 큰 cluster defect, package crack, RDL open과 cooling failure는 단순 core spare로 복구되지 않을 수 있다.
또 모든 결함의 비용이 같지 않다. isolated core 한 개는 인접 spare와 route로 숨길 수 있지만, 여러 결함이 한 구역에 몰리거나 critical seam과 test access path를 끊으면 작은 결함 수로도 큰 영역을 잃는다. 회사 설명에서 사용한 평균 defect density와 Poisson 감각은 point defect 수를 이해하는 데 유용하지만 defect clustering과 systematic failure까지 보장하지 않는다.
IBM Research의 1985년 wafer-scale yield model도 point defect와 two-way redundancy가 yield에 미치는 영향을 분석했다. 40년 전부터 핵심 질문은 결함이 있느냐가 아니라 redundancy가 어떤 topology의 결함을 얼마나 흡수할 수 있느냐였다.
4. reticle seam은 별도의 test object다
WSE는 하나의 wafer 크기 mask로 그려지지 않는다. 반복 reticle field를 노광하고, field 경계를 건너는 interconnect를 공정과 설계 규칙으로 연결한다. 따라서 core와 SRAM이 모두 정상이어도 seam link가 open, short 또는 timing fail이면 logical mesh가 끊길 수 있다.
WSE-3 Hot Chips 자료는 84개 die 영역, 각 영역의 약 10.7k core와 die boundary를 full performance로 건너는 2D mesh를 설명한다. built-in redundancy를 통해 software가 균일한 logical mesh를 본다고도 말한다. 그러나 seam lane 수, test pattern, 허용 가능한 고장 seam 수와 timing guardband는 공개하지 않는다.
seam test는 단순 continuity만으로 부족하다. 양방향 data pattern, aggressor switching, voltage·temperature corner, 장거리 multi-hop route에서의 timing과 crosstalk을 봐야 한다. 결함 우회 후 traffic이 특정 lane에 몰릴 때만 드러나는 marginal fault도 있다. production test 시간을 줄이려면 구조 test와 대표 stress workload 사이의 correlation을 먼저 확보해야 한다.
5. monolithic WSE와 chiplet SoW의 실패 지점은 다르다
chiplet-on-wafer는 작은 die를 먼저 검사해 known-good-die만 조립할 수 있다. 이것은 큰 active wafer의 모든 transistor를 한 번에 살려야 하는 부담을 줄인다. DarwinWafer처럼 64개 chiplet을 300 mm interposer에 배치한 시스템은 chiplet 단위 selection과 replaceable assembly를 활용할 수 있다.
하지만 KGD는 완성 system yield가 아니다. placement error, bump open, RDL defect, interposer TSV와 power contact는 조립 뒤에 새로 생긴다. chiplet 수가 늘면 각 die가 pass해도 모든 attach와 link가 정상일 확률은 별도 곱셈이 된다. 어느 chiplet을 rework할 수 있는지, interposer가 손상되지 않는지, rework 후 thermal planarity를 유지하는지가 중요하다.
monolithic WSE는 microbump 수를 줄이고 매우 촘촘한 on-wafer wiring을 얻는 대신 front-end wafer와 custom package가 강하게 결합된다. chiplet SoW는 KGD와 공정 혼합을 얻지만 assembly defect와 chiplet-to-chiplet clock, test protocol을 떠안는다. test architecture는 integration 선택의 결과이지 마지막 단계의 공통 부속이 아니다.
6. final test와 burn-in은 실제 냉각계에서 해야 한다
Cerebras의 2024년 S-1은 TSMC가 WSE를 제조하고 ASE가 redistribution layer를 형성하며, Cerebras가 final packaging, assembly와 testing을 수행한다고 설명한다. 완성 system은 Cerebras에서 burn-in과 final test를 거친다. 이는 공급망 역할에 관한 발행사 공시다.
왜 die 단계에서 끝내지 않을까. package를 조립해야만 실제 power path, connector contact, cold plate pressure, external I/O와 full-wafer clock·routing condition이 만들어진다. 높은 activity의 functional workload에서만 나타나는 IR droop, thermal gradient와 intermittent seam도 있다. final system을 실제 냉각계와 함께 구동해야 검출할 수 있다.
burn-in은 초기 고장 가능성이 높은 부품과 접합을 시간과 stress로 걸러내는 과정이다. 그러나 공개 공시는 burn-in 온도, voltage, 시간, workload, fallout rate를 밝히지 않는다. 길게 할수록 screening은 강화될 수 있지만 장비 점유, 전력과 제품 aging 비용도 늘어난다. 최적 조건은 defect pareto와 field return data 없이는 정할 수 없다.
출하 뒤에도 완전히 끝나지 않는다. aging이나 intermittent fault가 생기면 health monitor가 감지하고 core·link를 retire한 뒤 topology를 다시 구성할 수 있어야 한다. 제품이 실제로 어느 범위까지 in-field repair를 지원하는지, application state를 유지한 채 reroute하는지는 공개 자료가 제한적이다. 장기적으로 wafer-scale reliability의 차별점은 spare 수보다 진단 오탐과 복구시간이 될 수 있다.
7. test time이 수율을 바꾸는 방식
970,000개 core를 하나씩 순차 검사하는 사고방식은 생산성이 없다. 예를 들어 core당 1 ms만 써도 단순 합은 970초를 넘는다. 실제 test는 병렬화하고 pattern을 공유하며 core마다 같은 시간이 들지 않는다. 이 계산은 실제 WSE test time이 아니라 serial test가 왜 불가능한지 보여주는 예시다.
병렬도를 높이면 peak current와 thermal load가 커져 false fail 또는 실제 stress failure를 만들 수 있다. 병렬도를 낮추면 ATE와 cooling fixture 점유시간이 늘어난다. signature compression은 output pin을 줄이지만 alias 가능성과 diagnosis resolution을 희생한다. production test는 coverage, diagnosis, parallelism, stress와 시간의 다섯 항을 맞추는 최적화다.
spare budget도 test 정책과 연결된다. marginal core를 보수적으로 disable하면 yield는 좋아 보일 수 있지만 active margin이 빨리 소모된다. 공격적으로 살리면 initial active count는 높아도 field failure 위험이 커질 수 있다. frequency binning과 voltage margin, defect map의 spatial pattern까지 포함한 출하 rule이 필요하다.
8. 공개되지 않은 것
Cerebras는 wafer sort pass rate, final package yield, system burn-in fallout, defect type별 분포, scan·MBIST·LBIST 구조, seam test coverage, diagnostic resolution, ATE time, spare 소비 분포와 고객 field failure rate를 공개하지 않았다. 93% active-core 비율에서 이 숫자들을 역산할 수 없다.
또 제품이 제조 결함 map을 fuse, nonvolatile memory, external configuration file 중 어디에 보관하는지, boot마다 어떤 self-test를 수행하는지, runtime에 core와 link를 추가 retire할 수 있는지 공개 자료만으로 확정하기 어렵다. 이 글은 대규모 reconfigurable system에 필요한 일반 test architecture와 공개된 supply-chain flow를 연결한 분석이다.
Contrarian read: 완전한 테스트보다 빠른 복구가 더 싸다
내 주장의 반대 가설은 wafer-scale AI workload가 bit-perfect processor만큼 엄격한 사전 검사를 필요로 하지 않을 수 있다는 것이다. 충분한 spare와 runtime health check가 있다면 긴 burn-in과 높은 구조 coverage보다 field에서 빠르게 core를 retire하고 job을 재시작하는 편이 total cost가 낮을 수 있다. 특히 stateless inference나 checkpoint가 잦은 training은 일부 hardware loss를 운영으로 흡수할 수 있다.
그러나 이 결론은 failure가 local하고 fail-stop 형태이며 잘못된 값을 조용히 내놓지 않는다는 조건에 의존한다. silent data corruption, shared power·clock failure, routing deadlock과 intermittent seam은 software retry보다 먼저 결과 신뢰성을 훼손한다. 내 계층형 test 강조가 과도한지 판단하려면 burn-in 시간 자체가 아니라 detected fault class, SDC rate, field retire frequency와 recovery time을 공개해야 한다.
Korean Lens: tester보다 diagnosis stack이 중요해진다
한국은 memory wafer test, burn-in 장비, probe card, thermal handler와 OSAT 경험이 깊다. wafer-scale에서는 기존 장비의 채널 수를 키우는 것만으로 충분하지 않다. BIST signature에서 physical defect 위치를 복원하고, 그 결과를 routing·compiler configuration으로 넘기는 diagnosis software가 함께 필요하다.
현실적인 연구 과제는 full-wafer product를 바로 복제하는 것이 아니라 reticle stitch와 multi-chiplet test vehicle에서 seam fault library, high-current parallel test, liquid-cooled burn-in과 reconfiguration API를 묶는 일이다. 장비 업체, package house, EDA와 architecture team이 동일한 defect taxonomy를 써야 데이터가 다음 제품에 재사용된다.
실무 적용 한 줄
Sources
- Cerebras, Form S-1 filed in 2024 (제조·최종 test·burn-in 역할에 관한 발행사 공시)
- Cerebras, 100x Defect Tolerance (physical·active core에 관한 회사 설명)
- Cerebras, WSE-3 at Hot Chips 2024 (구조와 redundancy 기술 발표)
- Cerebras, WSE at Hot Chips 31 (초기 redundant core·fabric 발표)
- IBM Research, Point Defect Yield Model for Wafer Scale Integration (1985)
- Zhu et al., DarwinWafer (chiplet SoW 연구 시제품)
자주 묻는 질문
Cerebras WSE-3의 physical core와 active core 수는 얼마인가?
Physical core 970,000개, active core 900,000개로 공개됐다. 약 93%라는 active 비율은 출하 가능한 wafer 비율이나 최종 제품 수율이 아니다.
웨이퍼 스케일 테스트는 왜 계층으로 나눠야 하는가?
공정·소자, core·SRAM tile, reticle 내부 link, reticle seam, package·system, burn-in·field의 최소 여섯 계층으로 나눠 검사해야 하기 때문이다. 결함을 검출하고 위치를 특정한 뒤 격리하고 topology를 재구성하는 lifecycle로 보는 것이 핵심이다.
일반적인 wafer probe 방식만으로 부족한 이유는 무엇인가?
Wafer-scale 시스템은 수십 개 reticle field와 수십만 core를 포함하는데, ATE의 pin 수와 tester channel은 내부 state보다 훨씬 적기 때문이다. 전체 회로를 at-speed로 켜면 높은 전류와 수랭 fixture가 필요해, 내부 self-test와 병렬 검사가 필요하다.
웨이퍼 스케일에서 테스트의 경제성은 어떻게 결정되는가?
테스트는 불량을 찾는 비용이 아니라 어떤 자원을 끄고 어떤 우회 경로를 쓸지 정하는 configuration 공정이다. Test time, spare budget, 성능 binning이 함께 수율을 결정한다.