VLSI Korea
웨이퍼가 곧 컴퓨터가 될 때 ②: 수율은 왜 불량률이 아니라 재구성 문제인가
웨이퍼 전체가 완벽해야 한다면 wafer-scale chip은 성립하지 않는다. 해법은 결함을 없애는 것이 아니라 결함 한 개가 죽이는 면적을 줄이고, spare와 라우팅으로 정상 논리 격자를 재구성하는 것이다. 다만 900,000 active core를 실제 웨이퍼 수율로 읽으면 안 된다.


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
핵심 주장: wafer-scale yield는 좋은 웨이퍼를 골라내는 통계 문제가 아니라, 불완전한 웨이퍼를 동일한 사양의 컴퓨터로 바꾸는 아키텍처 문제다.
1. 46개 결함이라는 생각 실험이 말해주는 것
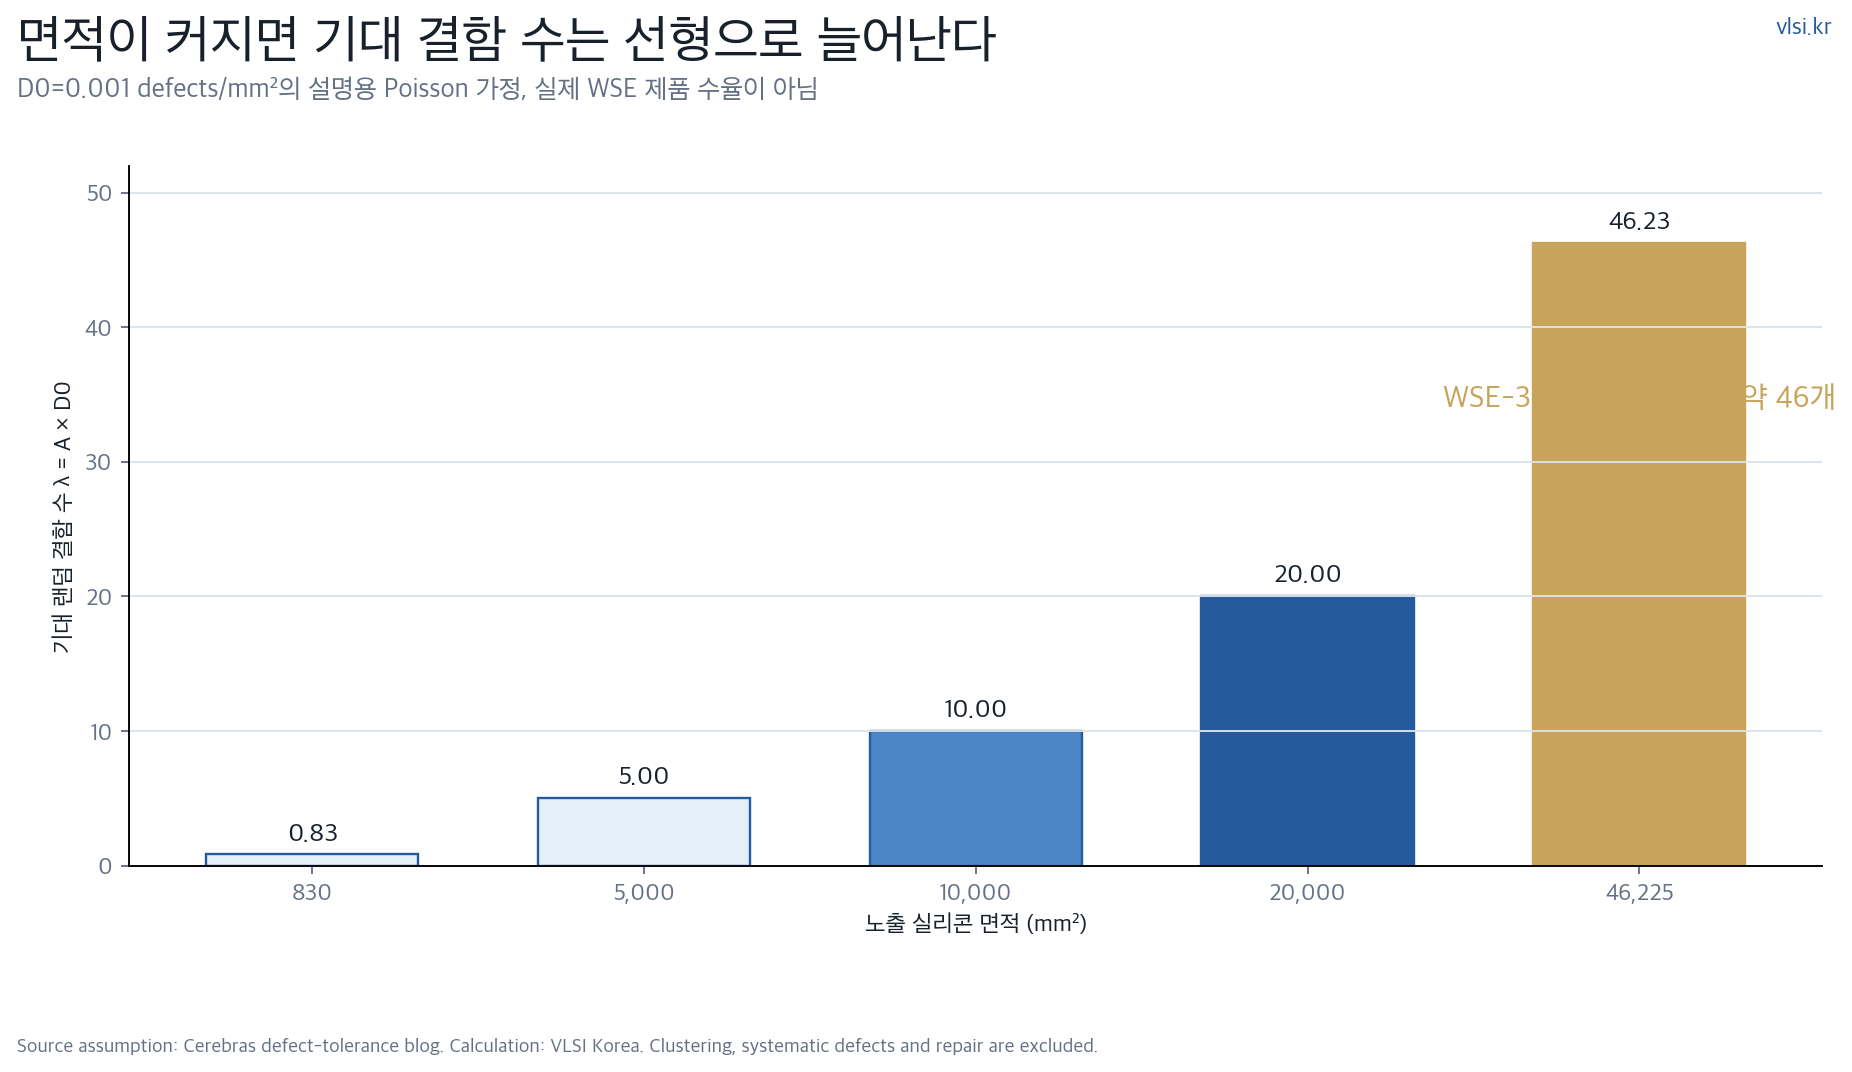
가장 단순한 점결함 모델에서 유효 면적을 A, 단위면적당 평균 결함 수를 D0라고 하면 평균 결함 수는 λ=A×D0다. 결함이 서로 독립이고 하나만 있어도 칩 전체가 불량이라고 가정한 무결점 확률은 Y0=exp(-A×D0)다. 이 식은 실제 파운드리 견적식이 아니라 면적이 커질 때 왜 기존의 pass 또는 fail 사고가 무너지는지 보여주는 첫 번째 근사다.
Cerebras는 자사 결함 허용 설명에서 TSMC 5nm의 결함밀도를 약 0.001개/mm²라고 가정했다. 이것은 TSMC가 WSE 계약 수율로 확인한 공식 수치가 아니라 Cerebras가 비교를 위해 사용한 보고값이다. 그래도 같은 가정을 면적별로 적용하면 규모의 효과는 분명하다.
| 유효 면적 A | 평균 결함 수 λ | 단순 무결점 확률 exp(-λ) | 해석 |
|---|---|---|---|
| 50mm² | 0.05개 | 95.1% | 작은 반복 타일은 무결점일 가능성이 높다 |
| 830mm² | 0.83개 | 43.6% | 레티클급 대형 다이는 이미 redundancy가 유리하다 |
| 5,000mm² | 5개 | 0.674% | 완벽한 대형 영역만 고르는 전략이 급격히 불리하다 |
| 10,000mm² | 10개 | 0.00454% | 결함 격리가 사실상 필수다 |
| 46,225mm² | 46.225개 | 약 8.4×10⁻²¹ | 무결점 웨이퍼를 전제로 할 수 없다 |
2. 수율 공식을 바꾸는 첫 번째 레버: 결함 격리 면적
전통적인 대형 GPU도 완전 무결점을 요구하지 않는다. 일부 SM, 캐시 way와 메모리 인터페이스를 fuse로 비활성화하고 등급별 SKU로 판매한다. wafer-scale이 다른 점은 이 세분성을 훨씬 더 작고 규칙적인 처리요소까지 밀어붙인다는 데 있다. Cerebras 발표에서 WSE-3 코어 한 개는 약 0.05mm²다. 회사의 단순 비교대로 점결함 하나가 그 코어에 국한된다면 손실되는 면적은 대형 GPU의 복잡한 연산 블록 하나보다 훨씬 작다.
그러나 코어 크기만 줄인다고 끝나지 않는다. 한 코어를 끈 뒤 동서남북 링크가 끊기면 메시가 둘로 갈라질 수 있다. spare가 멀리 떨어져 있으면 정상 코어를 쓰기 위해 긴 우회가 생기고 지연과 혼잡이 달라진다. 따라서 계산 spare, SRAM spare, 링크 spare와 재구성 논리가 함께 있어야 한다. 물리적으로 불규칙한 웨이퍼를 소프트웨어가 기대하는 규칙적인 직사각형 격자로 바꾸는 과정이 제품화의 핵심이다.
Cerebras의 1세대 Hot Chips 발표는 redundant core와 fabric link를 두고 extra link가 논리적 2차원 메시를 복원한다고 설명한다. WSE-3 발표도 built-in redundancy와 소프트웨어에 보이는 uniform 2D mesh를 강조한다. 구체적인 spare 배치율과 결함 맵 생성 알고리즘은 공개하지 않았지만, 제품 사양이 정상 코어 수로 고정될 수 있는 구조적 이유는 확인된다.
3. 970,000 physical과 900,000 active: 이 숫자가 수율이 아닌 이유
Cerebras는 WSE-3에 물리 코어 약 970,000개가 있고 출하 제품에서 900,000개를 활성화한다고 밝혔다. 차이는 70,000개, 물리 코어 수의 약 7.2%다. 회사는 이를 약 93% silicon utilization이라고 표현한다. 이 수치는 동일한 논리 사양을 만들기 위해 충분한 spare 여유가 있다는 의미로 읽을 수 있다. 하지만 93%의 웨이퍼가 출하된다는 뜻도, 웨이퍼 면적의 정확히 93%가 전기적으로 정상이라는 뜻도 아니다.
첫째, 모든 비활성 코어가 실제 결함 때문이라는 공개 증거가 없다. 일정한 직사각형 논리 배열과 주파수 bin을 맞추기 위해 정상 코어 일부를 예약할 수 있다. 둘째, 코어 외 면적이 있다. 라우터, SRAM, 클록, 전원망, I/O와 reticle seam의 건강 상태는 코어 개수만으로 표현되지 않는다. 셋째, fab에서 살아남은 웨이퍼도 재배선층, 커넥터, 냉각판, 최종 조립과 burn-in에서 탈락할 수 있다.
따라서 서로 다른 네 비율을 구분해야 한다. physical core 중 active core 비율은 configuration yield다. wafer probe에서 요구 사양을 만족한 웨이퍼 비율은 wafer sort yield다. 패키징 뒤 살아남은 비율은 assembly yield다. 최종 시스템 테스트와 burn-in을 통과한 비율이 shipment yield다. 원가는 마지막 비율에 의해 결정되지만 공개 마케팅 숫자는 대개 첫 번째 비율에 머문다.
4. spare core가 못 고치는 여섯 종류의 불량
결함 군집: 파티클이나 공정 이상이 인접한 여러 코어와 링크를 동시에 망가뜨리면 작은 spare가 한곳에서 고갈된다. 점결함 독립 가정과 달리 웨이퍼 가장자리, 특정 공정 스텝이나 스크래치에 의해 공간적 상관이 생긴다. IBM의 고전적 wafer-scale point-defect 연구가 redundancy와 결함 분포를 함께 모델링한 이유다.
systematic defect: reticle 데이터 오류, 마스크 결함이나 설계 규칙 위반이 반복 노광 필드마다 같은 위치에 나타나면 모든 타일의 동일 기능이 죽을 수 있다. random spare로는 공통 원인을 제거할 수 없다. test chip, OPC 검증과 공정 변경 관리가 별도로 필요하다.
seam defect: 필드 내부 코어가 정상이어도 노광 경계를 가로지르는 금속의 open, short, 저항 증가와 overlay 오차가 생길 수 있다. 우회 링크가 있더라도 seam 하나에 결함이 집중되면 bisection bandwidth가 감소하거나 격자가 분할된다.
global network: 전원 분배망, 기준 클록, reset, test access, thermal sensor와 management path는 넓은 영역을 공유한다. 설계자가 계층화하고 복제하지 않으면 한 결함이 수천 코어를 동시에 잃게 한다. wafer-scale에서 가장 위험한 것은 코어 수보다 이런 단일 실패점이다.
parametric failure: open이나 short가 없어도 느린 트랜지스터, SRAM read margin, IR drop, electromigration, 누설과 온도 편차 때문에 목표 주파수와 전압을 만족하지 못할 수 있다. 논리 BIST 통과와 장시간 신뢰성은 다른 문제다.
post-fab failure: ASE가 형성하는 재배선층, 웨이퍼와 PCB 사이 커넥터, 전원 접촉과 냉각판 계면의 기계적 불량은 전공정 core spare로 복구할 수 없다. WSE가 하나의 칩인 동시에 하나의 맞춤형 패키지인 이유다.
5. 결함 맵은 테스트 결과가 아니라 제품의 일부다
일반 칩 테스트는 양품과 불량품을 나누는 데 집중한다. wafer-scale에서는 테스트가 구성 정보를 생산한다. 먼저 각 처리요소의 SRAM MBIST, 연산 패턴, 라우터 포트와 인접 링크를 병렬 검사한다. 다음으로 경계 링크와 긴 경로의 연속성, 지연, 전압과 온도 margin을 측정한다. 그 결과로 물리 결함 맵을 만들고 spare를 할당하며 논리 좌표를 다시 정의한다. 마지막으로 컴파일러나 런타임이 이 좌표와 허용 경로를 사용한다.
이 과정은 test network 자체가 정상이어야 한다는 재귀 문제를 만든다. 중앙 JTAG 체인 하나가 끊기면 뒤의 수십만 코어를 관측할 수 없다. 따라서 계층형 scan, 지역 MBIST controller, 중복 test access와 on-chip telemetry가 필요하다. 외부 ATE의 핀 수와 메모리로 90만 코어의 모든 패턴을 직렬 주입하면 테스트 시간이 원가를 압도할 수 있으므로 메시를 self-test 전달망으로 활용하는 접근도 자연스럽다.
Cerebras의 규제 제출자료는 최종 패키징, 조립과 테스트, 완성 시스템의 burn-in을 회사가 수행한다고 밝힌다. 이는 테스트가 표준 foundry wafer sort에서 끝나지 않음을 보여주는 1차 증거다. 다만 scan compression 비율, MBIST coverage, at-speed seam test, burn-in 시간과 field repair 정책은 공개되지 않았다. 따라서 테스트 구조에 관한 구체적 설명은 일반적인 DFT 요구에서 도출한 설계 추론이지 WSE-3 구현 확인이 아니다.
6. KGD 방식은 수율을 해결하는가, 옮기는가
chiplet SoW는 결함이 많은 웨이퍼를 통째로 살리는 대신 각 다이를 잘라 충분히 검사한 뒤 known-good die만 배치한다. 다이 수율이 90%라면 불량 다이를 애초에 조립하지 않을 수 있으므로 25개 다이가 모두 우연히 양품이어야 한다는 단순 곱셈을 피한다. 또 동일한 다이를 여러 위치에 쓰면 재고에서 교체할 수 있다. Tesla Dojo가 5×5 D1 배열과 죽은 다이 주변 라우팅을 함께 둔 것은 이 장점을 활용한다.
하지만 known-good die의 good은 테스트한 조건에서만 good이다. 얇은 다이의 취급, 열압착, 범프 접합, underfill, wafer-scale RDL과 인터포저 stitching에서 새로운 결함이 생긴다. 다이가 많아질수록 접합점 수가 증가하고, 각 접합의 미세한 실패 확률이 시스템 전체 조립 수율에 누적된다. 한 다이를 다시 뗄 수 있는 rework 구조가 없으면 값비싼 양품 다이 여러 개를 함께 버릴 수 있다.
결국 monolithic WSI와 KGD SoW는 결함을 없앤 두 기술이 아니라 불량을 처리하는 시점을 달리한 두 기술이다. 전자는 fab 결함을 미세한 기능 블록에서 흡수하고 후자는 조립 전에 다이를 선별한다. 전자는 매우 촘촘한 경계 배선을 얻고, 후자는 공정 노드와 IP를 섞을 자유를 얻는다. 어느 쪽의 최종 비용이 낮은지는 공개되지 않은 wafer sort, assembly, rework와 test cost가 결정한다.
7. 수율 경제학: 분모는 웨이퍼가 아니라 출하 가능한 계산량이다
wafer-scale의 비용을 wafer당 가격 하나로 비교하면 틀린다. 필요한 분자는 전공정 웨이퍼 비용, 특수 재배선, 패키지 재료, 조립 장비, 테스트 시간, burn-in 전력과 탈락품 비용의 합이다. 분모는 출하 시스템 수만이 아니라 보증된 활성 코어, 동작 주파수, 유효 메모리와 시스템 가용시간을 반영한 계산량이어야 한다.
예를 들어 작은 결함 40개가 있어도 모두 우회해 동일한 900,000-core 사양으로 출하하면 기능 수율에는 영향이 없다. 반대로 논리 결함이 0개여도 전압 강하 때문에 목표 클록을 낮추거나 냉각 접촉 불량으로 burn-in에서 탈락하면 경제적 수율은 0이다. 제품이 한 웨이퍼에 하나이므로 한 번의 최종 탈락이 버리는 절대 실리콘 가치가 크다. 그래서 조기 테스트와 단계별 stop rule이 중요하다.
또한 redundancy는 공짜가 아니다. 70,000 physical core 여유, extra link, fuse나 configuration memory, 센서와 test controller가 면적과 검증 시간을 사용한다. 하지만 이 overhead를 낭비라고만 볼 수 없다. 결함 하나가 0.05mm²만 무력화하는 구조는 800mm²급 다이 여러 개에서 큰 연산 블록을 통째로 끄는 방식보다 웨이퍼 전체 유효 면적을 더 많이 보존할 가능성이 있다. 비교해야 할 것은 spare 비율이 아니라 결함 한 개당 잃는 판매 가능한 계산량이다.
8. Contrarian read: 큰 칩이 항상 더 많은 실리콘을 버리는 것은 아니다
상식은 die가 커질수록 수율이 떨어진다고 말한다. 전통적 pass 또는 fail 다이에는 맞다. 그러나 규칙적인 작은 코어와 링크를 대량 복제하고 결함 단위로 끌 수 있다면 물리 면적이 커져도 결함당 손실은 작아질 수 있다. Cerebras의 비교가 강조하는 지점도 총 결함 수가 아니라 각 결함이 제거하는 면적이다. wafer-scale은 크기 법칙을 무시한 것이 아니라 판매 단위를 다이에서 정상 타일의 집합으로 바꿨다.
그렇다고 회사의 164배 면적 손실 비교를 곧바로 원가 우위로 받아들여서는 안 된다. 비교에 사용한 GPU core 면적은 추정이고, 캐시와 I/O 등 비코어 영역의 결함 허용 방식이 단순화됐다. WSE의 군집 결함과 패키지 실패 비용도 반영되지 않았다. 이 비교는 fine-grained redundancy의 방향을 설명하는 좋은 직관이지 독립적으로 검증된 cost-per-good-compute 계산이 아니다.
9. 공개되지 않은 것: 진짜 수율표에 필요한 숫자
- fab을 통과한 WSE 웨이퍼 중 900,000 active core와 목표 주파수를 만족하는 비율.
- 웨이퍼 위치별 결함 분포, 결함 군집 계수, seam open과 short의 발생률.
- 70,000 비활성 또는 spare core 중 실제 결함, 형상 맞춤, 성능 bin과 예약분의 비중.
- ASE 재배선 공정과 최종 패키징 단계별 수율, rework 가능 범위와 scrap cost.
- wafer sort, 패키지 테스트와 system burn-in 시간, 병렬도, coverage와 탈락률.
- 출하 후 aging이나 soft error로 링크와 코어를 다시 매핑할 수 있는지, 가능하다면 성능 보증을 어떻게 유지하는지.
이 숫자가 없으면 외부 분석자는 실제 good system per wafer를 계산할 수 없다. 따라서 공개 자료로 말할 수 있는 가장 강한 결론은 Cerebras가 결함 허용 구조로 상용 시스템을 출하했다는 사실이다. 경쟁사보다 수율이나 원가가 높다는 결론은 아직 검증할 수 없다.
출처와 방법
- Cerebras, 100x Defect Tolerance: 0.05mm² core, 970,000 physical, 900,000 active와 회사의 결함밀도 가정.
- WSE-3 Hot Chips 발표: 84개 필드, built-in redundancy와 논리 메시.
- WSE-1 Hot Chips 발표: redundant core와 fabric link 설계.
- Cerebras 2024 S-1: 제조, RDL, 최종 패키징과 테스트 책임.
- IBM Research, Point-defect yield model for WSI: redundancy를 포함한 고전적 수율 문제.
- Tesla Dojo Hot Chips 발표: KGD 배열과 불량 다이 우회.
Poisson 값은 Cerebras가 제시한 0.001개/mm²를 동일하게 적용한 VLSI Korea의 생각 실험이다. 공정별 실제 defect density나 WSE 수율을 추정한 것이 아니다. 모든 퍼센트는 계산 기준을 함께 적었고, 기업 자료의 비교 주장은 독립 실측과 분리했다. 자료 기준일은 2026년 7월 15일이다.