VLSI Korea
웨이퍼가 곧 컴퓨터가 될 때 ⑧: 중국은 어디까지 왔나
중국에서 wafer-scale 도전이 많다는 말은 절반만 맞다. 공개 증거가 가장 강한 것은 64-chiplet DarwinWafer 실측이고, Tsinghua 12인치 시제품은 핵심 사양이 비공개다. Tsingmicro TX83은 roadmap, Huawei CloudMatrix384는 wafer chip이 아닌 supernode다.


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
핵심 주장: 중국 wafer-scale 경쟁의 현재형은 여러 상용 WSE 회사의 추격전이 아니다. mature-node chiplet과 reconfigurable architecture를 wafer 단위로 묶을 수 있는지 검증하는 대학·기업 공동 실험이며, 가장 큰 공백은 제조했다는 사진과 실제 출하 사이의 yield·test·software 데이터다.
1. 먼저 wafer라는 단어를 다섯 개로 나눠야 한다
monolithic wafer-scale engine은 동일 active wafer에서 reticle 경계를 넘어 compute와 memory가 연결되고, 결함을 우회한 뒤 wafer 전체가 하나의 processor로 동작하는 형태다. Cerebras WSE가 공개적으로 검증된 대표다.
chiplet system-on-wafer는 먼저 제조하고 검사한 여러 compute die를 300 mm급 interposer나 carrier 위에 붙인다. wafer 전체가 시스템으로 동작하지만 active transistor가 하나의 monolithic front-end wafer에 만들어진 것은 아니다. Tesla Dojo와 DarwinWafer, TSMC의 SoW roadmap이 이 범주에 가깝다.
big chip은 reticle보다 큰 package나 multi-chip architecture를 넓게 부르는 연구 용어다. full 12-inch wafer를 반드시 뜻하지 않는다. wafer-level packaging은 wafer 상태에서 여러 개의 개별 package를 동시에 만드는 공정일 수 있으며, 최종 제품이 wafer 크기라는 뜻이 아니다. supernode는 rack과 cable·switch로 여러 chip을 하나의 논리 machine처럼 연결한 시스템이다.
중국 기사에서 이 다섯 표현이 모두 晶圆级, 超节点, 大芯片 같은 단어로 섞이면 회사가 많아 보인다. 엄격히 분류하면 공개 hardware evidence를 가진 주체는 훨씬 적다.
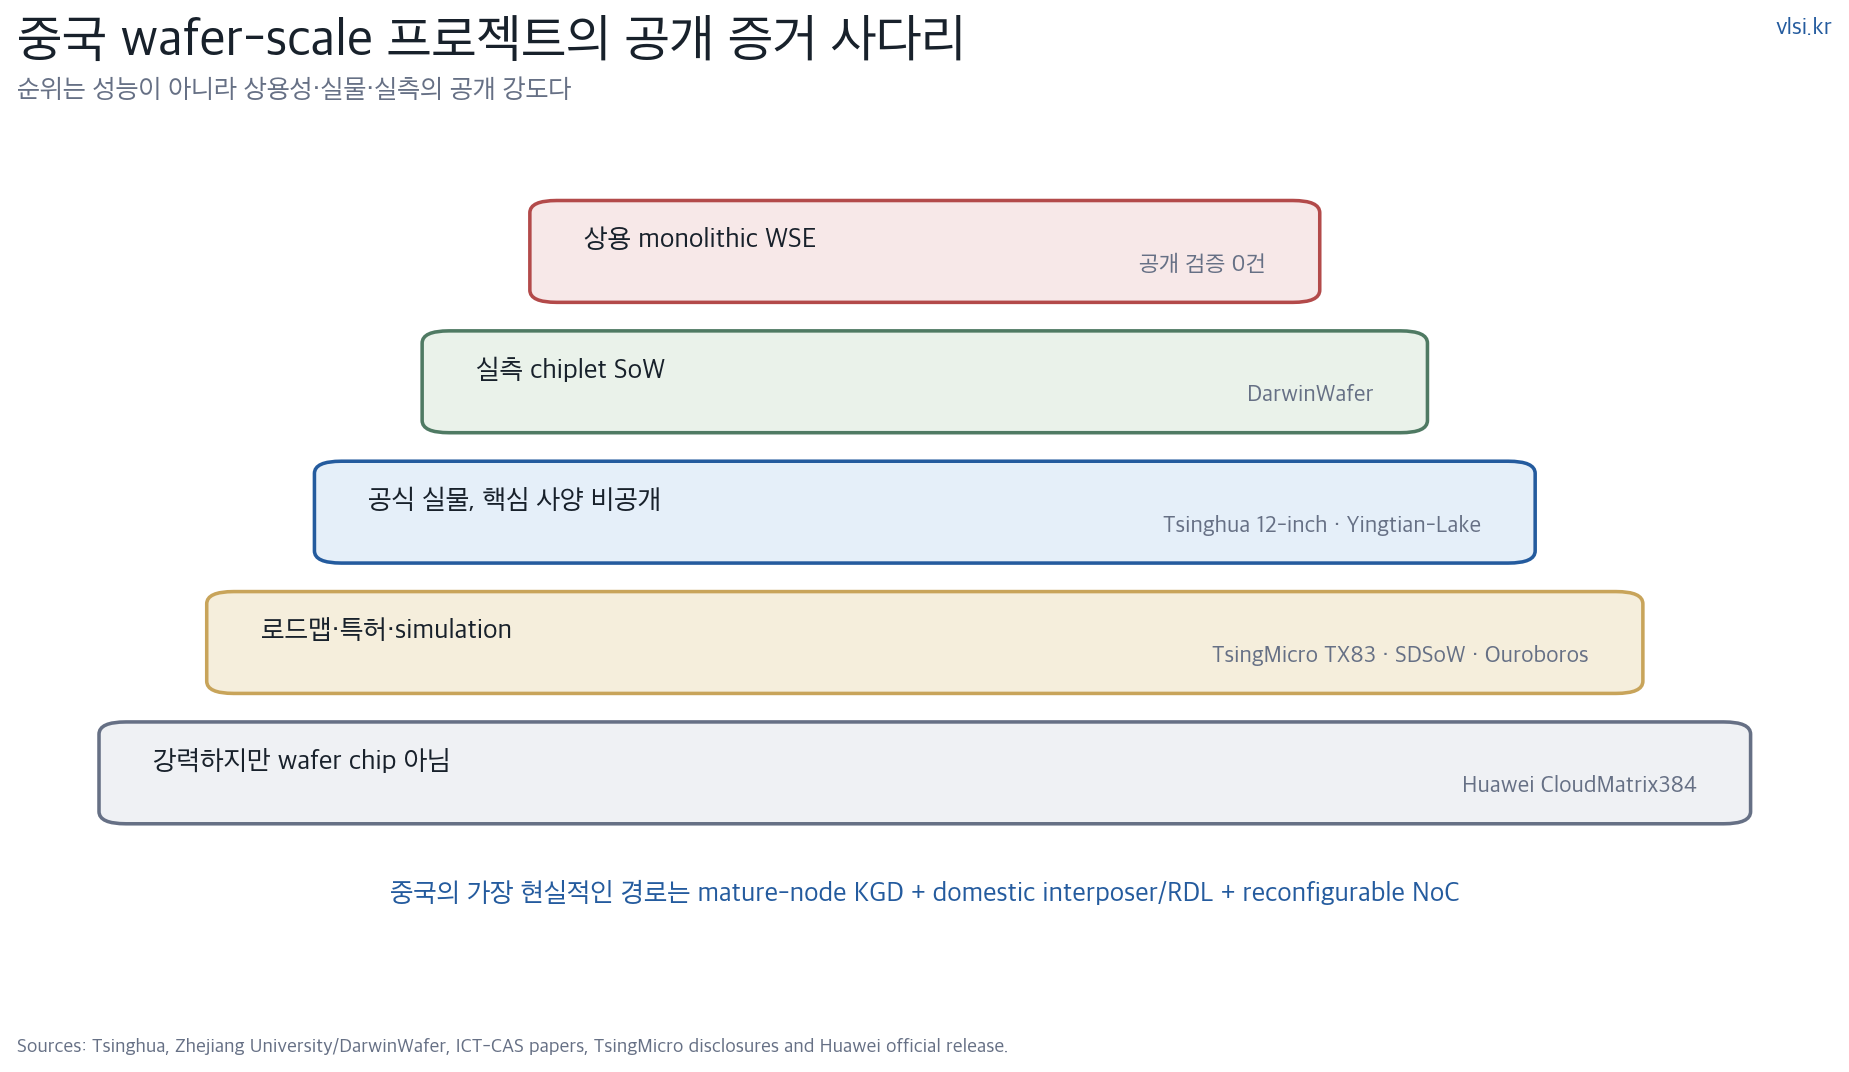
2. 증거등급표: 누가 무엇을 실제로 보여 줬나
| 프로젝트·주체 | 형태 | 공개 증거 | 등급 | 현재 판단 |
|---|---|---|---|---|
| Cerebras WSE-3 | monolithic full-wafer compute | 제품 사양, 시스템 판매, SEC 공시, Hot Chips | S: 상용 제품 | 비교 기준이며 중국 본토 회사가 아님 |
| DarwinWafer, Zhejiang University | 64-chiplet, 300 mm SoW | 논문 hardware 측정과 대학 발표 | A: 실측 시제품 | 중국 공개 증거 중 가장 구체적, neuromorphic 전용 |
| Tsinghua 12-inch AI prototype | reconfigurable AI chiplet SoW | 대학 공식 발표와 prototype 사진 | B: 시제품, 핵심 수치 비공개 | 제조 사실은 강함, 성능·yield 검증은 약함 |
| Tsingmicro TX83 | reconfigurable grid와 wafer-level form | 공식 인터뷰의 product roadmap, patent | C+: 기업 roadmap | 가장 유력한 상업화 후보, 출하 증거 없음 |
| CAS ICT Big Chip | reticle 초과 chiplet architecture | peer-reviewed architecture 논문 | C: 연구 framework | 설계 방향이지 full-wafer 제품 발표가 아님 |
| Huawei CloudMatrix384 | 384-chip SuperPoD cloud instance | 공식 제품·keynote 자료 | X: WSI가 아님 | scale-up 경쟁자지만 wafer chip으로 분류하면 오류 |
3. Tsinghua 12인치 시제품: 제조는 확인, 사양은 공백
Tsinghua School of Integrated Circuits의 2025년 공식 글은 Shouyi Yin이 이끄는 팀이 reconfigurable AI chiplet 기반의 중국 첫 12-inch wafer-scale prototype을 개발했다고 밝힌다. architecture, integration과 compiler mapping을 공동 설계했고 관련 산업 chain을 연결했다는 설명도 있다.
Tsinghua의 2025년 주요 연구성과 페이지도 wafer-scale AI chip prototype을 설계·평가했고, on-wafer interconnect와 advanced integration을 mature semiconductor technology로 검증했다고 적는다. 두 자료를 합치면 12-inch hardware가 존재하고 reconfigurable chiplet 접근이라는 점은 공식 확인 범위다.
하지만 node, chiplet 수, physical area, active core 수, SRAM, on-wafer bandwidth, power, temperature, yield, benchmark와 package test 결과는 공개되지 않았다. prototype 사진과 연구성과 선정은 engineering milestone이지만 Cerebras WSE-3와 성능을 비교할 데이터는 아니다.
Tsinghua 글은 협력 회사 이름을 명시하지 않는다. 다만 팀 leader Shouyi Yin이 Tsingmicro를 incubate했고, Tsinghua 전자공학과의 Tsingmicro 공식 인터뷰가 같은 reconfigurable AI chiplet prototype을 보여 준다. 두 프로젝트가 밀접하다는 inference는 강하지만 대학 prototype을 곧바로 Tsingmicro 양산품이라고 단정하지 않는 이유다.
4. Tsingmicro TX83: 중국 회사 중 가장 선명한 roadmap
2025년 10월 Tsinghua 전자공학과 인터뷰에서 Shouyi Yin은 Tsingmicro의 TX83이 reconfigurable compute grid architecture와 wafer-level chip form을 결합할 것이라고 말했다. 같은 인터뷰는 team이 wafer-level chip technology를 확보하고 laboratory prototype을 완성했다고 주장한다.
회사 측은 wafer-level cluster가 동일 compute에서 GPU cluster보다 density를 10~20배 이상 높이고 power를 30% 이상 낮출 수 있다고 말한다. 또 자신들의 architecture 연구가 같은 cost constraint에서 Tesla Dojo Tray보다 평균 2.9배 성능을 냈다고 주장한다. 이 수치들의 workload, process, package, power accounting과 independent reproduction은 해당 인터뷰에 충분히 공개되지 않았다. 따라서 회사 claim으로만 기록한다.
2026년 6월 26일 공개된 CN122285395A patent record은 Beijing Tsingmicro를 assignee로 하고 wafer-level reconfigurable dataflow chip의 fault-tolerance를 다룬다. neighbor PE의 shadow context, heartbeat fault detection과 local routing update를 사용해 failed PE를 backup으로 넘기는 구조다. patent는 회사가 yield와 runtime fault를 구체적으로 연구한다는 증거지만 silicon 구현과 제품 출하의 증거는 아니다.
현재 가장 공정한 표현은 이렇다. Tsingmicro는 중국에서 wafer-scale commercial intent가 가장 선명한 회사이고, lab prototype과 관련 patent도 있다. 그러나 TX83의 tape-out 여부, foundry, node, wafer integration method, HBM 사용 여부, yield와 고객 acceptance는 공개되지 않았다.
5. DarwinWafer: 가장 구체적인 실측, 그러나 다른 workload
DarwinWafer 논문은 300 mm silicon interposer에 64개의 Darwin3 chiplet을 통합한 system-on-wafer를 공개했다. 각 chiplet은 2.35 million neuron과 0.1 billion synapse를 지원해 wafer 합계 0.15 billion neuron과 6.4 billion synapse다.
333 MHz, 0.8 V 조건에서 저자들은 약 100 W, peak 64 TSOPS와 4.9 pJ/SOP를 보고한다. 약 99.7 W 부하에서 최대 supply droop는 10 mV, temperature profile은 34~36°C였다. GALS NoC, AER asynchronous wafer fabric, hierarchical time-step synchronization, PCBlet과 compliant pogo pin까지 공개해 power, clock, I/O와 warpage를 실제 hardware에서 닫았다는 점이 강하다.
Zhejiang University 공식 발표도 single 12-inch wafer에 64개 Darwin-III die를 통합한 SoW blade를 설명한다. 다만 university release의 세계 최초 표현과 AGI 전망은 홍보 문구이며, 기술 판단은 논문의 measured condition을 우선했다.
DarwinWafer가 Cerebras의 직접 대체품은 아니다. spiking neural network와 brain simulation을 위한 neuromorphic architecture이고, 22 nm SOI chiplet을 쓰며 power class도 다르다. 그래도 mature node, known-good chiplet, silicon interposer와 demountable assembly로 full-wafer system을 만들 수 있음을 보여 주는 중국의 가장 강한 공개 proof point다.
6. Big Chip은 제품명이 아니라 area-wall 연구다
Chinese Academy of Sciences Institute of Computing Technology 연구자들이 쓴 The Big Chip: Challenge, model and architecture는 reticle limit, cost와 yield가 만드는 area-wall을 분석하고 chiplet 기반 Big Chip의 performance model과 architecture를 제시한다.
이 논문의 가치는 중국 연구계가 compute density뿐 아니라 interconnect, cost, redundancy와 unified architecture를 system problem으로 다룬다는 데 있다. 그러나 review·architecture paper를 full 12-inch chip의 fabrication announcement로 읽으면 안 된다. 논문에 제시된 model과 scaling concept은 product yield, customer software와 production capacity를 증명하지 않는다.
중국 wafer-scale landscape에서 이런 연구는 중요한 C등급 증거다. Tsinghua의 compiler mapping, Tsingmicro의 fault-tolerance patent, DarwinWafer의 GALS와 assembly처럼 필요한 기술 조각이 서로 다른 기관에서 개발되고 있음을 보여 준다. 조각이 있다는 것과 한 회사가 supply chain 전체를 통합했다는 것은 별개의 주장이다.
7. Huawei CloudMatrix384를 wafer chip이라 부르면 안 된다
Huawei Connect 2025 공식 keynote는 Atlas 900 A3 SuperPoD가 최대 384개의 Ascend 910C chip을 연결하고, CloudMatrix384가 이 SuperPoD 위에 구축된 cloud service instance라고 설명한다. 회사는 최대 300 PFLOPS와 300대 이상 SuperPoD deployment도 주장한다.
이것은 중국의 scale-up system engineering이 상당한 수준이라는 증거다. 동시에 single wafer chip의 증거는 아니다. 여러 server, interconnect device, optical link, CPU와 memory를 rack 규모로 묶은 system이다. wafer-scale과 같은 목표, 즉 많은 accelerator를 하나의 logical computer로 보이게 하는 목표를 다른 물리 계층에서 푼다.
경쟁 측면에서는 오히려 중요한 대조군이다. wafer 내부의 짧고 넓은 link를 얻는 대신 custom yield와 package를 감수할 것인지, 더 많은 개별 chip과 optical network를 쓰고 replaceability와 supply flexibility를 얻을 것인지의 선택이다. Huawei가 SuperPoD를 택했다는 사실을 wafer project 수에 더할 것이 아니라 wafer-scale의 대체 architecture로 봐야 한다.
8. 왜 중국의 현실적 경로는 chiplet SoW인가
여기부터는 공개 프로젝트에서 끌어낸 inference다. Tsinghua prototype은 reconfigurable AI chiplet과 mature technology를 강조하고, DarwinWafer는 22 nm SOI chiplet 64개를 300 mm interposer에 올렸다. Tsingmicro 인터뷰도 mature process, HBM과 high-end switch 의존 축소를 자사의 방향으로 제시한다. 세 사례가 가리키는 공통 경로는 최신 node monolithic stitching보다 known-good chiplet을 wafer 위에서 재구성하는 방식이다.
장점은 defective chiplet을 조립 전에 거르고, compute와 I/O를 서로 다른 공정으로 만들며, spare를 chiplet 또는 PE 수준에 둘 수 있다는 점이다. 국내에서 확보 가능한 mature process의 transistor density 열세를 짧은 on-wafer interconnect와 큰 total silicon area로 일부 보완하려는 전략이다.
하지만 공정 세대 차이가 사라지는 것은 아니다. logic speed, SRAM density, SerDes, power efficiency와 memory interface는 transistor technology의 영향을 받는다. chiplet 수가 늘면 placement, microbump, interposer stitching, warpage, test와 compiler mapping의 실패점도 늘어난다. old node를 넓게 펼치면 advanced node를 자동으로 이긴다는 설명은 company marketing에 가깝다.
결국 중국 방식의 KPI는 wafer 크기가 아니라 good compute per assembled wafer, joule per useful operation, defect-aware mapping loss, package yield와 software utilization이다. 이 수치를 공개하지 않는 한 prototype 사진만으로 산업 경쟁력을 평가할 수 없다.
9. 공개되지 않은 것과 다음 확인 지점
Tsinghua prototype의 node, chiplet 수, reticle stitch 방식, active area, SRAM, internal·external bandwidth, power, thermal result와 yield는 공개되지 않았다. Tsingmicro TX83의 tape-out, package supplier, final test, compiler maturity, customer sample과 shipping schedule도 확인되지 않는다. patent application은 product bill of materials가 아니다.
DarwinWafer는 가장 자세하지만 wafer assembly yield, 여러 wafer 간 분포, long-duration reliability, pogo contact aging, production test time과 external customer deployment가 없다. Big Chip은 architecture framework이고 Huawei는 rack-scale SuperPoD다. 중국 본토에서 commercial monolithic WSE의 출하량과 고객 사례를 보여 주는 primary source는 확인하지 못했다.
- TX83: silicon photo보다 node, chiplet·PE 수, active yield와 customer sample 공개 여부
- Tsinghua: 12-inch prototype의 measured bandwidth, power와 compiler utilization 논문
- DarwinWafer: 두 개 이상 wafer의 yield distribution, burn-in과 장기 contact reliability
- Patent to product: heartbeat·shadow context fault recovery가 실제 silicon에서 recovery latency와 overhead로 측정되는지
- Supply chain: domestic interposer, RDL, bonding, probe와 liquid-cooling line이 반복 생산을 지원하는지
Contrarian read: 공개 자료가 중국의 실제 수준을 과소평가할 수 있다
내 결론의 가장 큰 약점은 public evidence를 실제 capability와 동일시한다는 점이다. wafer-scale은 공정 recipe, yield, package와 고객 workload가 모두 민감한 분야라 회사와 국책 연구팀이 핵심 수치를 공개하지 않을 유인이 크다. Tsinghua가 12-inch prototype을 만들었다고 공식 확인하면서도 사양을 거의 밝히지 않은 사실은 undercount 가능성을 보여 준다.
반대로 비공개를 성능의 증거로 사용할 수도 없다. lab prototype, award, patent와 roadmap이 동시에 있어도 반복 제조수율과 software throughput이 없으면 commercial system으로 평가하기 어렵다. 내 등급이 뒤집히는 조건은 단순한 새 발표가 아니라 고객이 확인한 TX83 sample, 여러 wafer의 measured distribution, final test·burn-in flow와 workload scaling data가 나오는 경우다.
10. 연재의 최종 결론: 웨이퍼보다 시스템 정의가 먼저다
8편을 관통한 결론은 wafer-scale이 큰 chip을 만드는 기술이 아니라 결함이 있는 넓은 실리콘을 하나의 serviceable computer로 만드는 기술이라는 점이다. 수율은 spare와 routing의 문제로, reticle limit은 stitch와 chiplet integration의 문제로, bus는 mesh와 compiler의 문제로 바뀐다. 외부 I/O, power, cooling과 test는 package 뒤에 남는 부속이 아니라 architecture를 처음부터 제한한다.
Cerebras는 monolithic WSE가 상업 시스템이 될 수 있음을 보여 줬지만 실제 wafer·package yield와 workload별 utilization을 공개하지 않았다. TSMC의 SoW roadmap과 중국의 DarwinWafer·Tsinghua prototype은 chiplet-on-wafer가 더 넓은 산업 경로가 될 가능성을 보여 준다. 이 방식은 KGD와 process mix를 얻는 대신 assembly yield, clock, test와 warpage를 새로 해결해야 한다.
중국을 과소평가할 이유도 과대평가할 이유도 없다. measured prototype과 architecture·patent 기반은 분명 빠르게 쌓이고 있다. 그러나 공개 증거의 현재 위치는 여러 상용 Cerebras 경쟁사가 아니라 한 개의 구체적 neuromorphic SoW, 한 개의 사양 비공개 12-inch AI prototype, 한 회사의 제품 roadmap과 여러 연구 조각이다.
누가 이길지는 wafer 면적이나 peak TOPS가 결정하지 않는다. defect map을 compiler가 얼마나 적은 성능 손실로 흡수하는지, assembled wafer를 반복 생산할 수 있는지, kA급 power와 cold plate를 field에서 service할 수 있는지, 외부 memory traffic을 얼마나 줄이는지가 결정한다. 웨이퍼가 곧 컴퓨터가 되는 순간, 반도체 회사는 system company가 되어야 한다.
실무 적용 한 줄
Sources
- Tsinghua School of Integrated Circuits, 12-inch reconfigurable AI chiplet prototype (대학 공식 발표, 2025-07-23)
- Tsinghua University, 2025 notable research achievements (대학 공식 발표)
- Tsinghua EE interview with Tsingmicro founder Shouyi Yin (회사·연구자 주장, 2025-10-17)
- CN122285395A, wafer-level reconfigurable dataflow fault tolerance (patent document mirror, 2026-06-26)
- Zhu et al., DarwinWafer (연구팀 논문과 hardware 측정)
- Zhejiang University, DarwinWafer and Wukong announcement (대학 공식 발표)
- Han et al., The Big Chip: Challenge, model and architecture (open-access peer-reviewed paper)
- Huawei Connect 2025, SuperPoD keynote (회사 공식 발표)
- Cerebras, WSE-3 at Hot Chips 2024 (글로벌 상용 비교 기준)
자주 묻는 질문
중국에 상용 monolithic wafer-scale engine이 출하되고 있는가?
2026년 7월 15일 공개 자료 기준, 중국 본토에 Cerebras와 같은 상용 monolithic wafer-scale engine이 출하된다는 검증 가능한 증거는 없다. 대학 시제품, chiplet SoW, architecture 논문, 회사 roadmap과 특허가 쌓이는 단계다.
DarwinWafer는 어떤 실측을 제시했는가?
저장대의 DarwinWafer는 300mm interposer에 64개 chiplet을 통합하고 약 100W, 64 TSOPS, 최대 10mV droop, 34~36°C를 논문으로 제시했다. 다만 neuromorphic chiplet-on-wafer이지 범용 LLM용 monolithic WSE가 아니다.
Tsingmicro TX83의 공개 수준은 어느 정도인가?
Reconfigurable compute grid와 wafer-level form을 결합하겠다는 공식 인터뷰가 확인된다. 그러나 TX83의 node, core 수, yield, 고객 출하, benchmark는 공개되지 않아 roadmap 단계로 분류된다.
Huawei CloudMatrix384를 wafer-scale chip으로 보면 왜 오류인가?
CloudMatrix384는 384개 Ascend 910C를 연결한 SuperPoD 기반 cloud instance, 즉 supernode이기 때문이다. Wafer-level packaging이나 big chip과 wafer-scale chip을 같은 말로 쓰면 중국의 진척을 과장하게 된다.