VLSI Korea
웨이퍼가 곧 컴퓨터가 될 때 ④: 버스가 사라진 자리, NoC와 컴파일러
90만 코어를 하나의 bus에 물릴 수는 없다. wafer-scale의 실제 아키텍처는 각 코어 옆 router와 SRAM을 반복한 2D mesh이고, compiler가 연산과 데이터를 물리 좌표에 배치해 통신을 짧게 만드는 공간 컴퓨터다. 214Pbit/s라는 집계 대역폭도 bisection 성능과는 다르다.


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
핵심 주장: wafer-scale chip은 큰 프로세서가 아니라 물리 좌표를 가진 분산 컴퓨터이며, compiler가 그 좌표에 프로그램을 배치하는 순간에야 하나의 칩이 된다.
1. 왜 전역 bus는 웨이퍼까지 갈 수 없는가
bus는 여러 master와 slave가 한 묶음의 wire를 시간 분할해 쓰는 구조다. endpoint가 적고 거리가 짧을 때 단순하고 효율적이다. 하지만 코어가 늘면 요청을 중재하는 arbiter의 fan-in이 커지고, 긴 wire의 capacitance와 repeater가 전력을 먹는다. 같은 clock edge 안에 웨이퍼 반대편까지 신호를 보내려면 과도한 pipeline이 필요하고, 한 번에 한 transaction만 통과하는 공유 구간이 전체 throughput을 제한한다.
full crossbar도 답이 아니다. N개 source와 N개 destination을 직접 연결하는 crossbar의 교차점과 wire는 대략 N²으로 증가한다. 900,000 endpoint에서 물리적으로 배치할 수 없는 규모다. 계층형 bus를 만들면 결국 switch와 router가 생기고 NoC가 된다. wafer-scale에서 선택지는 bus냐 network냐가 아니라 어떤 topology와 flow control을 쓰느냐에 가깝다.
또한 물리 거리가 문제다. 300mm wafer의 유효 사각 영역을 가로지르는 wire는 대형 GPU 내부 global wire보다 훨씬 길다. 반복 코어를 촘촘히 놓아도 전역 clock, reset과 coherence를 평평한 한 층으로 배포하면 skew와 전력망이 폭발한다. 그래서 계산, SRAM, router와 제어를 작은 tile 안에 묶고 통신은 인접 tile 사이 hop으로 전달하는 구조가 자연스럽다.
2. WSE의 답: PE 옆 SRAM, router, 그리고 2D mesh
Cerebras의 공식 architecture deep dive는 WSE-2의 router를 동서남북 link와 local core port를 가진 단순한 5-port 구조로 설명한다. cardinal direction마다 32-bit bidirectional interface가 있고 작은 packet은 FP16 data 16bit와 control 16bit로 구성된다. 24개의 독립 static route를 color라고 부르며 physical link 위에서 time-multiplex한다. multicast와 broadcast도 router가 직접 지원한다.
WSE-3의 Hot Chips 발표에서는 PE당 48KB SRAM, 84개 field와 900k active core, 21PB/s aggregate SRAM bandwidth가 제시된다. Cerebras SDK 설명은 fabric의 peak aggregate를 214Pbit/s라고 밝힌다. 이 구조의 핵심은 cache hierarchy를 거쳐 먼 shared memory에 접근하는 대신 각 PE가 자신이 사용할 data와 instruction을 가까운 SRAM에 보관한다는 점이다.
이 설계는 dataflow와 spatial computer의 성격을 가진다. packet이 도착하면 특정 task가 실행되고 결과가 다음 PE로 흐른다. matrix multiply의 일부, stencil cell, activation과 gradient의 조각을 물리 PE 영역에 배치하면 데이터가 가까운 이웃 사이를 이동한다. memory access와 communication을 계산 graph의 edge로 노출하기 때문에 hardware는 단순해지지만 compiler의 책임은 커진다.
reticle seam도 같은 mesh를 연장한다. field 사이에는 source-synchronous parallel interface와 redundancy가 들어가지만 논리 topology는 유지된다. defect map으로 물리 core와 link 일부를 제외한 뒤에도 software에 uniform grid를 보이게 하는 것이 목표다. 따라서 routing layer는 성능 기능인 동시에 yield 복구 기능이다.
3. 214Pbit/s를 그대로 믿으면 생기는 세 가지 오류
| 지표 | 무엇을 더한 값인가 | 알 수 있는 것 | 알 수 없는 것 |
|---|---|---|---|
| 214Pbit/s peak fabric aggregate | 수많은 local link가 동시에 전달할 수 있는 이론 peak | 전체 mesh의 병렬 local 이동 잠재력 | 한 tensor가 wafer를 횡단하는 속도, bisection, 실제 utilization |
| 21PB/s aggregate SRAM bandwidth | 900k PE 근처 SRAM port의 read와 write 능력 합계 | data가 올바르게 분산됐을 때 local feed 능력 | 44GB 전체를 한 PE가 읽는 속도, 외부 weight 공급 속도 |
| 평균 hop 수 | compiler가 배치한 producer와 consumer 거리 | latency, link energy와 congestion의 핵심 원인 | 제품 사양표만으로는 계산 불가 |
| bisection bandwidth | mesh를 둘로 나누는 cut을 가로지르는 link 용량 | global shuffle, all-to-all와 collective의 상한 | aggregate link 합계와 동일하지 않음 |
| application bandwidth | 충돌, route, schedule, protocol overhead 후 유효 data | 실제 workload 성능 | kernel과 mapping 없이 일반화 불가 |
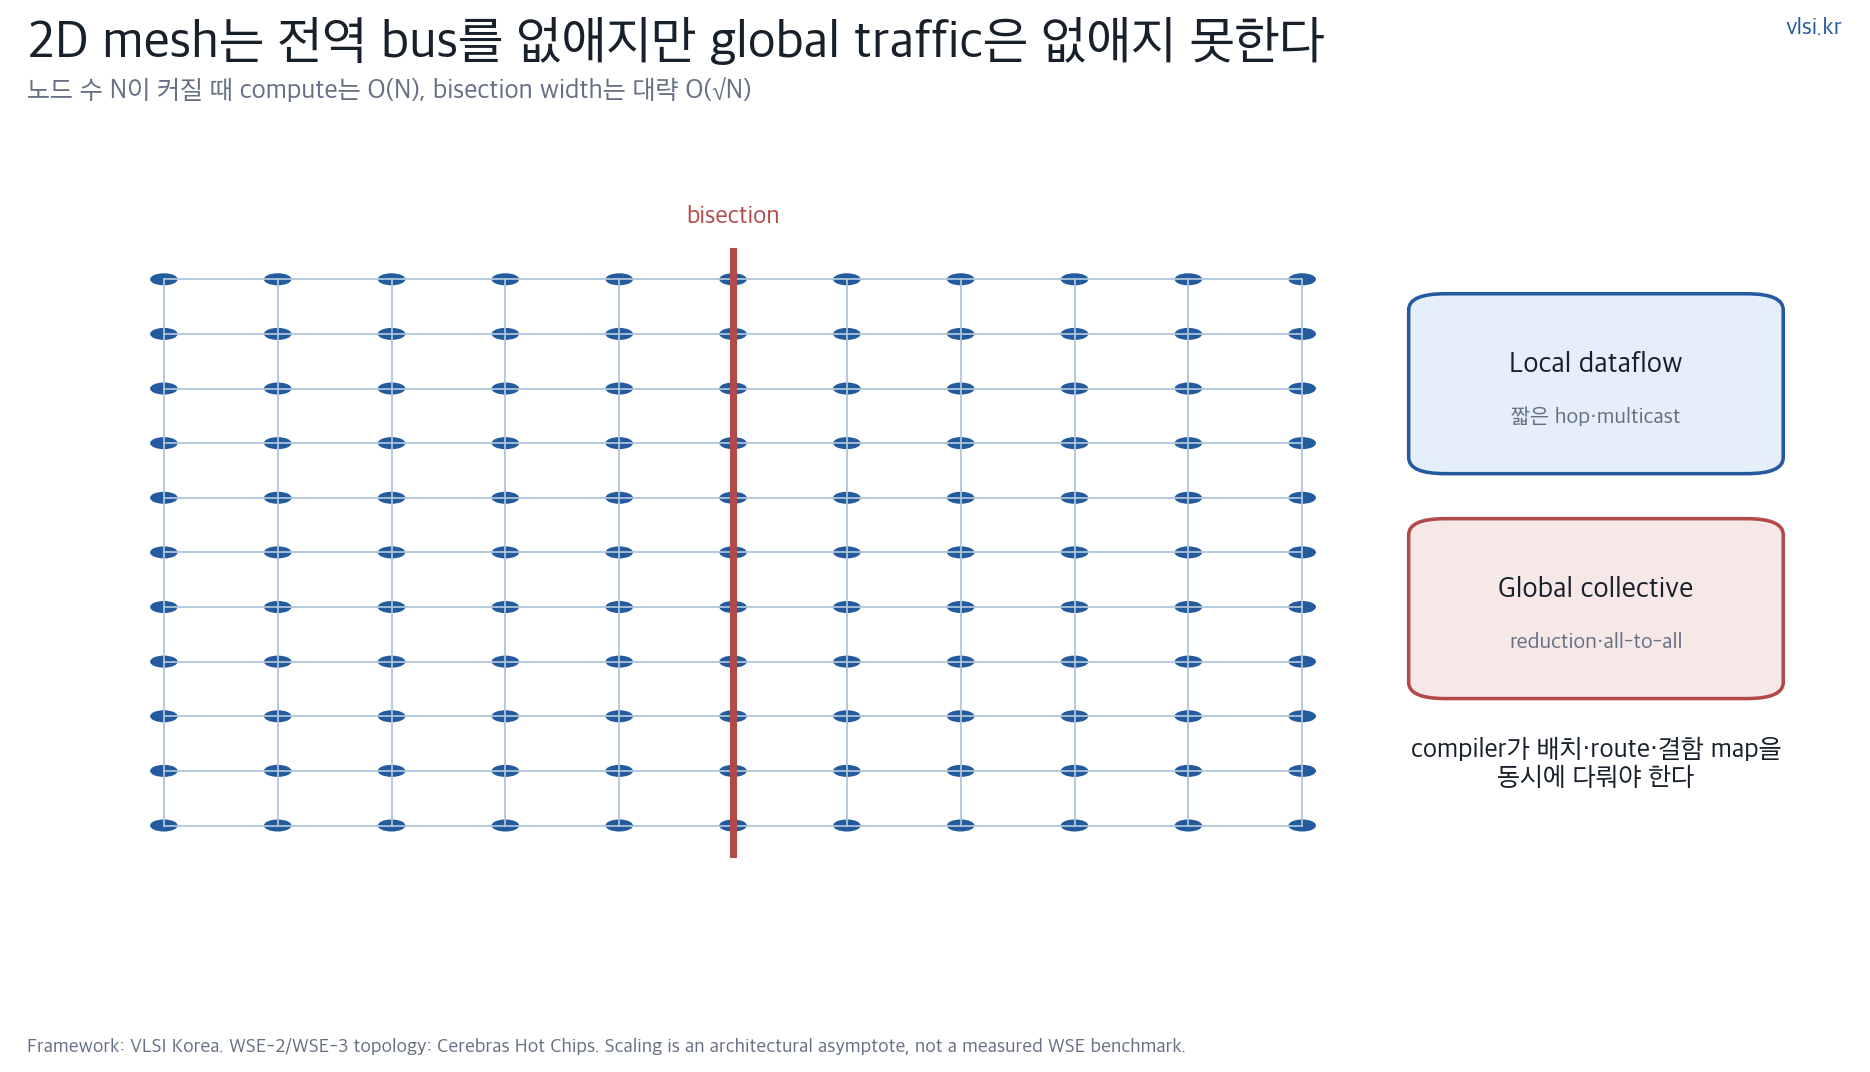
직관적으로 N개 node의 정사각형 2D mesh는 한가운데 cut을 건너는 link 수가 대략 √N에 비례한다. node와 local link 총수는 N에 비례해 늘지만 wafer 왼쪽 절반에서 오른쪽 절반으로 동시에 보낼 수 있는 능력은 훨씬 느리게 증가한다. 900k core라는 숫자만으로 실제 mesh dimension을 확정할 수는 없지만, topology의 scaling law는 global traffic을 자동으로 해결하지 않는다는 점을 보여준다.
그래서 aggregate bandwidth가 커질수록 locality가 더 중요해지는 역설이 생긴다. 대부분의 link를 동시에 쓰려면 각 PE가 가까운 이웃과 독립적으로 통신해야 한다. 한 source의 data를 모든 destination으로 보내거나 모든 PE 결과를 하나로 모으면 중앙 cut과 root 주변 link가 혼잡해진다. hardware multicast와 tree reduction이 필요한 이유다.
4. static routing은 원시적인가, workload에 맞춘 최적화인가
데이터센터 network는 packet이 수시로 생기고 destination이 바뀌므로 dynamic routing과 큰 buffer가 유용하다. neural network graph와 stencil은 반복 iteration 동안 통신 패턴이 비교적 고정돼 있다. 이 경우 compiler가 미리 route와 time slot을 정하면 header, arbitration, queue와 deadlock 회피의 runtime overhead를 줄일 수 있다. Cerebras의 color는 여러 logical route를 같은 physical link에 분리해 실어주는 virtual channel 역할을 한다.
static 방식의 비용은 불확실성을 software로 넘긴다는 점이다. input shape, sparsity, expert selection이나 conditional branch가 바뀌면 실제 traffic이 compile-time 예측과 달라질 수 있다. 하나의 route가 과부하돼도 adaptive router가 빈 link로 자동 분산하지 않을 수 있다. compiler가 최악 traffic을 보수적으로 잡으면 link가 놀고, 평균을 기준으로 잡으면 burst에서 backpressure가 생긴다.
결함 우회도 같은 trade-off를 가진다. runtime마다 경로를 찾지 않고 출하 또는 boot 때 확정한 healthy topology에 맞춰 route를 만들면 router가 단순해진다. 하지만 aging으로 새 결함이 생기거나 field replace를 해야 한다면 재compile 또는 새로운 configuration이 필요하다. 어떤 수준의 dynamic remap이 가능한지는 공개 자료만으로 확인되지 않는다.
5. compiler가 풀어야 하는 문제는 instruction selection보다 크다
Graph partition: model의 operator와 tensor를 PE group으로 나누고 compute load와 memory footprint를 균형화한다. 48KB local SRAM을 넘는 working set은 다른 PE로 분산하거나 외부 memory와 stream해야 한다.
Placement: 많이 통신하는 producer와 consumer를 가깝게 둔다. matrix tile, activation, gradient와 optimizer state를 어느 물리 좌표에 놓을지 정하며 defect로 제외된 영역과 seam을 고려한다.
Routing: 각 tensor edge에 color와 physical path를 할당한다. 같은 link를 동시에 요구하는 edge를 분리하고 multicast tree와 reduction tree를 만든다. buffer가 작으므로 cyclic dependency와 backpressure도 피해야 한다.
Scheduling: compute, SRAM read와 packet send 시점을 맞춘다. 한 PE의 결과가 늦어 전체 wavefront가 멈추지 않도록 pipeline을 구성하고, communication과 arithmetic을 겹친다.
Memory allocation: distributed SRAM의 주소와 lifetime을 관리한다. cache가 자동으로 data를 가져오는 구조가 아니므로 tensor shard를 어느 PE가 소유하고 언제 재사용할지 compile-time에 결정하는 비중이 크다.
Configuration and test: 정상 core와 link로 만든 logical mesh에 mapping을 맞추고, route가 hardware resource와 timing 조건을 만족하는지 확인한다. compile report가 utilization과 예상 성능을 보여주는 이유다.
Cerebras는 PyTorch compiler 설명에서 ATen 연산을 MLIR 기반 CIRH 중간표현에 mapping하고 최종적으로 PE 배치가 포함된 실행물을 만든다고 설명한다. 개발자 문서도 compile 결과가 neural network operation과 PE의 mapping을 담는다고 밝힌다. 고수준 framework 호환은 front end이고 실제 차별화는 이 거대한 place-and-route backend에 있다.
6. 어떤 workload가 mesh를 사랑하고, 어떤 workload가 괴롭히는가
잘 맞는 패턴: stencil, finite difference, local convolution, systolic matrix tile과 규칙적인 dataflow는 가까운 이웃이 반복 통신한다. 2D 물리 구조에 자연스럽게 embed할 수 있고 wavefront를 pipeline하면 대부분 link가 병렬로 일한다. 각 PE의 local SRAM도 작은 working set을 계속 재사용하는 계산에 유리하다.
조건부로 맞는 패턴: dense matrix multiplication과 transformer layer는 tiling과 multicast, reduction을 잘 설계하면 높은 locality를 얻는다. 하지만 44GB on-chip SRAM보다 큰 weight는 외부에서 stream하거나 여러 시스템에 layer를 나눠야 한다. on-wafer NoC가 빨라도 off-wafer 공급과 layer boundary가 전체 latency를 제한할 수 있다.
어려운 패턴: global all-to-all, 대규모 transpose, 불규칙 graph traversal과 token별 MoE routing은 먼 destination으로 traffic을 흩뿌린다. attention과 optimizer의 collective도 reduction tree와 placement가 나쁘면 좁은 cut에 몰린다. load imbalance가 생기면 빈 PE와 바쁜 link가 동시에 존재한다.
Near-Optimal Wafer-Scale Reduce 연구는 WSE의 Reduce와 AllReduce를 모델링하고 새 알고리즘이 당시 vendor solution보다 최대 3.27배 빠르며 예측 오차가 4% 미만이라고 보고했다. 이는 연구진의 실측 결과다. 놀라운 부분은 hardware가 바뀌지 않아도 collective mapping만으로 3배 이상 차이가 났다는 점이다. peak fabric 숫자보다 algorithm과 compiler가 성능을 좌우한다는 강한 증거다.
7. bisection을 이기는 네 가지 방법
첫째는 communication avoidance다. data를 이동하기보다 계산을 복제하고 local SRAM에서 재사용한다. 추가 FLOP가 먼 byte 이동보다 싸다면 옳은 교환이다. 둘째는 hierarchical collective다. 각 지역에서 먼저 reduce한 뒤 작은 결과만 상위 tree로 보낸다. 셋째는 topology-aware placement다. tensor parallel group과 pipeline stage의 물리 경계를 traffic cut과 맞춘다. 넷째는 in-network combine다. router나 PE가 지나가는 partial result를 합쳐 link traffic을 줄인다.
이 방법들은 network hardware 하나로 자동 제공되지 않는다. model parallelism 전략, batch와 sequence length, tensor shape에 따라 최적 tree와 tile이 달라진다. compiler가 모든 경우를 완벽히 예측하기 어렵기 때문에 vendor library, auto-tuning과 performance model이 필요하다. 사용자에게 익숙한 PyTorch API를 제공하더라도 내부에서는 HPC domain decomposition과 physical design에 가까운 최적화가 수행된다.
또한 fault tolerance와 성능을 함께 봐야 한다. 결함을 우회한 logical mesh가 기능적으로 직사각형이어도 일부 지역 route가 길어질 수 있다. compiler가 그런 지역을 피하거나 traffic이 적은 연산을 배치하면 spec을 유지할 수 있다. 반대로 모든 결함을 감춘다는 추상화가 실제 hop variation까지 숨기면 예상치 못한 hotspot이 생긴다. defect-aware mapping의 공개 수준이 중요한 이유다.
8. clock, coherence와 programming model의 선택
wafer 전체를 하나의 낮은-skew clock domain으로 보는 것은 물리적으로 부담이 크다. 일반적인 대규모 설계는 계층형 clock distribution, 지역 domain, source-synchronous link나 GALS를 조합한다. Cerebras 공개 자료는 field boundary link를 source-synchronous라고 설명하지만 WSE-3 전체 clock tree와 domain 구조는 공개하지 않는다. 따라서 wafer 전체가 완전 동기라는 식의 단정은 피해야 한다.
cache coherence도 같은 문제다. 900k core에 전통적 snoop이나 거대한 directory coherence를 제공하면 metadata와 invalidation traffic이 폭발한다. WSE가 local SRAM ownership과 explicit data movement를 택한 것은 단순한 메모리 선택이 아니라 coherence 비용을 compiler로 옮긴 선택이다. programmer는 tensor와 stream을 다루고 compiler가 분산 주소와 이동을 구현한다.
이 programming model이 성공하려면 두 사용자층을 모두 만족시켜야 한다. ML 사용자는 PyTorch graph가 별도 parallel code 없이 compile되기를 원한다. HPC 개발자는 PE별 memory, route와 task를 직접 제어해 stencil이나 FFT를 튜닝하고 싶다. 높은 수준의 portability와 낮은 수준의 spatial control 사이에서 안정적인 abstraction을 제공하는 것이 hardware 못지않은 장벽이다.
9. Contrarian read: 가장 빠른 network가 가장 범용적인 computer는 아니다
on-wafer wire의 물리는 강력하다. 수십 cm cable과 SerDes를 거치는 GPU cluster보다 짧은 silicon wire가 bit당 에너지와 latency에서 유리한 것은 당연하다. 그러나 그 이점을 얻으려면 문제를 2D 공간에 맞게 분해하고 data를 local SRAM에 계속 머물게 해야 한다. workload가 이를 허용하지 않으면 많은 link의 aggregate peak는 사용되지 않는다.
반대로 범용 dynamic network는 overhead가 크지만 irregular traffic과 multi-tenant workload를 더 유연하게 처리한다. wafer-scale이 모든 accelerator와 cluster를 대체하기보다 반복적이고 통신집약적인 특정 graph에서 압도적인 spatial machine이 될 가능성이 크다. 성공의 기준도 peak FLOPS가 아니라 compile 가능한 model 범위, mapping 안정성, 외부 memory와 cluster를 포함한 end-to-end time-to-solution이다.
10. 공개되지 않은 것: NoC 성능표의 빈칸
- WSE-3의 정확한 mesh dimension, direction별 link width와 frequency, seam과 field 내부 link의 차이.
- 214Pbit/s 집계값에서 protocol, disabled link, routing reservation을 뺀 sustainable bandwidth.
- wafer 중앙 bisection과 여러 traffic pattern에서의 측정 대역폭, latency 분포와 congestion counter.
- defect map이 compiler에 노출되는 수준, 결함 우회가 평균 hop과 정격 성능에 미치는 영향.
- global clock과 power domain 구조, clock failure를 격리하는 범위.
- compile time, 대형 model의 place-and-route 실패율, remapping 결정성과 compiler version별 성능 변화.
- MoE, all-to-all, attention과 optimizer collective에 대한 동일 조건의 독립 benchmark.
이 빈칸 때문에 외부 분석은 peak 숫자만으로 application 성능을 계산할 수 없다. 확인 가능한 사실은 규칙적 local dataflow를 위해 hardware와 compiler가 공동 설계됐고, 실제 collective 연구에서 algorithm만으로 큰 성능 차이가 관측됐다는 것이다. 나머지는 workload별 실측으로 채워야 한다.
출처와 방법
- Cerebras WSE-3 Hot Chips 2024: 84 field, 900k core, 48KB/PE와 mesh 구조.
- Cerebras Architecture Deep Dive: 5-port router, 32-bit interface, 24 color와 field boundary.
- Cerebras SDK 공식 설명: WSE-3 214Pbit/s aggregate fabric와 48KB local memory.
- Supporting PyTorch on WSE: MLIR 기반 compiler flow와 mapping.
- Near-Optimal Wafer-Scale Reduce: Reduce와 AllReduce의 독립 연구 실측 및 성능 모델.
- Cerebras 2024 S-1: 44GB SRAM, 21PB/s와 시스템 설명.
회사 공개 사양은 peak aggregate라고 명시했으며 bisection이나 measured application bandwidth로 변환하지 않았다. 2D mesh scaling과 compiler 역할은 topology에서 도출되는 분석이고, WSE-3의 미공개 clock과 route 세부를 임의로 채우지 않았다. 3.27배와 4% 미만은 해당 논문의 실측 및 모델 결과다. 자료 기준일은 2026년 7월 15일이다.