VLSI Korea
d-Matrix企業価値20億ドルの内訳 — SRAM内で演算するCorsairと3DIMCの賭け
d-Matrixは2025年11月、企業価値20億ドルで2億7,500万ドルのSeries Cを完了した。SRAM内部で演算するDIMCアーキテクチャCorsairはなぜこの価格なのか。帯域幅の物理、SRAMのプロセス経済学、Raptor 3DIMCのロードマップと、20億ドルが成立する条件を解剖する。


30秒サマリー
d-Matrixの企業価値20億ドルは、推論の経済性が不足している唯一のもの、すなわちチップの外に出ないメモリ帯域幅を買う価格である。サンタクララのスタートアップd-Matrixは2025年11月12日、企業価値20億ドルで2億7,500万ドルのSeries Cを完了し、累計調達額は4億5,000万ドルに達した。主力アクセラレータCorsairは、SRAM内部で演算するDigital In-Memory Computing(DIMC)により、カード当たり150TB/sのオンチップ帯域幅、Llama 70Bで毎秒30,000トークン・トークン当たり2msをうたい、GPUベースのシステム比で3〜5倍のエネルギー効率を主張する。Corsairは2026年6月に量産に入った。20億ドルは今日の売上への対価ではない。推論がAIコストの中心になるとき、勝つアーキテクチャは演算ではなくメモリを製品にする側だというオプションへの対価である。
| 項目 | 内容 |
|---|---|
| 企業価値 | $2B(Series C、2025年11月12日) |
| 累計調達 | $450M |
| 製品 | Corsair(DIMC、TSMC 6nm) |
| 演算性能 | 2,400 TFLOPS(8-bit) |
| オンチップメモリ | 2GB SRAM、150 TB/s |
| オフチップメモリ | 最大256GB LPDDR5 |
| 次世代 | Raptor / 3DIMC(2026年末テープアウト目標) |
Background:AIの後半戦のために設立された会社
d-Matrixは2019年、米カリフォルニア州サンタクララでSid Sheth(CEO)とSudeep Bhoja(CTO)が設立した。創業時の賭けは当時主流ではなかった。学習(training)がAIのボトルネックであり続けることはないという判断である。モデルは一度学習されれば、課金ユーザーに対して継続的かつ大規模に質問へ答え続けなければならない。その提供フェーズである推論(inference)こそが業界最大のコストになる。d-Matrixは市場が同意する6年前から、そのフェーズのための半導体を作り続けてきた。
資金調達の履歴は、この仮説への共感が広がった軌跡である。2023年の1億1,000万ドルのラウンドでMicrosoftのベンチャーファンドM12が参加した。2025年11月のSeries CはBullhoundCapital、Triatomic Capital、Temasekが共同主導し、カタール投資庁(QIA)とシンガポールのEDBIが新規参加、M12、Nautilus Venture Partners、Industry Ventures、Mirae Assetがフォローオンした。累計調達額は4億5,000万ドル、従業員はサンタクララ、トロント、シドニー、バンガロール、ベオグラードで250人を超えた。
タイミングも重要である。2025年末までにハイパースケーラーは設備投資の重心を学習クラスターから推論フリートへ移し、業界の問いは「どれだけ速く学習できるか」から「トークン1個の原価はいくらか」へ変わった。d-Matrixは初日から2番目の問いのために設計した数少ないスタートアップの一つである。量産前段階のチップ企業に対する20億ドルの評価は、この背景の上で読むべきである。
Business Deep Dive
製品:重みがある場所で演算する
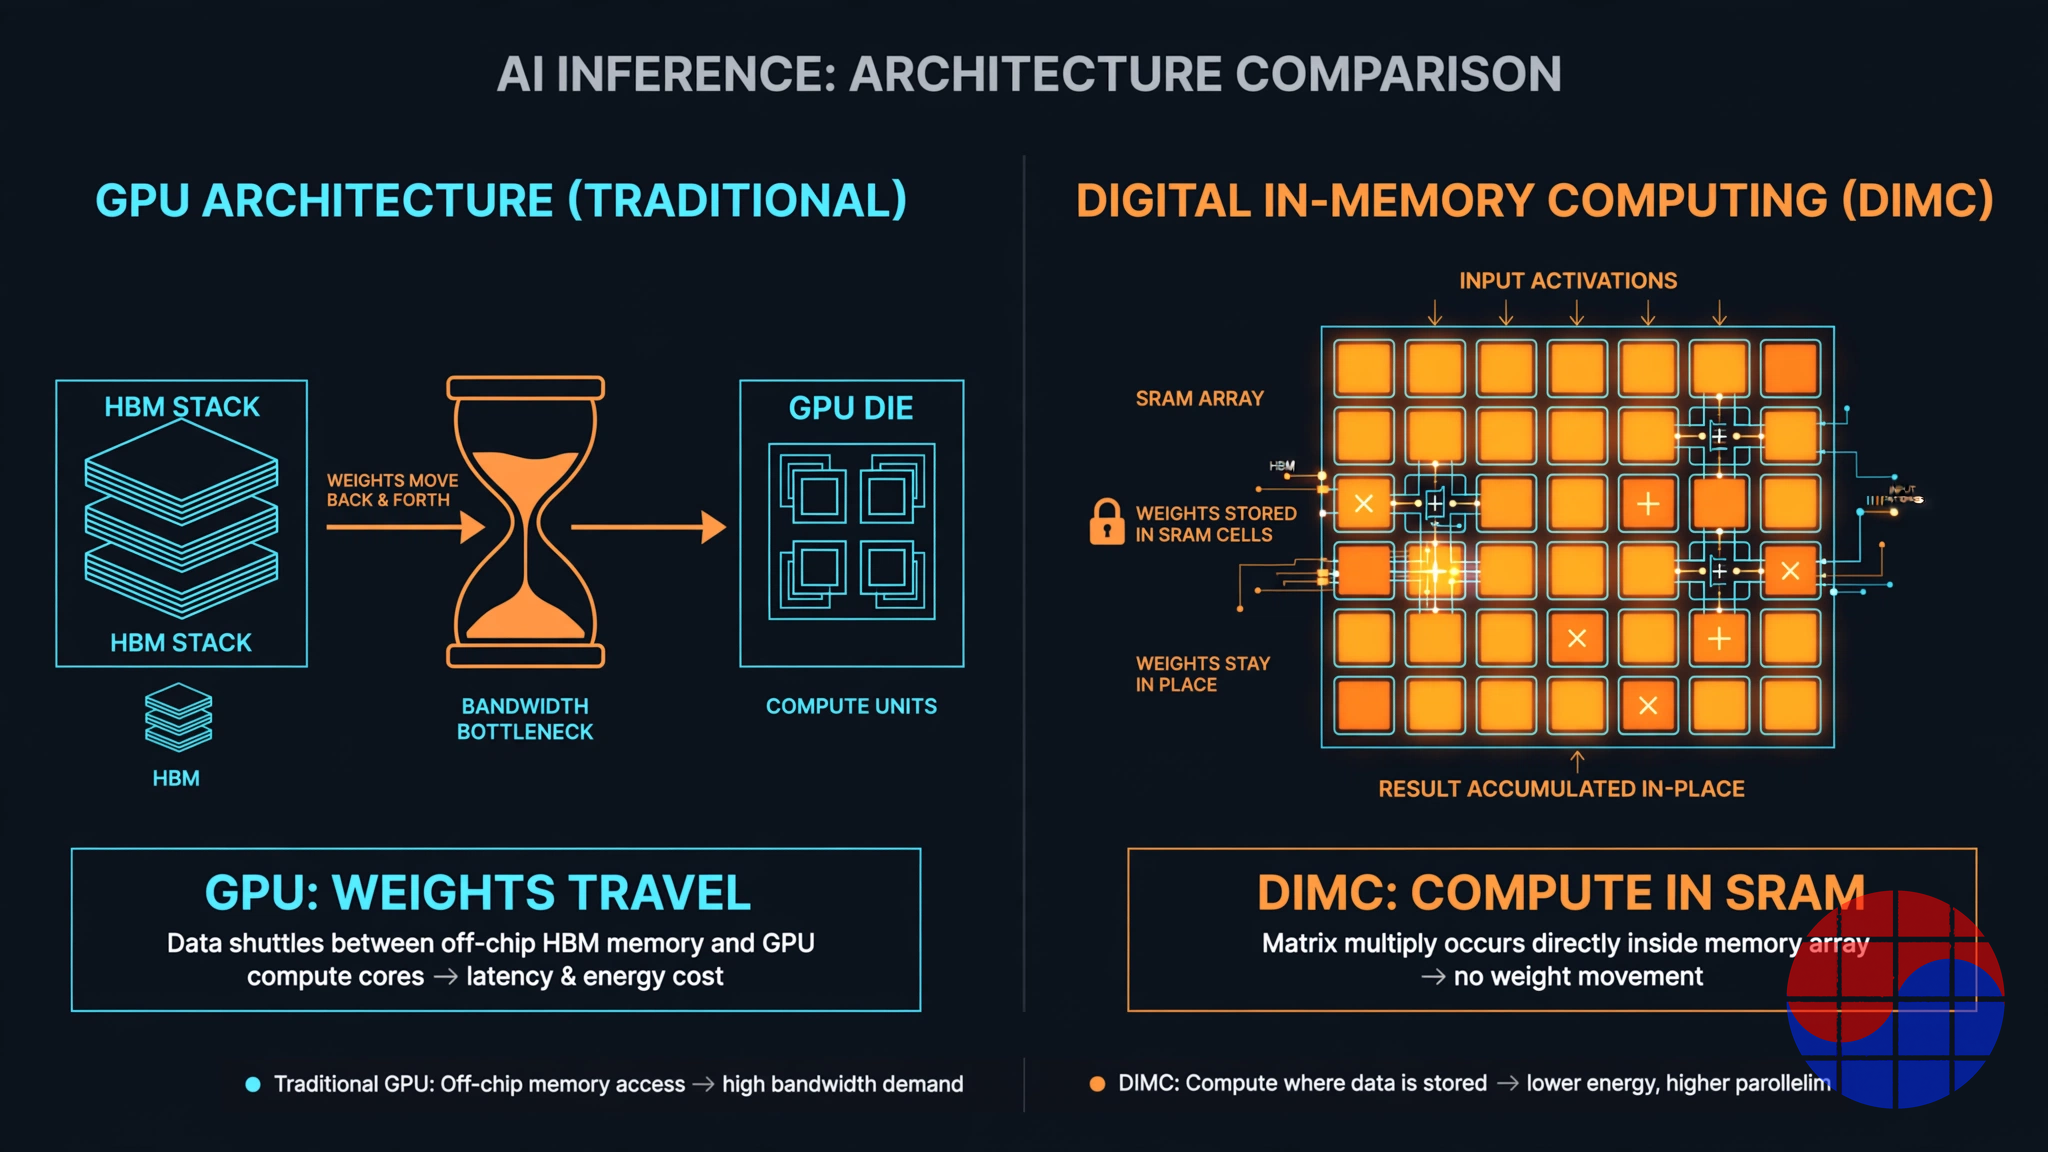
デコード段階の推論はメモリ律速である。トークンを1個生成するたびにモデルの重みを読む必要があり、GPUはその重みをHBMスタックと演算ユニットの間で往復させることに時間と電力の多くを費やす。Corsairは移動そのものを攻撃する。DIMCコアはSRAMアレイ内部で乗算累積演算を実行する。重みは演算のために運ばれるのではなく、置かれた場所で計算される。
量産カードの数値がトレードオフを定義する。TSMCの6nmプロセス、標準PCIe Gen5フォームファクタのCorsairカードは、8ビットピーク演算2,400 TFLOPS、150TB/sで動作する2GBのオンチップPerformance Memory(SRAM)、最大256GBのオフチップLPDDR5 Capacity Memoryを備える。帯域幅をHBMと比較すると、最新のHBM3eスタックは1個当たり約1.2TB/s、GPUパッケージ全体でも8TB/s程度である。Corsairの150TB/sはパッケージ帯域幅ではなくオンチップSRAM帯域幅であり性質が異なる数値で、この比較はd-Matrixに有利に傾く。それでも方向性は実在する。小バッチ・低レイテンシのデコードでは、重みをSRAMに置くだけでGPUのトークンレイテンシを支配する往復を消せる。
Series Cの資金が実際に買うのは、チップを取り巻くプラットフォームである。JetStream NICがカードとラックを低レイテンシで接続する。AviatorソフトウェアスタックはPyTorchとTritonで書かれたモデルをDIMCファブリックへコンパイルする。Arista、Broadcom、Supermicroと構築したリファレンスラックアーキテクチャSquadRackはカードを配備可能なシステムにまとめ、2026年10月に一般提供が発表されたSquadronクラスターは、標準空冷データセンターで16ラック・最大1,024基のCorsair XPUまで拡張できる。Corsairは2026年6月に量産に入り、出荷はハイパースケーラー、ネオクラウド、フロンティアAIラボを優先する。2026年4月にはGigaIOのデータセンター事業を買収し、FabreXメモリファブリックとSuperNODEのシステム設計も獲得した。
SRAMの天井と、Raptorが存在する理由
このアーキテクチャの強みはそのまま天井でもある。SRAMは速いがビット当たり価格が高い。CorsairのPerformance Memory 2GBでは70Bモデルを収容できず、残りはLPDDR5 Capacity Memoryにあり、実性能はAviatorが2つの階層間で作業をどれだけ巧みにタイリングできるかに依存する。SRAMはロジックのようには縮小しない。先端ノードでも密度改善は遅く、純粋なSRAMロードマップは世代ごとにトークン生成容量当たりの原価が上がる構造である。これがすべてのインメモリコンピューティング企業が答えるべきプロセス経済学の問いである。
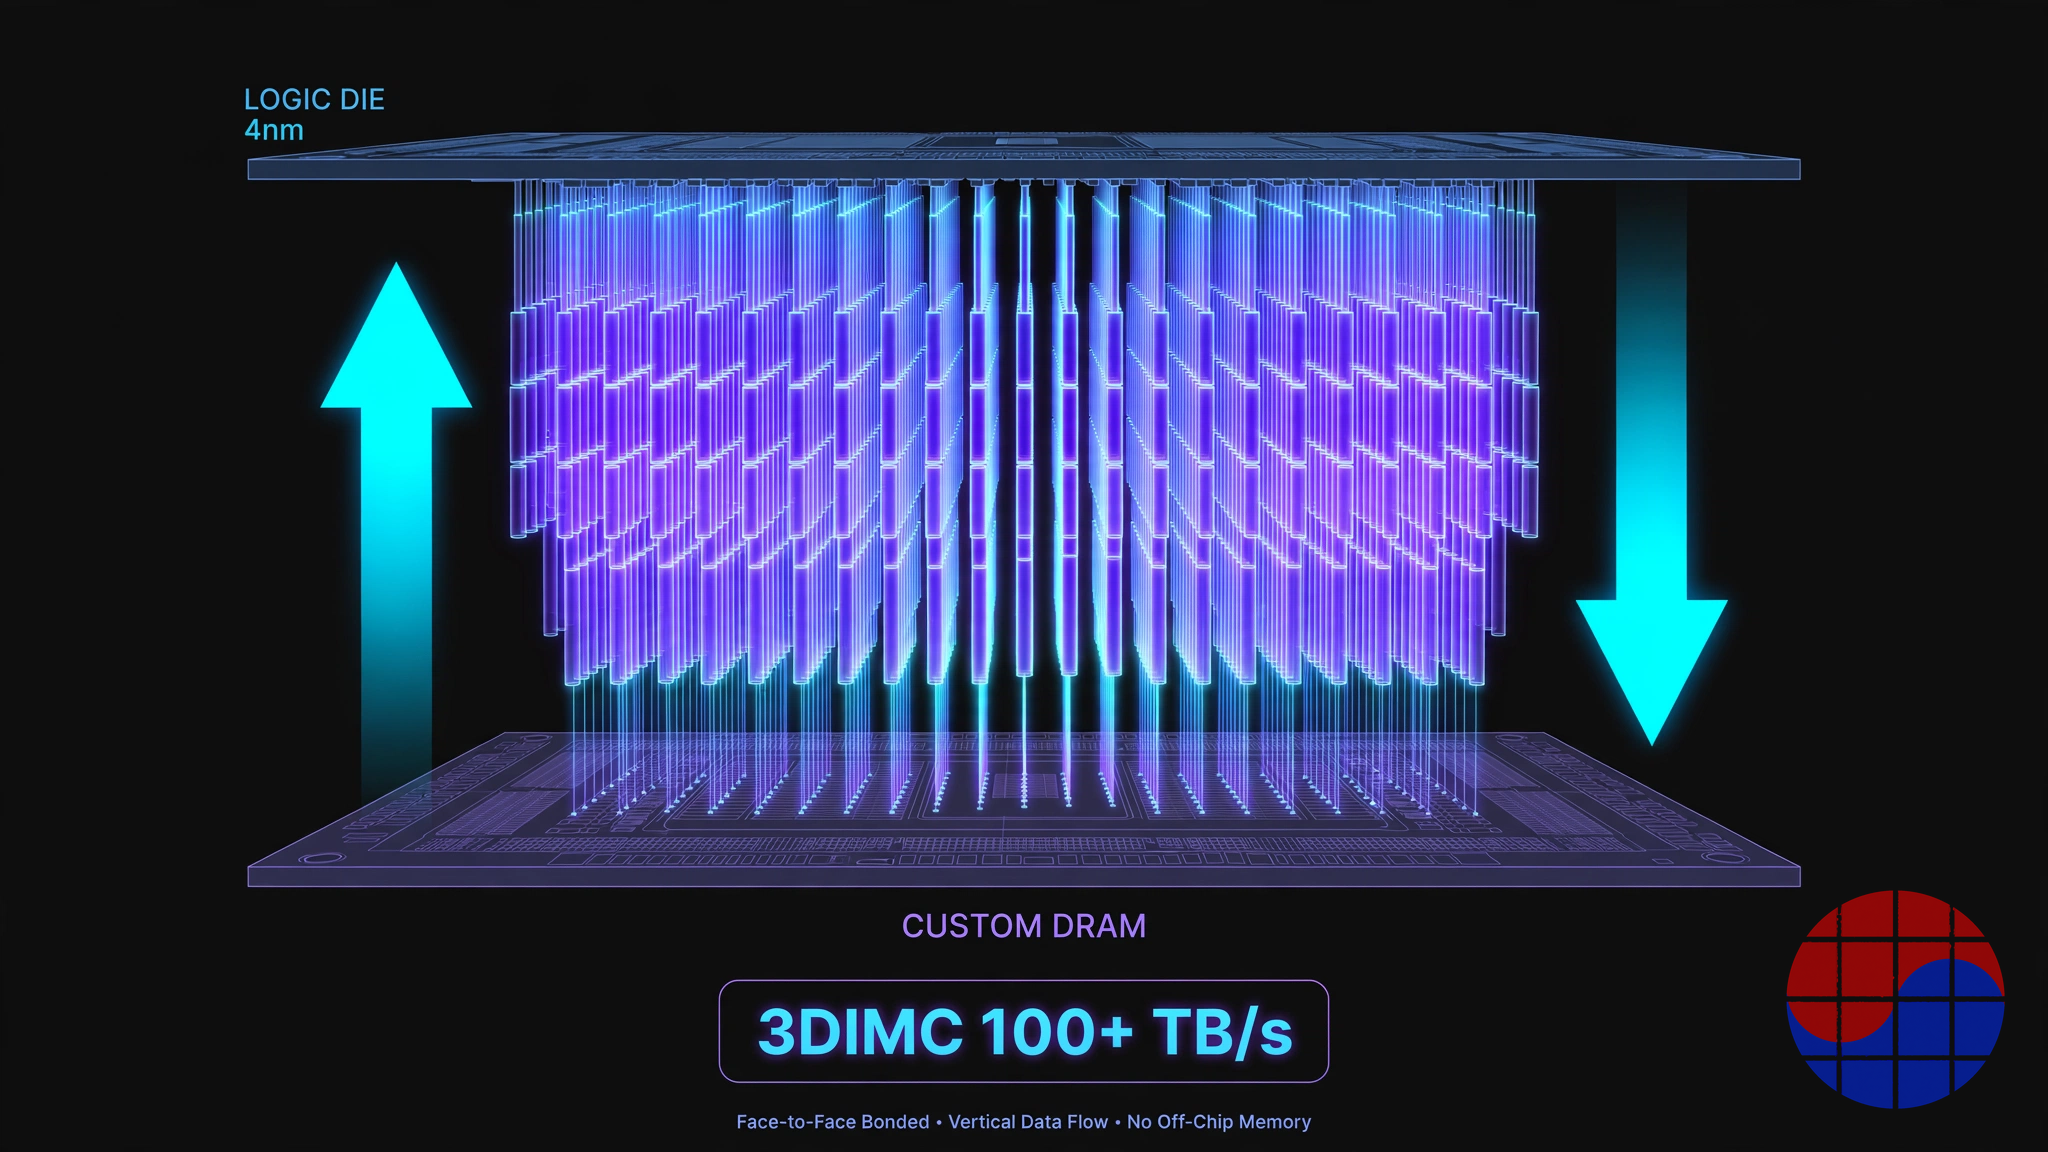
d-Matrixの答えが3DIMC、次世代のRaptorプラットフォームである。2025年11月にAlchipとともにPavehawkテスト車両で公開されたRaptorは、TSMC 4nmのロジックダイを36マイクロンピッチでカスタムDRAMダイにフェイス・ツー・フェイス接合する。同社はアクセラレータ当たり100TB/s超の帯域幅と32GB(256Gb)の積層メモリ、0.37pJ/bitを見込み、2026年に公開された初期シリコン結果ではHBMベース構成比でアクセラレータ当たり約4.7倍の推論スループットを報告した。Raptorは2026年末のテープアウト、2027年第4四半期のラック供給が目標である。2026年9月、d-MatrixはNVIDIAのNVLink Fusionエコシステムに加わり、Raptor XPUはGPUの全面置き換えを求めるのではなく、NVIDIA MGXラック内に差し込めるよう設計された。
20億ドルが成立するために真でなければならないこと
物語を算術に剥がしてみる。本格的な売上前、累計調達4億5,000万ドルの上に立つ20億ドルの評価は、d-Matrixを部品ベンダーではなく将来のプラットフォーム事業として価格付けしている。3つの条件が必要である。第1に、推論支出が複利で成長し続け、専用デコード層がGPUとは別の予算項目になること。第2に、Corsairが主張する経済性(対話速度10倍、TCO当たり性能3倍、エネルギー効率3〜5倍、いずれも会社発表値)が、Llamaのベンチマークではなく実名顧客のプロダクションワークロードで耐えること。第3に、ソフトウェアの堀が形成されること。NVIDIAやAMD、あるいはハイパースケーラー自身のASICチームが「十分に良い」答えを出したとき、顧客がハードウェアを交換可能な商品と見なさないほどAviatorが定着することである。
これまでの牽引(トラクション)の証拠は実在するが不完全である。量産入り、Supermicro製のラックライン、システムファブリックを加えた買収、Temasek・QIA・EDBIといったソブリン系中心の投資家構成は、いずれも精緻な買い手がデューデリジェンスを行い残っている信号である。まだ欠けているのは、チップスタートアップの価格を最終的に決める証拠、すなわち実名ハイパースケーラーのプロダクション導入の開示とリピートオーダーである。2026年7月に報じられた、より高い評価での追加調達の動きとNVIDIAの投資検討は、確認されていないreported水準として扱うべきである。
ダウンサイド:HBM陣営の反撃とソフトウェアという税金
弱気の論拠は2つある。第1は物理とロードマップである。HBMは止まっていない。HBM4はスタック当たりのインターフェースを2,048ビットに広げ、GPUベンダーはより大きなSRAM、より高速なインターコネクト、推論最適化SKUを自社ラインアップに統合している。世代ごとに、別アクセラレータを正当化するレイテンシ格差は狭まり、GPU陣営は学習と推論を1つのソフトウェアスタックで提供する。第2は導入税である。CUDAでないすべてのプラットフォームは、顧客にモデルの移植、若いコンパイラへの信頼、スタートアップの財務へのベンダーリスクを求める。d-Matrixはヘテロジニアスな位置付けでこれを緩和する。NVLink Fusionへの参加とAttention-FFN Disaggregation(AFD)の実証がその形であり、AFDはアテンションをGPUに、フィードフォワード層をCorsair XPUに分け、同時ユーザー64人でユーザー当たり毎秒845トークンを示した。緩和は消去ではない。この税金は営業サイクルごとに支払われる。
Chase's Take
多くのAIチップスタートアップは速いエンジンを売っている。d-Matrixは別の会計恒等式を売っている。デコード推論では、毎秒トークン数は概ね帯域幅をモデルサイズで割った値である。帯域幅を所有する会社がマージンを所有する。インメモリコンピューティングをアナログではなくデジタルで実装した選択は、静かに正しかった。アナログIMCはデモでは美しいがキャリブレーションで崩れ、DIMCはSRAMの決定性を保ちプロセス移行にも耐える。正直な問いは物理が動作するかではない。Pavehawkと2026年のシリコン結果が動作すると言っている。問いは、SRAMの経済性と若いソフトウェアスタックが、顧客がすでに買ったGPUラックに答えを同梱できる既存勢力の前で、防御可能な層を維持できるかである。NVLink Fusionの決定は経営陣がこれを理解していることを示す。d-MatrixはNVIDIAのラックに勝とうとしているのではない。そのラックの中の1項目(ラインアイテム)になろうとしている。20億ドルで投資家が買っているのはその結果ではなく、まだ欠けている2つの証明(実名のプロダクション規模とRaptorのスケジュール遵守)へSeries Cの資金を投じる、確率加重された道筋である。
Implications
ハイパースケーラーとネオクラウドへ:Corsair級のアクセラレータは推論をヘテロジニアス設計の問題に変える。調達の問いは「どのGPUか」から「どの層をどこで動かすか」へ移り、AFD式の分離は実験ではなく容量計画の規律になる。
メモリ業界へ:d-Matrixは警告付きの需要信号である。現行製品はSRAMとLPDDR5でHBMを迂回し、Raptorのカスタム積層DRAMは、長期戦の本質が「HBM対無」ではなく「標準HBM対特定の演算ダイに合わせて設計されたメモリ」であることを示唆する。アクセラレータスタートアップとスタックを共同設計するメモリメーカーは、GPU二強が支配しない販路を得る。
投資家へ:20億ドルという価格は2つの観測可能な出来事で再価格付けされる。Corsair初の実名・リピートのハイパースケール導入と、2026年末のRaptorテープアウトである。それまでは、この評価はベンチマークの主張と投資家の質に依拠している。強い信号ではあるが、信号はキャッシュフローではない。
FAQ
d-Matrixは何をする会社ですか?
d-MatrixはAI推論専用のデータセンター向けアクセラレータを作っています。Corsairプラットフォームは、SRAM内部で演算するDigital In-Memory Computing(DIMC)にJetStreamネットワーキングとAviatorソフトウェアスタックを組み合わせ、モデル学習ではなく低レイテンシで高効率なトークン生成を狙います。
d-Matrixの企業価値が20億ドルなのはなぜですか?
20億ドルの評価は、2025年11月12日に完了した2億7,500万ドルのSeries Cで決まりました。BullhoundCapital、Triatomic Capital、Temasekが共同主導し、QIA、EDBI、MicrosoftのM12が参加しました。投資家は、推論がAIインフラ最大のコストになり、メモリ中心アーキテクチャがその持続可能な一角を占めるという期待を価格に織り込んでいます。
CorsairはGPUと何が違いますか?
GPUはトークンごとにHBMからモデルの重みを読み、パッケージ帯域幅は8TB/s程度です。Corsairは頻繁に使う重みをオンチップSRAMに置きメモリアレイ内部で演算することで、カード当たり150TB/sのオンチップ帯域幅に到達します。GPUが最も非効率な小バッチ・低レイテンシのデコードワークロードを狙った設計です。カード当たりSRAM Performance Memory 2GBと最大256GBのLPDDR5 Capacity Memoryを備えます。
3DIMCとRaptorとは何ですか?
3DIMCはd-Matrixのインメモリアーキテクチャの3D積層への進化形です。Raptorプラットフォームは4nmロジックダイをカスタムDRAMダイにフェイス・ツー・フェイス接合し、アクセラレータ当たり100TB/s超の帯域幅と32GB(256Gb)のメモリを見込みます。Raptorは2026年末のテープアウト、2027年第4四半期のラック供給が目標で、NVIDIA NVLink Fusionラックとの統合も含まれます。
注:性能・効率の数値(対話速度10倍、TCO当たり性能3倍、エネルギー効率3〜5倍、150TB/s)は本文に記した日付時点の会社発表値である。20億ドルの企業価値は2025年11月Series C発表で報じられたpost-moneyの数値である。
📩 VLSI Korea ニュースレター
毎日配信の半導体ディープダイブを、メールでいち早くお届けします。購読は無料です。