VLSI Korea
AMD의 Taalas 인수: 17K tok/s 하드와이어드 AI가 Instinct에 더하는 것
AMD가 Taalas 인수 계약을 발표했다. 모델을 배선에 고정하는 17K tok/s 추론 경로가 Instinct와 결합할 조건을 검증한다.


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
결론부터: AMD가 2026년 8월 6일 Taalas 인수 계약을 공식 발표했다. 거래 금액과 종결 시점은 공개하지 않았지만, AMD가 확보하려는 핵심은 특정 AI 모델의 가중치와 데이터 흐름을 상부 금속 배선에 고정해 메모리 이동을 줄이는 모델 전용 추론 기술이다.
이 기술은 Instinct GPU를 대체하기보다 안정적이고 반복량이 큰 추론을 맡는 보조 엔진이 될 가능성이 높다. 투자와 공급망 판단에서 중요한 것은 Taalas가 제시한 17,000 tokens/s 수치 자체가 아니라, 독립 품질 검증과 대형 모델 확장성, 수율, 모델 수명, AMD 소프트웨어 통합이 확인되는 순서다.
이 글이 답하는 실무 질문은 두 가지다. 아키텍처와 제품 팀은 모델을 실리콘에 고정할 만큼 워크로드가 안정적인지 판단해야 한다. 투자자와 공급망 기업은 어떤 증거가 나와야 매출, HBM 수요, 파운드리와 패키징 물량에 반영할 수 있는지 구분해야 한다.
1. 인수로 확정된 것과 아직 비어 있는 것
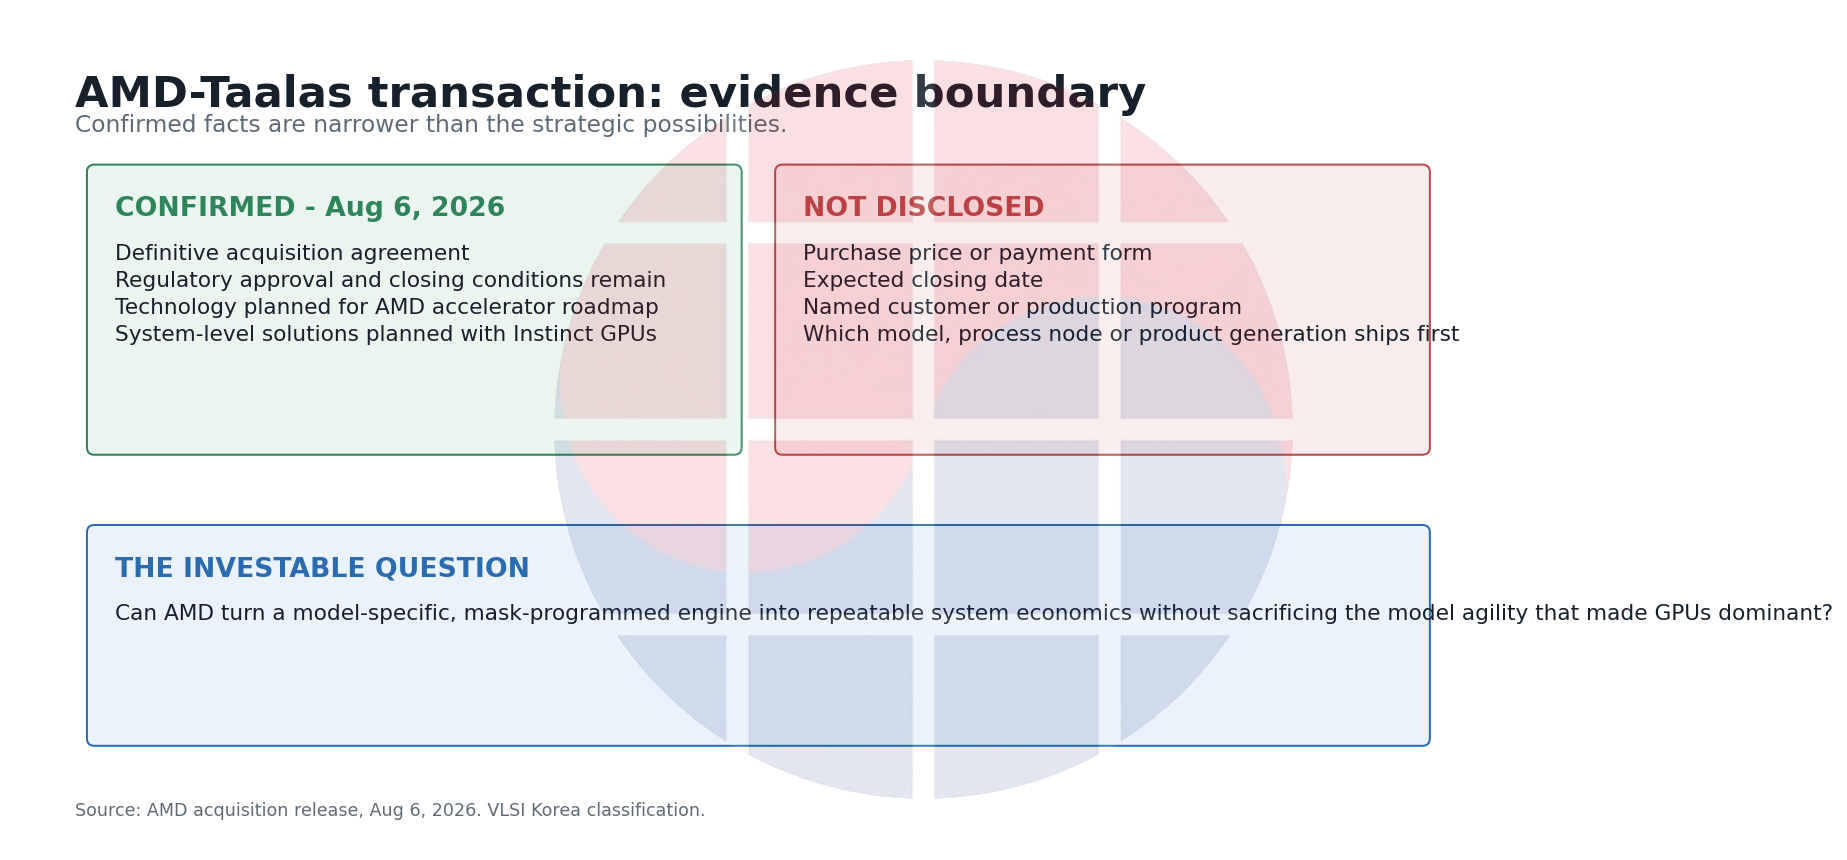
AMD의 공식 발표가 확정한 사실은 제한적이지만 명확하다. AMD는 토론토 기반 Taalas를 인수하는 최종 계약을 체결했고, 규제 승인 등 통상적 조건을 거쳐 거래를 종결할 계획이다.
AMD는 Taalas 기술을 향후 가속기 로드맵에 통합하고 Instinct GPU와 함께 시스템 수준 솔루션을 개발하겠다고 밝혔다. 반면 인수 가격, 현금 또는 주식의 지급 방식, 예상 종결일, 매출 기여, 제품명과 고객은 공개하지 않았다.
따라서 현재 단계에서 기업가치나 주당이익 효과를 계산하는 것은 근거가 없다. 분석 가능한 것은 기술의 전략적 위치와 검증해야 할 경제성뿐이다.
시장의 단순한 해석은 “AMD가 초고속 추론 칩을 샀다”는 것이다. 우리의 해석은 더 좁다. AMD는 범용 GPU의 약점을 한 번에 해결한 제품이 아니라, 바뀌지 않는 모델에 한해 데이터 이동을 구조적으로 줄일 수 있는 설계 경로와 팀을 샀다.
차이는 중요하다. 범용성의 손실이 성능 이익보다 작으려면 같은 모델이 충분히 오래, 충분히 많은 요청을 처리해야 하기 때문이다.
2. HC1이 공개한 수치와 그 수치가 증명하지 않는 것
Taalas의 첫 칩 HC1은 양산 범용 가속기가 아니라 기술 시연용 제품이다. 회사 자료에 따르면 TSMC N6 공정, 815mm² 다이, 530억 트랜지스터를 사용하며 Llama 3.1 8B 모델을 하드와이어드했다.
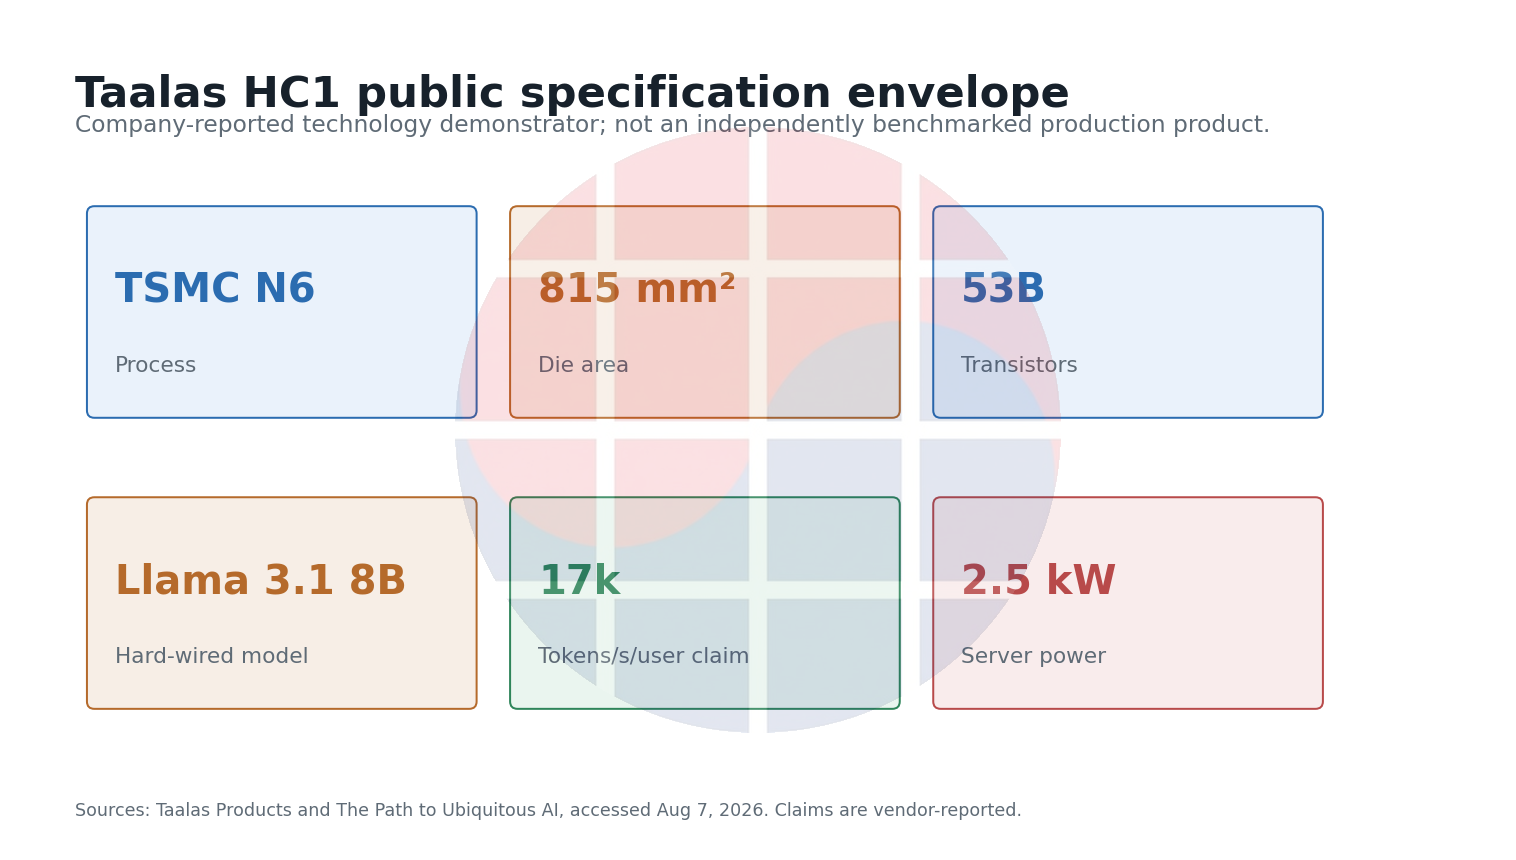
Taalas는 사용자 한 명 기준 17,000 tokens/s, 약 10배의 속도, 약 10분의 1 전력, 약 20분의 1 개발비를 주장한다. 10개 카드로 구성한 공랭 서버 전력은 약 2.5kW이며, 칩당 수치는 약 250W로 제시됐다.
여기에는 세 가지 제한이 붙는다. 첫째, 17,000 tokens/s는 회사 측 수치이며 독립 벤치마크가 아니다. 둘째, 어떤 비교 시스템과 배치, 입력과 출력 길이, 지연시간 분위수, 모델 정확도를 사용했는지가 동일 조건으로 공개되지 않았다.
셋째, HC1의 공개 시연은 Llama 3.1 8B에 맞춰져 있다. 최신 대형 혼합전문가 모델이나 멀티모달 모델에서 같은 상대 우위가 유지된다는 증거는 아직 없다.
정밀도도 성능만큼 중요하다. Taalas는 HC1에서 3비트와 6비트의 공격적 양자화를 사용했고 일부 품질 저하가 있다고 직접 설명했으며, 2세대에서는 표준 4비트 형식을 적용할 계획이라고 밝혔다.
따라서 “17K”는 제품 성능표의 종착점이 아니라 재현해야 할 출발점이다. 최소한 동일 프롬프트 집합의 품질 점수, 첫 토큰 지연시간, 토큰 간 지연시간, 동시 사용자 수, 벽면 전력, 오류율이 함께 공개돼야 비교가 성립한다.
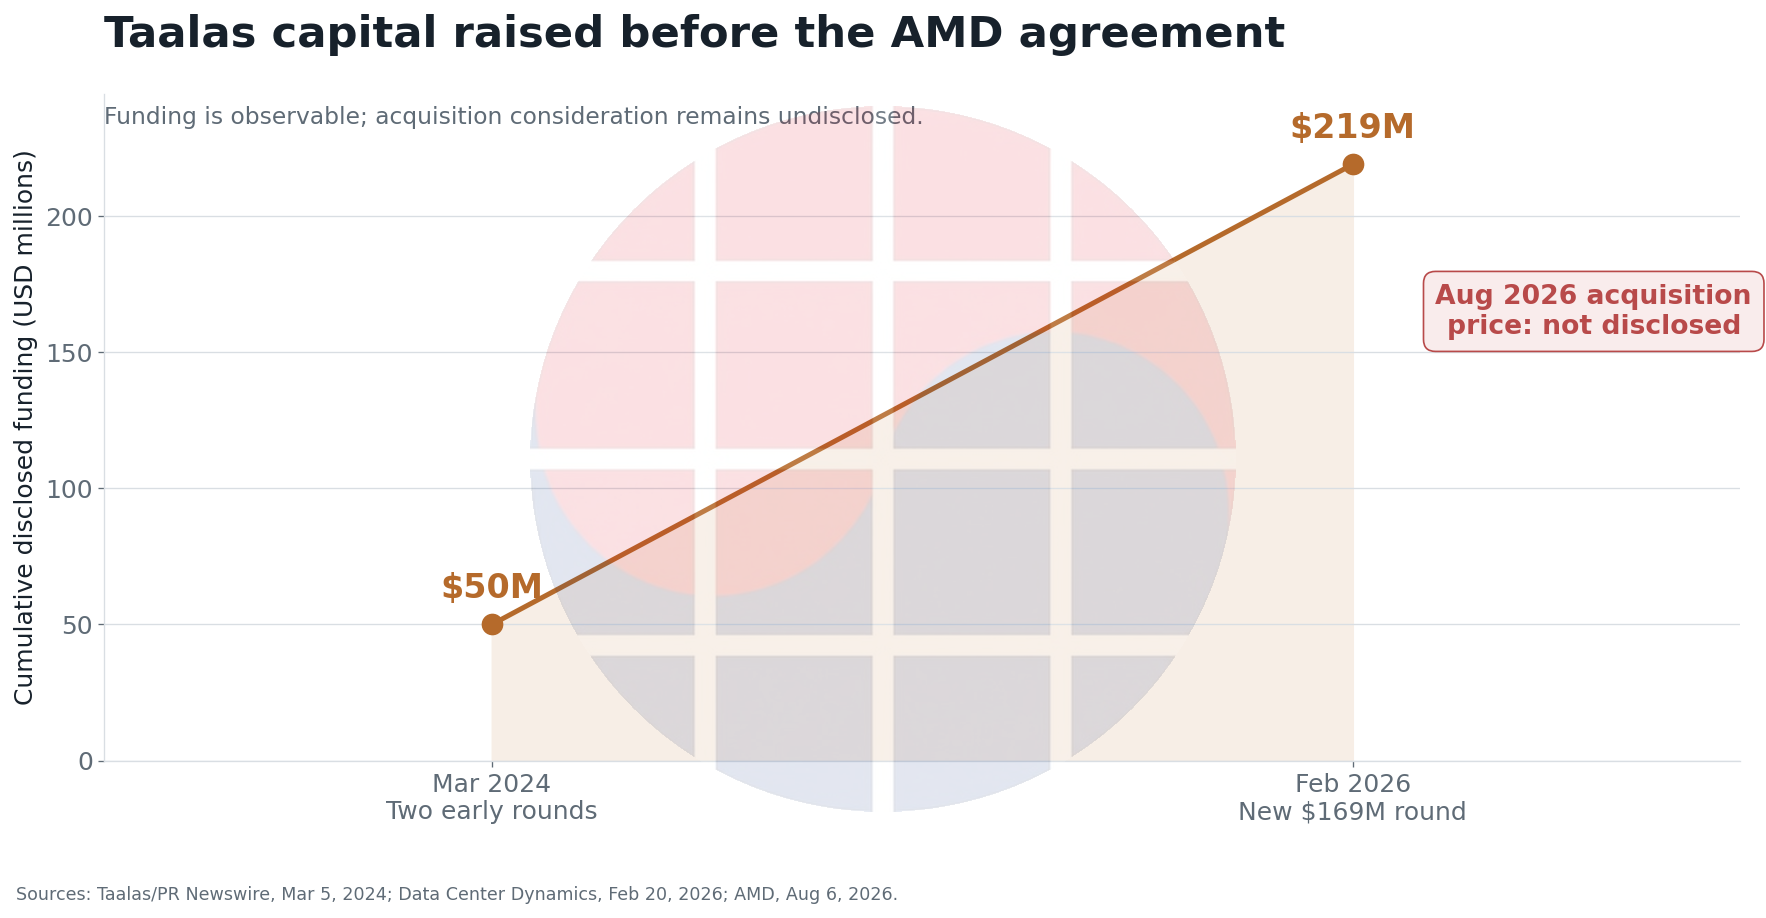
자본 조달 이력은 상용화 난도를 보여준다. Taalas는 2024년 두 차례 라운드에서 5,000만 달러, 2026년 1억6,900만 달러를 추가로 조달해 누적 약 2억1,900만 달러를 확보했다고 공개됐다.
이는 AMD가 지불한 가격이 아니다. 인수 대가는 비공개이므로 조달액을 거래 가치로 대체해서는 안 된다.
3. 모델을 소프트웨어가 아니라 배선에 저장하는 방법
기존 GPU는 HBM이나 SRAM에서 가중치를 읽어 계산 유닛으로 옮긴다. Taalas의 공개 특허는 가능한 양자화 곱의 집합을 미리 만들고, 모델 값이 결정하는 연결을 상부 금속층의 배선과 비아로 선택하는 구조를 설명한다.
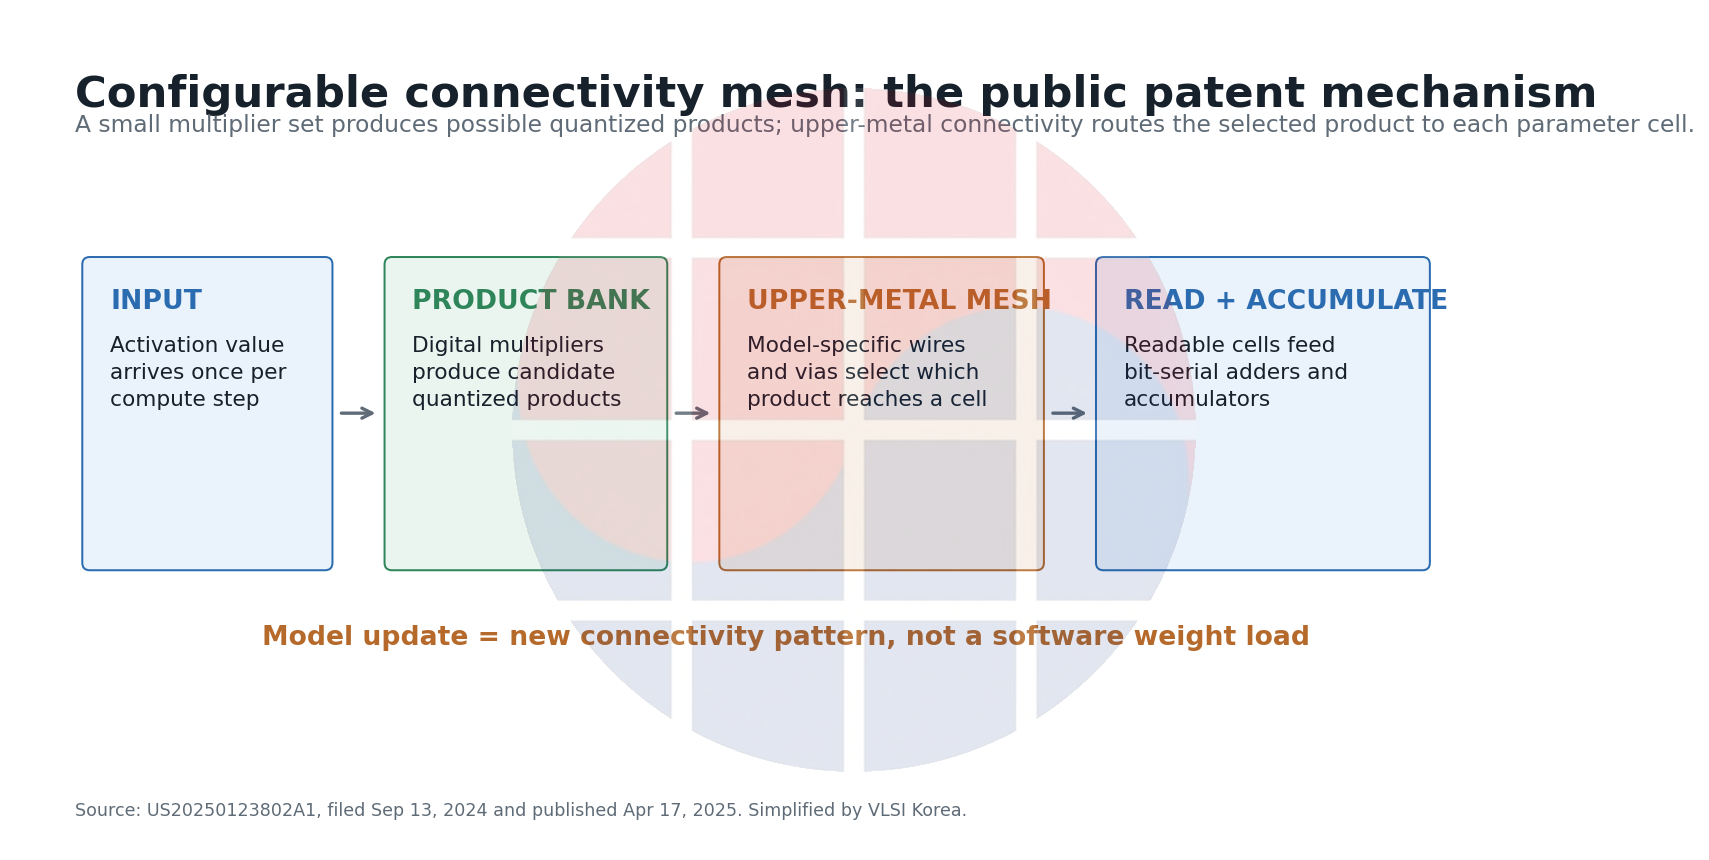
쉽게 말하면 모델의 큰 고정 가중치 집합을 반복해서 메모리에서 가져오는 대신, 어떤 곱셈 결과를 어느 누산 경로로 보낼지를 칩 배선에 새긴다. 특허는 이를 마스크 ROM과 구성 가능한 연결망으로 표현한다.
이 접근은 연산보다 데이터 이동이 지배하는 디코드 추론에서 특히 매력적이다. HBM 왕복을 줄이면 대역폭과 에너지 병목을 동시에 낮출 여지가 생긴다.
그러나 “완전히 고정된 ASIC”과 동일하지는 않다. EE Times 인터뷰에 따르면 KV 캐시와 미세조정 가중치에는 프로그래머블 SRAM을 사용할 수 있어 문맥과 일부 어댑터는 바꿀 수 있지만, 기본 모델의 큰 가중치나 데이터 흐름을 바꾸려면 새 마스크와 새 칩이 필요하다.
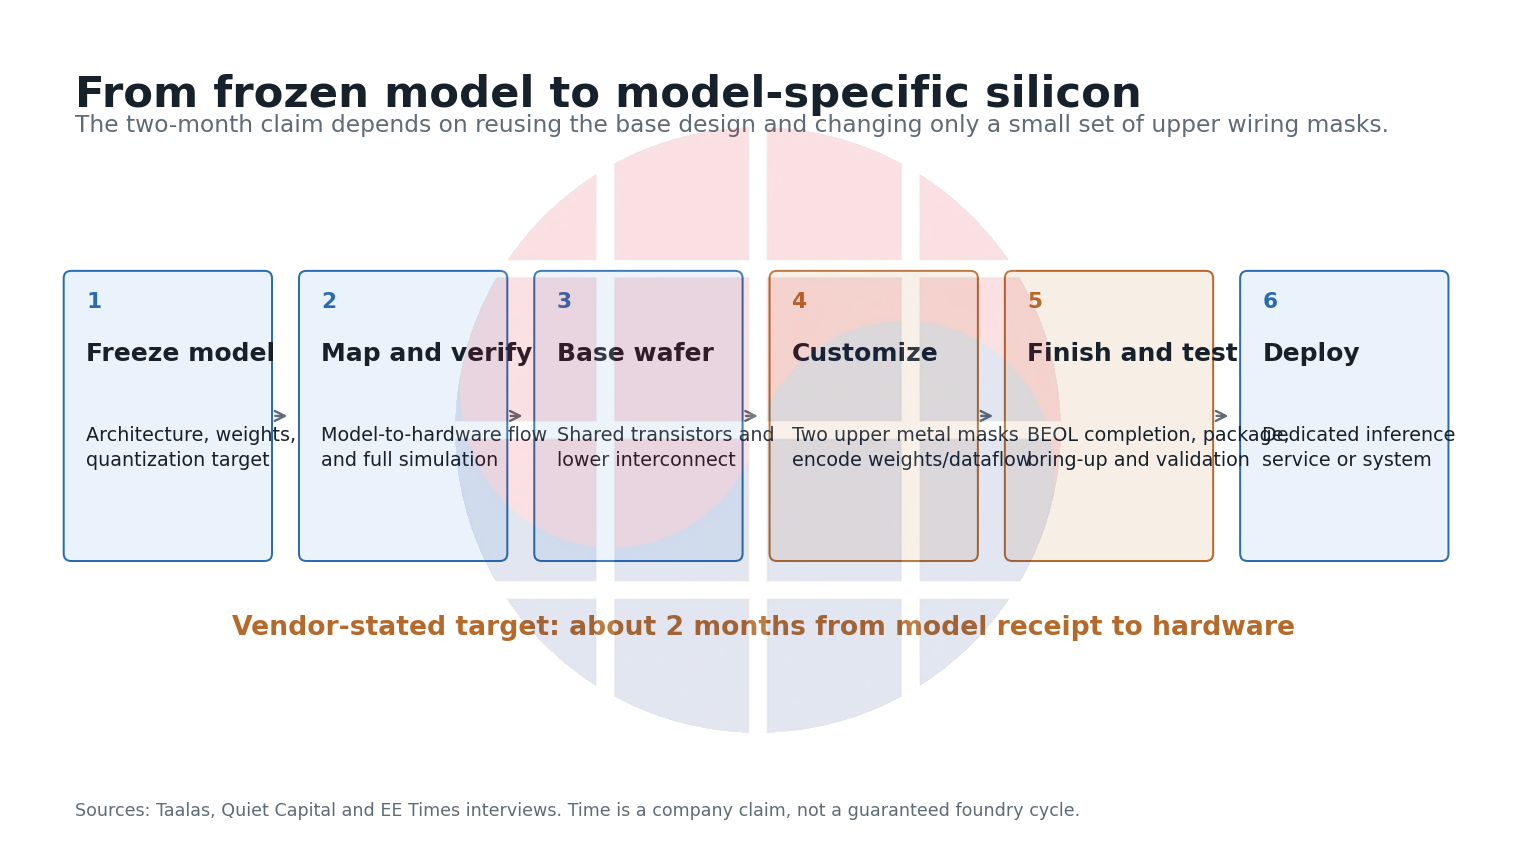
Taalas가 말하는 약 두 달의 모델 투입 후 칩 완성은 이 분리에서 나온다. 트랜지스터와 공통 회로가 들어간 베이스 웨이퍼를 미리 만들고, 모델이 정해지면 상부 금속 마스크 두 장을 바꿔 배선한 뒤 후공정과 테스트를 진행한다는 구상이다.
특허는 상부 마스크 비용이 하부 회로 전체의 10분의 1에서 100분의 1일 수 있다고 설명한다. 이는 특허의 범위와 회사의 제조 가설이지, 공개된 원가표나 반복 양산 실적으로 검증된 수치는 아니다.
또한 전체 모델 시뮬레이션, 물리 검증, DRC, 타이밍, 전력 무결성, 테스트 벡터, 패키징을 빠르게 끝내야 한다. 가중치가 배선이 되면 소프트웨어 패치로 고치기 어려운 만큼, 검증 비용이 전면으로 이동한다.
4. 왜 AMD는 지금 이 경로를 추가하는가
AMD의 2026년 2분기 매출은 115억3,600만 달러, 데이터센터 매출은 67억 달러였다. 계산하면 데이터센터 비중은 58.1%이며 AMD도 약 58%로 제시했다.
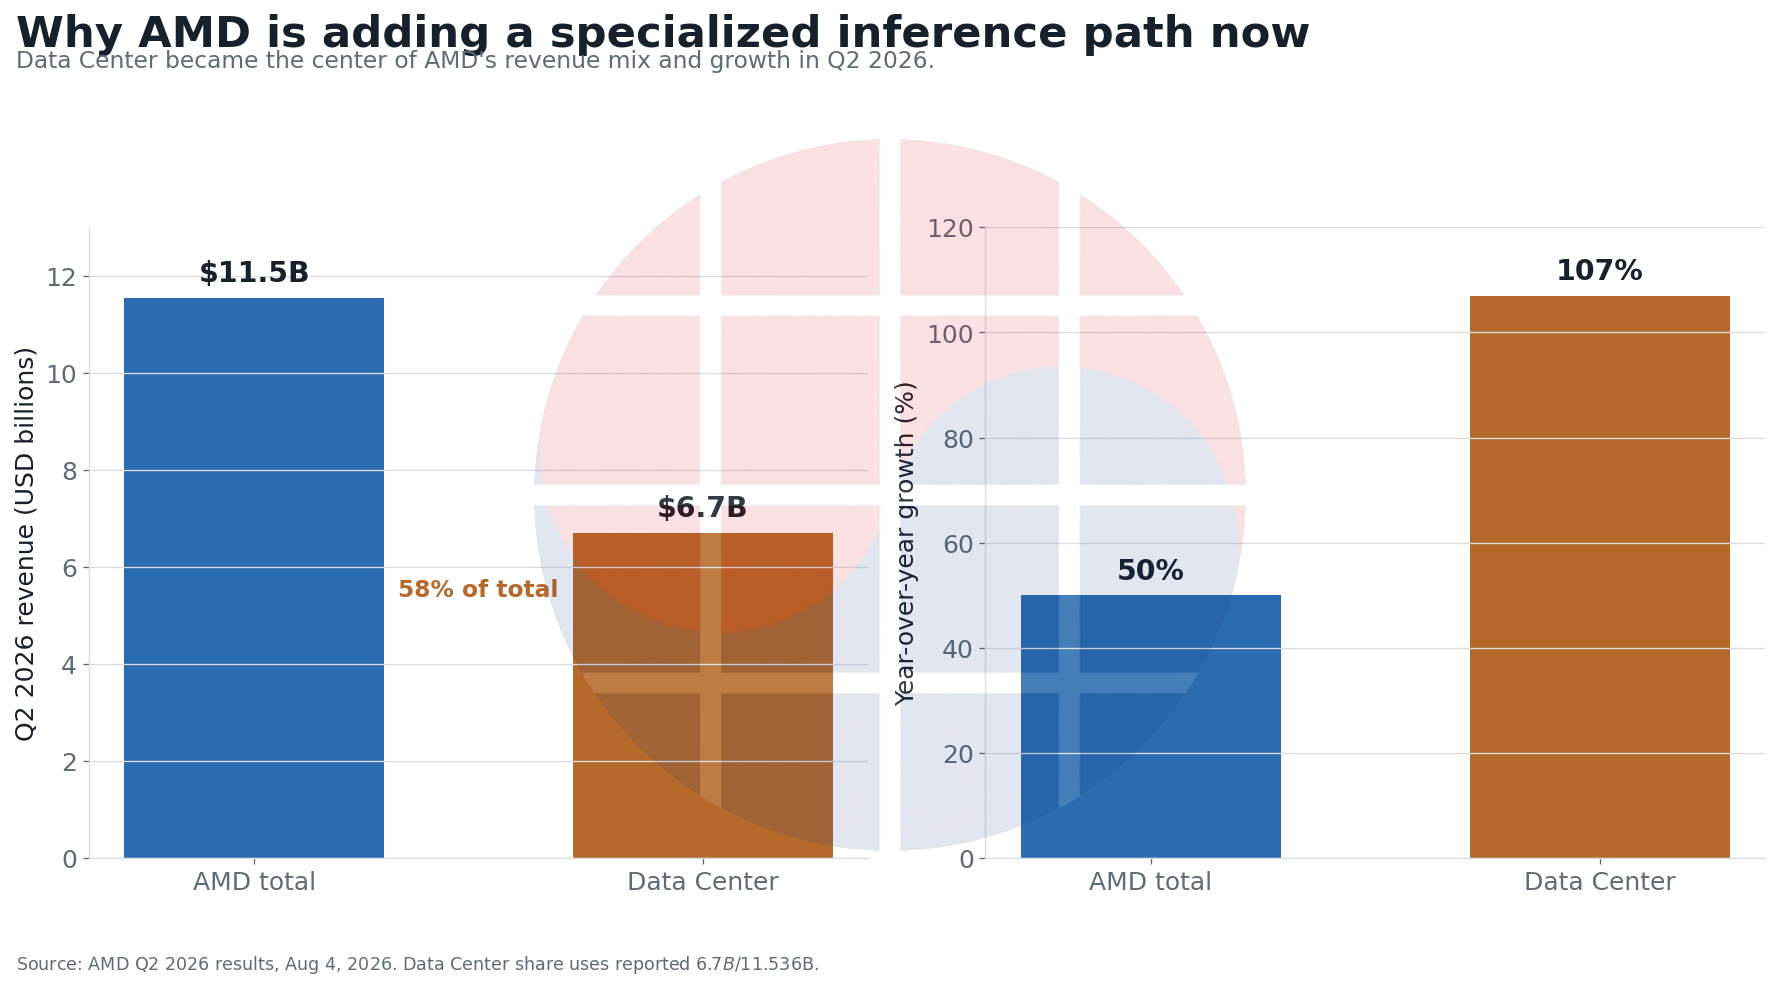
전년 동기 대비 전체 매출은 50%, 데이터센터는 107% 증가했다. Taalas 인수 발표 이틀 전 나온 이 숫자는 AMD가 데이터센터 AI를 주변 사업이 아니라 회사 중심축으로 다루고 있음을 보여준다.
AMD의 기본 자산은 Instinct GPU, ROCm 소프트웨어, CPU, 네트워크와 랙 시스템이다. 이 조합은 훈련, 빠르게 바뀌는 모델, 여러 모델의 혼합, 긴 프리필처럼 프로그래머빌리티와 큰 메모리가 필요한 작업에 적합하다.
Taalas는 반대쪽 끝을 노린다. 모델과 연산 패턴이 안정된 대량 디코드에서 범용성의 일부를 포기하고, 가중치 이동과 외부 메모리를 줄여 지연시간과 전력을 낮추려 한다.
인수 논리는 “GPU 대 ASIC”의 단일 승부가 아니다. AMD가 시스템을 관리하는 위치에서 요청을 GPU와 모델 전용 엔진 사이에 나누고, ROCm과 운영 소프트웨어가 두 경로를 하나의 서비스로 보이게 만들 수 있는지가 핵심이다.
이 관점은 AMD의 공식 문구와도 맞는다. 회사는 Taalas를 Instinct의 대체재가 아니라 Instinct GPU와 함께 쓰는 시스템 수준 솔루션으로 설명했다.
5. 통합이 성공한다면 생길 구조와 가장 어려운 문제
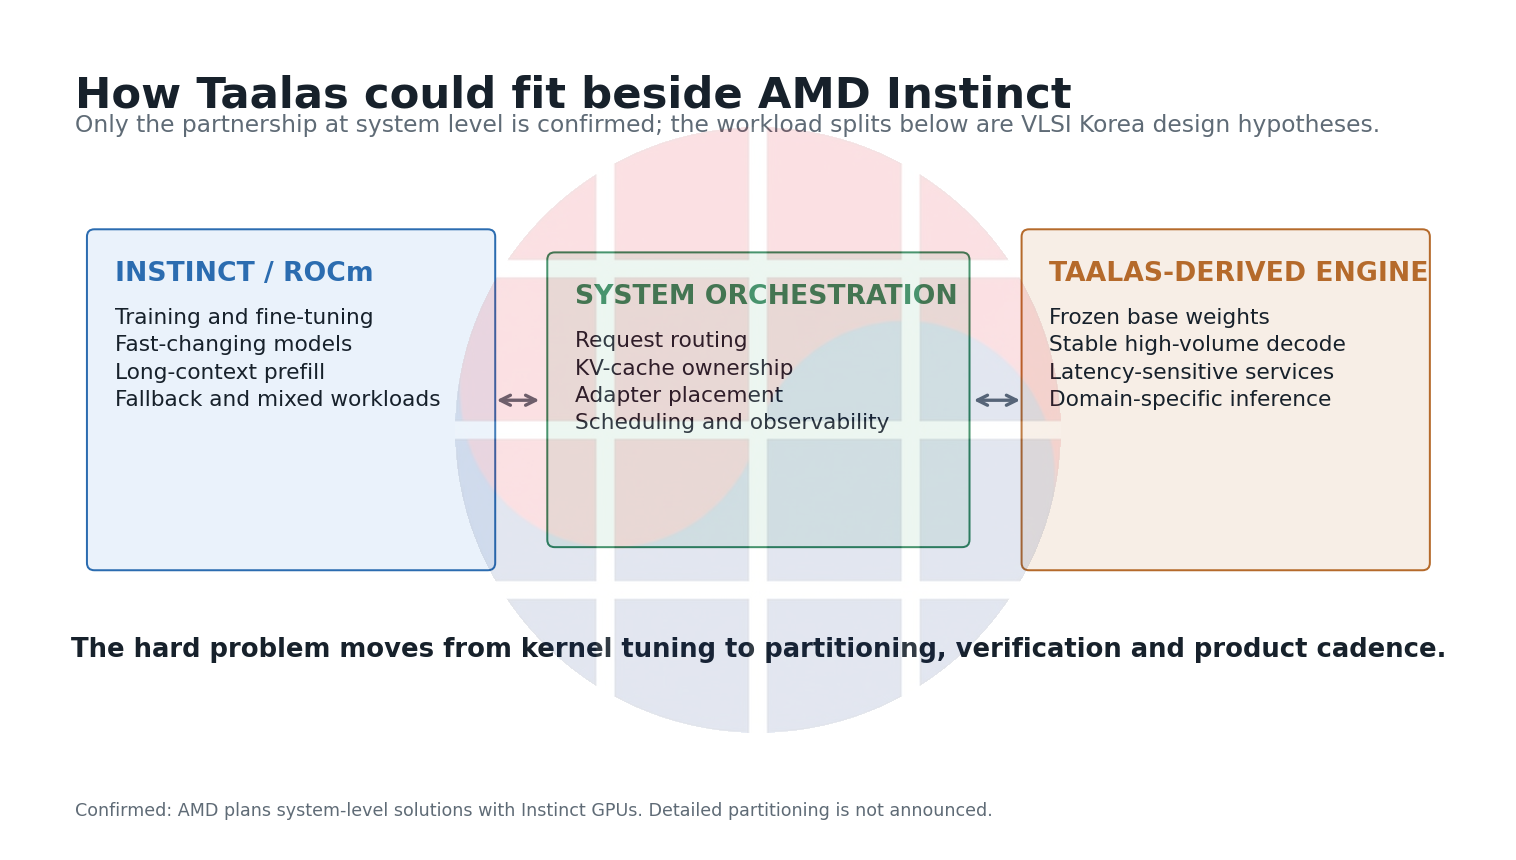
가능한 첫 구조는 프리필을 Instinct가 처리하고 안정적인 디코드를 Taalas 계열 엔진이 맡는 방식이다. 두 번째는 자주 호출되는 소수 모델만 전용 칩에 배치하고, 긴 꼬리 모델과 새 버전은 GPU에 남기는 방식이다.
세 번째는 지연시간에 민감한 온라인 서비스와 일정한 도메인 모델을 전용 엔진으로 보내고, 배치와 미세조정은 GPU에 유지하는 방식이다. 세 구조 모두 AMD가 발표한 제품 계획이 아니라 기술 특성에서 도출한 가설이다.
가장 어려운 문제는 커널 최적화가 아니다. 요청 라우팅, 모델 버전 관리, KV 캐시 이동, 텐서와 토크나이저 호환, 장애 시 GPU 폴백, 두 칩 사이의 서비스 수준 목표를 함께 관리해야 한다.
하드웨어 일정도 소프트웨어와 결합된다. 모델이 바뀔 때마다 마스크, 웨이퍼 마감, 패키지, 테스트와 재고를 다시 맞춰야 하므로 모델 릴리스 주기와 반도체 공급 주기가 충돌할 수 있다.
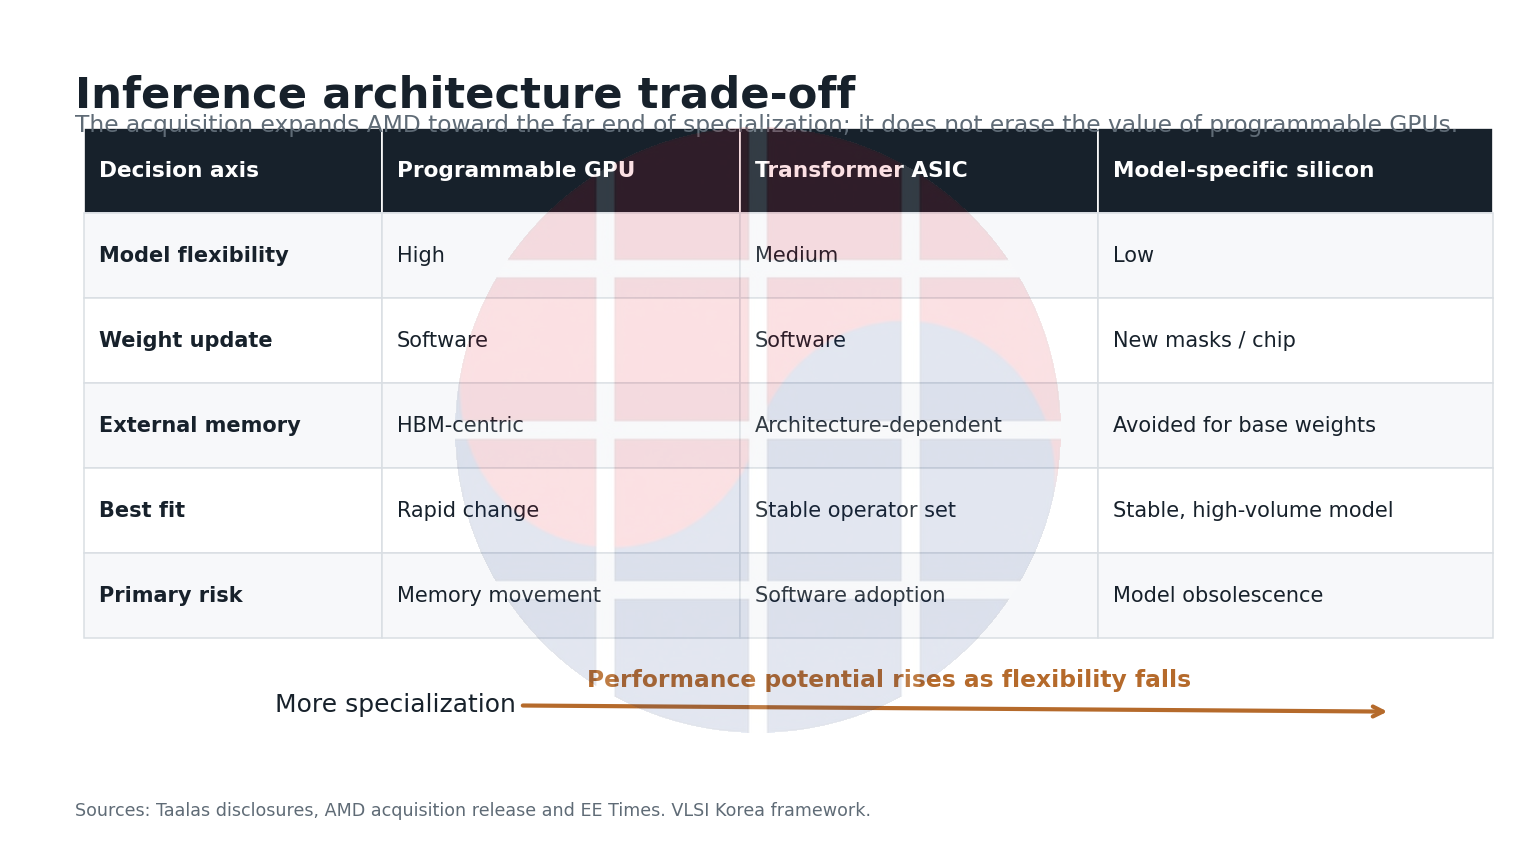
모델 전용 실리콘의 손익분기점은 개념적으로 단순하다. 새 칩의 총 개발, 검증, 마스크, 웨이퍼, 패키지와 재고 비용이 GPU 대비 요청당 절감액에 누적 요청 수를 곱한 값보다 작아야 한다.
공식으로 쓰면 고정비 < 요청당 절감액 × 모델 수명 동안의 유효 요청량이다. 문제는 세 항 모두 아직 공개되지 않았다는 점이다.
모델이 빨리 교체되거나 수요가 여러 버전으로 분산되면 전용 칩은 감가상각 전에 구형이 된다. 반대로 호출량이 매우 크고 모델이 1년 이상 안정적이면, 낮은 전력과 높은 단일 사용자 처리량이 마스크와 재고 위험을 상쇄할 수 있다.
6. 한국 반도체 공급망에 주는 신호
HC1은 공개 설명상 HBM과 CoWoS를 사용하지 않는다. 하지만 이를 곧바로 HBM 수요 감소로 연결하면 범위를 과장하게 된다.
첫째, HC1은 8B 모델의 기술 시연이며 AMD의 대형 Instinct 로드맵은 여전히 HBM 집약적이다. 둘째, 훈련, 프리필, 빠르게 바뀌는 모델, 대형 멀티모달 작업은 프로그래머블 가속기와 큰 외부 메모리를 계속 요구한다.
셋째, 모델 전용 엔진이 차지할 수 있는 영역은 안정된 대량 디코드라는 좁은 부분부터 시작할 가능성이 높다. 따라서 삼성전자와 SK하이닉스에 대한 1차 질문은 “HBM이 사라지는가”가 아니라 “추론 랙에서 GPU, HBM, SRAM, 전용 엔진의 비중이 어떻게 바뀌는가”다.
한국 공급망에는 네 개의 관찰 지점이 생긴다. 파운드리와 마스크 업체에는 상부 금속층만 빠르게 맞춤화하는 BEOL 흐름의 반복성과 수율이 중요하다.
OSAT와 테스트 업체에는 모델별 칩을 짧은 주기로 검증하고 분류하는 방법이 중요하다. 기판과 전력 업체에는 공랭 2.5kW 서버가 실제 랙 설계로 확장될 때의 전력 밀도와 연결 구조가 중요하다.
메모리 업체에는 전용 칩이 제거하는 것이 전체 메모리가 아니라 기본 가중치의 외부 왕복이라는 점이 중요하다. KV 캐시, 활성값, 어댑터와 시스템 메모리 수요는 남고, 더 큰 모델의 멀티칩 구현에서는 새로운 병목이 생길 수 있다.
이미 발표된 93개 기업의 AI 반도체 스타트업 해자 지도에서 Taalas 같은 업체의 핵심 위험은 기술 시연과 반복 가능한 제품 사업 사이의 간격이었다. AMD 인수는 유통, 시스템, 소프트웨어와 자본을 보완하지만, 그 간격을 자동으로 닫지는 않는다.
7. 인수 이후 확인할 순서와 논리를 깨는 조건
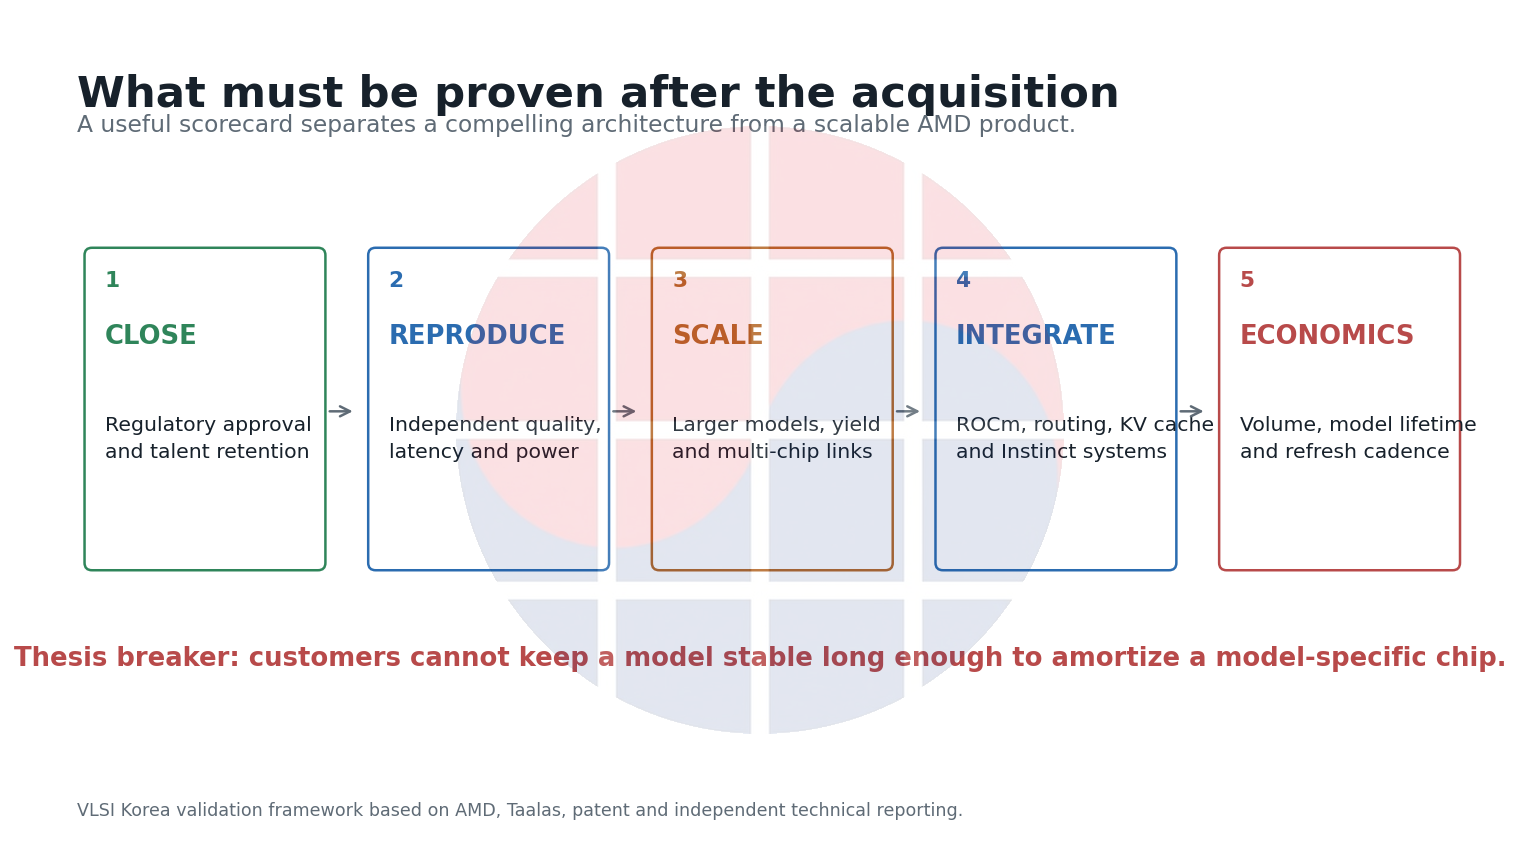
첫 관찰점은 거래 종결과 핵심 인력 유지다. 규제 승인과 조직 통합이 끝나기 전에는 기술이 AMD 로드맵에 실제로 들어갔다고 볼 수 없다.
두 번째는 독립 재현이다. HC1의 품질, 17,000 tokens/s, 전력과 동시성 수치가 동일 조건의 GPU와 외부 측정으로 비교돼야 한다.
세 번째는 확장성이다. 8B 한 칩을 넘어 더 큰 모델, 멀티칩 연결, 수율, 패키지와 테스트 결과가 나와야 한다.
네 번째는 AMD 통합이다. ROCm에서 보이는 장치 모델, 요청 라우팅, KV 캐시 정책, Instinct와의 폴백, 이름이 붙은 첫 제품과 고객 일정이 증거가 된다.
다섯 번째는 경제성이다. 주문량, 모델 유지 기간, 마스크 회전 주기, 칩당 비용과 전력 절감이 공개돼야 모델 전용 실리콘이 반복 가능한 사업인지 평가할 수 있다.
이 투자 논리를 깨는 조건도 분명하다. 고객 모델이 전용 칩의 고정비를 회수하기 전에 교체되거나, 독립 품질 검증에서 공격적 양자화의 손실이 허용 범위를 넘으면 핵심 가정이 무너진다.
또한 대형 모델에서 멀티칩 통신과 수율이 병목이 되거나, GPU와 HBM의 효율 향상이 요청당 총비용 격차를 닫아도 전용화의 우위는 약해진다. AMD가 Taalas를 별도 제품으로 내지 않고 일부 회로 또는 인력만 흡수할 가능성도 열어 둬야 한다.
최종 판단: 이번 인수는 AMD가 범용 GPU 바깥의 추론 경로를 공식적으로 추가했다는 점에서 전략적 의미가 있다. 그러나 승부는 17K라는 시연 숫자가 아니라, 모델 수명과 반도체 수명을 맞추고 Instinct와 함께 운영 가능한 시스템 경제성을 만드는 데서 결정된다.
출처
- AMD, “AMD Acquires Taalas,” Aug. 6, 2026
- AMD Q2 2026 financial results, Aug. 4, 2026
- Taalas, “The Path to Ubiquitous AI,” Feb. 19, 2026
- Taalas Products: HC1
- US20250123802A1, Large Parameter Set Computation Accelerator Using Configurable Connectivity Mesh
- EE Times, “Taalas Specializes to Extremes for Extraordinary Token Speed,” Feb. 19, 2026
- Taalas funding announcement, Mar. 5, 2024
- Data Center Dynamics, Taalas raises $169 million, Feb. 20, 2026
- Quiet Capital, “AI at the Speed of Silicon,” Feb. 19, 2026
- TrendForce, AI inference chip architecture analysis, June 2026
- Taalas API documentation
- Wikimedia Commons, AMD headquarters, CC0 1.0
편집 고지: 본문은 공개 자료 조사와 AI 보조 초안을 바탕으로 VLSI Korea가 사실, 수치, 논리와 시각 자료를 검토해 작성했습니다. 외부 회사의 이미지는 권리 확인 결과 재사용하지 않았으며, AI 개념 이미지는 실제 제품을 묘사하지 않습니다.
본 글은 정보 제공만을 목적으로 하며, 특정 증권의 매수 또는 매도를 권유하는 것이 아닙니다. 본 글에 포함된 수치와 사실은 기업 공시, 언론 보도, 시장 조사 등 공개적으로 이용 가능한 자료를 바탕으로 작성되었으며, 해당 자료 또는 작성 과정에서 오류가 발생할 수 있습니다. 필자는 언급된 기업의 주식을 보유하고 있을 수 있습니다. 모든 투자 결정 및 그에 따른 결과는 독자의 책임입니다.
관련 글