VLSI Korea
에이전틱 EDA (3): 작게 쪼갤수록 똑똑해진다 — 계층적 AI 칩 설계 연구의 최전선
🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다 에이전틱 EDA 5부작 중 3부. 1부에서는 에이전트가 RTL-to-GDS 플로우를 어떻게 바꾸는지, 2부에서는 AI 랩과 EDA 벤더들의 각축전을 다뤘다. 이번 3부는 시리즈의 중심축이다. 거대한 칩을 잘게 파티셔닝할수록 AI 에이전트가 각 조각을 더 잘 이해하고 최적화한다는 테제를, 2024~2025년의 핵심 연구들을 통해 검증한다. 왜 지금 이 주제인가. 1부에서 다룬 에이전트들, 2부에서 다룬


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
에이전틱 EDA 5부작 중 3부. 1부에서는 에이전트가 RTL-to-GDS 플로우를 어떻게 바꾸는지, 2부에서는 AI 랩과 EDA 벤더들의 각축전을 다뤘다. 이번 3부는 시리즈의 중심축이다. 거대한 칩을 잘게 파티셔닝할수록 AI 에이전트가 각 조각을 더 잘 이해하고 최적화한다는 테제를, 2024~2025년의 핵심 연구들을 통해 검증한다.
왜 지금 이 주제인가. 1부에서 다룬 에이전트들, 2부에서 다룬 벤더들의 로드맵에는 공통된 전제가 깔려 있다. 에이전트가 다룰 작업 단위가 존재한다는 것. 그런데 그 단위를 누가, 어떤 크기로 정하는가에 대한 논의는 놀랄 만큼 적다. 파티셔닝은 그동안 "당연히 인간이 하는 것"으로 치부돼 왔다. 이 글은 그 당연함을 의심하는 것에서 시작한다. 어쩌면 파티셔닝이야말로 에이전트 시대의 핵심 설계 행위인지도 모른다.
TL;DR
- LLM에게 칩 전체를 flat한 Verilog 블록 하나로 생성시키면, 복잡도가 올라가는 순간 hallucination이 터진다. 2024~2025년 연구들의 처방은 놀랄 만큼 일치한다. 계층적으로 쪼개라.
- 홍콩중문대(CUHK) 팀의 RTLRewriter(ICCAD 2024, 2024년 9월 arXiv 공개)는 파티셔닝된 서브서킷에 LLM 기반 최적화를 적용했을 때 효과가 확연히 좋아진다고 관측했다. 근거로 트랜스포머의 long context 이해 한계를 든다.
- NYU 팀의 ROME(2024년 7월 arXiv 공개, MLCAD 2024 발표)은 계층적 프롬프팅으로 GPT-4가 flat 방식에서 완전히 실패하던 systolic array와 UART 생성에 성공했다. 토큰 비용은 최대 58.8% 절감됐다.
- 같은 연구에서 작은 모델들은 계층 계획(hierarchy plan) 자체를 세우지 못했다. 잘게 쪼개는 것은 정답이지만, "어떻게 쪼갤지"를 정하는 설계는 여전히 어려운 일이다.
- 실무적 함의는 명확하다. 파티션 크기를 정하는 기준이 "팀의 인원수"에서 "AI의 컨텍스트 윈도우"로 이동하고 있다. 칩렛(chiplet) 트렌드와 맞물리면 설계 방법론과 조직이 함께 바뀔 것이다.
1. 문제의식: 왜 flat하게 생성하면 터지는가
LLM으로 Verilog를 생성하는 연구는 2023년부터 본격화됐다. VerilogEval(2023년 11월 공개)이 표준 벤치마크가 됐고, RTLCoder, Chip-Chat 같은 초기 연구들이 뒤를 이었다. 그런데 이 초기 연구들에는 공통된 한계가 있었다. 모듈을 계층 구조 없이, 하나의 긴 straight-line 코드 블록으로 생성한다는 점이다.
이 방식은 작은 디자인에서는 통한다. 문제는 복잡도가 올라가는 지점이다. ROME 논문의 표현을 빌리면, 복잡한 디자인의 straight-line 코드 블록은 계층적 대안보다 길어질 수밖에 없고, 길어진 출력에서 LLM은 hallucination을 일으킨다. LLM이 텍스트를 너무 길게 생성하면 원래 목표의 컨텍스트를 잃어버리는 경우가 잦다는 것이다.[1]
여기서 한 걸음 더 들어가 보자. 소프트웨어 코드와 달리 Verilog는 병렬(parallel) 시맨틱을 가진다. always 블록들이 동시에 돌고, 클록 엣지에 상태가 바뀐다. LLM의 학습 데이터에서 Verilog가 차지하는 비중은 작고, 그나마도 대부분이 작은 예제 코드다. 길어진 생성에서 모델이 "지금 내가 어떤 클록 도메인의 어떤 상태를 기술하고 있었지"를 놓치는 순간, 문법적으로는 맞지만 의미적으로는 틀린 코드가 나온다.
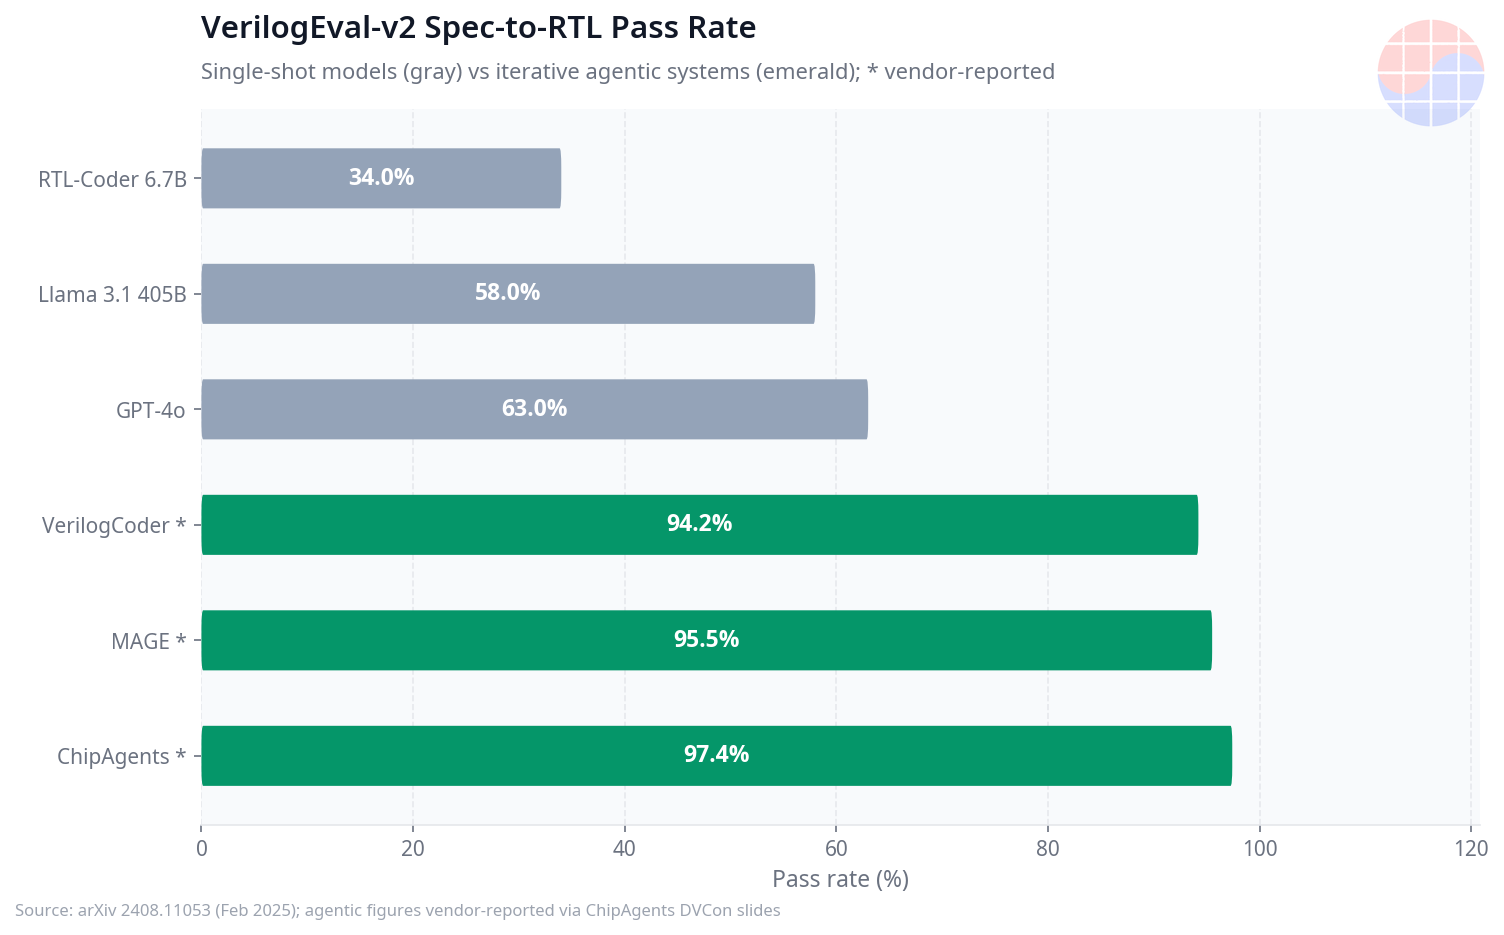
벤치마크 점수 추이를 보면 이 한계가 어디까지 왔는지도 보인다. NVIDIA 팀의 "Revisiting VerilogEval"(arXiv, 2025년 2월 개정)에 따르면, GPT-4o는 spec-to-RTL 태스크에서 63%의 pass rate를 기록했다. 오픈 모델인 Llama 3.1 405B도 58%로 거의 따라잡았다. 그런데 iterative한 agentic 시스템들의 보고치는 차원이 다르다. ChipAgents 97.4%, MAGE 95.5%, VerilogCoder 94.2%(이상 2026년 ChipAgents DVCon 슬라이드에서 인용된 벤더 보고치)다. 벤치마크 자체는 iterative 시스템들에 의해 사실상 포화 상태에 가깝다. 이제 전선은 "맞게 생성하기"에서 "PPA를 좋게, 시스템 레벨에서 맞게 만들기"로 이동했다.
- 이 섹션의 한계: 벤더 보고치(agentic 시스템들의 94~97%)는 각 사가 자사 슬라이드에서 주장한 수치로, 독립적인 제3자 검증은 없다. single-shot 모델과 iterative 시스템의 측정 조건도 동일하지 않다. ↩︎
2. RTLRewriter: 쪼개면 최적화가 달라진다
생성이 아니라 최적화에서도 같은 이야기가 나온다. 홍콩중문대(CUHK) Bei Yu 교수팀의 RTLRewriter(2024년 9월 arXiv 공개, ICCAD 2024 발표)는 LLM을 이용한 RTL 코드 최적화 방법론을 다룬다. 이 논문의 가장 날카로운 대목은 3.1절 "Circuit Partition"에 있다.
저자들은 트랜스포머 기반 모델에서 긴 컨텍스트를 이해하는 문제가 여전히 풀리지 않았다는 점을 먼저 짚는다. quadratic complexity 때문이다. 그리고 실측 관측을 내놓는다. 회로 전체에 rewriting을 적용하는 것보다, 파티셔닝된 서브서킷에 적용했을 때 rewriting의 효과가 확연히 좋아졌다는 것이다. 작은 조각이 LLM의 "작업 기억" 안에 들어오면, 모델은 그 조각의 구조와 의도를 제대로 파악하고 최적화할 수 있다.
RTLRewriter의 파티셔닝 파이프라인 자체도 눈여겨볼 만하다. RTL 코드를 파싱해 AST로 바꾸고, instance tree로 변환한 뒤, 각 노드(Verilog 모듈)의 synthesis time을 예측하는 circuit predictor를 돌린다. 그 예측을 바탕으로 전체 synthesis workload를 균등하게 나누면서 성능 손실을 최소화하는 방향으로 파티션을 자른다. 즉 파티셔닝 자체를 최적화 문제로 푼 것이다.
여기서 필자가 주목하는 포인트는 하나다. 파티셔닝은 원래 업계에서 synthesis 시간을 줄이기 위한 실무 관행이었다. RTLRewriter는 그 실무 관행에 AI 시대의 두 번째 이유를 덧붙였다. LLM이 이해할 수 있는 단위로 나누는 것. 같은 행위, 다른 목적이다. 앞으로 파티셔닝을 논할 때 "왜 쪼개는가"에 대한 답이 두 개가 될 것이다. 병렬 합성을 위해서, 그리고 AI가 이해하게 하기 위해서.
3. HiVeGen: 계층적 생성에 DSE를 얹다
HiVeGen(arXiv 2412.05393, 2024년 12월 공개)은 "Hierarchical LLM-based Verilog Generation for Scalable Chip Design"이다. 문제의식은 명확하다. LLM은 하드웨어 디자인을 계층 구조가 아니라 단일 HDL 코드 블록으로 생성하려는 경향이 있고, 이는 특히 domain-specific accelerator(DSA) 같은 복잡한 디자인에서 hallucination으로 이어진다.
HiVeGen의 처방은 생성 태스크를 "LLM이 감당 가능한 계층적 서브모듈"로 분해하는 것이다. 여기서 그치지 않고 세 가지를 얹는다. 첫째, automatic design space exploration(DSE)을 hierarchy-aware prompt generation에 통합한다. 둘째, weight-based retrieval로 코드 재사용을 강화한다. 셋째, 실시간 human-computer interaction으로 에러 수정 비용을 낮춘다.
필자의 코멘트를 덧붙이면, 첫 번째가 가장 중요하다. DSE를 계층 구조에 붙였다는 것은, 파티션 단위로 PPA 탐색을 돌릴 수 있다는 뜻이다. 칩 전체를 한 번에 탐색하는 것보다 작은 조각들을 병렬로 탐색하는 게 효율적이라는 건, DOE 자동화 에이전트의 논의와 정확히 맞물린다.
4. ROME: 계층적 프롬프팅의 증명
이 시리즈의 테제를 가장 정면으로 증명한 논문은 NYU 팀의 ROME이다. "Rome was Not Built in a Single Step: Hierarchical Prompting for LLM-based Chip Design"(arXiv 2407.18276, 2024년 7월 공개, MLCAD 2024 발표).
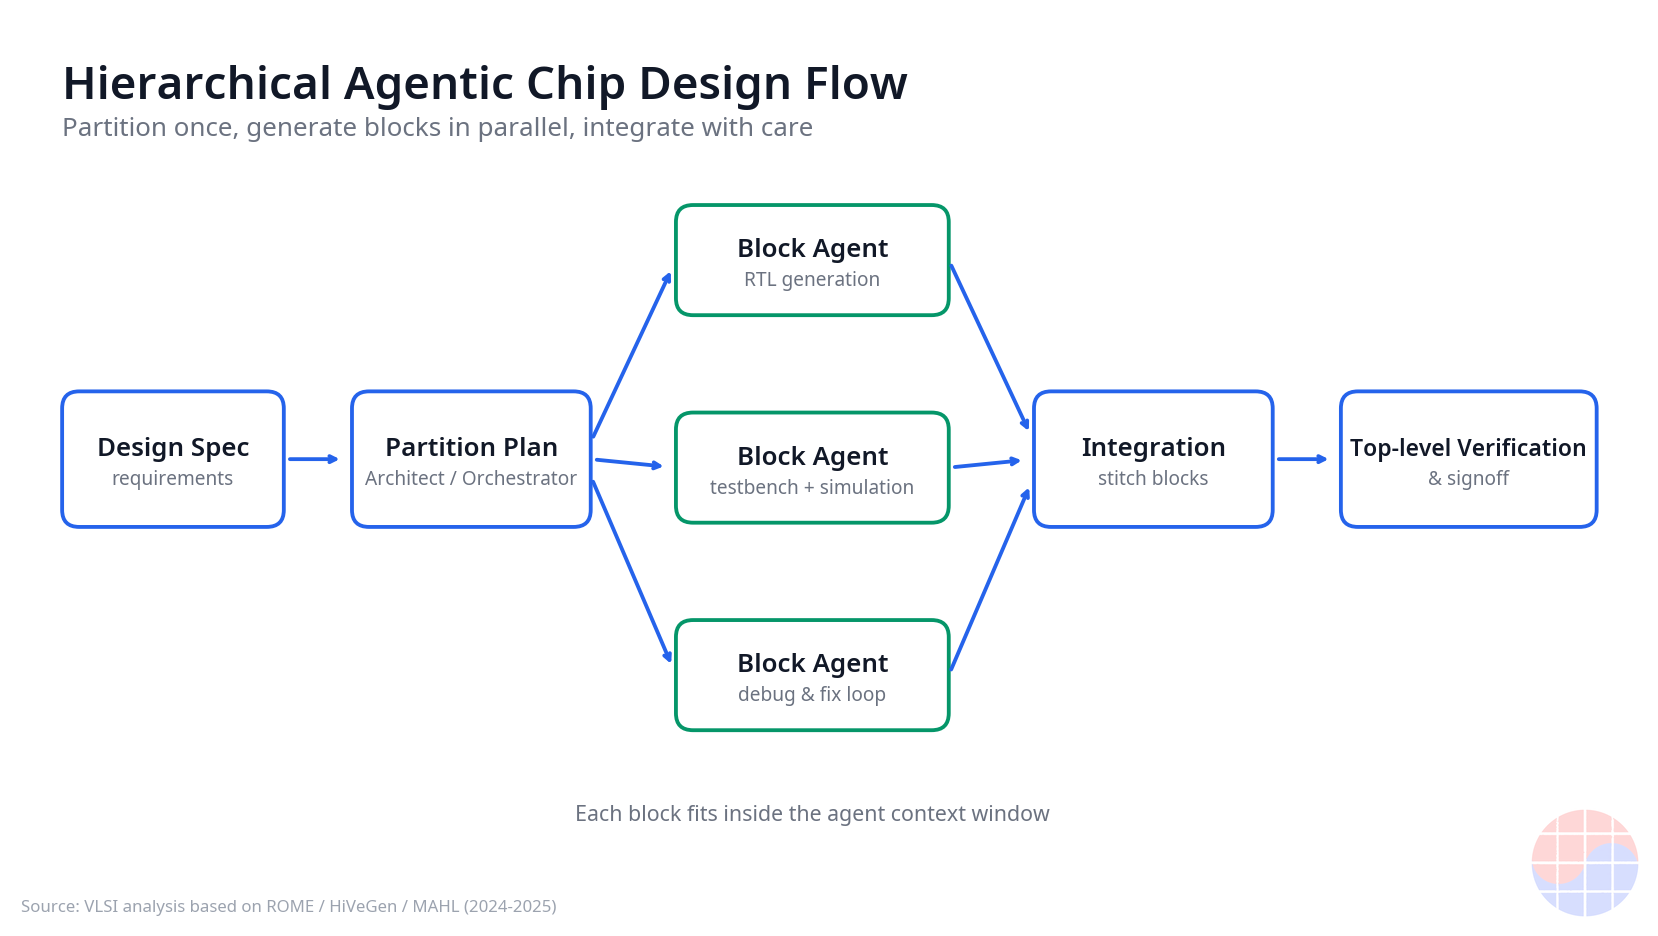
핵심 아이디어는 단순하다. 계층 구조를 프롬프팅으로 주입하는 것이다. 두 가지 모드가 있다. HDHP(human-driven hierarchical prompting)는 인간이 제안한 계층 구조를 프롬프트에 담고, 각 서브모듈의 unit test에서 나오는 컴파일러 피드백으로 반복 수정한다. PGHP(purely generative hierarchical prompting)는 한 걸음 더 나아간다. LLM에게 기본적인 프롬프트만 주고, 필요한 블록의 분해부터 스스로 하게 만든다.
두 모드의 구분이 중요한 이유는, 이것이 정확히 "인간의 역할이 어디까지 남는가"에 대한 실험 설계이기 때문이다. 그리고 논문의 결과는 이 구분을 정교하게 보여준다. PGHP에서 계층 계획을 스스로 세우는 데 성공한 것은 GPT-4뿐이었고, 작은 모델들은 서브모듈을 빼먹거나 엉뚱한 모듈을 끼워넣으며 실패했다. 즉 "쪼개는 계획"은 "쪼개진 조각의 구현"보다 한 차원 어려운 작업임이 실증된 셈이다.
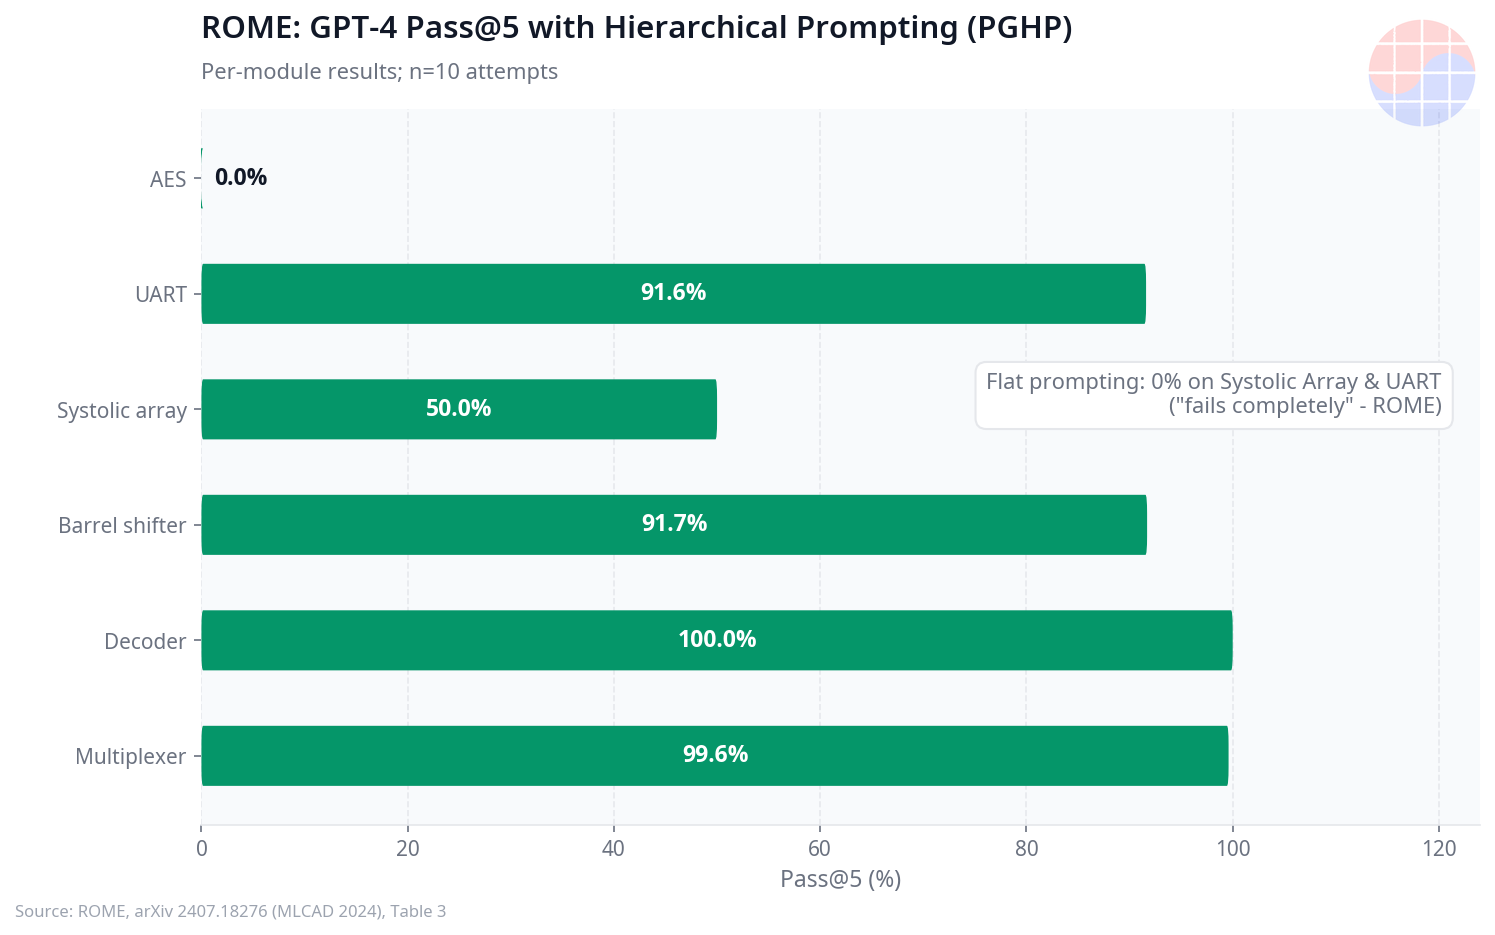
결과는 극적이었다. PGHP를 적용한 GPT-4는 flat 방식에서 완전히 실패하던 systolic array와 UART의 유효한 구현을 생성해냈다. 벤치마크 6종에 대한 GPT-4 PGHP의 pass@5는 multiplexer 99.6%, decoder 100%, barrel shifter 91.7%, systolic array 50%, UART 91.6%였다. (AES는 0%로, 아직 한계도 분명하다.)[1]
더 흥미로운 건 비용이다. 계층적 프롬프팅은 생성 시간도 줄이고 토큰 비용도 줄였다. 32-bit RISC-V 프로세서 생성에서 토큰 비용이 58.8% 절감됐다. 복잡한 모듈일수록 절감폭이 컸다.
그리고 이 논문이 남긴 가장 도발적인 기록. PGHP로 GPT-4가 16-bit MIPS 프로세서를 "인간의 개입 없이" 설계했다는 것이다. 초기 프롬프트 하나 이후에는 모든 설계 결정과 에러 핸들링이 자동으로 이뤄졌고, 23분 37초 만에 synthesize 가능한 프로세서가 나왔다.
5. VeriBToT: 스스로 쪼개고 스스로 검증하는 추론
2025년 11월에는 추론 패러다임 자체를 건드리는 논문이 나왔다. 중국과학원 ICT와 홍콩중문대 팀의 VeriBToT, "Think with Self-Decoupling and Self-Verification: Automated RTL Design with Backtrack-ToT"(arXiv 2511.13139, 2025년 11월 17일 공개)이다.
문제의식이 날카롭다. chain-of-thought(CoT)는 IC 설계 워크플로우 자동화에서 대체로 무효했고, 수동 개입이 필요했다는 것이다. 핵심 이슈는 CoT의 추론 방향과 단계별 세분도(granularity)를 제어하는 것인데, 이것이 전문가의 RTL 설계 지식과 맞지 않는다는 진단이다.
VeriBToT의 답은 top-down 접근과 DFV(design-for-verification)를 결합한 것이다. 중간 단계들의 self-decoupling과 self-verification을 달성하고, Backtrack Tree of Thought를 구축한다. DFV라는 개념에 주목할 필요가 있다. 에이전트가 스스로를 검증할 수 있는 단위로 생각을 나누라는 것이다. 검증 가능한 크기로 쪼개라. 이는 RTLRewriter의 "이해 가능한 크기로 쪼개라", HiVeGen의 "생성 가능한 크기로 쪼개라"와 같은 문장의 다른 변주다. 2025년의 연구들은 서로 다른 각도에서 같은 결론에 도달하고 있다. AI가 다루는 모든 것의 단위는 모듈이다.
6. MAHL: 칩렛으로 확장되는 계층 설계
MAHL, "Multi-Agent LLM-Guided Hierarchical Chiplet Design with Adaptive Debugging"(arXiv 2508.14053, 2025년 8월 공개)이다. 모듈 단위 생성을 넘어, 2.5D 칩렛 설계까지 LLM의 영역을 확장하려는 시도다.
MAHL은 6개의 에이전트가 협업하는 프레임워크다. 논문이 제시한 수치가 인상적이다. 실세계 칩렛 설계에 대한 Pass@5가 기존 LLM 대비 best-case 기준으로 0에서 0.72로 올랐다. 기존 LLM으로는 단 한 번도 성공하지 못하던 실세계 칩렛 설계가, 계층적 멀티에이전트 구조에서는 72%의 시도에서 성공한다는 뜻이다.
여기서 읽어야 할 흐름은 스케일업이다. HiVeGen(모듈) → MAHL(칩렛). 계층적 분해라는 같은 무기로 다루는 단위가 커지고 있다. 그리고 칩렛은 우연한 선택이 아니다. 업계 전체가 모놀리식 SoC에서 칩렛으로 이동하는 지금, AI 에이전트의 파티셔닝 단위와 산업의 파티셔닝 단위가 같은 방향을 가리키고 있다.
7. Architect in the Loop: 통합이 병목이다
여기까지가 "쪼개면 똑똑해진다"는 이야기였다. 이제 반대편을 보자. "Architect in the Loop Agentic Hardware Design and Verification"(arXiv 2512.00016, 2025년 10월)은 에이전트에게 RISC-V CPU의 풀 설계를 맡긴 실험을 보고한다.
결과는 냉정했다. 컴포넌트 레벨에서는 성공했지만, 시스템 레벨 검증에서는 예외 없이 실패했다. 저자들이 제안한 처방은 architect-in-the-loop 패러다임이다. 완전 자율이 아니라, 아키텍트가 루프 안에 들어가는 구조가 경제적으로 viable하다는 것이다.
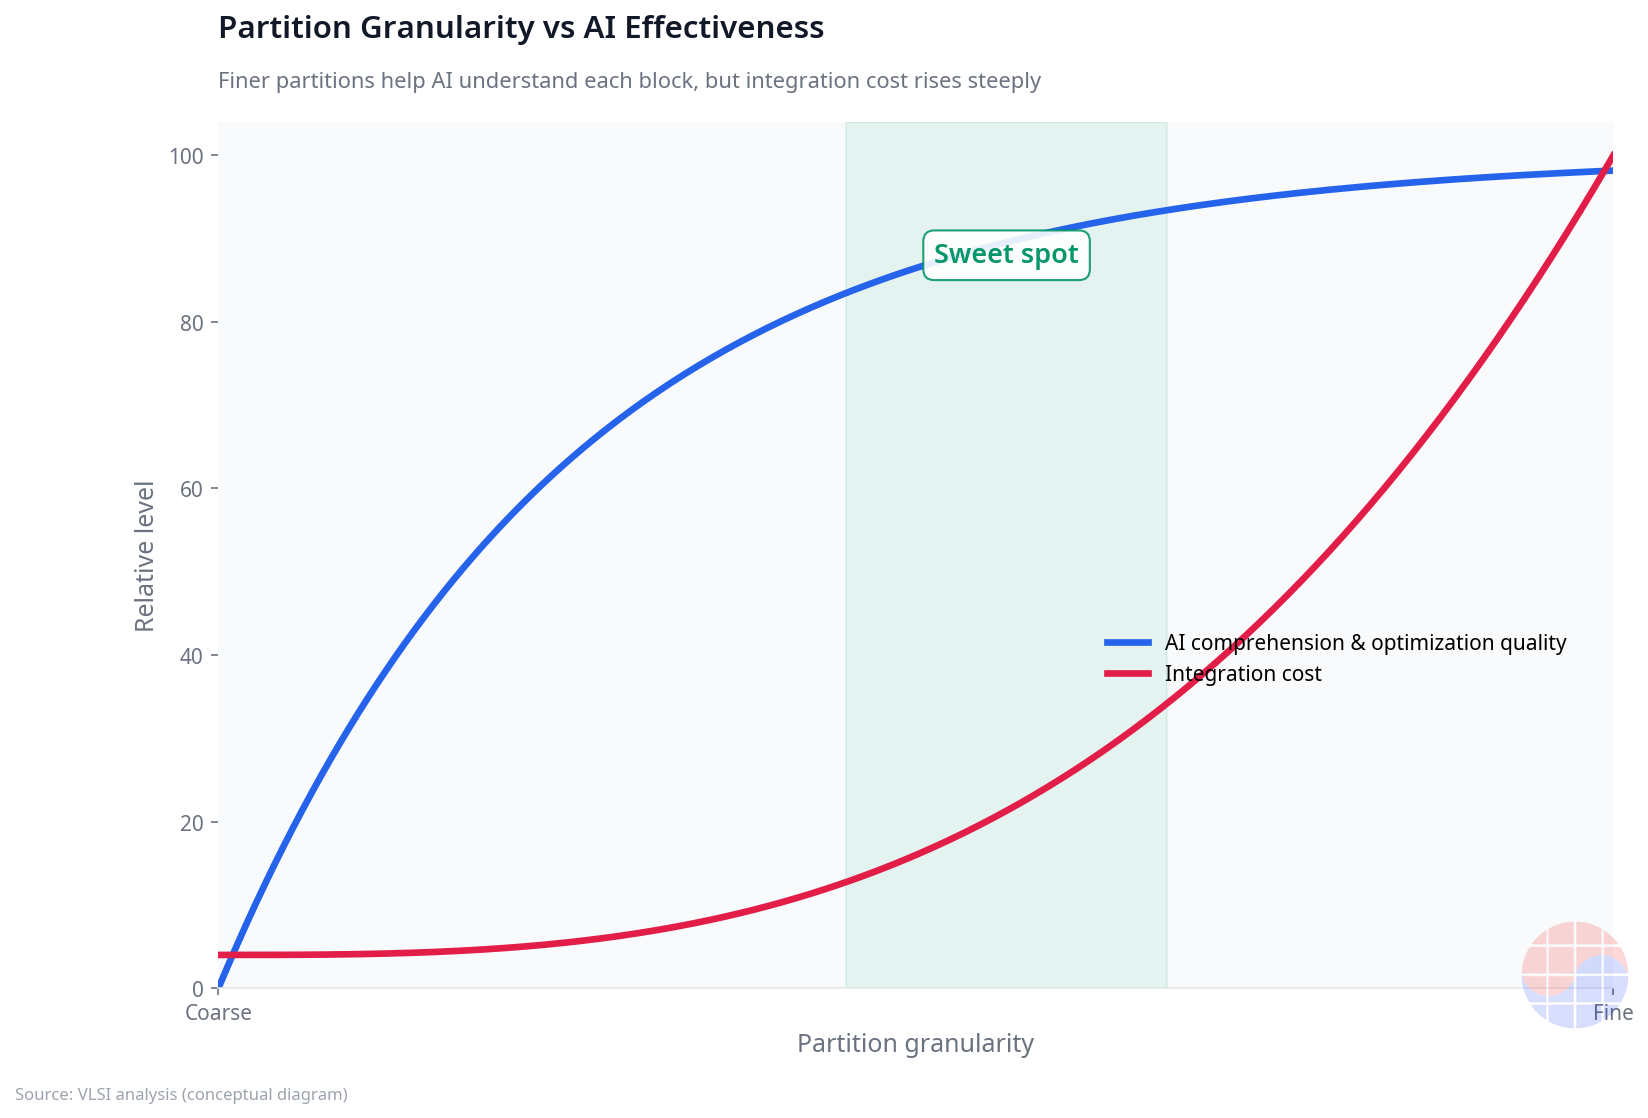
이 논문이 던지는 질문은 이것이다. 조각을 잘 만드는 것과 조각들을 잘 붙이는 것은 다른 스킬이다. 파티션이 수백 개가 되면 각 블록의 인터페이스 정의, 통합, 시스템 레벨 검증이 새로운 병목이 된다. 잘게 쪼갤수록 AI가 똑똑해지는 것은 맞지만, 쪼갠 것을 다시 하나로 만드는 비용도 함께 올라간다.[2]
architect-in-the-loop가 구체적으로 무엇을 의미하는지도 짚자. 아키텍트가 파티션 계획을 세우고, 블록 간 인터페이스 contract를 정의하고, 시스템 레벨 검증의 판정을 내리는 주체로 남는 것이다. 에이전트들이 각자의 파티션 안에서 아무리 똑똑해져도, 파티션 사이의 정합성을 보증하는 것은 다른 차원의 작업이다.
- 이 섹션의 한계: pass@k는 n=10 시도 기준의 논문 자체 측정치다. AES 0%에서 보듯, 복잡도가 일정 수준을 넘으면 계층 구조만으로는 풀리지 않는다. ↩︎
- 이 섹션의 한계: 해당 논문의 실험은 특정 RISC-V CPU 설계에 대한 것으로, 모든 복잡도의 디자인에 일반화할 수는 없다. ↩︎
8. 실무적 함의: 파티션 기준의 이동
이제 연구실을 떠나 실무로 시선을 돌려보자.
과거의 파티셔닝은 조직도의 함수였다. 블록 하나당 오너 엔지니어 한 명이 필요했기 때문에, 파티션 개수는 팀 인원수에 맞춰 최소한으로 쪼개졌다. 이건 Conway's law의 전형적인 발현이다. 조직 구조가 아키텍처를 닮는 것.
에이전트 시대에는 목적함수가 뒤집힌다. 파티션 크기를 정하는 기준이 "인간 조직의 인원수"에서 "AI의 컨텍스트 윈도우"로 바뀌는 것이다. 병렬로 돌릴 수 있는 에이전트 수만큼, 각 에이전트가 이해할 수 있는 크기만큼 쪼개는 것이 최적해가 된다. 칩의 계층 구조가 에이전트 스웜의 구조를 닮게 되는, Conway's law의 역전이다.
그리고 이 흐름은 업계의 칩렛(chiplet) 트렌드와 정확히 맞물린다. 칩렛으로의 이동은 원래 수율과 비용이 동기였다. 이제 여기에 두 번째 동기가 붙는다. AI 병렬화다. 잘게 쪼갠 설계일수록 에이전트가 이해하고 최적화하기 좋고, 파티션 단위로 DOE를 병렬 실행할 수 있다.
다만 물리적 현실도 짚어야 한다. 논리적으로 잘게 쪼개는 것과 물리적으로 잘게 구현하는 것은 다른 문제다. P&R은 파티션 경계를 넘나드는 타이밍을 싫어하고, 클록 분배와 파워 그리드는 경계가 많아질수록 골치가 아파진다. 논리적 계층과 물리적 계층을 어떻게 매핑할지는 여전히 인간 아키텍트의 설계 영역이다.
9. 한계와 전망
솔직한 한계도 정리하자. 블록이 수백 개가 되면 탑레벨 통합 지옥이 열린다. 인터페이스 타이밍 버짓을 누가 정하는가. CDC 경계가 수백 개가 되면 누가 검증하는가. ROME의 MIPS 프로세서 실험에서도 드러났듯, 서브모듈들의 입출력 와이어 네이밍을 통일시키는 것 같은 "사소해 보이는" 통합 작업이 자동화의 발목을 잡는다.
그래서 3부의 결론은 이렇게 수렴한다. 파티셔닝을 잘하는 AI와 통합을 책임지는 아키텍트의 분업이다. AI는 잘게 쪼개진 조각들을 이해하고 최적화하는 데 점점 능숙해질 것이다. 그러나 "어떻게 쪼갤지"를 정하는 파티션 계획, 블록 간 인터페이스 정의, 시스템 레벨 검증과 최종 사인오프는 아키텍트의 핵심 역량으로 남는다.
전망을 조심스럽게 내놓으면 이렇다. 중소형 칩에서는 5년 안에 "엔지니어 한 명 + 에이전트들"이 칩 전체를 끌고 가는 모습이 현실이 될 수 있다. 최선단 SoC에서는 architect-in-the-loop 구조가 오래 지속될 것이다. 어느 쪽이든, 파티션을 설계하는 능력의 가치는 올라가고, 런을 돌리며 에러를 잡는 파이프 클리닝의 가치는 내려간다.
마지막으로 토큰 이코노믹스 관점도 짚자. ROME의 결과는 계층적 프롬프팅이 단순히 정확도뿐 아니라 비용 문제도 푼다는 것을 보여준다. 32-bit RISC-V 프로세서 생성에서 토큰 비용이 58.8% 절감됐다. long-horizon 에이전트가 수천 스텝을 도는 시대에 토큰 비용은 곧 설계 비용이다. 파티셔닝은 정확도의 문제이자 경제성의 문제다. 잘게 쪼개는 팀이 더 싸게, 더 빨리 칩을 만든다.
FAQ
Q1. 계층적 설계가 만능인가? 작은 디자인에도 필요한가?
아니다. 작은 디자인은 flat하게 생성해도 잘 된다. 계층 구조의 이득은 복잡도가 올라가는 지점에서 발생한다. 계층화는 만능 처방이 아니라, 복잡도에 대한 처방이다.
Q2. 파티션을 잘게 쪼갤수록 무조건 좋은가?
아니다. 트레이드오프가 있다. 블록이 작아질수록 AI의 이해도와 최적화 품질은 올라가지만, 통합 비용(인터페이스 정의, CDC 검증, 탑레벨 타이밍 클로저)도 함께 올라간다. 최적의 파티션 크기는 "AI가 이해할 수 있는 최대 단위"와 "통합 비용이 감당 가능한 최소 단위" 사이 어딘가에 있다.
Q3. 작은 모델은 계층 설계를 정말 못 하는가?
ROME 논문의 실험에 따르면, 순수 생성 모드(PGHP)에서 계층 계획을 스스로 세우는 데 성공한 것은 GPT-4뿐이었다. 다만 human-driven 모드(HDHP)에서는 인간이 계층 구조를 주면 작은 모델들도 복잡한 모듈 생성에 성공했다. "쪼개는 계획"과 "쪼개진 조각의 구현"은 다른 난이도의 작업이다.
Q4. 이 연구들이 실제 tapeout까지 이어진 사례가 있나?
2026년 10월 현재, 완전히 자율적인 에이전트에 의한 산업 규모 칩의 tapeout이 독립적으로 검증된 사례는 없다. 연구는 방향을 증명하는 단계에 있다.
Q5. 현업 엔지니어는 무엇을 준비해야 하나?
파티션 계획, 인터페이스 정의, 시스템 레벨 검증과 사인오프 판단. 즉 아키텍처를 나누고 붙이는 능력이다. STA signoff 같은 "신뢰를 보증하는 레이어"의 전문성은 오히려 가치가 올라간다.
Sources
- ROME — Nakkab et al., "Rome was Not Built in a Single Step: Hierarchical Prompting for LLM-based Chip Design", arXiv 2407.18276 (2024년 7월), MLCAD 2024 발표. https://arxiv.org/abs/2407.18276
- HiVeGen — Tang et al., "HiVeGen: Hierarchical LLM-based Verilog Generation for Scalable Chip Design", arXiv 2412.05393 (2024년 12월, 2025년 10월 개정). https://arxiv.org/abs/2412.05393
- RTLRewriter — "Methodologies for Large Models aided RTL Code Optimization", arXiv 2409.11414 (2024년 9월), ICCAD 2024. https://arxiv.org/abs/2409.11414
- VeriBToT — Chao et al., "Think with Self-Decoupling and Self-Verification: Automated RTL Design with Backtrack-ToT", arXiv 2511.13139 (2025년 11월 17일). https://arxiv.org/abs/2511.13139
- MAHL — Tang et al., "MAHL: Multi-Agent LLM-Guided Hierarchical Chiplet Design with Adaptive Debugging", arXiv 2508.14053 (2025년 8월, 10월 개정). https://arxiv.org/abs/2508.14053
- Architect in the Loop — "Architect in the Loop Agentic Hardware Design and Verification", arXiv 2512.00016 (2025년 10월). https://arxiv.org/abs/2512.00016
- VerilogEval revisited — Pinckney et al., "Revisiting VerilogEval: A Year of Improvements in Large-Language Models for Hardware Code Generation", arXiv 2408.11053 (2025년 2월 개정). https://arxiv.org/abs/2408.11053
자주 묻는 질문
RTLRewriter가 확인한 파티셔닝 효과는 무엇인가요?
파티션된 서브서킷에 적용했을 때 재작성 효과가 확연히 좋아졌다는 것입니다. 홍콩중문대 팀의 RTLRewriter(ICCAD 2024)는 트랜스포머의 긴 컨텍스트 이해 한계가 원인이라고 짚었고, 파티셔닝 자체를 합성 시간 예측 기반의 최적화 문제로 풀었습니다.
ROME의 계층적 프롬프팅 결과는 어땠나요?
NYU 팀의 ROME(MLCAD 2024)에서 계층적 프롬프팅을 적용한 GPT-4는 플랫 방식에서 완전히 실패하던 시스톨릭 어레이와 UART의 유효한 구현을 생성했습니다. pass@5는 멀티플렉서 99.6%, 디코더 100%, 배럴 시프터 91.7%, UART 91.6%였고 AES는 0%로 한계도 남았습니다.
계층적 프롬프팅은 토큰 비용을 얼마나 줄였나요?
32비트 RISC-V 프로세서 생성에서 토큰 비용이 58.8% 줄었고 복잡한 모듈일수록 절감 폭이 컸습니다. 생성 시간도 함께 줄었다고 보고됐습니다.
계층 계획을 스스로 세우는 데 성공한 모델은 무엇인가요?
GPT-4만 성공했습니다. 작은 모델들은 서브모듈을 빠뜨리거나 엉뚱한 모듈을 끼워 넣어 실패했는데, 이는 쪼개는 계획을 세우는 일이 쪼개진 조각을 구현하는 일보다 한 차원 어려운 작업임을 보여줍니다.
관련 글