VLSI Korea
AI가 AI 칩을 설계한다: OpenAI·Anthropic·Tesla가 실리콘에 뛰어든 진짜 이유
🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다 TL;DR — 2026년 10월 현재, 모든 frontier AI 랩이 칩 회사가 되었다. OpenAI는 2026년 6월 Broadcom과 함께 첫 inference 칩 Jalapeño를 공개했고, 8월 Hot Chips에서는 NVIDIA GB200/GB300 대비 1.5~1.9배의 전력당 처리량과 1.7~3.6배 낮은 latency를 발표했다(OpenAI 자체 측정). Anthropic은 2026년 8월 custom silicon 팀을 공식


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
TL;DR — 2026년 10월 현재, 모든 frontier AI 랩이 칩 회사가 되었다. OpenAI는 2026년 6월 Broadcom과 함께 첫 inference 칩 Jalapeño를 공개했고, 8월 Hot Chips에서는 NVIDIA GB200/GB300 대비 1.5~1.9배의 전력당 처리량과 1.7~3.6배 낮은 latency를 발표했다(OpenAI 자체 측정). Anthropic은 2026년 8월 custom silicon 팀을 공식 인정했고, Claude에게 RTL 생성·verification·PD 최적화를 가르치는 RL 환경을 만드는 연구원을 별도로 뽑고 있다. xAI의 'Macrohard'는 칩이 아니라 소프트웨어 에이전트 회사이며, 머스크 진영의 실리콘은 Tesla(AI4 출하 중, AI5 양산 검증, AI6는 2026년 12월 tapeout 목표)에 있다. 이들이 칩을 만드는 이유는 세 가지다 — inference 비용, 공급 협상력, 모델-하드웨어 co-design. 그리고 이 글의 핵심은 이것이다: OpenAI는 Jalapeño를 자기들의 LLM으로 설계했고(IEEE Spectrum, 2026년 9월), Anthropic은 Claude를 칩 설계자로 키우고 있으며, NVIDIA는 NeMo Gym이라는 RL 인프라로 EDA 업체들의 에이전트를 먹여 살린다. 'AI가 AI 칩을 설계하는' 플라이휠이 이미 돌기 시작했다.
1. 왜 지금 AI 랩이 칩을 만드는가
질문은 "만들 수 있는가"가 아니라 "왜 직접 만드는가"다. 답은 세 가지로 수렴한다.
첫째, inference 비용. 학습은 한 번이지만 inference는 영원히 돈다. 모델이 커지고 agent 워크로드가 늘수록 토큰당 비용이 곧 사업의 손익분기점이 된다. OpenAI는 Jalapeño 공개 당시(2026년 6월) 토큰당 inference 비용을 NVIDIA GPU 대비 약 50% 낮추겠다고 밝혔고(벤더 주장, 기술 보고서 미공개), Anthropic은 칩-모델 co-design으로 inference 비용을 대폭 낮추는 것을 팀의 명시적 목표로 걸었다(언론 보도 기준).
둘째, 공급과 협상력. 한 벤더에 목을 매면 가격은 벤더가 정한다. 그래서 모두가 "multi-chip 접근"을 말하면서도 동시에 자체 칩을 만든다. 중요한 점은 아무도 NVIDIA와 결별을 선언하지 않았다는 것이다. OpenAI는 학습용으로 NVIDIA를 계속 쓰고, Anthropic은 AWS·Google·NVIDIA·AMD 네 벤더를 유지한다. 자체 칩은 탈(脫)NVIDIA 선언이 아니라 가격표에 대한 협상 카드다.
셋째, 모델-하드웨어 co-design. 범용 GPU는 모든 워크로드를 돌려야 해서 비효율이 구조적이다. 자기 모델의 attention 패턴, decode 특성, 메모리 접근 패턴에 맞춰 실리콘을 깎으면 같은 와트에서 더 많은 토큰이 나온다. Jalapeño가 정확히 이 베팅이다.
왜 하필 2026년인가도 짚을 필요가 있다. 2024~2025년의 칩 이야기는 학습용이었다. 그런데 2026년에 들어서며 agent 워크로드가 폭발했다. 에이전트는 한 번의 질문에 수십 번의 모델 호출을 일으킨다. 학습 비용은 고정비지만 inference는 변동비라서, 사용량이 늘수록 토큰당 원가가 사업 전체를 지배한다. 그래서 칩을 만드는 주체가 하이퍼스케일러에서 AI 랩으로 내려온 것이다.
2. OpenAI Jalapeño — AI 랩 최초의 실리콘
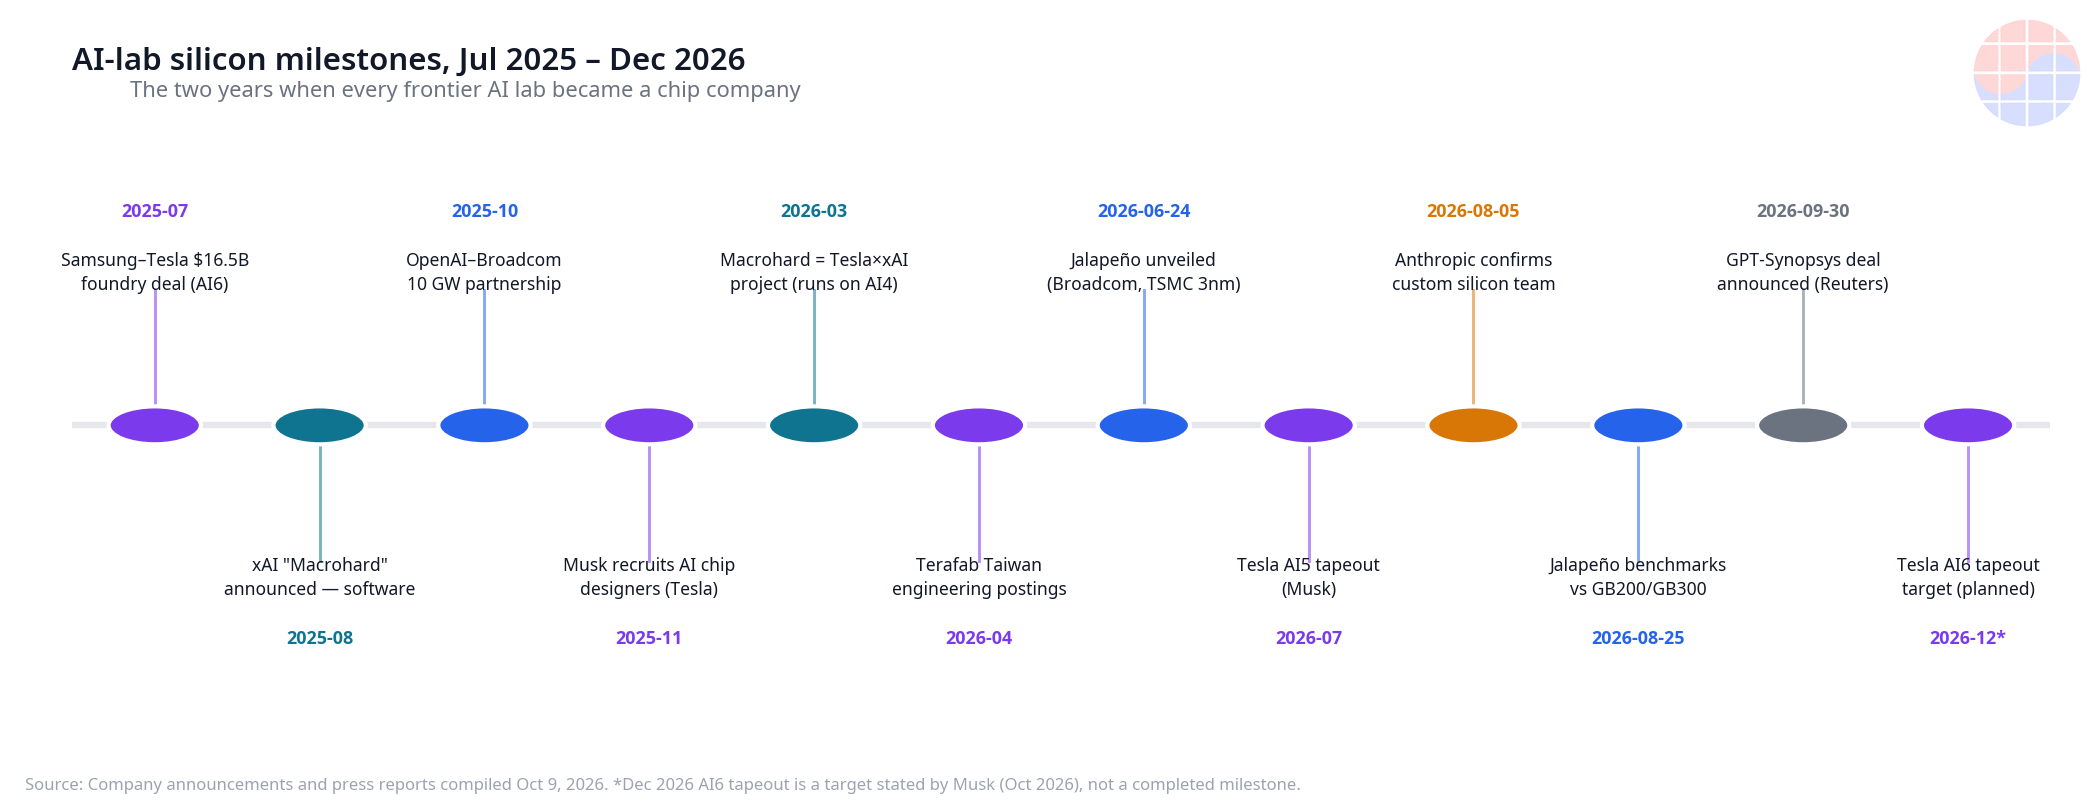
2026년 6월 24일, OpenAI와 Broadcom은 Jalapeño를 공개했다. TSMC 3nm 공정의 inference 전용 ASIC으로, systolic array 아키텍처에 8개의 HBM 스택을 2.5D 인터포저 위에 올린 구조다. Broadcom이 실리콘 구현과 Tomahawk 네트워킹을 맡고, Celestica가 보드·랙 통합을 담당했다.
숫자를 보자. 공개 당시 OpenAI는 토큰당 inference 비용을 현행 GPU 대비 약 50% 낮추겠다고 주장했다. 하지만 이를 뒷받침하는 기술 보고서는 나오지 않았고, 이 주장은 지금까지도 검증되지 않은 상태다. 판이 바뀐 것은 2026년 8월 25일 Hot Chips 2026이다. OpenAI는 SemiAnalysis의 공개 벤치마크 InferenceX로 측정한 결과를 발표했다. GPT-OSS 120B 대 NVIDIA GB200에서 피크 처리량당 와트 1.9배, end-to-end latency는 1.80초에서 1.03초로. DeepSeek R1 670B 대 GB300에서 1.7배, latency는 5.99초에서 1.65초로. Jalapeño는 700W, 비교 대상 GB300 시스템은 1,400W다. 절반의 전력으로 더 많은 일을 했다는 얘기다.
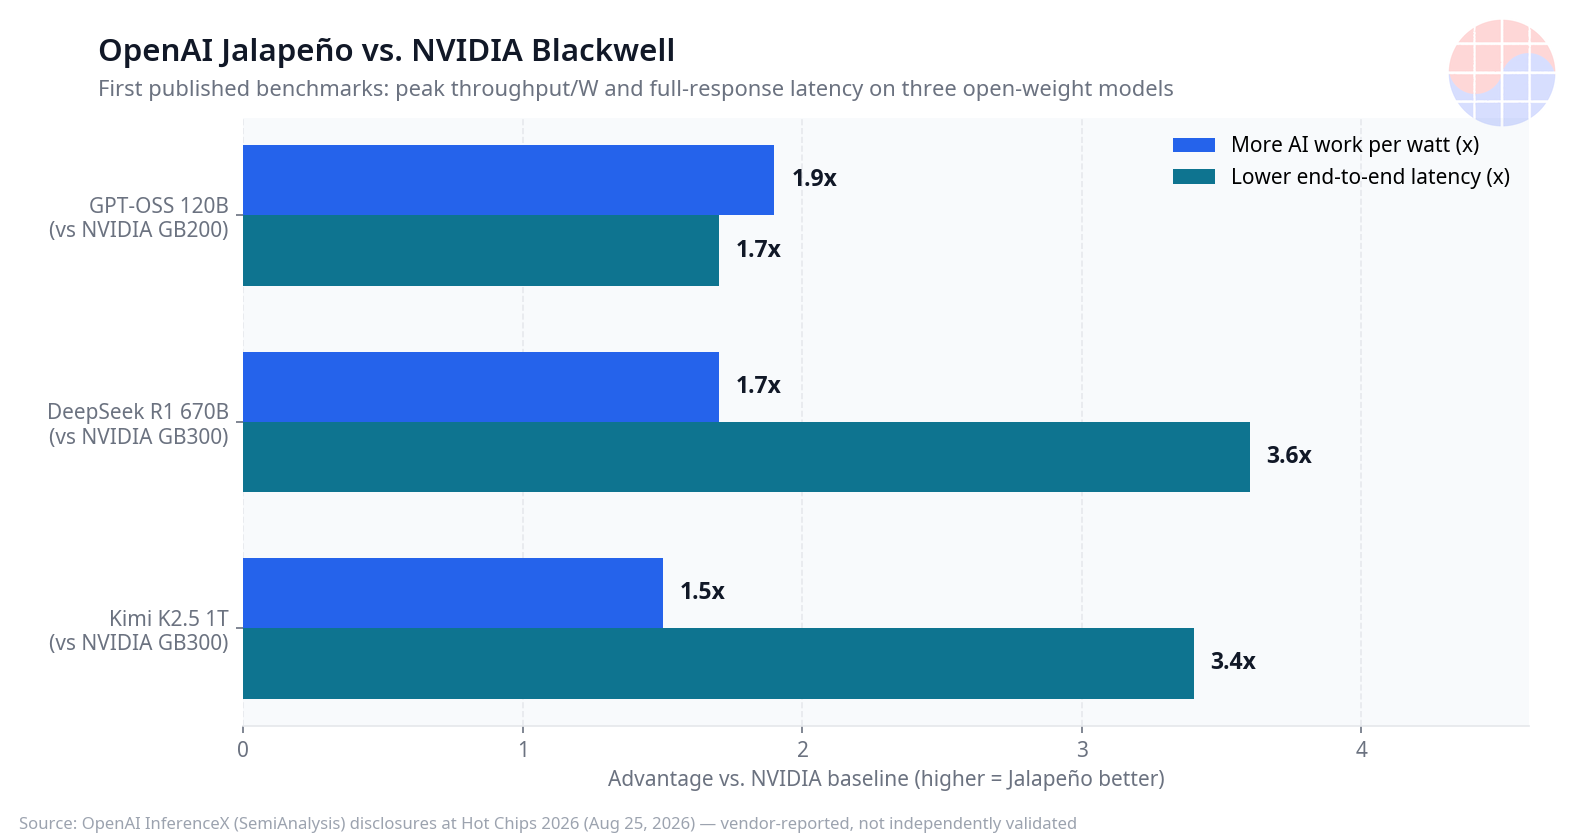
물론 함정이 있다. Jalapeño는 HBM4를 쓰고 비교 대상 GB200/GB300은 HBM3e다. inference 성능을 좌우하는 메모리 대역폭 세대가 다르니 엄밀한 동일 세대 비교는 아니다. 또 이 모든 수치는 OpenAI 자체 측정이다. 독립 벤치마크가 나올 때까지는 '잠정적'으로 읽는 것이 맞다.
팀 이야기도 흥미롭다. 하드웨어를 이끄는 것은 Richard Ho(OpenAI 하드웨어 VP, 전 Google TPU)다. 2025년 2월 로이터 보도 당시 팀은 약 40명. 2026년 Hot Chips 시점의 2차 보도에 따르면 평균 100명 미만의 인원으로 움직였다. 100명도 안 되는 팀이 9개월(first-RTL부터 tapeout까지) 만에 고성능 ASIC을 뽑아낸 것이다. Engineering sample은 사내에서 GPT-5.3 Codex 워크로드를 돌리고 있고, Microsoft는 초도 물량의 40%를 가져가기로 했다(2차 보도 기준).
여기서 역할 분담을 정확히 해야 한다. 2차 보도에 따르면 OpenAI가 칩을 설계했고, Broadcom은 실리콘 구현과 네트워킹을 맡았다. 즉 OpenAI가 architecture와 design authority를 쥐고, Broadcom이 implementation 파트너로 붙은 구조다. AI 랩들이 원하는 것은 팹도, 백엔드 구현 조직도 아니다. 무엇을 만들지를 정하는 권한, 즉 설계 주도권이다.
3. Anthropic — 팀을 만들었고, Claude에게 칩 설계를 가르친다
2026년 8월 5일, Anthropic은 Business Insider와 TechCrunch에 custom silicon 팀의 존재를 공식 인정했다. 목표는 명확하다. Claude와 하드웨어를 co-design해서 더 빠르고 싸게 돌리는 것. 그러면서도 "multi-chip 접근"은 유지한다.
채용 공고가 더 솔직하다. Silicon Engineer 포지션은 $320k~$485k 밴드로, "실리콘을 직접 출하해 본" 엔지니어를 찾는다. TPM 공고의 첫 문장은 이렇다. "Anthropic is building custom silicon for Claude." 그리고 "우리는 설계 주도권(design authority)을 직접 쥐기로 했다."
진짜 눈여겨볼 것은 따로 있다. "Research Engineer, Chip Design RL"라는 포지션이다. 이 팀은 Claude가 실리콘을 설계할 수 있도록 RL 환경과 evaluation을 만든다. 구체적으로 agentic RTL generation, design verification(formal 포함), physical design optimization을 위한 RL 환경·평가 지표의 발명과 구현을 다룬다. 공고는 "Hardware design is difficult and unforgiving – exactly the sort of domain we want Claude to excel at"라고 적었다.
연봉 밴드가 화제였다. Chip Design RL 포지션은 $500k~$850k, 실제 ASIC을 만드는 Silicon Engineer는 $320k~$485k라는 보도가 나왔다(Wccftech, 2026년 8월, 2차 보도). 같은 수준의 스킬셋을 요구하면서 칩을 '가르치는' 쪽이 '만드는' 쪽보다 최대 2배 가까이 받는 구조다. Anthropic이 어디에 베팅하는지가 숫자로 드러난 셈이다.
사람도 모으고 있다. 2026년 8월 24일, Google TPU 프로그램을 이끌며 7세대를 출하한 Amir Salek을 영입했다(Bloomberg 보도 기준).
4. 정정: xAI Macrohard는 칩이 아니다
많이 오해받는 지점이라 분명히 한다. Macrohard는 칩 프로그램이 아니다. 2025년 8월 22일 Musk가 X에 발표한 "순수 AI 소프트웨어 회사" 구상이다. 2026년 3월 11일, 로이터는 Macrohard가 Tesla와 xAI의 공동 프로젝트로 공개됐다고 보도했다. 그리고 이 시스템은 Tesla의 AI4 칩과 xAI의 NVIDIA 서버 위에서 돌아간다고 Musk가 밝혔다. 즉 Macrohard는 실리콘을 '소비'하는 쪽이지 '설계'하는 쪽이 아니다.
머스크 진영의 실리콘은 Tesla에 있다. AI4는 차량에 출하 중이고, AI5는 2026년 7월 tapeout을 마쳤다. AI6는 2026년 12월 tapeout을 목표로 한다. 제조는 Samsung Taylor 팹의 2nm다. 2025년 7월 체결된 $16.5B 파운드리 계약이 그 뒷받침이다. 더 큰 그림은 Terafab이다. 로이터(2026년 4월 17일)는 Tesla가 대만에서 엔지니어 9명을 채용 중이라고 보도했다. sub-7nm/2nm와 CoWoS/SoIC 경험을 요구하는 포지션이다.
5. SpaceX — 조용히 칩을 만드는 조직, 그리고 정보 공백
SpaceX에도 Silicon Engineering 조직이 있다. 채용 공고(2026년 현재 유효)를 보면 Sr. RFIC Engineer, Sr. ASIC Design Engineer 등을 뽑고 있다. Starlink 위성과 지상 인프라용 phased-array beamforming RFIC와 차세대 FPGA/ASIC을 설계한다. 2025년 9월 8일에는 EchoStar의 스펙트럼 라이선스를 약 $17B에 인수하기로 했다.
정직하게 말해야 할 것이 있다. SpaceX의 칩 설계 플로우 안에서 AI를 어떻게 쓰는지에 대한 공개 정보는 없다. 없다는 것이 안 쓴다는 증거는 아니지만, 이 글에서 주장할 수 있는 것도 아니다. 정보 공백은 공백으로 둔다.
6. "AI가 AI 칩을 설계한다" — 플라이휠이 돌기 시작했다
이 시리즈의 주제인 agentic EDA와 이 글의 주제가 만나는 지점이 여기다. AI 랩들은 칩을 만들면서, 동시에 AI로 칩을 설계하고 있다.
OpenAI가 먼저 증명했다. IEEE Spectrum(2026년 9월)의 보도에 따르면, Jalapeño의 프론트엔드 워크플로우는 Google의 오픈소스 HLS 툴체인인 XLS 위에 구축됐다. 엔지니어들은 Verilog를 직접 쓰지 않고 DSLX와 C++로 로직을 작성했고, XLS가 이를 Verilog로 변환했다. Richard Ho는 칩 설계를 위해 특별히 fine-tuning한 커스텀 LLM을 썼다고 밝혔다.
Anthropic은 한 걸음 더 나아간다. Chip Design RL 포지션이 그것이다. Claude가 RTL을 생성하고, verification을 돌리고, PD를 최적화하는 법을 배우도록 RL 환경 자체를 만드는 일이다. OpenAI가 자기 모델을 칩 설계 '도구'로 썼다면, Anthropic은 Claude를 칩 설계 '주체'로 키우겠다는 선언에 가깝다.
NVIDIA는 이 루프의 인프라를 판다. ChipNeMo(2023년)에 이어 2025~2026년의 행보는 NeMo Gym이다. 결정적 EDA 툴을 verifier로 쓰는 RL 인프라로, 오픈소스로 풀렸다. Siemens는 NeMo Gym과 Nemotron으로 Fuse EDA AI Agent를 'self-verifying'하게 만들었고, Synopsys는 AgentEngineer에, Cadence는 슈퍼 에이전트 라인에 NVIDIA 스택을 올렸다. EDA 업체들이 에이전트를 파는 동안, NVIDIA는 에이전트를 학습시키는 체육관을 파는 셈이다.
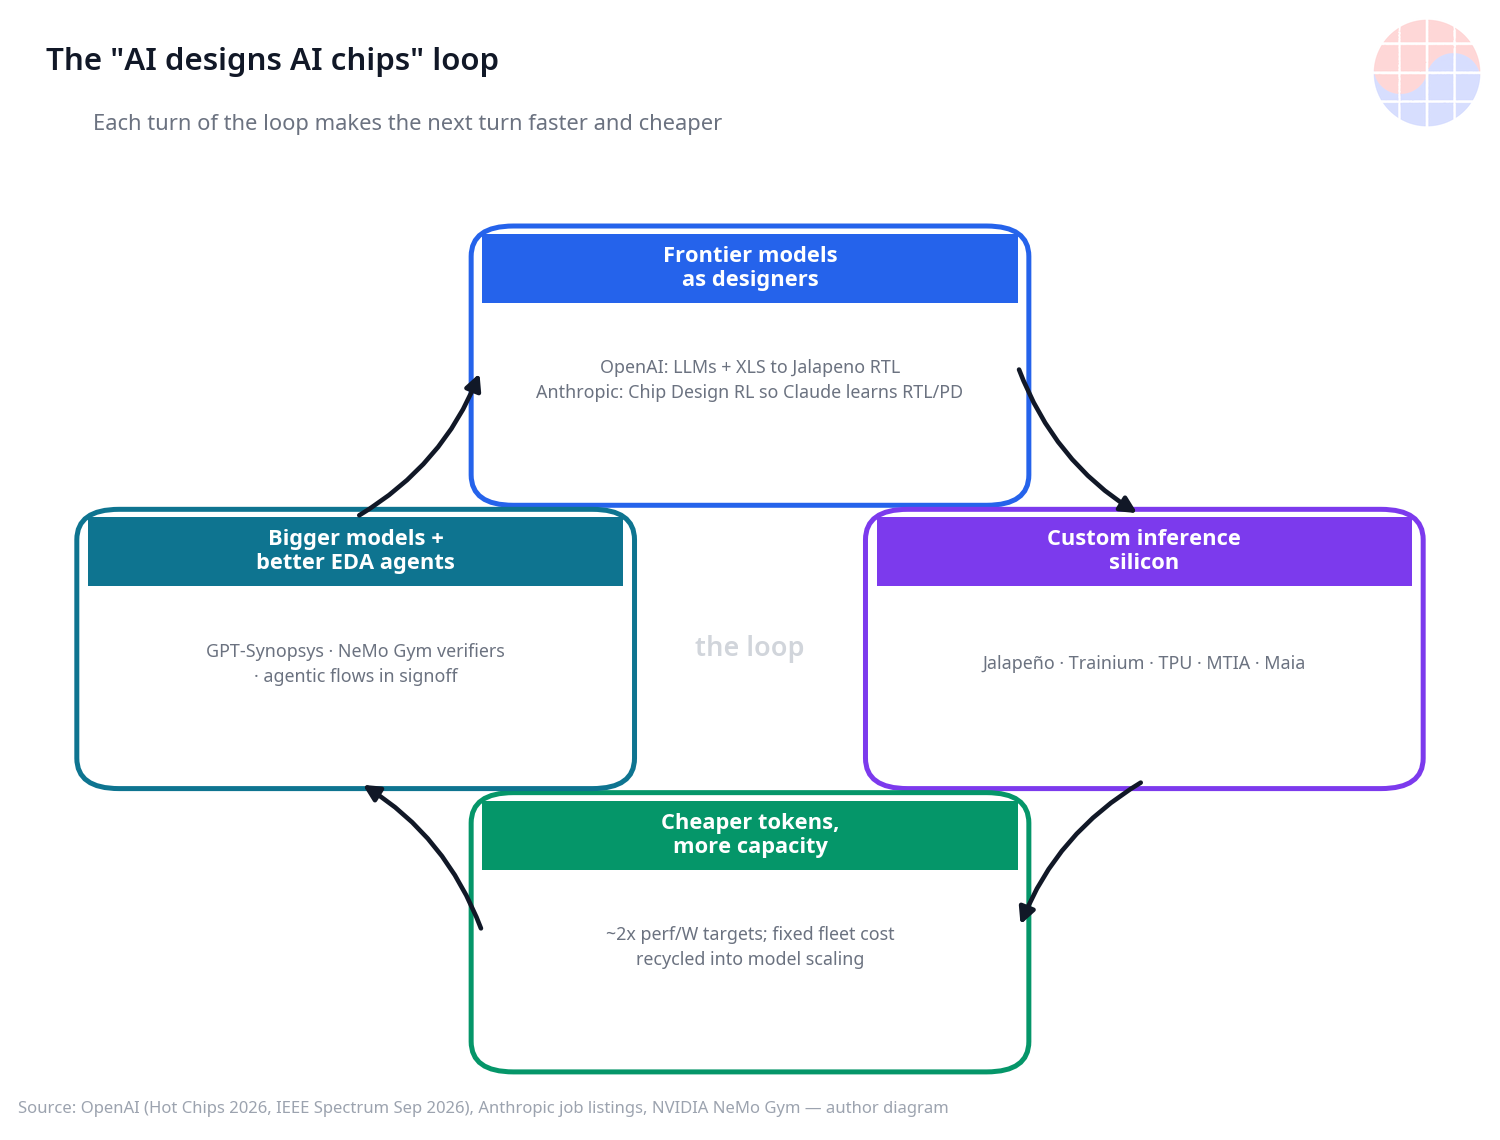
그림을 그려보자. Frontier 모델이 칩을 설계한다 → 커스텀 실리콘이 나온다 → inference가 싸지고 캐파가 늘어난다 → 아낀 돈과 늘어난 캐파로 더 큰 모델을 돌리고, 더 좋은 EDA 에이전트를 학습시킨다 → 다시 칩 설계로. 플라이휠이다. OpenAI는 이미 한 바퀴를 돌았고(Jalapeño → GPT-Synopsys 딜, 2026년 9월 30일), Anthropic은 두 번째 바퀴를 위한 엔진을 만들고 있으며, NVIDIA는 바퀴를 굴리는 바닥을 깔고 있다.
물론 한계도 명확하다. Synopsys CEO도 GPT-Synopsys 딜 발표 당시 "모델의 출력은 전통적인 signoff 툴로 double-check한다. signoff, 즉 ground truth가 필수"라고 말했다(로이터, 2026년 9월 30일). 산업 규모의 칩을 인간 개입 없이 완전히 자율적으로 tapeout한 검증된 사례는 아직 없다. 플라이휠은 돌고 있지만, 운전대 앞에는 여전히 사람이 앉아 있다.
7. 배경: Big Tech도 같은 게임 중이다
Google은 원조다. DeepMind의 AlphaChip은 RL로 칩 floorplan을 만드는 시스템으로, TPU 3세대의 레이아웃에 쓰였다. 다만 New Scientist(2024년 10월)는 외부 전문가들의 반론을 실었다. "인간보다 낫다"는 주장이 재현 가능하지 않다는 것이다.
Meta는 2026년 3월 11일 MTIA의 4개 신세대(300/400/450/500)를 한 번에 공개했다. MTIA 300은 이미 양산 중이고, Broadcom과 공동 설계하고 TSMC가 제조한다. 코드네임 Iris 칩이 2026년 9월 생산에 들어갔다는 보도도 있다.
Amazon의 Trainium 3, Microsoft의 Maia 200도 각자의 실리콘 로드맵을 달리고 있다.
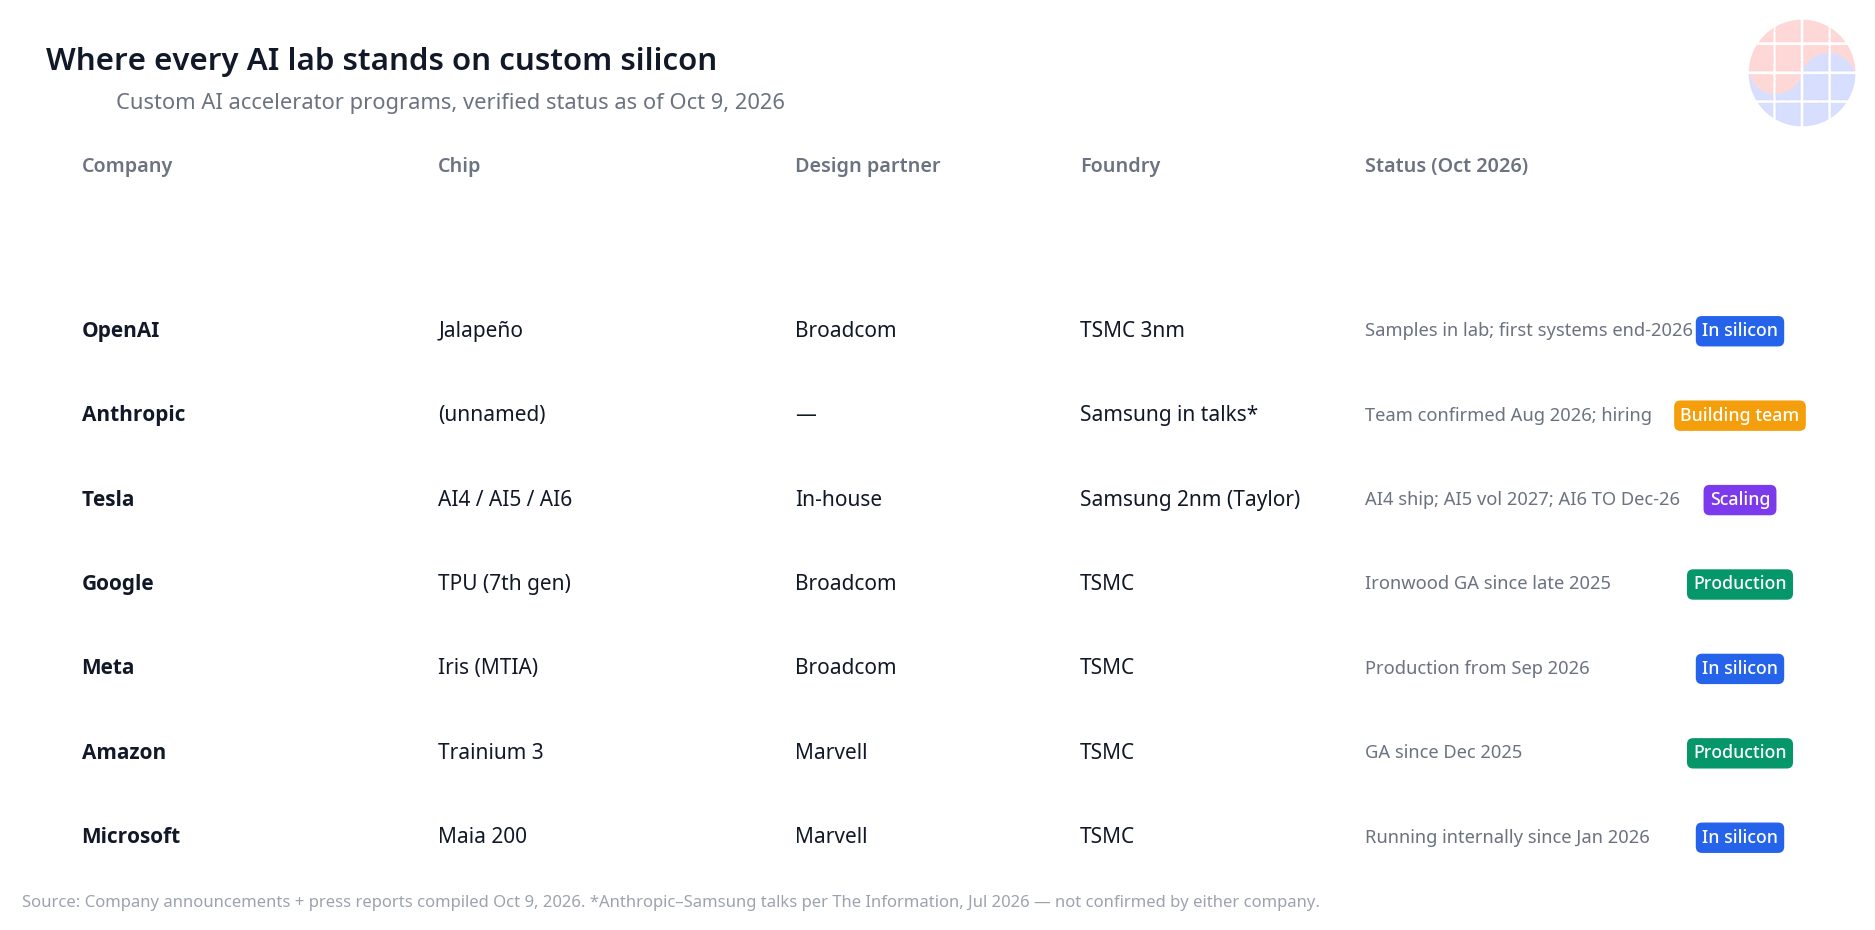
한 가지 패턴이 보인다. 설계 파트너가 Broadcom 아니면 Marvell로 수렴하고, 파운드리는 전부 TSMC다. NVIDIA 의존도를 낮추려는 레이스가, 역설적으로 TSMC 의존도를 높이고 있다. 어제의 EDA 고객이 반도체 회사였다면, 오늘의 EDA 고객은 AI 랩이다.
FAQ
Q1. OpenAI Jalapeño는 정말 NVIDIA GPU보다 빠른가요?
OpenAI가 2026년 8월 25일 Hot Chips에서 공개한 자체 측정 기준으로는 그렇다. 단, Jalapeño는 HBM4, 비교 대상은 HBM3e라 동일 세대 비교가 아니고, 독립 검증도 아직 없다.
Q2. Anthropic 칩은 언제 나오나요?
미정이다. 2026년 8월 5일 팀 존재를 공식 인정했고 채용 중이지만, tapeout 일정은 공개된 바 없다.
Q3. xAI도 AI 칩을 만드나요?
아니다. xAI의 'Macrohard'는 AI 소프트웨어 에이전트 프로젝트다. 머스크 진영의 칩 설계는 Tesla(AI4/AI5/AI6)에서 이뤄진다.
Q4. AI가 정말 칩을 설계할 수 있나요?
부분적으로는 이미 하고 있다. OpenAI는 Jalapeño의 프론트엔드를 LLM+XLS 워크플로우로 설계했고, Anthropic은 Claude에게 칩 설계를 가르치는 RL 환경을 구축 중이다. 다만 최종 signoff는 여전히 전통적인 EDA 툴과 인간 엔지니어가 담당한다.
Q5. 왜 AI 랩들은 NVIDIA를 떠나지 않으면서도 자체 칩을 만드나요?
탈(脫)NVIDIA가 목적이 아니라 협상력과 원가 구조가 목적이다. 자체 칩이 있으면 가격 협상에서 유리하고, inference 비용 구조를 직접 통제할 수 있다.
Sources
- Jalapeño 공개 (2026-06-24): https://lapaasvoice.com/openai-broadcom-unveil-jalapeno-custom-chip-built/
- Jalapeño 벤치마크 (Hot Chips 2026, 2026-08-25): https://www.igorslab.de/en/openai-jalapeno-beats-nvidia-gb200-gb300-in-initial-inference-benchmarks-up-to-36x-lower-latency/
- Jalapeño 설계 방법론 (IEEE Spectrum, 2026-09): https://spectrum.ieee.org/llms-for-chip-design
- Anthropic custom silicon 팀 확인 (TechCrunch, 2026-08-05): https://techcrunch.com/2026/08/05/anthropic-is-hiring-an-ai-chip-design-team/
- Anthropic 연봉 밴드 보도 (Wccftech, 2026-08, 2차): https://wccftech.com/anthropic-is-paying-nearly-a-million-dollars-per-year-to-the-engineers-teaching-its-ai-models-to-design-a-chip-but-just-320000-485000-to-those-actually-building-its-first-asic/
- Macrohard Tesla-xAI 공동 프로젝트 (Reuters, 2026-03-11): https://www.reuters.com/business/autos-transportation/musk-unveils-joint-tesla-xai-project-macrohard-eyes-software-disruption-2026-03-11/
- Samsung-Tesla $16.5B 파운드리 계약 (2025-07): https://www.datacenterdynamics.com/en/news/samsung-electronics-signs-165bn-deal-with-tesla-to-manufacture-ai6-chips-at-taylor-texas-fab/
- GPT-Synopsys 딜 (Reuters, 2026-09-30): https://www.lapost.com/content/synopsys-openai-strike-deal-to-develop-ai-model-for-chip-design-work
- NVIDIA NeMo Gym (오픈소스): https://github.com/NVIDIA-NeMo/Gym
- ChipNeMo 논문 (2023): https://arxiv.org/html/2311.00176v4
작성 기준일: 2026년 10월 9일. 모든 사실은 기준일 현재 확인 가능한 공개 정보를 바탕으로 하며, 벤더 주장과 2차 보도는 본문에 표기했다.
자주 묻는 질문
OpenAI Jalapeño는 어떤 칩이며 언제 공개됐나요?
Broadcom과 함께 만든 추론 전용 ASIC으로, 2026년 6월 24일 공개됐습니다. TSMC 3nm 공정에 systolic array 구조, HBM 스택 8개를 2.5D 인터포저에 올린 구성입니다.
Jalapeño의 Hot Chips 2026 발표 수치는 무엇인가요?
OpenAI 자체 측정 기준입니다. GPT-OSS 120B에서 NVIDIA GB200 대비 와트당 처리량 1.9배, DeepSeek R1 670B에서 GB300 대비 1.7배를 발표했습니다. Jalapeño는 700W, 비교 대상 GB300 시스템은 1,400W입니다.
AI 랩이 자체 칩을 만드는 이유는 무엇인가요?
추론 비용, 공급 협상력, 모델-하드웨어 co-design 세 가지입니다. 자체 칩은 NVIDIA 결별 선언이 아니라 가격과 공급 조건에 대한 협상 수단으로 함께 추진됩니다.
Anthropic의 자체 칩 추진 현황은 어떤가요?
2026년 8월 5일 custom silicon 팀의 존재를 공식 인정했습니다. Claude와 하드웨어를 co-design해 추론 비용을 낮추는 것이 목표이며, AWS·Google·NVIDIA·AMD를 함께 쓰는 multi-chip 접근은 유지합니다.
관련 글