 VLSI Korea
Phân tích chuyên sâu CPU NVIDIA Vera: vì sao băng thông bộ nhớ 1,2 TB/s quan trọng hơn 88 lõi
Vera mang lại 1,5 TB LPDDR5X SOCAMM2 và 1,2 TB/s mỗi socket, khoảng 13,6 GB/s mỗi lõi. So sánh đầy đủ với Grace và EPYC Turin, giới hạn tuyên bố của nhà cung cấp và cuộc đua SOCAMM2.


🆓 Bài viết miễn phí · Bất kỳ ai cũng có thể đọc miễn phí
Phân tích chuyên sâu CPU NVIDIA Vera: vì sao băng thông bộ nhớ 1,2 TB/s quan trọng hơn 88 lõi
TL;DR
- NVIDIA Vera là CPU trung tâm dữ liệu với 88 lõi Olympus tùy chỉnh tương thích Armv9.2-A, lần đầu ra mắt cùng nền tảng Vera Rubin tại GTC vào tháng 3 năm 2025, với chi tiết kiến trúc được công bố vào tháng 7 năm 2026 (công bố kiến trúc của NVIDIA, tháng 7 năm 2026).
- Con số chính không phải là số lõi. Mỗi socket Vera hỗ trợ tối đa 1,5 TB bộ nhớ LPDDR5X SOCAMM2 và tối đa 1,2 TB/s băng thông bộ nhớ, khoảng 13,6 GB/s mỗi lõi theo phép chia đơn giản (công bố kiến trúc của NVIDIA, tháng 7 năm 2026; tính toán từ số liệu đã công bố, 20 tháng 10 năm 2026).
- Băng thông mỗi lõi đó gấp khoảng 1,8 lần CPU Grace tiền nhiệm và khoảng 2,8 lần con số tính toán cho flagship AMD EPYC Turin 128 lõi dùng DDR5-6400 12 kênh (tính toán từ thông số của nhà cung cấp, 20 tháng 10 năm 2026).
- NVIDIA tuyên bố tối đa gấp 1,9 lần số lệnh mỗi chu kỳ so với EPYC Turin trong các workload liên quan đến AI, nhưng đó là tuyên bố của nhà cung cấp, và kết quả benchmark của đối tác đã công bố đến nay không tiết lộ cấu hình đầy đủ hay cài đặt TDP (công bố của NVIDIA, tháng 7 năm 2026).
- Thay đổi chiến lược là hàm lượng bộ nhớ mỗi socket: Vera mang gấp 3 lần dung lượng bộ nhớ của Grace mỗi socket, biến socket CPU thành đấu trường cạnh tranh nguồn cung LPDDR5X giữa Samsung Electronics, SK hynix và Micron (công bố kiến trúc của NVIDIA, tháng 7 năm 2026).
Background
Trong hai thập kỷ, marketing CPU trung tâm dữ liệu phần lớn là cuộc đua số lõi. Nhiều lõi hơn có nghĩa là nhiều máy ảo hơn, nhiều container hơn và nhiều luồng hơn mỗi rack. Logic đó hoạt động khi các workload đa dụng bị giới hạn chủ yếu bởi thông lượng tính toán. Nó hoạt động kém hơn trong kỷ nguyên AI dạng tác nhân, nơi CPU trong hệ thống AI không còn là host thụ động cho GPU. Nó điều phối các lần gọi công cụ, chuẩn bị và di chuyển dữ liệu, chạy các bước truy xuất và xếp hạng, xử lý lưu lượng mạng và lưu trữ, và cấp dữ liệu cho các bộ tăng tốc AI vốn dừng lại nhanh chóng khi dữ liệu đến trễ.
NVIDIA bước vào thị trường này với Grace, CPU 72 lõi dựa trên lõi Arm Neoverse V2, với tối đa 480 GB LPDDR5X và 546 GB/s băng thông bộ nhớ (thông số NVIDIA Grace, công bố trước công bố Vera tháng 7 năm 2026). Grace chứng minh một CPU Arm có thể đứng ở trung tâm của rack NVIDIA. Nó cũng phơi bày ràng buộc tiếp theo: khi hệ thống GPU nhanh hơn, CPU host cần dung lượng bộ nhớ lớn hơn, băng thông mỗi luồng lớn hơn và liên kết coherent nhanh hơn tới GPU.
Vera là câu trả lời của NVIDIA, ra mắt như một phần của nền tảng Vera Rubin tại GTC vào tháng 3 năm 2025 và được chi tiết hóa trong các công bố kiến trúc vào tháng 7 năm 2026 (GTC, tháng 3 năm 2025; công bố kiến trúc của NVIDIA, tháng 7 năm 2026). Vera thay thiết kế Neoverse được cấp phép bằng 88 lõi Olympus tùy chỉnh. NVIDIA báo cáo Spatial Multithreading exposing 176 luồng, một die tính toán nguyên khối, 2 MB cache L2 mỗi lõi, 164 MB cache L3 và Scalable Coherency Fabric thế hệ thứ hai (công bố kiến trúc của NVIDIA, tháng 7 năm 2026).
Các con số nền tảng quanh lõi cũng quan trọng không kém. Vera cung cấp NVLink-C2C ở 1,8 TB/s cho giao tiếp coherent CPU-GPU, PCIe Gen6 và CXL 3.1, với dải TDP có thể cấu hình từ 250 đến 450 W (công bố kiến trúc của NVIDIA, tháng 7 năm 2026). Hai CPU Vera tạo thành một Superchip với 176 lõi, 352 luồng, 16 mô-đun SOCAMM2, 2,4 TB/s băng thông bộ nhớ tổng hợp và 3 TB dung lượng bộ nhớ. Thiết kế tham chiếu quy mô rack với 128 Superchip đạt 22.528 lõi và 384 TB bộ nhớ (công bố kiến trúc của NVIDIA, tháng 7 năm 2026). Việc bán CPU độc lập và lô hàng khách hàng đầu tiên được báo cáo trong năm 2026, vì vậy các khẳng định về tính khả dụng trong bài viết này được nêu trên cơ sở báo cáo, không phải xác nhận giao hàng trực tiếp của NVIDIA (báo cáo ngành, 2026).
Deep Dive 1: Hệ thống bộ nhớ — 1,5 TB và 1,2 TB/s mỗi socket
Lựa chọn định nghĩa Vera là hệ thống bộ nhớ của nó. Mỗi socket hỗ trợ tối đa 1,5 TB LPDDR5X SOCAMM2 ở tốc độ tối đa 9.600 MT/s, mang lại tối đa 1,2 TB/s băng thông bộ nhớ (công bố kiến trúc của NVIDIA, tháng 7 năm 2026). SOCAMM2 là tiêu chuẩn mô-đun LPDDR dạng socket do NVIDIA thúc đẩy. Khác với LPDDR hàn cố định, mô-đun dạng socket có thể được cấu hình, bảo trì và mở rộng theo thiết kế hệ thống, đồng thời giữ ưu thế hiệu quả điện năng của LPDDR5X so với bộ nhớ máy chủ DDR5 thông thường.
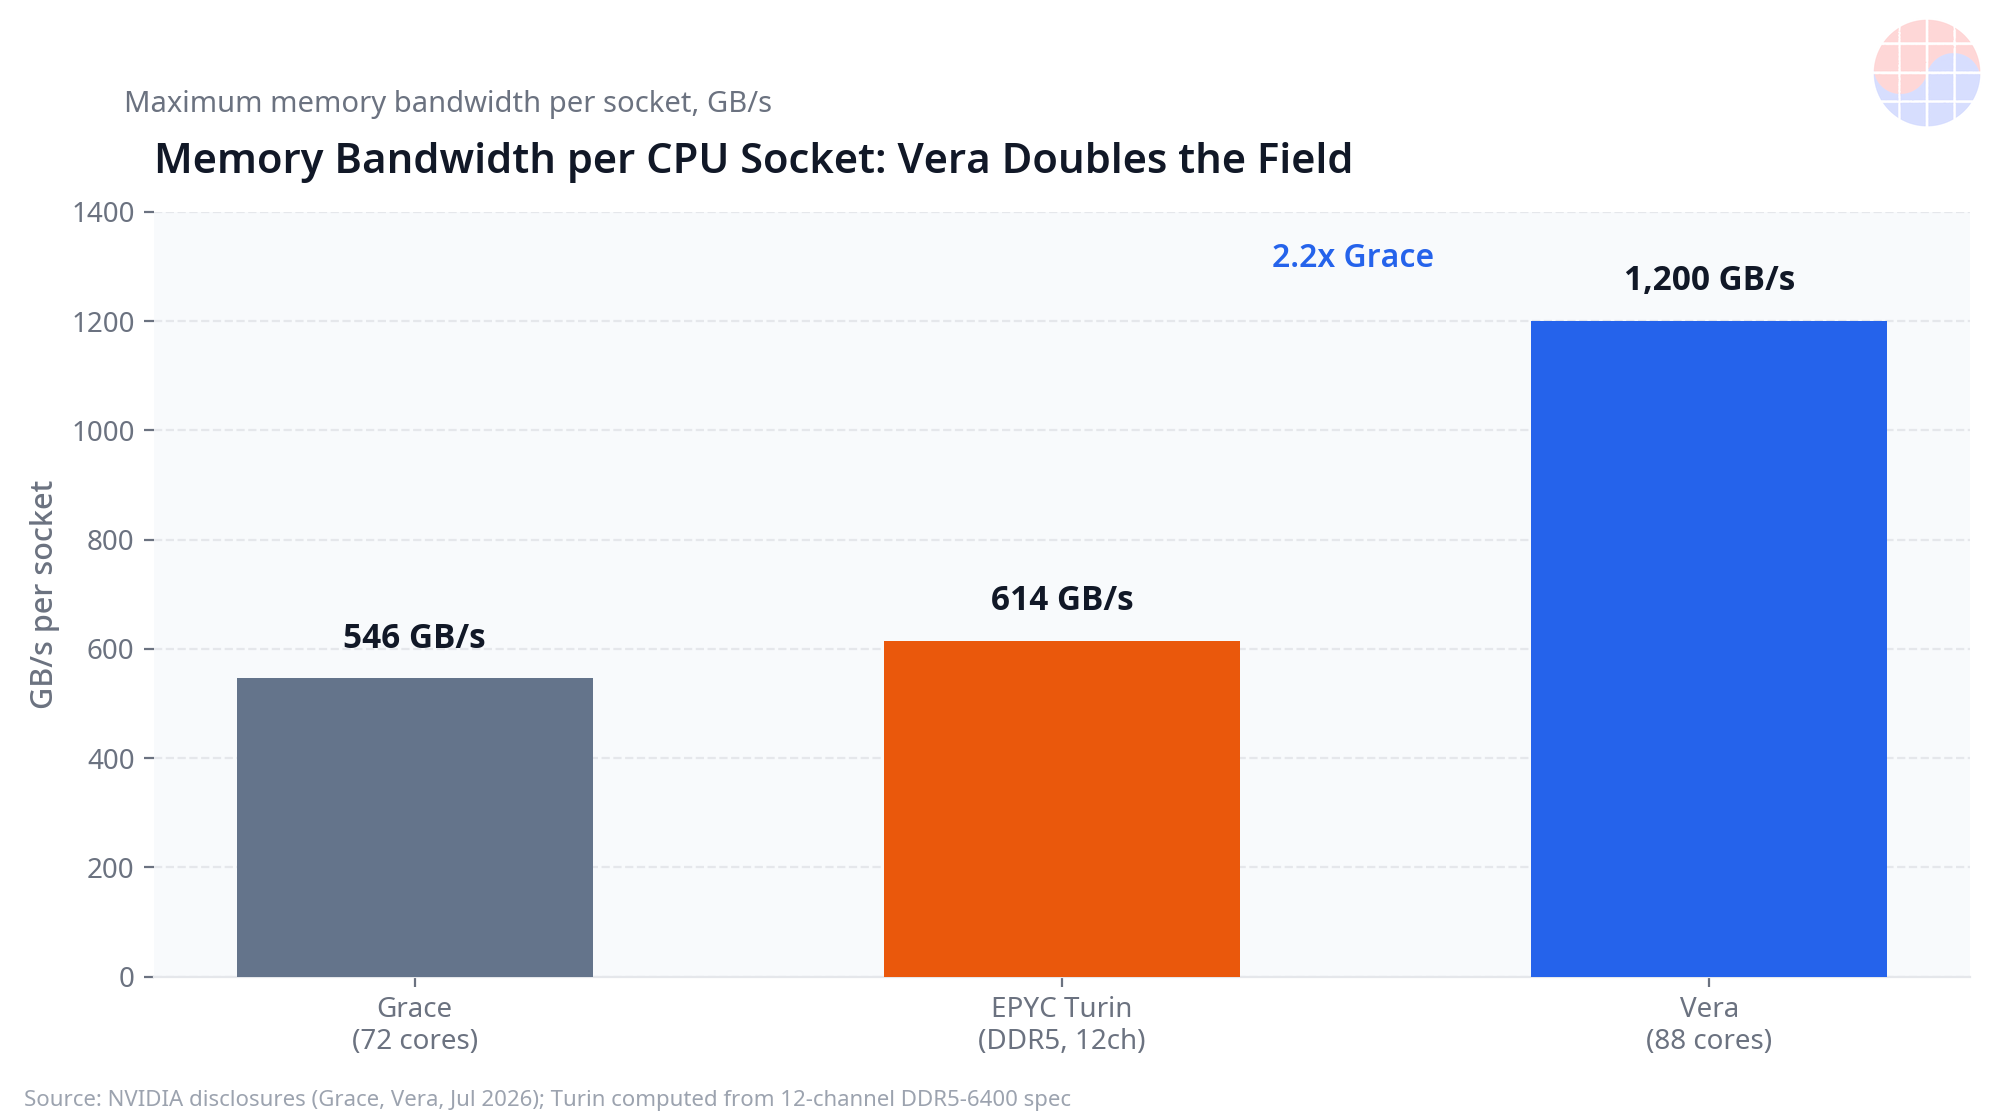
So sánh với Grace cho thấy thiết kế đã dịch chuyển bao xa trong một thế hệ. Grace cung cấp tối đa 480 GB LPDDR5X và 546 GB/s băng thông mỗi socket (thông số NVIDIA Grace). Vera gấp ba dung lượng lên 1,5 TB và nâng băng thông lên 1.200 GB/s, tăng 2,2 lần (công bố kiến trúc của NVIDIA, tháng 7 năm 2026; tính toán, 20 tháng 10 năm 2026). Về mặt thực tế, một socket Vera có thể giữ các working set lớn hơn trong bộ nhớ cục bộ: cache key-value lớn hơn, bảng embedding lớn hơn, nhiều phiên tác nhân đồng thời hơn và nhiều dữ liệu hơn được chuẩn bị cho GPU tiêu thụ mà không phải quay lại lưu trữ chậm hơn hay bộ nhớ từ xa.
Dung lượng và băng thông phải tăng cùng nhau. Dung lượng mà thiếu băng thông khiến các lõi phải chờ trên đường bộ nhớ tắc nghẽn. Băng thông mà thiếu dung lượng buộc phải eviction và refetch thường xuyên. Điểm thiết kế của Vera — 1,5 TB ở 1,2 TB/s — nhắm tới các workload nơi nhiều luồng chạm vào các tập dữ liệu lớn, thay đổi liên tục cùng lúc. Hồ sơ đó mô tả các pipeline truy xuất, feature serving, tiền xử lý tìm kiếm vector, tải dữ liệu và logic điều khiển quanh suy luận mô hình lớn tốt hơn nhiều so với benchmark số nguyên truyền thống.
Cũng có hệ quả chuỗi cung ứng. Tiêu chuẩn mô-đun LPDDR5X dạng socket tạo ra một đơn vị hàm lượng bộ nhớ xác định, có thể thay thế, mà các nhà xây dựng hệ thống mua với khối lượng lớn. Khi một socket mang 1,5 TB thay vì 480 GB, mỗi hệ thống Vera nhân lên hàm lượng LPDDR5X gắn với CPU, trước khi tính bất kỳ HBM nào gắn với GPU. Mục 4 quay lại ý nghĩa của điều này đối với Samsung Electronics, SK hynix và Micron.
Deep Dive 2: Băng thông mỗi lõi và so sánh x86
Số lõi gây hiểu lầm khi băng thông bộ nhớ không theo kịp. Chia băng thông socket cho số lõi cho một thước đo thô nhưng hữu ích về lượng thông lượng bộ nhớ mỗi lõi có thể kéo khi mọi lõi đều bận. Với Vera, 1.200 GB/s chia cho 88 lõi là khoảng 13,6 GB/s mỗi lõi, NVIDIA làm tròn thành khoảng 14 GB/s mỗi lõi (công bố kiến trúc của NVIDIA, tháng 7 năm 2026; tính toán, 20 tháng 10 năm 2026). Với Grace, 546 GB/s chia cho 72 lõi là khoảng 7,6 GB/s mỗi lõi.
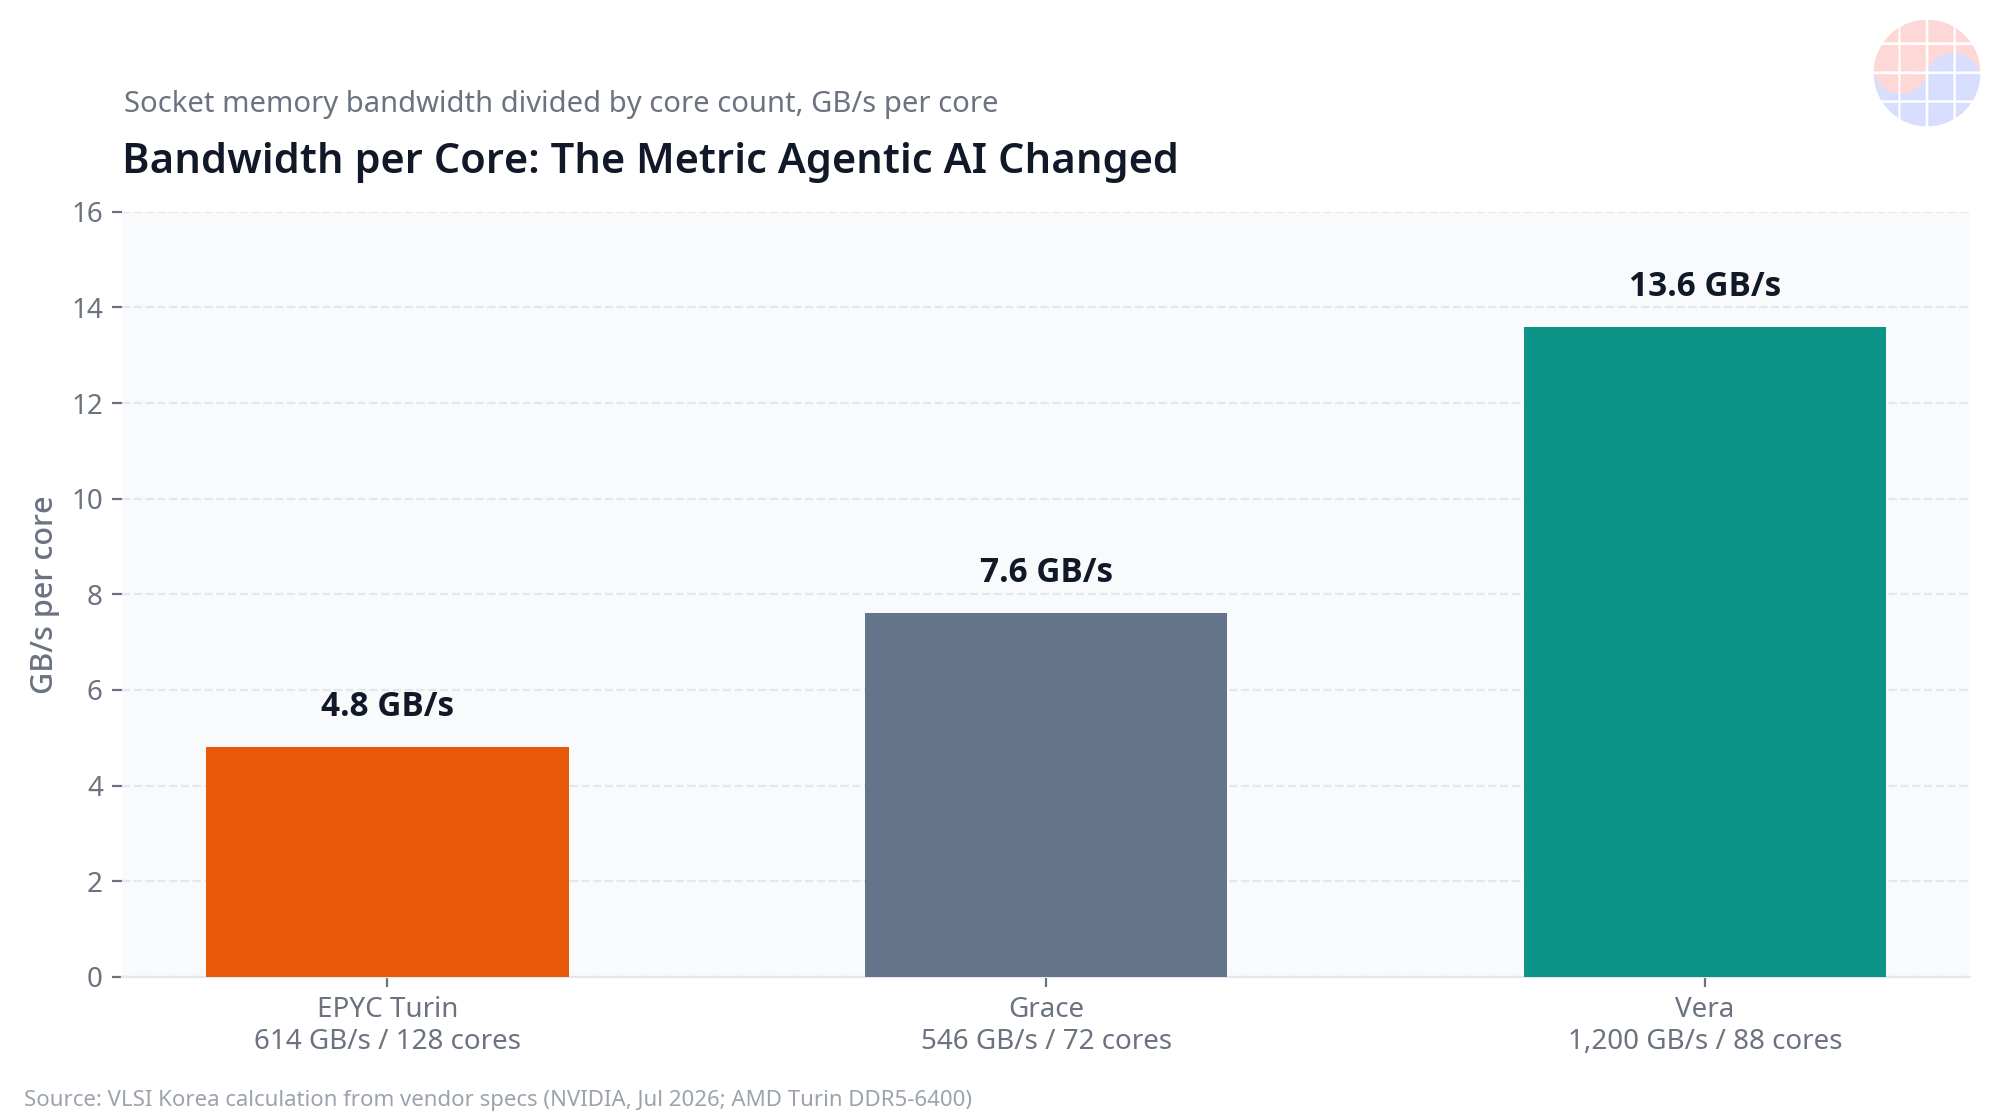
So sánh x86 cần một phương pháp minh bạch. Hệ thống AMD EPYC Turin với 12 kênh DDR5-6400 có đỉnh lý thuyết 614 GB/s, tính bằng 12 kênh nhân 6.400 MT/s nhân 8 byte mỗi lần truyền (tính toán từ thông số bộ nhớ AMD EPYC Turin, 20 tháng 10 năm 2026). Trải trên cấu hình flagship 128 lõi, đó là khoảng 4,8 GB/s mỗi lõi. Băng thông duy trì thực tế thấp hơn đỉnh lý thuyết ở mọi nền tảng trong so sánh này, vì vậy các con số nên được đọc như tỷ lệ dựa trên thông số, không phải kết quả ứng dụng đo được.
Trên cơ sở đó, Vera cung cấp khoảng 2,8 lần băng thông mỗi lõi của cấu hình Turin và khoảng 1,8 lần của Grace (tính toán, 20 tháng 10 năm 2026). Đây là phần mạnh nhất trong lập luận của NVIDIA. Các workload dạng tác nhân và nặng dữ liệu thường chạy nhiều luồng, mỗi luồng truyền, lọc hoặc biến đổi dữ liệu. Khi băng thông mỗi lõi thấp, thêm lõi ngừng giúp ích vì các lõi chia sẻ một đường ống bộ nhớ cố định. Khi băng thông mỗi lõi cao, khả năng mở rộng luồng kéo dài hơn.
NVIDIA cũng tuyên bố tối đa gấp 1,9 lần số lệnh mỗi chu kỳ so với EPYC Turin trong các workload liên quan đến AI (tuyên bố của nhà cung cấp, công bố của NVIDIA, tháng 7 năm 2026). Tuyên bố đó cần được xử lý cẩn thận. Số lệnh mỗi chu kỳ phụ thuộc nhiều vào workload, trình biên dịch và hỗn hợp lệnh, và lõi Arm tùy chỉnh cùng lõi x86 không thực thi các luồng lệnh giống hệt nhau. Tuyên bố báo hiệu ý đồ thiết kế của NVIDIA — lõi rộng hơn, hiệu quả hơn được cấp băng thông lớn hơn — nhưng không phải phép đo độc lập, và người mua nên chờ benchmark có thể tái tạo với cấu hình được tiết lộ trước khi dùng nó trong quyết định mua sắm.
Deep Dive 3: Lõi Olympus, tính coherent và Superchip
88 lõi Olympus của Vera là thiết kế tùy chỉnh tương thích Armv9.2-A, một bước tiến xa hơn lõi Neoverse V2 được cấp phép của Grace (công bố kiến trúc của NVIDIA, tháng 7 năm 2026). Sở hữu thiết kế lõi cho phép NVIDIA tinh chỉnh thông lượng vector, hành vi rẽ nhánh và hệ thống phân cấp cache cho các workload mà hệ thống rack của hãng thực sự chạy. Mỗi lõi mang 2 MB cache L2, và chip cung cấp 164 MB cache L3, những con số quan trọng vì cache lớn giảm tần suất luồng phải chờ bộ nhớ chính (công bố kiến trúc của NVIDIA, tháng 7 năm 2026).
Spatial Multithreading gấp đôi số luồng exposed lên 176 luồng mỗi socket (công bố kiến trúc của NVIDIA, tháng 7 năm 2026). Gấp đôi luồng chỉ có ích nếu hệ thống bộ nhớ có thể cấp dữ liệu cho các luồng thêm, đó là lý do con số 1,2 TB/s và số luồng nên được đọc như một quyết định thiết kế duy nhất, không phải hai thông số riêng biệt.
Tính coherent là trụ cột thứ hai. Scalable Coherency Fabric thế hệ thứ hai của Vera và NVLink-C2C ở 1,8 TB/s cho phép CPU và GPU chia sẻ dữ liệu một cách coherent ở tốc độ vượt xa liên kết PCIe thông thường (công bố kiến trúc của NVIDIA, tháng 7 năm 2026). Vera cũng hỗ trợ PCIe Gen6 và CXL 3.1, nên có thể gắn các bộ tăng tốc thông thường, bộ điều hợp mạng và thiết bị mở rộng bộ nhớ (công bố kiến trúc của NVIDIA, tháng 7 năm 2026). Trong rack AI, chia sẻ coherent giảm overhead sao chép tường minh: CPU có thể chuẩn bị cấu trúc dữ liệu mà GPU tiêu thụ trực tiếp, và kết quả trung gian có thể di chuyển với ít lần truyền do phần mềm quản lý hơn.
Cấu hình Superchip mở rộng cùng ý tưởng. Hai CPU Vera mang lại 176 lõi, 352 luồng, 2,4 TB/s băng thông bộ nhớ và 3 TB bộ nhớ trên 16 mô-đun SOCAMM2 (công bố kiến trúc của NVIDIA, tháng 7 năm 2026). Ở quy mô rack, tổng tham chiếu 22.528 lõi và 384 TB bộ nhớ trên 128 Superchip cho thấy NVIDIA thiết kế lớp CPU như hạ tầng gộp cho các đội tác nhân và pipeline dữ liệu, không phải người trông GPU tối thiểu (công bố kiến trúc của NVIDIA, tháng 7 năm 2026).
Công suất có thể cấu hình từ 250 W đến 450 W TDP (công bố kiến trúc của NVIDIA, tháng 7 năm 2026). Dải đó quan trọng để diễn giải bất kỳ benchmark nào: kết quả ở 450 W và kết quả ở 250 W mô tả các điểm vận hành khác nhau, và so sánh không nêu cài đặt là không đầy đủ.
Deep Dive 4: Các giới hạn trung thực — benchmark, phản ứng x86 và chi phí nguyên khối
Ba giới hạn đáng được chú ý trực tiếp. Thứ nhất, bằng chứng benchmark công khai còn mỏng. Kết quả của đối tác, bao gồm kết quả dữ liệu streaming gắn với Redpanda, được công bố mà không tiết lộ đầy đủ cấu hình và cài đặt TDP (công bố benchmark của đối tác, 2026). Thiếu số lõi tại thời điểm kiểm tra, cách bố trí bộ nhớ, firmware và cài đặt công suất, độc giả bên ngoài không thể tái tạo các con số hay đánh giá so sánh có công bằng hay không. Tuyên bố tối đa gấp 1,9 lần IPC của NVIDIA có cùng vị thế: đó là tuyên bố của nhà cung cấp cho đến khi kiểm tra độc lập với phương pháp được tiết lộ xác nhận nó (công bố của NVIDIA, tháng 7 năm 2026).
Thứ hai, các nhà cung cấp x86 không đứng yên. Nền tảng máy chủ đang tiến tới DDR5 nhanh hơn, bộ nhớ MRDIMM nâng băng thông hiệu dụng mỗi kênh, và các thế hệ mới với nhiều kênh bộ nhớ hơn. MRDIMM và nền tảng x86 thế hệ tiếp theo sẽ thu hẹp khoảng cách băng thông mỗi lõi từ đường cơ sở thông số 614 GB/s dùng ở trên, đặc biệt trong các cấu hình đánh đổi số lõi lấy băng thông. Lợi thế của Vera là có thật trên các thông số được công bố tính đến 20 tháng 10 năm 2026, nhưng đó là lợi thế tại một thời điểm, không phải khoảng cách cấu trúc vĩnh viễn.
Thứ ba, die tính toán nguyên khối của Vera có hồ sơ chi phí. Một die nguyên khối lớn thường đối mặt với kinh tế tỷ lệ đạt (yield) khó hơn thiết kế chiplet vốn chỉ bỏ một die nhỏ lỗi và tái sử dụng các die tốt đã biết trên nhiều sản phẩm (nguyên lý sản xuất chất bán dẫn chung, nêu ngày 20 tháng 10 năm 2026). NVIDIA chưa công bố số liệu tỷ lệ đạt (yield) hay chi phí đơn vị của Vera, vì vậy không có khẳng định chi phí cụ thể nào được đưa ra ở đây. Điểm này mang tính định hướng: lựa chọn thiết kế giúp độ trễ và tính coherent cũng tập trung rủi ro sản xuất, và giá sẽ phản ánh điều đó.
Cuối cùng, phần mềm quyết định bao nhiêu lợi thế phần cứng sống sót khi chạm vào sản xuất. Độ trưởng thành của hệ sinh thái Arm trong công cụ doanh nghiệp, khả năng quan sát và middleware kế thừa đã cải thiện, nhưng nỗ lực di chuyển vẫn là chi phí thực đối với các nhà vận hành có tài sản x86 lớn. Băng thông thắng benchmark; tổng chi phí sở hữu thắng đơn đặt hàng.
Chase's Take
Thay đổi quan trọng không phải là NVIDIA đã xây dựng một CPU với 88 lõi. Thay đổi quan trọng là nút thắt đã di chuyển đi đâu. Trong hệ thống AI dạng tác nhân, CPU xử lý điều phối: vòng lặp lập kế hoạch, gọi công cụ, truy xuất, quản lý bộ nhớ cho ngữ cảnh dài và di chuyển dữ liệu giữa lưu trữ, mạng và GPU. Những tác vụ đó giàu luồng và đói bộ nhớ. Tài nguyên giới hạn của chúng thường không phải thông lượng dấu phẩy động đỉnh. Đó là mỗi luồng có thể chạm tới bao nhiêu dữ liệu, nhanh đến mức nào, mà không phải xếp hàng sau mọi luồng khác. Vera được thiết kế quanh thực tế đó — băng thông mỗi lõi và dung lượng bộ nhớ mỗi socket trước, số lõi sau.
Từ góc độ kinh doanh, SOCAMM2 có thể quan trọng hơn cả lõi Olympus. Bằng cách định nghĩa mô-đun LPDDR5X dạng socket cho socket CPU, NVIDIA biến bộ nhớ host thành một khe hàm lượng tiêu chuẩn, khối lượng lớn. Vera mang 1,5 TB mỗi socket so với 480 GB của Grace, gấp ba hàm lượng bộ nhớ mỗi socket (công bố kiến trúc của NVIDIA, tháng 7 năm 2026). Mỗi rack áp dụng Vera do đó kéo nhiều LPDDR5X hơn hẳn qua chuỗi cung ứng.
Điều đó biến socket CPU thành đấu trường hàm lượng bộ nhớ. Samsung Electronics, SK hynix và Micron đều cạnh tranh trong nguồn cung LPDDR5X, và việc đạt chuẩn cho một nền tảng NVIDIA khối lượng lớn có giá trị hơn một chiến thắng thiết kế đơn lẻ: nó neo giữ khối lượng, quyền lực định giá và vị thế trong lần sửa đổi mô-đun tiếp theo. Các nhà cung cấp Hàn Quốc có lợi ích đặc biệt ở đây, vì vị thế dẫn đầu LPDDR trong lịch sử là thế mạnh của Hàn Quốc, và SOCAMM2 cho thế mạnh đó một lối ra máy chủ mới ngoài điện thoại thông minh. Câu chuyện Vera, đọc từ Seoul, một phần là câu chuyện CPU và một phần là câu chuyện về ai bán bộ nhớ bao quanh CPU.
Đánh giá của tôi: hãy đánh giá Vera bằng băng thông mỗi lõi được mang lại trong các workload tác nhân sản xuất thực, không phải bằng tiêu đề 88 lõi và không phải bằng cài đặt benchmark không được tiết lộ. Nếu kiểm tra độc lập xác nhận dù chỉ phần lớn lợi thế thông số, áp lực lên lộ trình x86 — nhiều kênh hơn, áp dụng MRDIMM, ít lõi hơn mỗi tầng băng thông — sẽ là dấu hiệu rõ nhất rằng Vera đã thay đổi thị trường.
Implications
- Đối với người mua hệ thống AI: Đánh giá Vera theo băng thông mỗi lõi và dung lượng bộ nhớ mỗi socket cho các workload tác nhân, truy xuất và tải dữ liệu của riêng bạn, và yêu cầu TDP cùng cấu hình bộ nhớ được tiết lộ trong mọi benchmark của nhà cung cấp (cơ sở: công bố kiến trúc của NVIDIA, tháng 7 năm 2026).
- Đối với hoạch định nền tảng x86: Khoảng cách thông số — khoảng 13,6 GB/s mỗi lõi cho Vera so với khoảng 4,8 GB/s mỗi lõi cho cấu hình Turin 128 lõi dùng DDR5-6400 — biến MRDIMM và thiết kế nhiều kênh hơn thành ưu tiên lộ trình, không phải lựa chọn (tính toán, 20 tháng 10 năm 2026).
- Đối với nhà cung cấp bộ nhớ: SOCAMM2 nâng hàm lượng LPDDR5X phía CPU lên 1,5 TB mỗi socket, gấp ba Grace, vì vậy Samsung Electronics, SK hynix và Micron cạnh tranh cho một socket lớn hơn và chiến lược hơn (công bố kiến trúc của NVIDIA, tháng 7 năm 2026).
- Đối với nhà vận hành: Chi phí di chuyển, mức phù hợp hệ sinh thái phần mềm và giá die nguyên khối có thể bù một phần lợi thế phần cứng; kiểm tra tổng chi phí sở hữu quan trọng hơn tuyên bố IPC tiêu đề.
- Đối với thị trường CPU: Nếu workload dạng tác nhân tiếp tục tăng, băng thông mỗi lõi trở thành tiêu chí mua hàng bậc nhất bên cạnh số lõi, và marketing CPU chỉ dẫn đầu bằng số lõi sẽ nhanh chóng lỗi thời.
Bài viết này dựa trên các công bố của NVIDIA tháng 3 năm 2025 và tháng 7 năm 2026 và các tính toán thông số ngày 20 tháng 10 năm 2026; các tuyên bố hiệu năng của nhà cung cấp được ghi nhãn như vậy và chưa được kiểm chứng độc lập.
FAQ
Q1. CPU NVIDIA Vera là gì và được công bố khi nào? Vera là CPU trung tâm dữ liệu của NVIDIA với 88 lõi Olympus tùy chỉnh tương thích Armv9.2-A và 176 luồng qua Spatial Multithreading. Nó ra mắt cùng nền tảng Vera Rubin tại GTC vào tháng 3 năm 2025, và NVIDIA công bố chi tiết kiến trúc vào tháng 7 năm 2026.
Q2. Vera cung cấp bao nhiêu băng thông và dung lượng bộ nhớ mỗi socket? Mỗi socket Vera hỗ trợ tối đa 1,5 TB LPDDR5X SOCAMM2 ở tối đa 9.600 MT/s và tối đa 1,2 TB/s băng thông bộ nhớ, tương đương khoảng 13,6 GB/s mỗi lõi trên 88 lõi (công bố kiến trúc của NVIDIA, tháng 7 năm 2026).
Q3. Vera so với Grace và AMD EPYC Turin về băng thông mỗi lõi như thế nào? Grace cung cấp 546 GB/s trên 72 lõi, khoảng 7,6 GB/s mỗi lõi. Cấu hình EPYC Turin 128 lõi với DDR5-6400 12 kênh có lý thuyết 614 GB/s, khoảng 4,8 GB/s mỗi lõi. Khoảng 13,6 GB/s mỗi lõi của Vera gấp khoảng 1,8 lần Grace và khoảng 2,8 lần cấu hình Turin đó, trên cơ sở thông số (tính toán, 20 tháng 10 năm 2026).
Q4. Các giới hạn chính và câu hỏi mở của Vera là gì? Tuyên bố tối đa gấp 1,9 lần IPC so với Turin của NVIDIA là tuyên bố của nhà cung cấp, benchmark của đối tác như kết quả Redpanda không tiết lộ cấu hình đầy đủ hay cài đặt TDP, nền tảng x86 đang phản ứng bằng MRDIMM và thiết kế bộ nhớ thế hệ tiếp theo, và die nguyên khối của Vera có thể có chi phí sản xuất cao hơn các lựa chọn chiplet. Benchmark độc lập với phương pháp được tiết lộ vẫn cần thiết (trạng thái tính đến 20 tháng 10 năm 2026).
📩 Đăng ký bản tin VLSI Korea
Nhận phân tích bán dẫn chuyên sâu mỗi ngày qua email trước tiên. Đăng ký miễn phí.
Bài viết liên quan
- Nhà máy AI trong 14 ngày, không phải 6 tháng: Vera Rubin vào sản xuất…
- Cược Substrat của NVIDIA: Công Suất 2,5x, Tạm Ứng Kiểm Thử USD 1,1 Tỷ…
- Các hãng công nghệ lớn của Trung Quốc đặt mua chip Nvidia trị giá 35 tỷ…
- Toán học sản xuất Vera Rubin: 576 stack HBM4 trong mỗi rack, 300.000…
- Hai phần ba thị trường bán dẫn thuộc về 10 công ty (NVIDIA, bộ nhớ)


