 VLSI Korea
AI 設計 AI 晶片:OpenAI、Anthropic、Tesla 投入矽的真正理由
截至 2026 年 10 月,所有 frontier AI 實驗室都成了晶片公司。OpenAI 以 LLM 設計 Jalapeño,Anthropic 把 Claude 培養成晶片設計者,Tesla 的 AI6 以 2026 年 12 月 tapeout 為目標。投入矽的理由是推論成本、談判力與 co-design。


🆓 免費文章 · 任何人都可以免費閱讀
TL;DR — 截至 2026 年 10 月,所有 frontier AI 實驗室都成了晶片公司。OpenAI 在 2026 年 6 月與 Broadcom 一起公開第一顆推論晶片 Jalapeño,8 月 Hot Chips 發表了比 NVIDIA GB200/GB300 高 1.5~1.9 倍的每瓦處理量與低 1.7~3.6 倍的 latency(OpenAI 自行測量)。Anthropic 在 2026 年 8 月正式承認 custom silicon 團隊,另外招募教 Claude 做 RTL 生成、verification、PD 最佳化的 RL 環境研究員。xAI 的「Macrohard」不是晶片,而是軟體代理公司,Musk 陣營的矽在 Tesla(AI4 出貨中、AI5 量產驗證、AI6 以 2026 年 12 月 tapeout 為目標)。他們做晶片的理由有三個 — 推論成本、供應談判力、模型-硬體 co-design。而本文的核心是這個:OpenAI 用自己的 LLM 設計了 Jalapeño(IEEE Spectrum, 2026 年 9 月),Anthropic 正在把 Claude 培養成晶片設計者,NVIDIA 以名為 NeMo Gym 的 RL 基礎設施餵養 EDA 業者的代理。「AI 設計 AI 晶片」的飛輪已經開始轉動。
1. 為何現在 AI 實驗室做晶片
問題不是「能不能做」,而是「為何親自做」。答案收斂為三個。
第一,推論成本。訓練是一次,推論卻永遠在跑。模型變大、agent 工作負載增加,每 token 成本就成為事業的損益兩平點。OpenAI 在公開 Jalapeño 當時(2026 年 6 月)表示要把每 token 推論成本比 NVIDIA GPU 降低約 50%(供應商主張,技術報告未公開),Anthropic 把以晶片-模型 co-design 大幅降低推論成本當成團隊的明示目標(依媒體報導)。
第二,供應與談判力。若被一個供應商掐住脖子,價格由供應商決定。所以大家一邊說「multi-chip 做法」,一邊同時做自家晶片。重要的是,沒有人宣布與 NVIDIA 決裂。OpenAI 訓練用持續使用 NVIDIA,Anthropic 維持 AWS、Google、NVIDIA、AMD 四家供應商。自家晶片不是脫離 NVIDIA 的宣言,而是對價目表的談判牌。
第三,模型-硬體 co-design。通用 GPU 必須跑所有工作負載,低效率是結構性的。若依自己模型的 attention 模式、decode 特性、記憶體存取模式削矽,同樣的瓦數能出更多 token。Jalapeño 正是這個賭注。
也需要指出為何偏偏是 2026 年。2024~2025 年的晶片故事是訓練用。但進入 2026 年,agent 工作負載爆發。代理對一個問題會引發數十次模型呼叫。訓練成本是固定費,推論是變動費,使用量愈增,每 token 原價愈支配整個事業。所以做晶片的主體從超大規模業者下放到 AI 實驗室。
2. OpenAI Jalapeño — AI 實驗室的第一顆矽
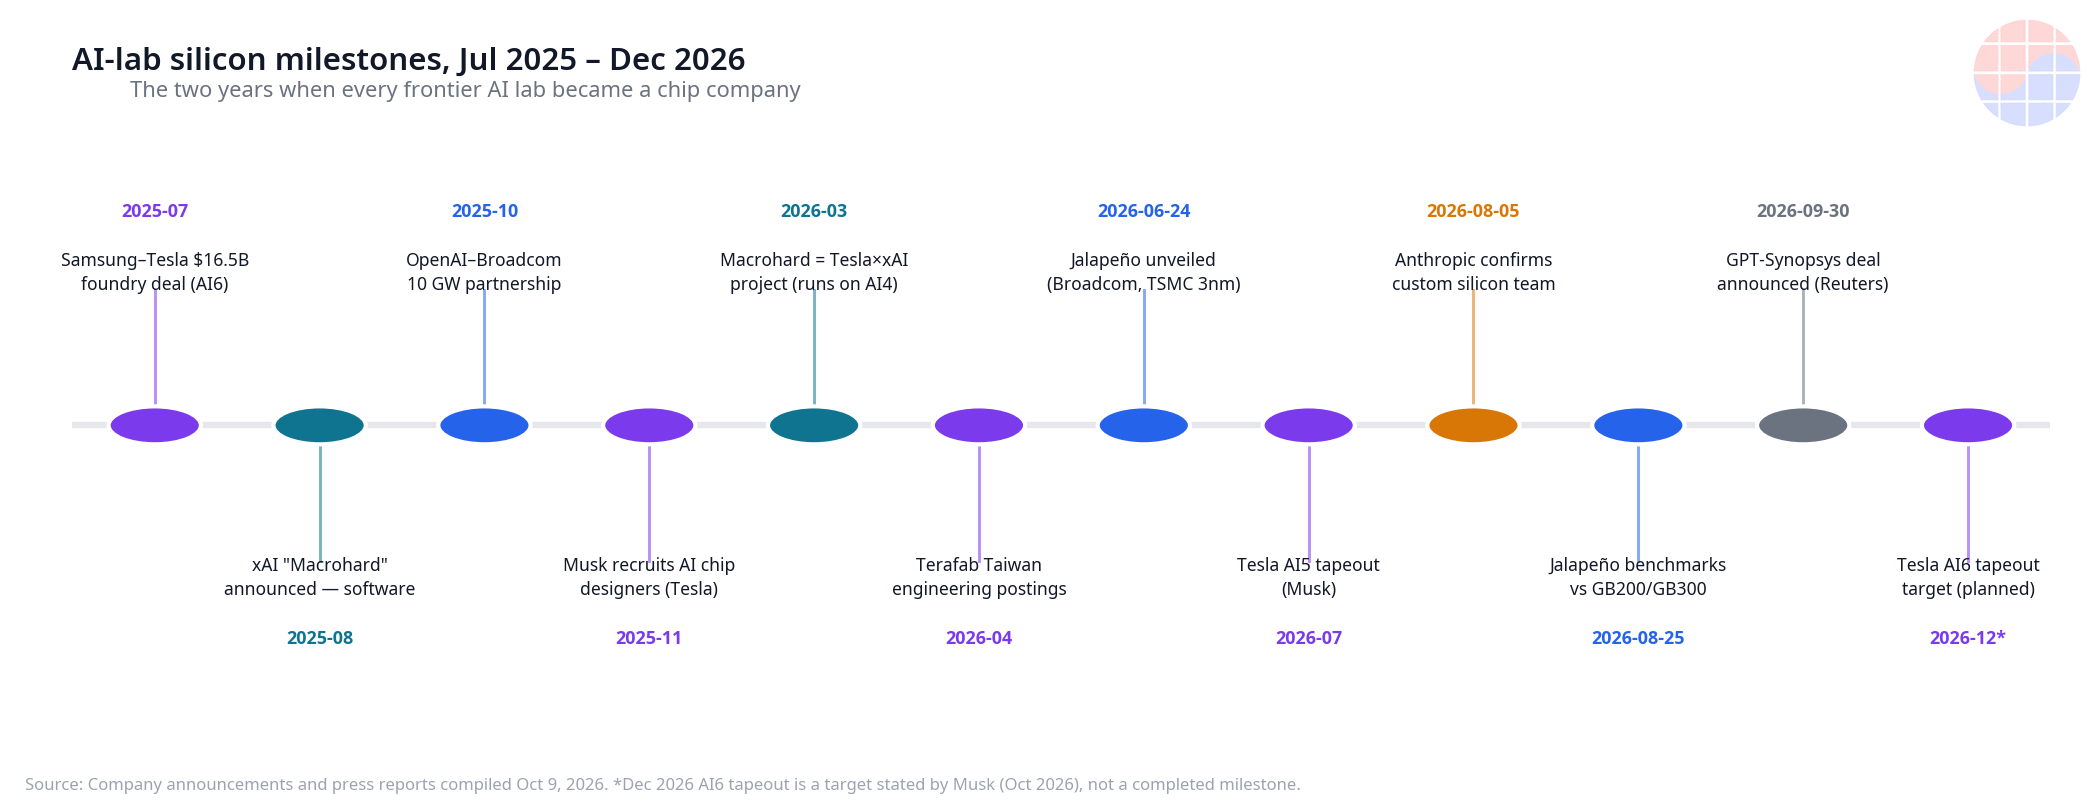
2026 年 6 月 24 日,OpenAI 與 Broadcom 公開 Jalapeño。它是 TSMC 3nm 製程的推論專用 ASIC,systolic array 架構,在 2.5D 中介層上放 8 個 HBM 堆疊的結構。Broadcom 負責矽實現與 Tomahawk 網路,Celestica 負責主機板與機櫃整合。
看數字。公開當時 OpenAI 主張每 token 推論成本比現行 GPU 低約 50%。但支撐這一點的技術報告沒有出來,這個主張至今仍未驗證。改變局面的是 2026 年 8 月 25 日 Hot Chips 2026。OpenAI 發表了以 SemiAnalysis 的公開 benchmark InferenceX 測量的結果。GPT-OSS 120B 對 NVIDIA GB200,每瓦峰值處理量 1.9 倍,end-to-end latency 從 1.80 秒到 1.03 秒。DeepSeek R1 670B 對 GB300 是 1.7 倍,latency 從 5.99 秒到 1.65 秒。Jalapeño 是 700W,比較對象 GB300 系統是 1,400W。意思是它以一半電力做了更多工作。
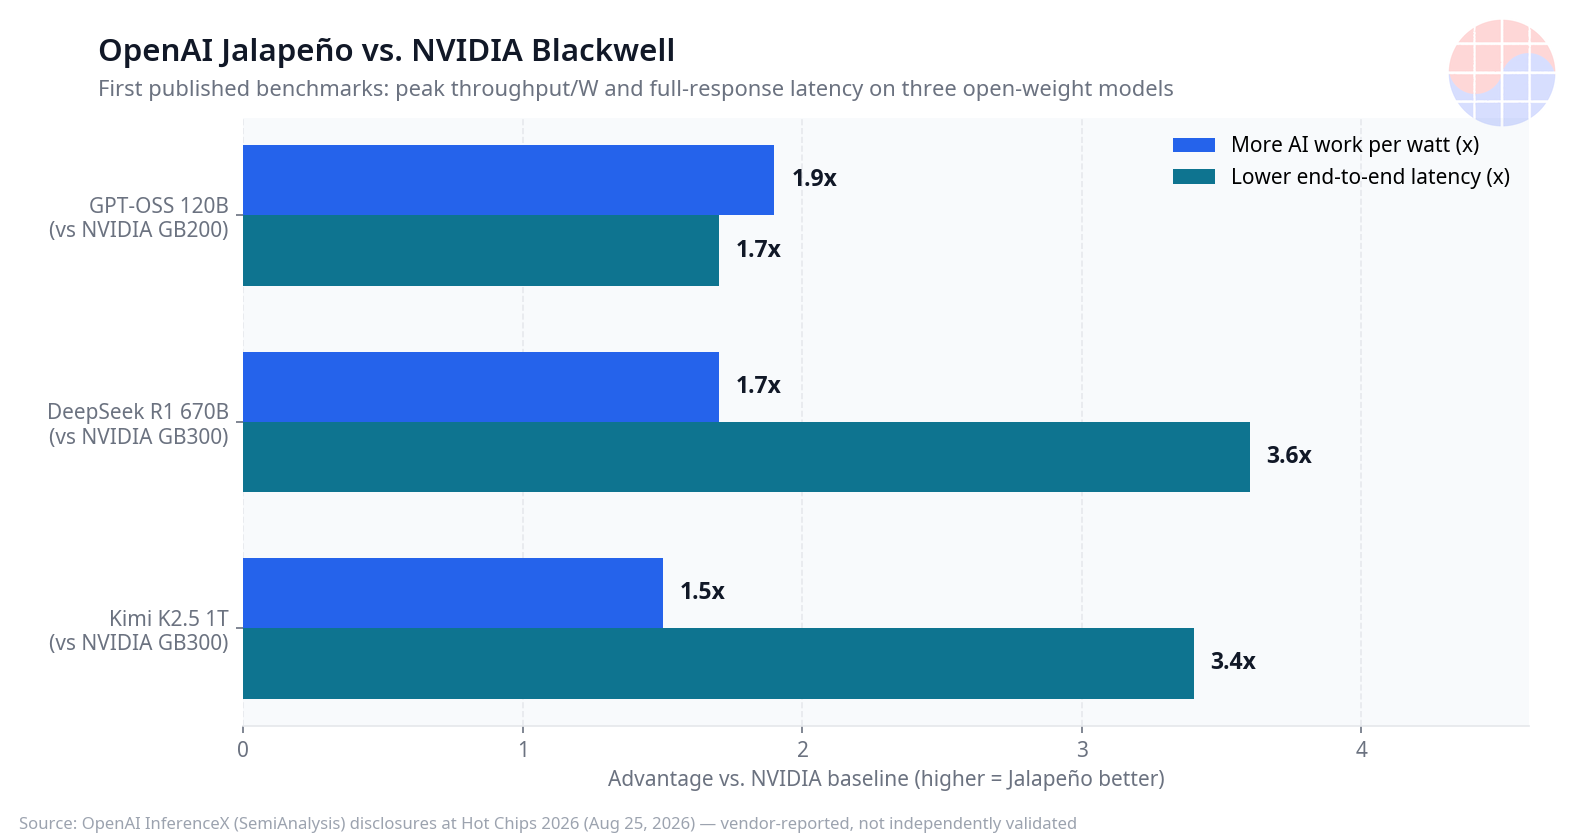
當然有陷阱。Jalapeño 用 HBM4,比較對象 GB200/GB300 是 HBM3e。左右推論效能的記憶體頻寬世代不同,嚴格來說不是同世代比較。而且所有數字都是 OpenAI 自行測量。在獨立 benchmark 出來之前,以「暫定」來讀才正確。
團隊故事也有趣。帶領硬體的是 Richard Ho(OpenAI 硬體 VP,前 Google TPU)。依 2025 年 2 月 Reuters 報導,當時團隊約 40 人。依 2026 年 Hot Chips 時點的二次報導,以平均不到 100 人的編制運作。不到 100 人的團隊在 9 個月(從 first-RTL 到 tapeout)內做出了高性能 ASIC。Engineering sample 在內部跑 GPT-5.3 Codex 工作負載,Microsoft 決定拿首批量的 40%(依二次報導)。
在這裡必須準確劃分角色。依二次報導,OpenAI 設計了晶片,Broadcom 負責矽實現與網路。也就是 OpenAI 掌握 architecture 與 design authority,Broadcom 以 implementation 夥伴加入的結構。AI 實驗室想要的不是晶圓廠,也不是後端實現組織。是決定做什麼的權限,也就是設計主導權。
3. Anthropic — 組了團隊,教 Claude 做晶片設計
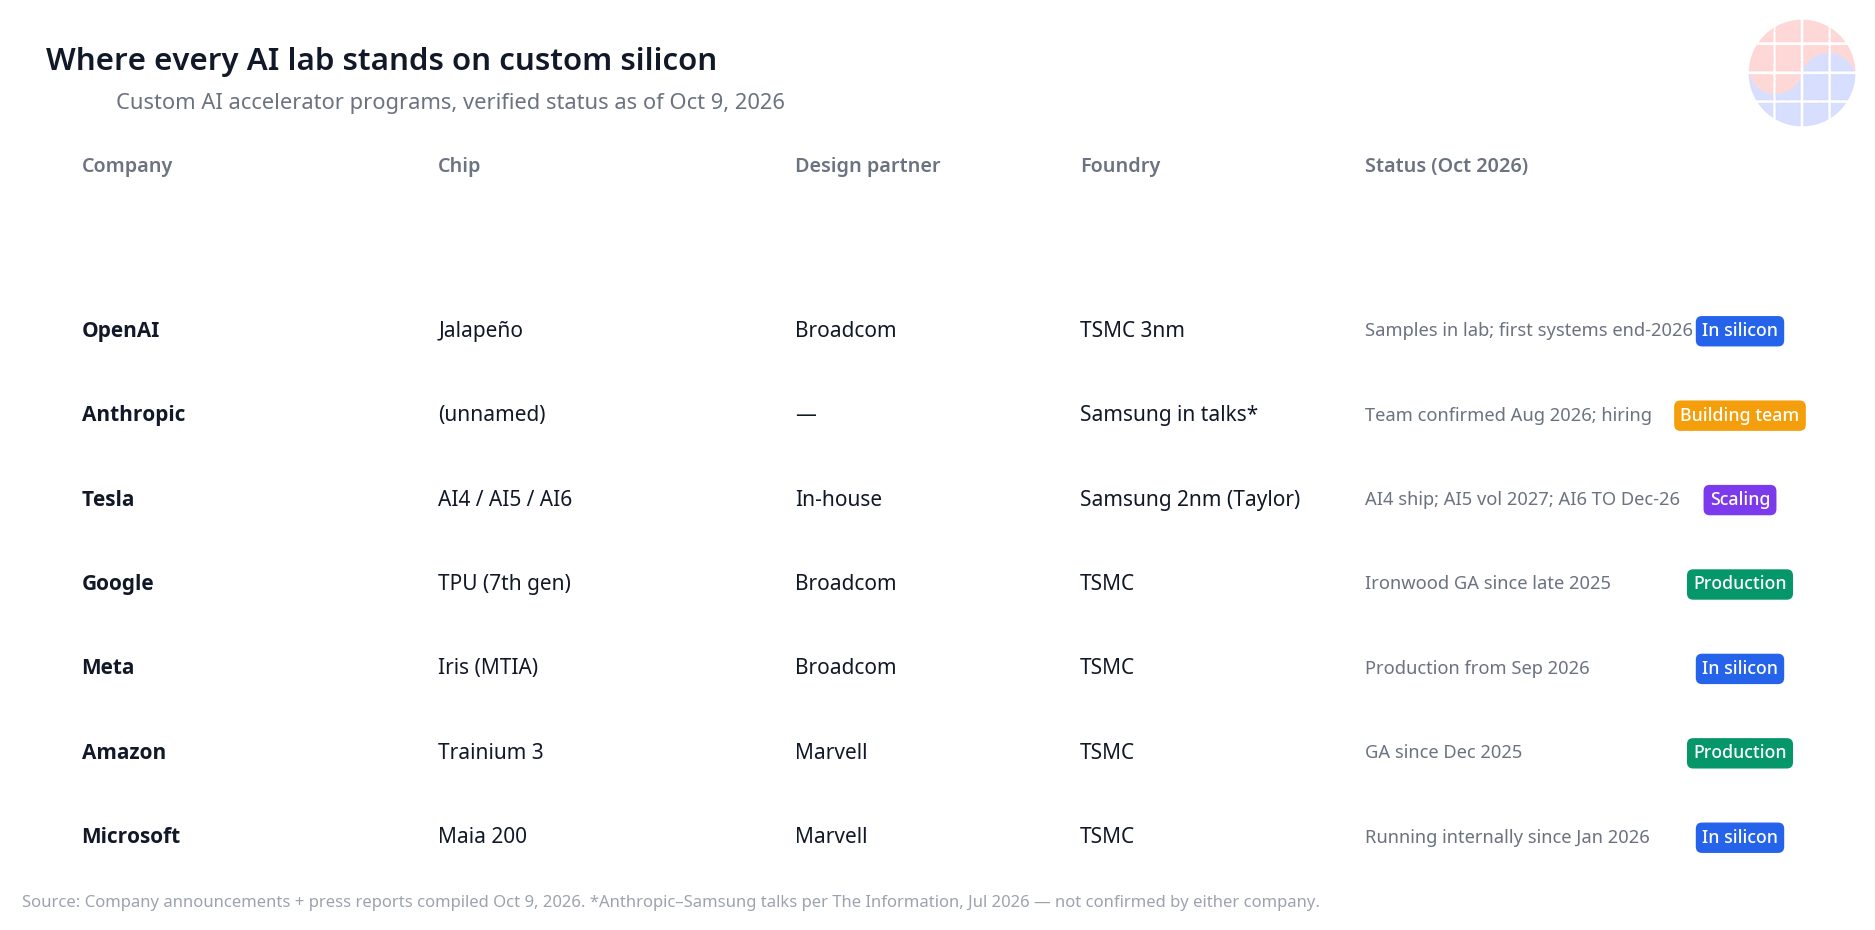
2026 年 8 月 5 日,Anthropic 向 Business Insider 與 TechCrunch 正式承認 custom silicon 團隊的存在。目標很明確:把 Claude 與硬體 co-design,讓它跑得更快更便宜。同時維持「multi-chip 做法」。
招募公告更坦白。Silicon Engineer 職位是 $320k~$485k 區間,找「親自出貨過矽」的工程師。TPM 公告的第一句是這樣:「Anthropic is building custom silicon for Claude.」而且「我們決定親自掌握設計主導權(design authority)。」
真正值得注視的在別處。是「Research Engineer, Chip Design RL」這個職位。這個團隊製作讓 Claude 能設計矽的 RL 環境與 evaluation。具體處理用於 agentic RTL generation、design verification(包含 formal)、physical design optimization 的 RL 環境與評估指標的發明與實現。公告寫道:「Hardware design is difficult and unforgiving – exactly the sort of domain we want Claude to excel at」。
薪資區間成了話題。Chip Design RL 職位是 $500k~$850k,實際做 ASIC 的 Silicon Engineer 是 $320k~$485k 的報導出來了(Wccftech, 2026 年 8 月,二次報導)。要求同水準技能組合,教晶片的一方比做晶片的一方最多多拿近 2 倍的結構。Anthropic 賭在哪裡,以數字顯現。
也在招人。2026 年 8 月 24 日,招攬了帶領 Google TPU 計畫、出貨 7 代的 Amir Salek(依 Bloomberg 報導)。
4. 更正:xAI Macrohard 不是晶片
這是常被誤解的點,說清楚。Macrohard 不是晶片計畫。它是 Musk 在 2025 年 8 月 22 日於 X 發表的「純 AI 軟體公司」構想。2026 年 3 月 11 日,Reuters 報導 Macrohard 以 Tesla 與 xAI 共同專案公開。Musk 表示,這個系統在 Tesla 的 AI4 晶片與 xAI 的 NVIDIA 伺服器上運作。也就是 Macrohard 是「消費」矽的一方,不是「設計」的一方。
Musk 陣營的矽在 Tesla。AI4 正在車輛出貨,AI5 在 2026 年 7 月完成 tapeout。AI6 以 2026 年 12 月 tapeout 為目標。製造是 Samsung Taylor 廠的 2nm。2025 年 7 月簽訂的 $16.5B 晶圓代工合約是其支撐。更大的圖是 Terafab。Reuters(2026 年 4 月 17 日)報導 Tesla 正在台灣招募 9 名工程師。是要求 sub-7nm/2nm 與 CoWoS/SoIC 經驗的職位。
5. SpaceX — 安靜做晶片的組織,以及資訊空白
SpaceX 也有 Silicon Engineering 組織。看招募公告(2026 年目前有效),正在招 Sr. RFIC Engineer、Sr. ASIC Design Engineer 等。設計 Starlink 衛星與地面基礎設施用的 phased-array beamforming RFIC 與次世代 FPGA/ASIC。2025 年 9 月 8 日,決定以約 $17B 收購 EchoStar 的頻譜授權。
有必須誠實說的事。關於 SpaceX 在晶片設計流程內如何使用 AI,沒有公開資訊。沒有不是不用的證據,但在本文也不能主張。資訊空白就留作空白。
📩 在持續關注這個主題嗎?
財報·報告·HBM供需的後續分析,每天10:30(KST)寄到您的信箱。 免費訂閱 →
6. 「AI 設計 AI 晶片」 — 飛輪開始轉動
本系列主題代理型 EDA 與本文主題相遇的點在這裡。AI 實驗室一邊做晶片,一邊同時以 AI 設計晶片。
OpenAI 先證明了。依 IEEE Spectrum(2026 年 9 月)報導,Jalapeño 的前端工作流程建立在 Google 的開源 HLS 工具鏈 XLS 之上。工程師不直接寫 Verilog,而以 DSLX 與 C++ 撰寫邏輯,XLS 把它轉換成 Verilog。Richard Ho 表示使用了為晶片設計特別 fine-tuning 的客製 LLM。
Anthropic 再往前一步。Chip Design RL 職位就是它。製作 RL 環境本身,讓 Claude 學會生成 RTL、跑 verification、最佳化 PD。若 OpenAI 把自家模型當晶片設計「工具」使用,Anthropic 則接近把 Claude 培養成晶片設計「主體」的宣言。
NVIDIA 賣這個迴圈的基礎設施。繼 ChipNeMo(2023 年)之後,2025~2026 年的步伐是 NeMo Gym。它是以決定性 EDA 工具為 verifier 的 RL 基礎設施,已開源釋出。Siemens 以 NeMo Gym 與 Nemotron 把 Fuse EDA AI Agent 做成「self-verifying」,Synopsys 在 AgentEngineer、Cadence 在超級代理線放上 NVIDIA 堆疊。在 EDA 業者賣代理的同時,NVIDIA 賣的是訓練代理的體育館。
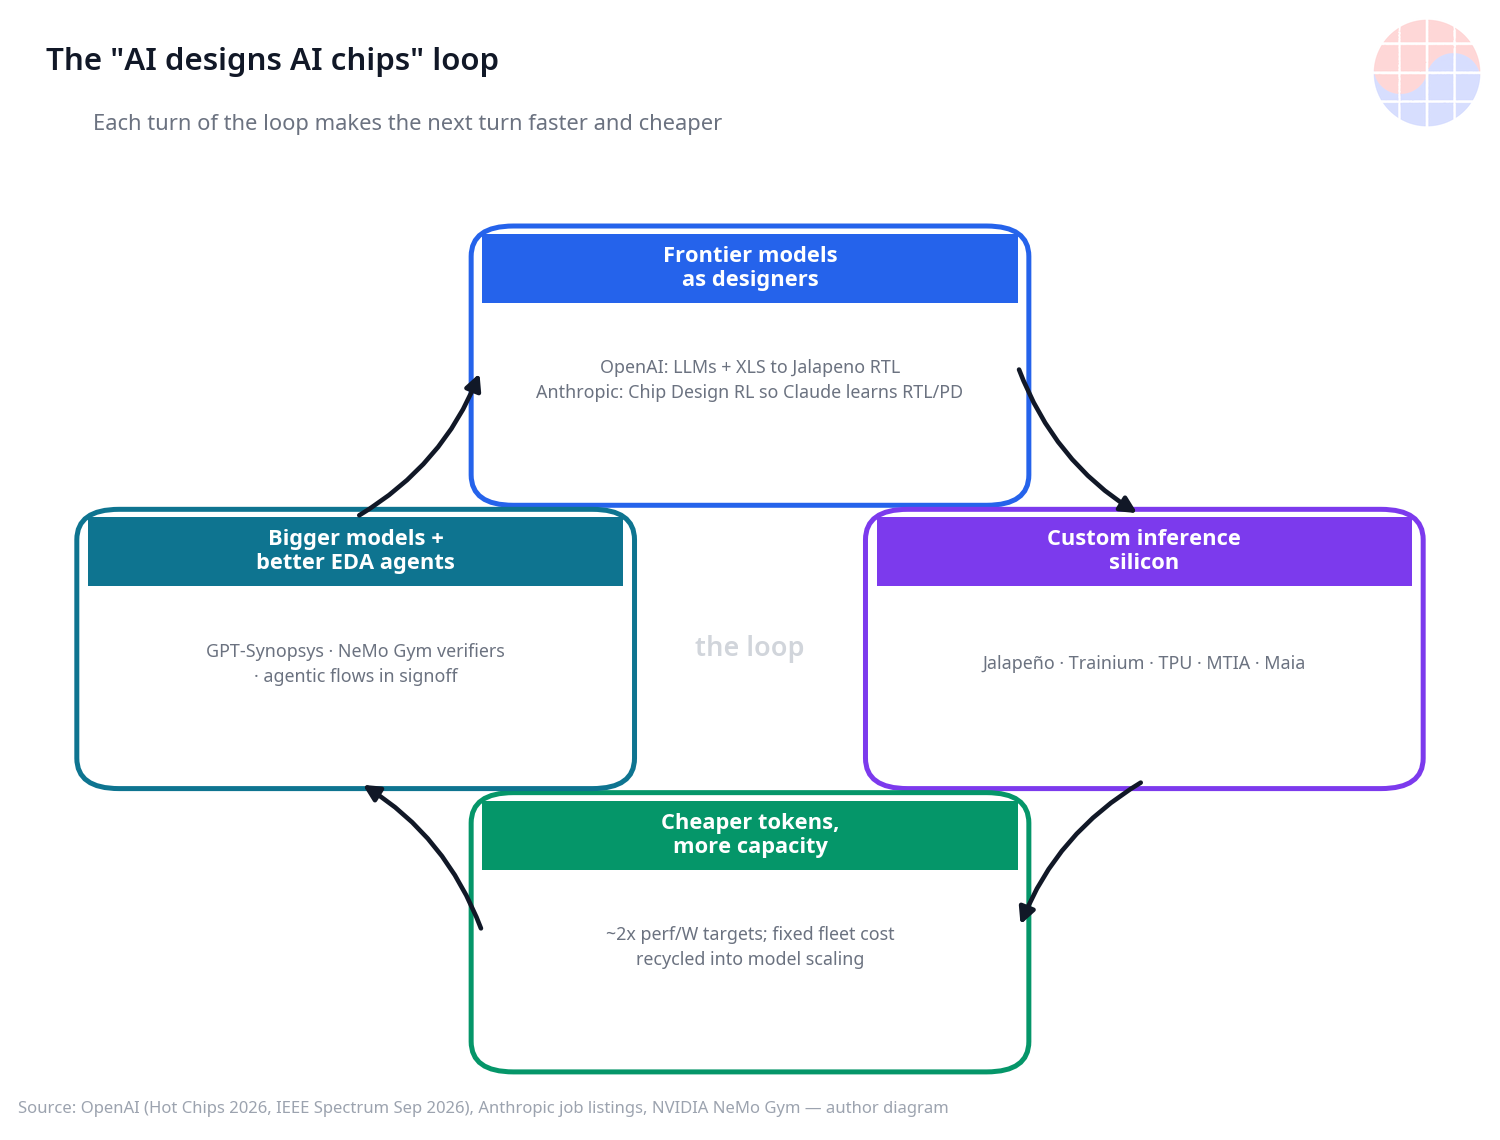
畫圖來看。Frontier 模型設計晶片 → 客製矽出來 → 推論變便宜、容量增加 → 以省下的錢與增加的容量跑更大的模型、訓練更好的 EDA 代理 → 再回到晶片設計。是飛輪。OpenAI 已經轉了一圈(Jalapeño → GPT-Synopsys 交易,2026 年 9 月 30 日),Anthropic 正在做第二圈的引擎,NVIDIA 正在鋪轉動輪子的地板。
當然限制也很明確。Synopsys CEO 在 GPT-Synopsys 交易發表當時也說:「模型的輸出以傳統 signoff 工具 double-check。signoff,也就是 ground truth 是必需的」(Reuters, 2026 年 9 月 30 日)。尚無在無人類介入下完全自主 tapeout 產業規模晶片的驗證案例。飛輪在轉,但方向盤前仍然坐著人。
7. 背景:Big Tech 也在同一場遊戲中
Google 是元祖。DeepMind 的 AlphaChip 是以 RL 做晶片 floorplan 的系統,用於 TPU 3 代的布局。不過 New Scientist(2024 年 10 月)刊登了外部專家的反論: 「比人類更好」的主張不可重現。
Meta 在 2026 年 3 月 11 日一次公開 MTIA 的 4 個新世代(300/400/450/500)。MTIA 300 已量產中,與 Broadcom 共同設計,TSMC 製造。也有代號 Iris 晶片在 2026 年 9 月進入生產的報導。
Amazon 的 Trainium 3、Microsoft 的 Maia 200 也各自跑著矽路線圖。
可以看到一個模式。設計夥伴收斂到 Broadcom 或 Marvell,晶圓廠全都是 TSMC。降低 NVIDIA 依存度的競賽,諷刺地提高了 TSMC 依存度。若昨天的 EDA 客戶是半導體公司,今天的 EDA 客戶是 AI 實驗室。
FAQ
Q1. OpenAI Jalapeño 真的比 NVIDIA GPU 快嗎?
以 OpenAI 在 2026 年 8 月 25 日 Hot Chips 公開的自行測量為基準,是的。但 Jalapeño 是 HBM4、比較對象是 HBM3e,不是同世代比較,也尚無獨立驗證。
Q2. Anthropic 晶片什麼時候出來?
未定。2026 年 8 月 5 日正式承認團隊存在並招募中,但 tapeout 時程未公開。
Q3. xAI 也做 AI 晶片嗎?
不是。xAI 的「Macrohard」是 AI 軟體代理專案。Musk 陣營的晶片設計在 Tesla(AI4/AI5/AI6)進行。
Q4. AI 真的能設計晶片嗎?
部分已經在做。OpenAI 以 LLM+XLS 工作流程設計 Jalapeño 的前端,Anthropic 正在建構教 Claude 做晶片設計的 RL 環境。不過最終 signoff 仍由傳統 EDA 工具與人類工程師負責。
Q5. 為何 AI 實驗室不離開 NVIDIA 卻做自家晶片?
目的不是脫離 NVIDIA,而是談判力與原價結構。有自家晶片,在價格談判中有利,也能直接控制推論成本結構。
Sources
- Jalapeño 公開 (2026-06-24): https://lapaasvoice.com/openai-broadcom-unveil-jalapeno-custom-chip-built/
- Jalapeño benchmark (Hot Chips 2026, 2026-08-25): https://www.igorslab.de/en/openai-jalapeno-beats-nvidia-gb200-gb300-in-initial-inference-benchmarks-up-to-36x-lower-latency/
- Jalapeño 設計方法論 (IEEE Spectrum, 2026-09): https://spectrum.ieee.org/llms-for-chip-design
- Anthropic custom silicon 團隊確認 (TechCrunch, 2026-08-05): https://techcrunch.com/2026/08/05/anthropic-is-hiring-an-ai-chip-design-team/
- Anthropic 薪資區間報導 (Wccftech, 2026-08, 二次): https://wccftech.com/anthropic-is-paying-nearly-a-million-dollars-per-year-to-the-engineers-teaching-its-ai-models-to-design-a-chip-but-just-320000-485000-to-those-actually-building-its-first-asic/
- Macrohard Tesla-xAI 共同專案 (Reuters, 2026-03-11): https://www.reuters.com/business/autos-transportation/musk-unveils-joint-tesla-xai-project-macrohard-eyes-software-disruption-2026-03-11/
- Samsung-Tesla $16.5B 晶圓代工合約 (2025-07): https://www.datacenterdynamics.com/en/news/samsung-electronics-signs-165bn-deal-with-tesla-to-manufacture-ai6-chips-at-taylor-texas-fab/
- GPT-Synopsys 交易 (Reuters, 2026-09-30): https://www.lapost.com/content/synopsys-openai-strike-deal-to-develop-ai-model-for-chip-design-work
- NVIDIA NeMo Gym (開源): https://github.com/NVIDIA-NeMo/Gym
- ChipNeMo 論文 (2023): https://arxiv.org/html/2311.00176v4
撰寫基準日:2026 年 10 月 9 日。所有事實以基準日目前可確認的公開資訊為基礎,供應商主張與二次報導已標示於本文。
常見問題
OpenAI Jalapeño 是什麼晶片,何時公開?
是與 Broadcom 一起做的推論專用 ASIC,2026 年 6 月 24 日公開。TSMC 3nm 製程,systolic array 結構,在 2.5D 中介層上放 8 個 HBM 堆疊的構成。
Jalapeño 的 Hot Chips 2026 發表數字是什麼?
是 OpenAI 自行測量基準。在 GPT-OSS 120B 發表比 NVIDIA GB200 高 1.9 倍的每瓦處理量,在 DeepSeek R1 670B 比 GB300 高 1.7 倍。Jalapeño 是 700W,比較對象 GB300 系統是 1,400W。
AI 實驗室做自家晶片的理由是什麼?
推論成本、供應談判力、模型-硬體 co-design 三個。自家晶片不是與 NVIDIA 決裂的宣言,而是作為對價格與供應條件的談判手段一起推進。
Anthropic 自家晶片的推進現況如何?
2026 年 8 月 5 日正式承認 custom silicon 團隊的存在。目標是把 Claude 與硬體 co-design 降低推論成本,維持與 AWS、Google、NVIDIA、AMD 一起使用的 multi-chip 做法。
相關文章
- 一人晶片時代要來了:AI 代理改變的半導體工程師工作與生存策略
- 晶片設計 AI 代理是誰在賣:以 build vs buy 讀代理型 EDA 市場地圖
- 代理型 EDA (3):切得愈小愈聰明 — 階層式 AI 晶片設計研究的最前線
- 代理型 EDA 2026:Synopsys、Cadence、Siemens 三家晶片設計代理策略比較
📩 今天錯過的分析,明天早上寄到您的信箱
每天10:30(KST)Daily Silicon與財報·機構報告核心解讀搶先送達。訂閱後可選擇韓語/英語/日語新聞通訊,中文深度分析每日在網站更新。
免費訂閱 →
免費 · 無垃圾郵件 · 隨時退訂


