VLSI Korea
接上 Quad SPI,感測器也不會變快的原因
以 TinyProbe 的新研究為出發點,計算在接腳數量之前應先檢視的傳輸長度、控制器、緩衝器與無線路徑的處理量。


🆓 免費文章 · 任何人都可以免費閱讀
增加讀取感測器資料的 SPI 線數,資料區間一次能搬移的位元會增加。但使用者收到的幀不會以相同比例變快。
發送命令的時間、所選控制器的時脈、緩衝器填滿的速度、能否與下一個傳輸階段重疊工作,都必須一起改變。在重新設計電路板之前,該做的是計算縮短哪個區間的時間,能讓完整資料更常到達。
| Boundary | Keep fixed | Record |
|---|---|---|
| Pins | Board, voltage, lane mode, clock | Pattern errors, timing conditions |
| Transaction | Payload length, command format, gaps | Useful bytes and elapsed time |
| Host delivery | Acquisition setting, network load | Complete frames, loss and latency |
Table 1. Editorial test framework, not a claim that these tests were performed here.
2026-10-01 提交的 TinyProbe 多線 SPI 預印本,具體展示了這個問題。作者報告在實際的 IGLOO2、SiWG917 配置中以 5 MHz 驗證了 Dual SPI,並在另外的 Kria K26、STM32N6 試驗台上把 Quad SPI 測到 66 MHz。
後者的資料區間原始位元率是 264 Mbit/s,但不是完整探測器的無線處理量。 論文原文
VLSI Korea view: 寬匯流排的價值,應該以它把系統最慢的等待時間縮短多少來判斷,而不是最大位元率。
本文幫助在 FPGA 中取出感測器資料的工程師決定匯流排寬度與突發長度,也幫助系統負責人判斷該把開發費花在韌體修改還是控制器更換上。核心計算不是特定產品的基準,而是能代入自己的量測值重複使用的設計範例。
同樣的位元,量測的邊界不同
把感測器路徑分為資料產生、暫存、電路板內傳輸、網路交付,「速度」這個詞的分母就變清楚了。ADC 的取樣速率是把輸入轉為數值的能力,SPI 的位元率是在給定的線上移動資料的能力。
主機的處理量,是其中實際到達並被承認為有效的資料量。前面的數字大,不代表後面的數字也會大,這個關係並不成立。
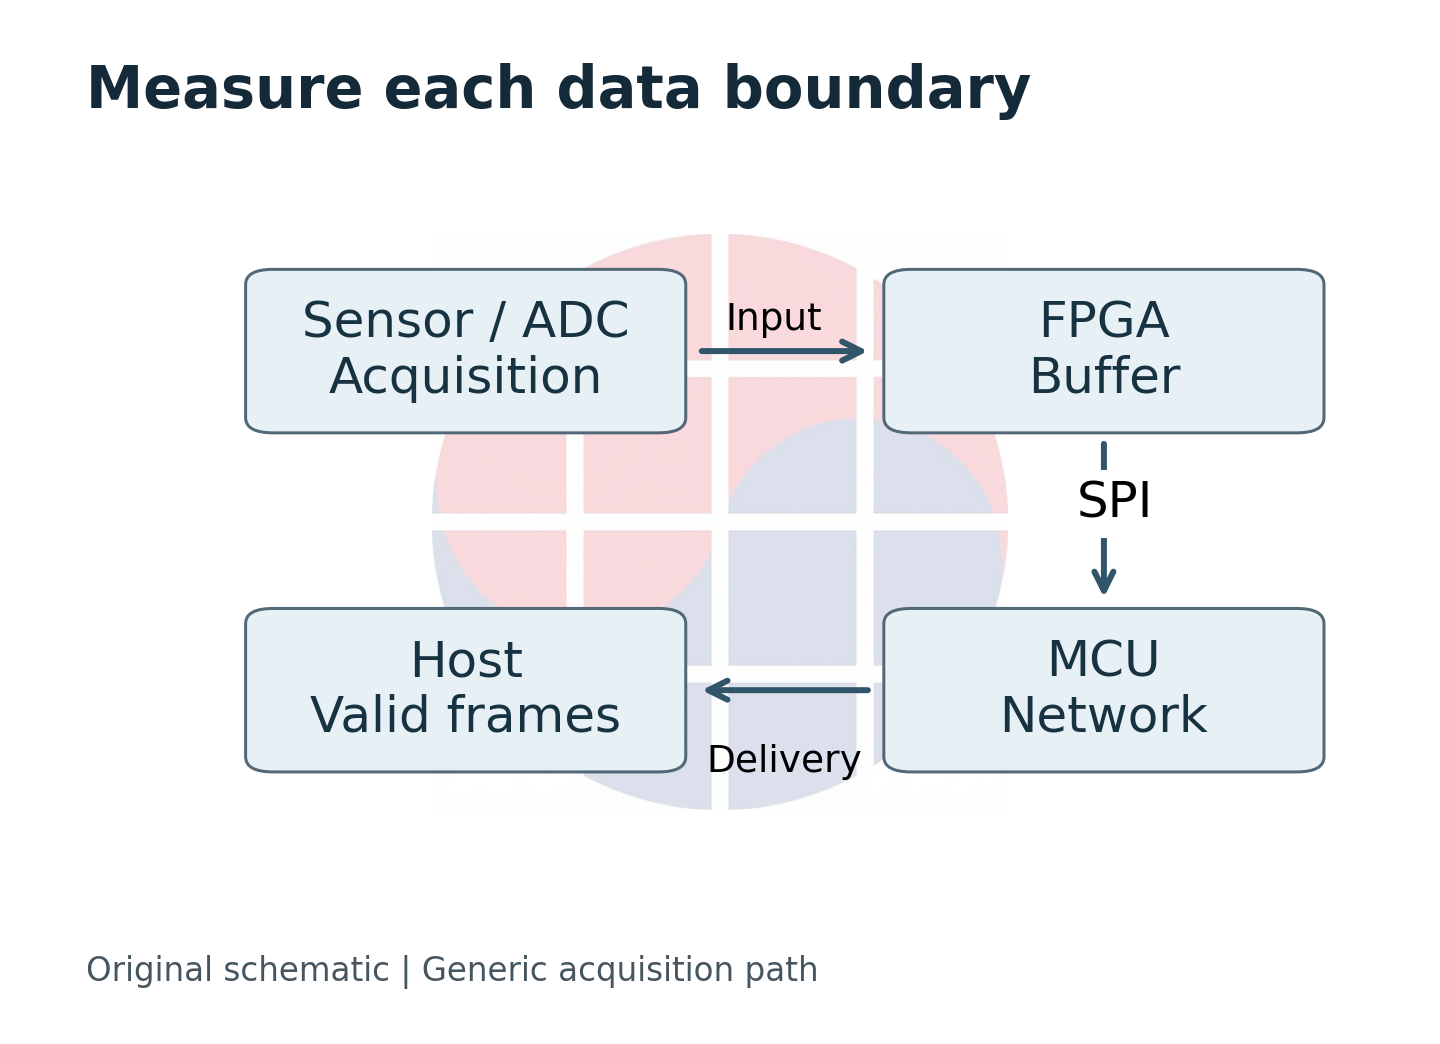
舉例來說,TI AFE5832LP 產品資料說明了 32 個輸入通道與 LVDS 輸出。這是類比接收部連接到數位採集電路的邊界。
若把同一份產品資料的取樣速率與後面 MCU 的 SPI 速率直接相除來求系統幀率,就會省略通道選擇、採集時間、儲存格式與傳輸間隔。這就是必須區分零件最大規格與裝置運作條件的原因。 TI 產品資料
實務上最好先固定處理量的定義。決定要算採集到的原始樣本、去掉標頭的緩衝器,還是主機完整組裝的幀。
之後在相同的起始、結束條件下量時間。若把重傳的位元組再次加進成果,或把送出函數返回的瞬間當成主機到達時點,同一個系統也會產出不同的效能表。
這是比量測設備更先要解決的契約。
增加線數時,時脈與方向也要確認
一般的單資料線 SDR 傳輸,每個時脈週期在該方向搬移一個位元。Dual、Quad 方式增加資料區間平行使用的線數。
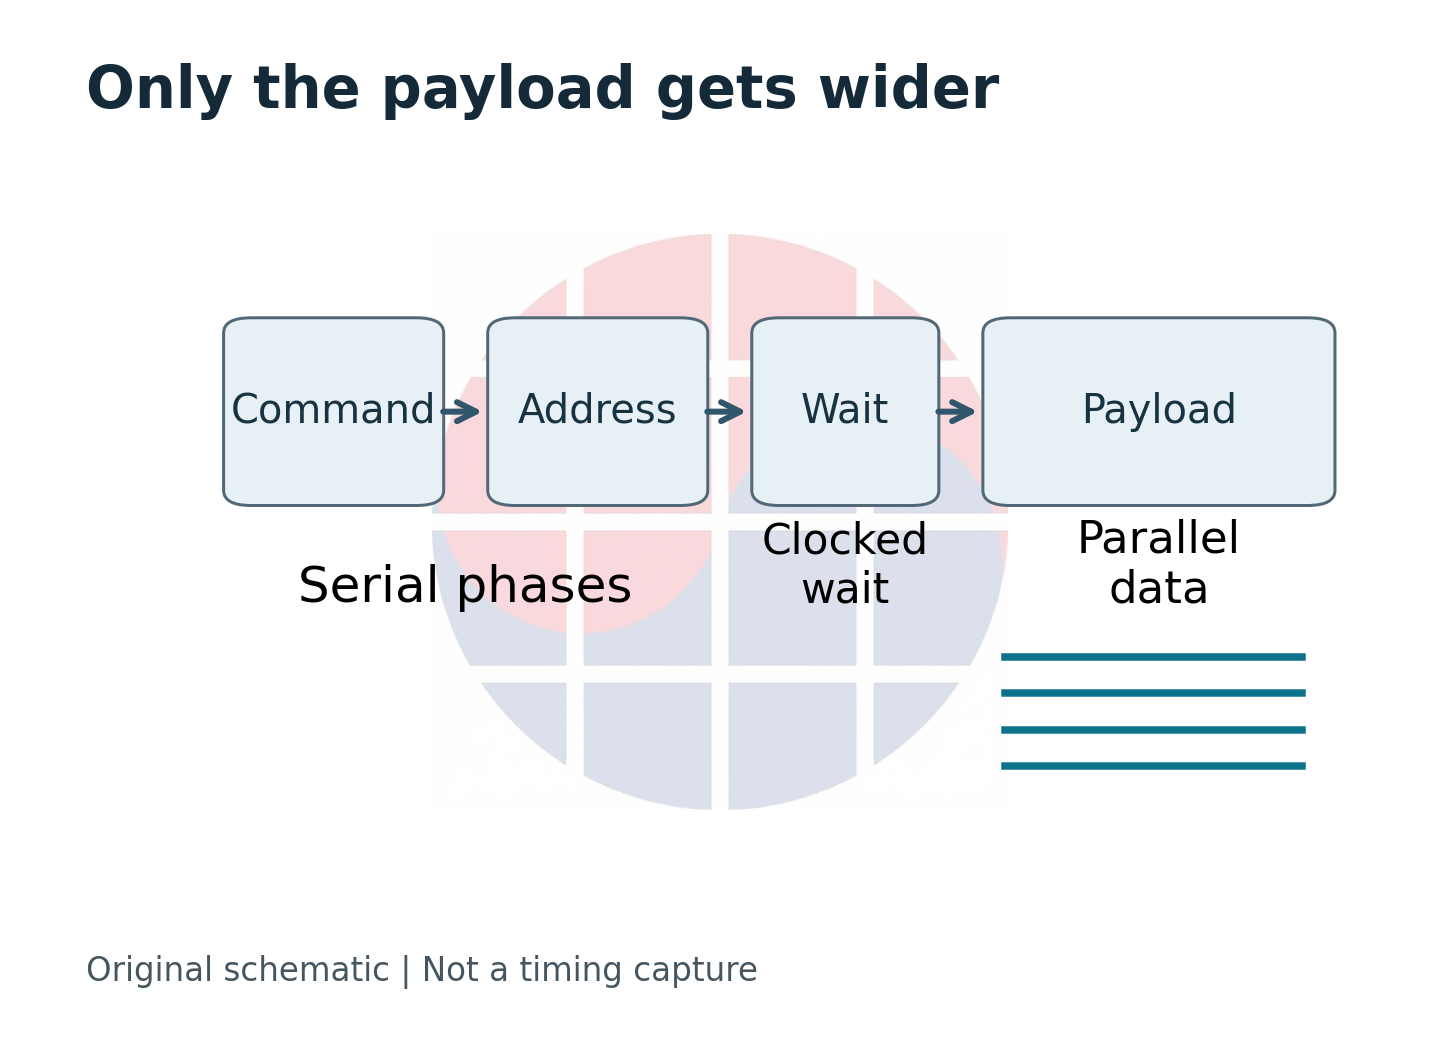
此時命令與位址是否也以相同寬度傳輸,是另外的條件。Silicon Labs 的 SSI 結構文件說明要區分命令、位址、等待、資料區間,並分別設定其傳輸格式。
因此,不能只憑「支援 Quad」的標示就認定整個交易都變寬了。 SSI 結構文件
另一個陷阱是假設每個模式的容許時脈都相同。Silicon Labs 的 917 開發者指南 v1.0.3 FAQ 明示一般 SPI 最高 40 MHz,Dual、Quad 最高 10 MHz。
但同版本結構說明中也有加入 DMA 條件的 Quad 22.5 MHz 計算範例,所以整份文件並未整理成一個無條件的上限。必須把產品、SDK 與接腳設定綁在一起確認,此處不把 FAQ 的數字擴大為普遍的實測上限。 FAQ
在布線檢視中,要追蹤的不是訊號名稱,而是每個區間的驅動主體。在單 SPI 中用作輸出的線,在多線讀取中可能變成輸入。
若兩邊同時驅動,就不是邏輯值的問題,而是電氣衝突。反之若切換時點太晚,第一筆資料會消失。
必須在兩端對齊等待週期、取樣邊緣、晶片選擇訊號的保持條件。只搬移設定選單上顯示的最大值,並不能確保相容性。 SSI 設定指南
短傳輸中,命令比資料更昂貴
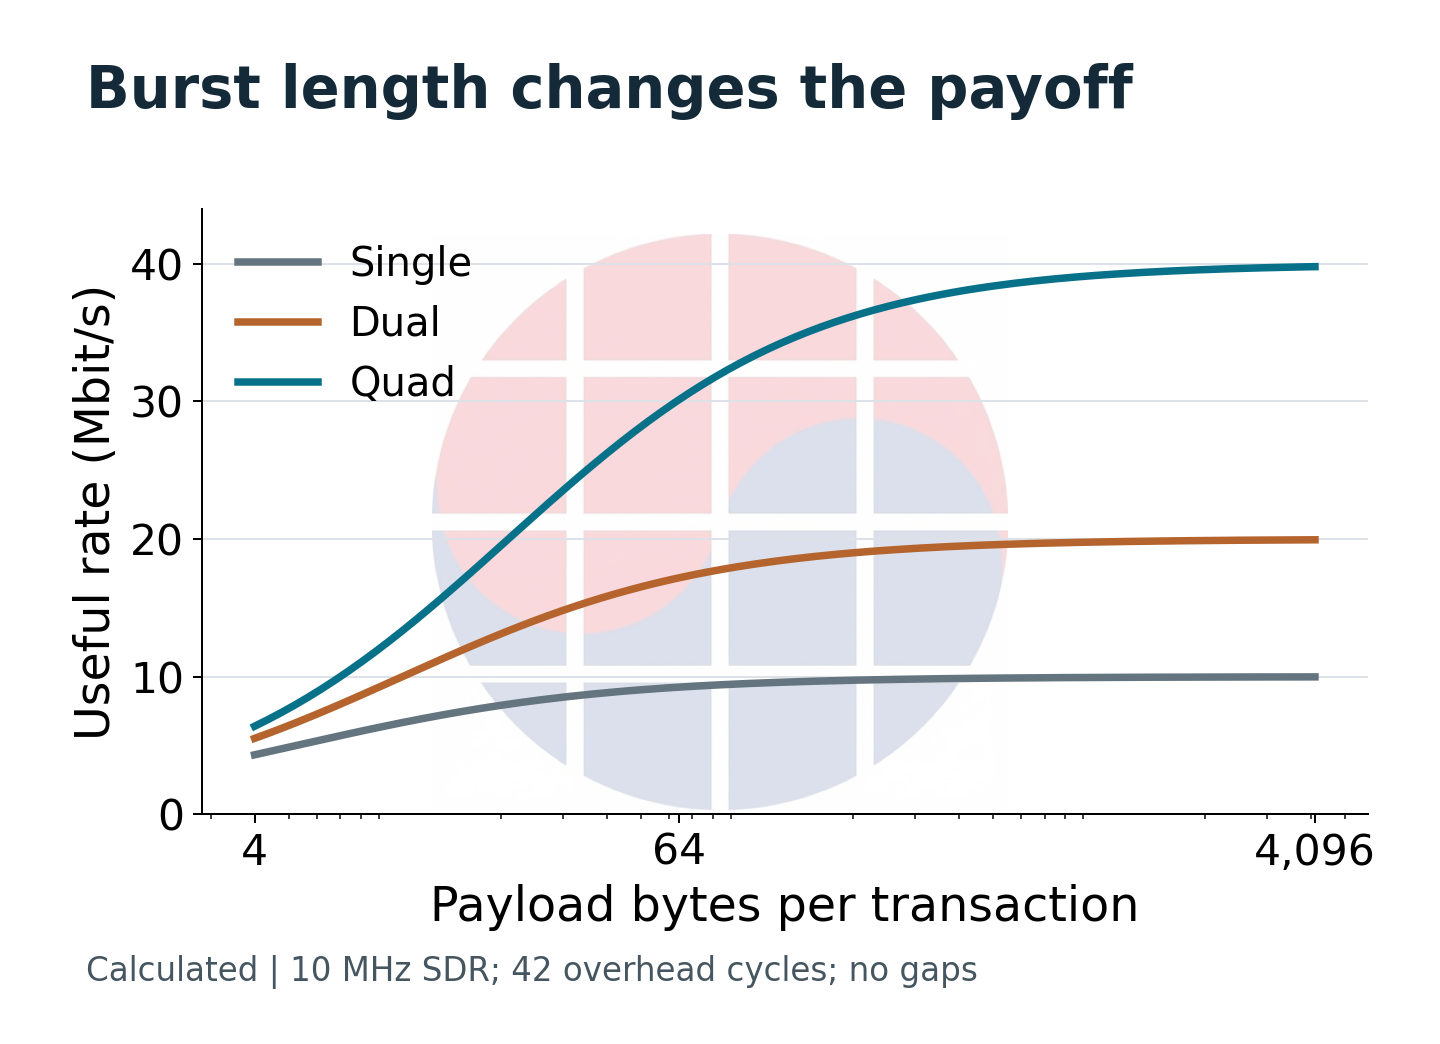
為了分離寬度的效果,定義如下的虛擬讀取。所有模式時脈皆為 10 MHz,命令為單線 8 位元,位址為單線 24 位元,等待為 10 週期。
只有資料區間依線數 L 變寬。這是比較用的共同條件,不保證所有組合在特定 MCU 上都原樣運作。
先排除晶片選擇之間的空白與軟體延遲。
讀取 N 位元組的交易時脈數為 42 + 8N/L。因此有效 payload 位元率以 8N × f / (42 + 8N/L) 計算。f 是每秒時脈數。
區分分子的位元與分母的時間,也能減少把 MHz 誤寫成 Mbit/s 的錯誤。產品說明中的原始位元率 L × f,是只有資料區間持續接連時會逼近的值。
讀 4 位元組時,單線約 4.32 Mbit/s,Dual 5.52 Mbit/s,Quad 6.40 Mbit/s。即使線數增加,已付出的命令、位址與等待時間並不減少。
相對地,一次讀 4,096 位元組的 Quad 範例約為 39.80 Mbit/s,接近原始位元率 40 Mbit/s。這就是同一個「Quad」在小型暫存器讀取與大型樣本緩衝器讀取中看起來完全不同的原因。
| Payload per transaction | Single, Mbit/s | Dual, Mbit/s | Quad, Mbit/s |
|---|---|---|---|
| 4 bytes | 4.32 | 5.52 | 6.40 |
| 64 bytes | 9.24 | 17.18 | 30.12 |
| 4,096 bytes | 9.99 | 19.95 | 39.80 |
Table 2. The same illustrative assumptions as Figure 3; values rounded to 2 decimal places.
當然,把突發無限拉長也不是答案。接收緩衝器被佔用的時間與其他工作的等待時間會拉長。
在長交易途中發生錯誤,必須重送的範圍也可能變大。若控制命令的回應期限緊迫,把資料塊切分是更好的選擇。
📩 在持續關注這個主題嗎?
財報·報告·HBM供需的後續分析,每天10:30(KST)寄到您的信箱。 免費訂閱 →
實務順序是先定容許延遲,再在其中選足以稀釋固定開銷的大小。
FIFO 不會消除平均速度的不平衡
緩衝器讓生產者與消費者能在不同時刻工作。但若平均流入量大於平均流出量,有限的緩衝器終究會滿。
必須把這個差異與時脈域交越,也就是 CDC 的正確性問題區分。即使 CDC 安全,容量也可能不足;即使容量充裕,若狀態訊號傳遞錯誤,資料也可能損壞。
AMD 的 Embedded FIFO Generator PG327 要求寫入、讀取介面的訊號在各自的時脈域中使用,並遵守 full、empty 狀態。獨立時脈 FIFO 的狀態解除也有同步延遲。
即使剛空出空間,對面也不能立刻使用那個空間。這是該 IP 的動作說明,不代表 TinyProbe 使用了這個 IP。 同步說明、狀態旗標說明
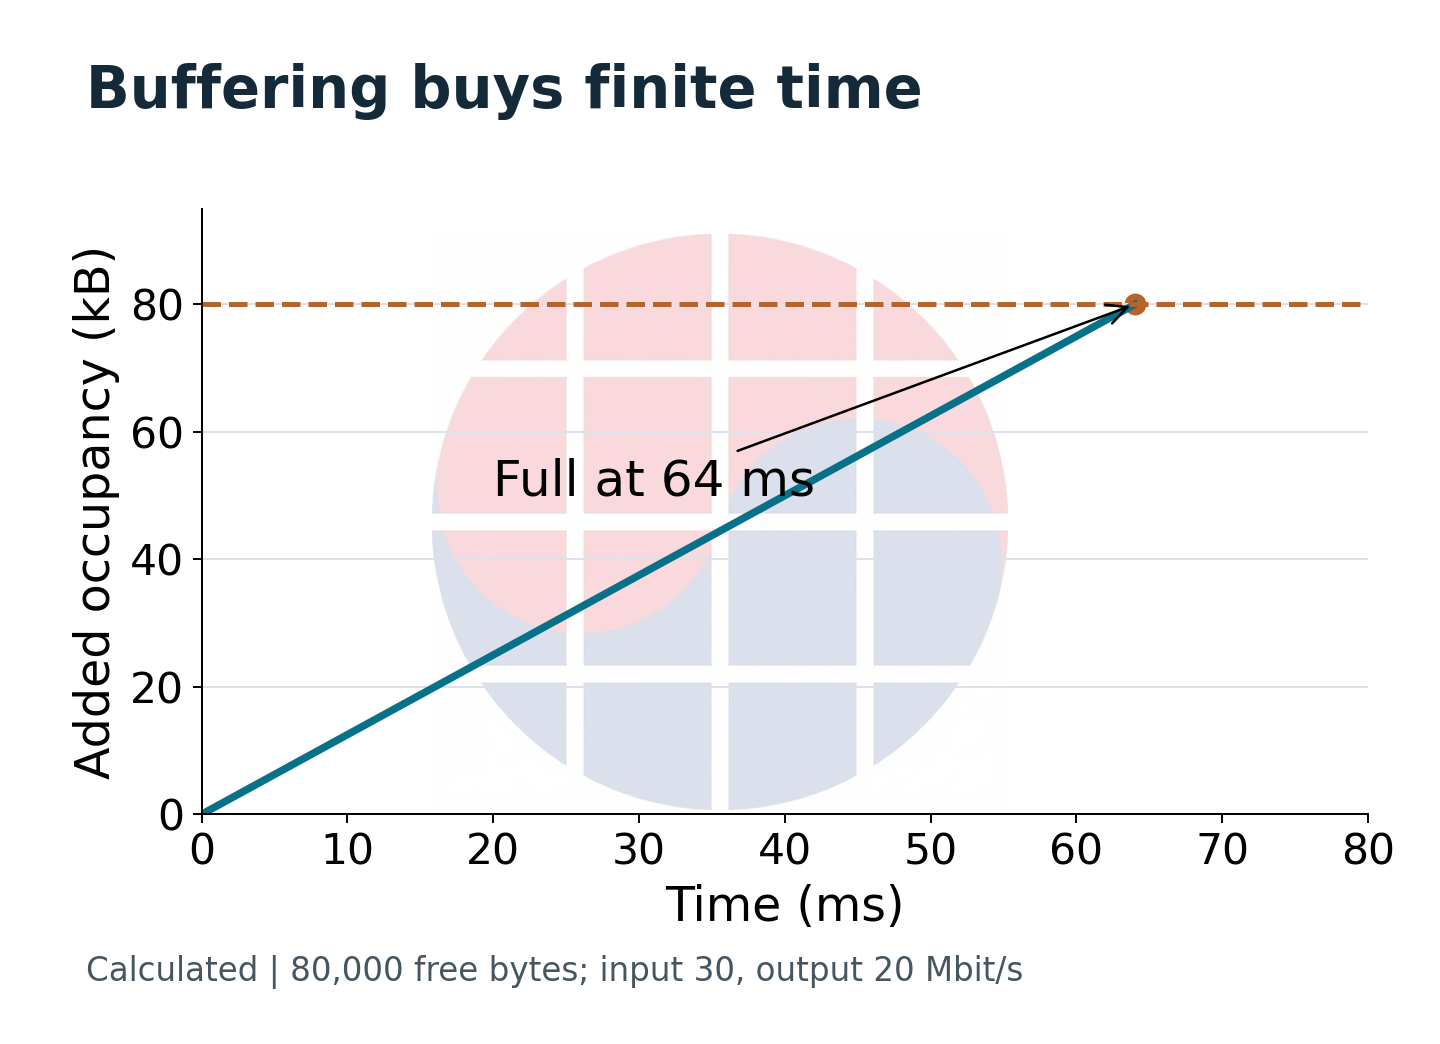
在圖的範例中,剩餘空間 80,000 位元組是 640,000 位元。以流入 30 Mbit/s 與流出 20 Mbit/s 的差去除,64 ms 後餘裕就消失。
若一開始就有一部分是滿的,或 DMA 服務停下來,會更快。因此需要的不是單一深度,而是關於最壞服務空白、容許損失、生產者能否停下來的條件。
若採集無法停止,擴大緩衝器是買到緩衝時間的選擇,不是提高持續處理量的選擇。
也要一併看資料單位。若樣本寬度與記憶體儲存寬度不同,會產生 padding 或重新打包。
把傳輸的位元組換算成感測器有效位元時,必須反映這個比例。即使使用 DMA,也可能剩下記憶體複製、快取管理與完成通知處理。
若把這些成本扣掉只量 SPI,就難以比較韌體變更的實際價值。
無線路徑與是否重疊傳送,會改變整體速度
電路板內的 SPI 變快之後,接著看從 MCU 到主機的路徑。這裡「最慢的連結決定整體速度」這句話也有條件。
若多個階段在穩態下同時處理不同的資料捆,慢的階段會訂上限。但若讀完整個緩衝器後才開始網路傳輸,並在此期間停下下一次讀取,各階段的時間就會相加。
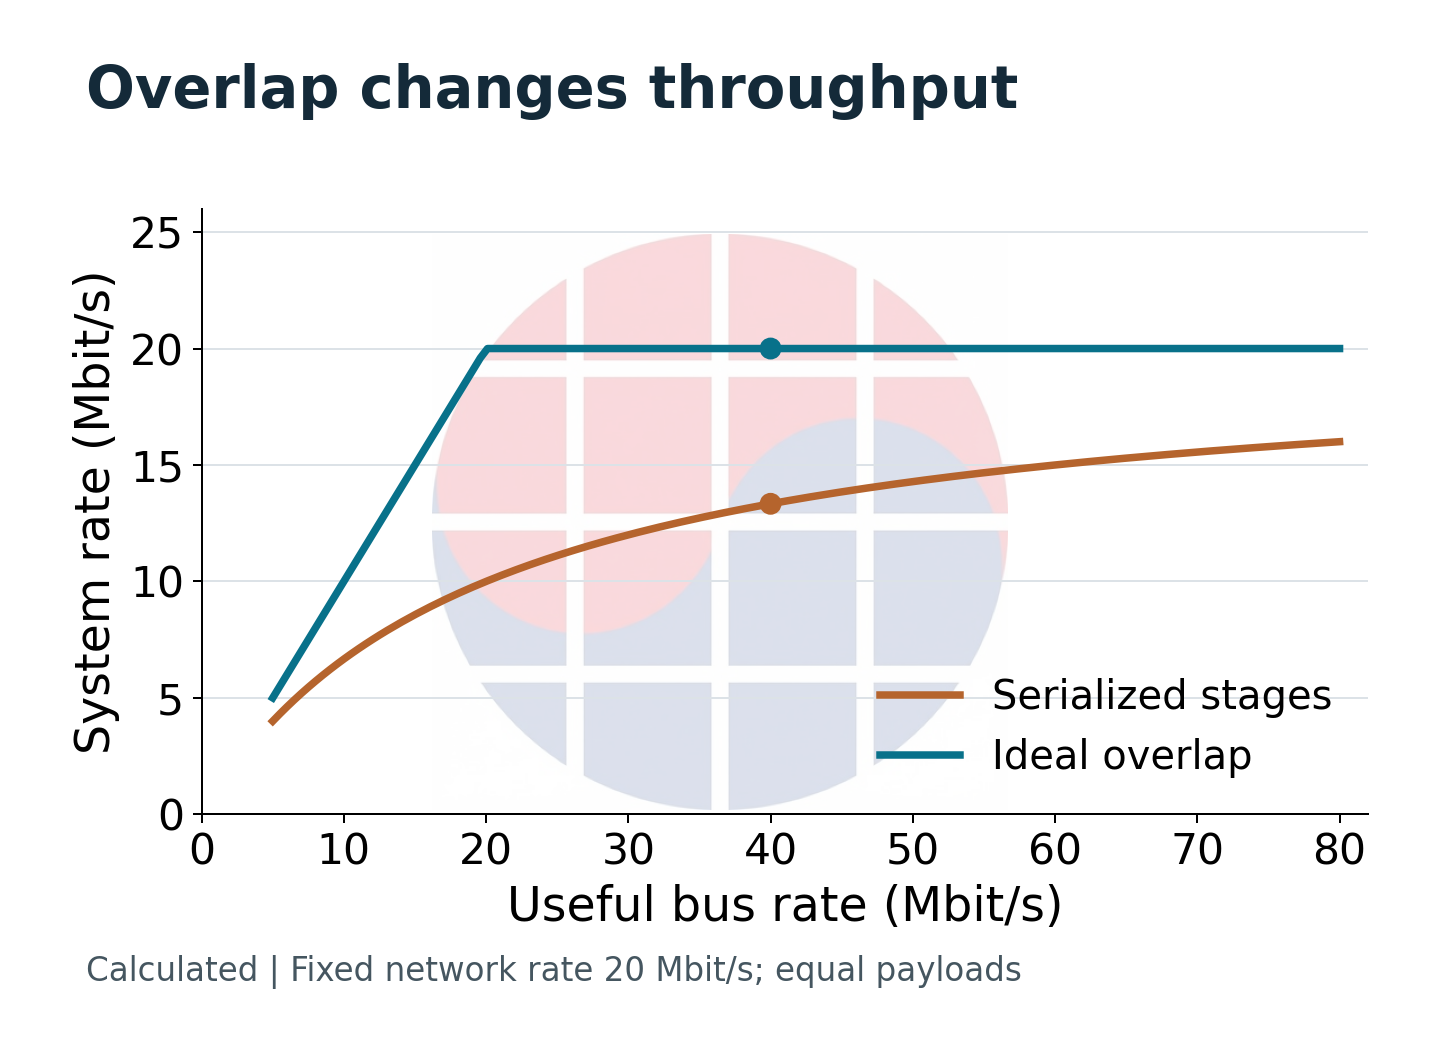
為了看這一點,假設搬移相同大小有效資料的匯流排為 40 Mbit/s,網路為 20 Mbit/s。若階段完全串列,處理量是 1 / (1/40 + 1/20),約 13.33 Mbit/s。
若有足夠的獨立緩衝器與資源而能重疊處理,穩態的理想上限是 20 Mbit/s。這個數字不是 TinyProbe 的量測值,也是排除了協定成本與採集時間的獨立範例。
| Scheduling | Model denominator | Limiting condition |
|---|---|---|
| Serialized | Sum of stage times | Each batch waits for the next stage |
| Overlapped | Slowest stage in steady state | Independent resources and buffers |
Table 3. Original model comparison. First-frame latency still includes every required stage.
這個差異會改變該修什麼。若結構上無法重疊資料傳輸,在多用接腳之前,先改緩衝器所有權與 DMA 完成路徑可能更有效。
若已充分重疊且網路已飽和的結構,電路板內匯流排的追加速度,可能貢獻的是餘裕時間或部分延遲,而不是幀率。同一個最佳化依前提不同,產品價值也不同。
Boundary condition: 不能把管線的處理量上限讀成第一幀的到達時間。即使重疊工作,每一幀都必須經過所有必要階段。
只因是無線就把所有空白都歸咎於傳播環境,也很危險。MCU 的複製工作、共用記憶體存取、堆積封包的政策,可能讓匯流排與網路輪流閒置。
把資料產生、讀取完成、送出交接、主機組裝完成的時間戳連起來,就能區分需要更快的無線零件,還是該讓現有資源少等待。
把試驗台通過的速度搬到產品規格的條件
前面看的 TinyProbe 研究的意義,在分開讀不同試驗時變得明確。獨立試驗台調查介面的可能範圍,整合裝置確認實際連接配置的動作。
若用了不同的 FPGA 與控制器,不能把結果綁成單一效能提升倍數。此外,報告試驗中未觀察到錯誤,與在所有溫度、電壓、布線條件下的錯誤率保證不同。
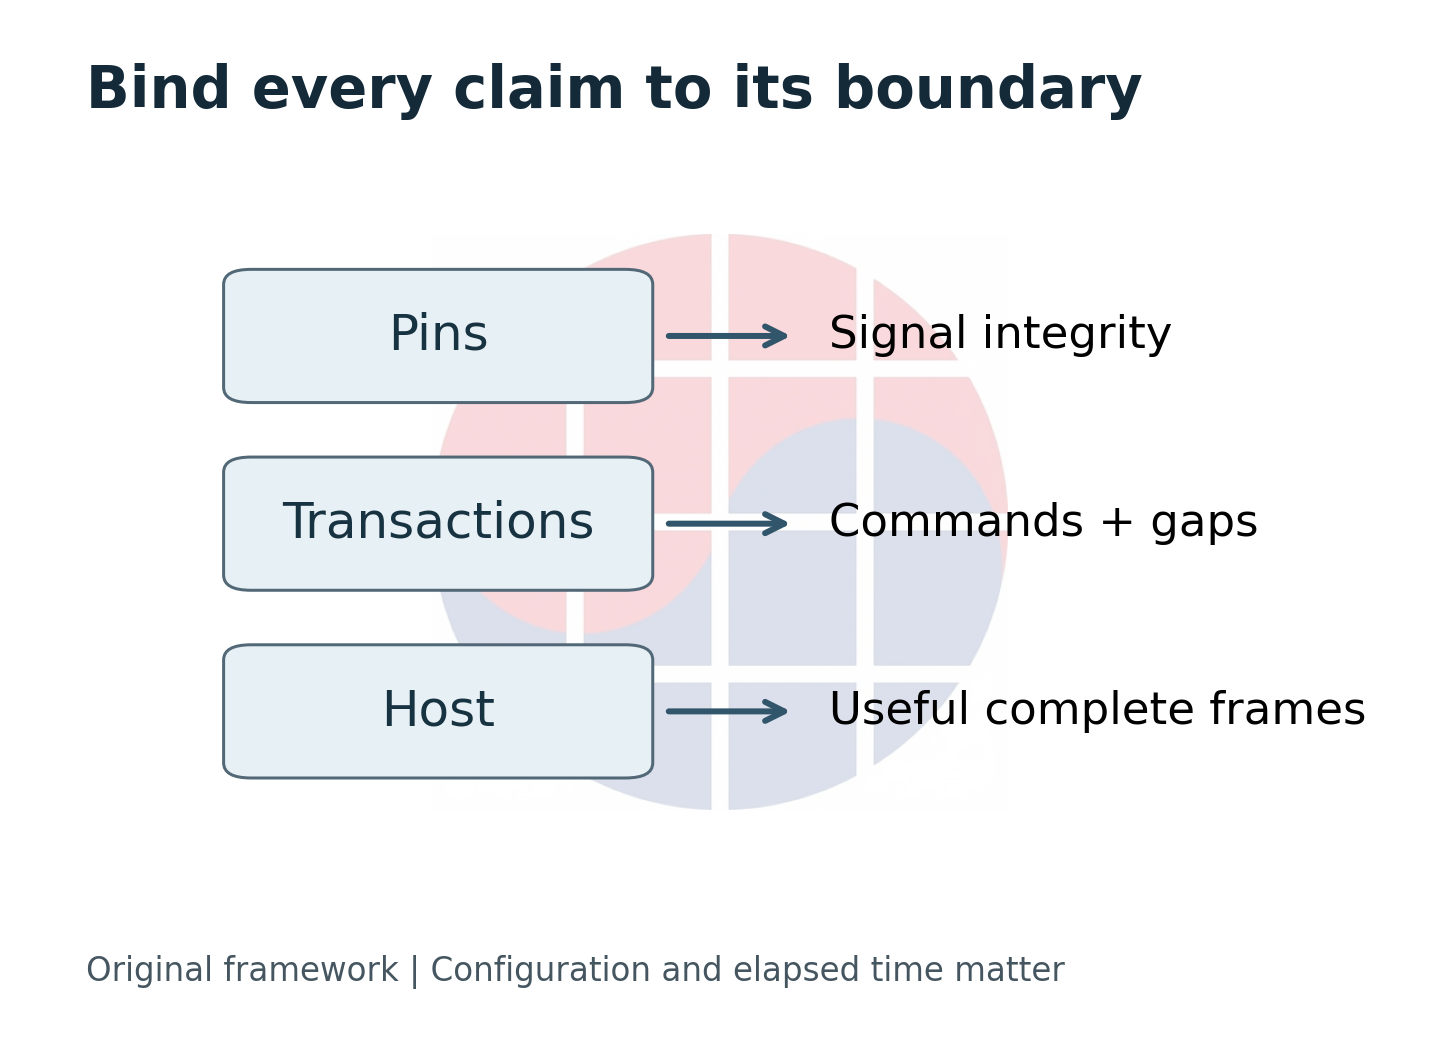
設計審查用的效能表最好至少留下三個邊界:接腳的資料區間、包含命令與空白的交易、主機上完成的有效資料。
把各邊界連起來,就能同時說明匯流排內部改善與系統改善。匯流排變快了、但主機數字不變的結果,不是失敗的量測,而是告訴我們瓶頸位置的觀察。
一開始以重複圖案確認布線與位元順序,接著放入實際樣本格式與緩衝器邊界。最後一併給予網路負載與服務空白,確認緩衝器溢出時會失去什麼、如何恢復。
每次若把所有條件都改變,就無法分離改善原因,所以要定好要比較的變數,並維持其他條件。若只選成功的短傳輸,很容易錯過長時間採集的弱點。
韓國設計團隊應先改的是效能表的分母
對韓國國內的感測器模組、FPGA 與嵌入式產品團隊而言,這個問題也是零件選擇與時程管理的問題。若使用更寬的介面,會伴隨追加接腳與布線、新驅動程式、驗證範圍。
若更換控制器,可能連電力狀態與軟體資產都受到影響。反之,若瓶頸可用突發合併或傳輸重疊解決,就能讓既有電路板的價值維持更久。
哪一方較便宜,不是只以購買單價決定。
| Observed constraint | Candidate intervention | Tradeoff |
|---|---|---|
| Short transactions | Aggregate bursts | Control latency and buffer occupancy |
| Stages take turns | Overlap transfers | Buffer ownership and memory contention |
| Bus stays saturated | Wider or faster interface | Pins, power and validation effort |
Table 4. Editorial decision framework. Choose the intervention only after measuring the stated constraint.
因此設計團隊要傳達給採購與事業負責人的數字,比起單一最大時脈,更應是目標資料到達的時間與達成它的配置。一併問「這次變更減少了哪裡的空白」、「在相同輸入與損失條件下,完成的幀是否更多」。更換零件的理由不在匯流排變寬本身,而在以更少的延遲或資源完成所需的工作。
未來 6–12 個月的觀察點,是整合路徑的資料,比高時脈的再演示更重要。若 TinyProbe 後續公開資料能特定控制器與韌體版本,並把緩衝器政策與主機有效處理量連起來,就能更精確判斷匯流排變更的產品價值。
下一個檢視基準日是 2027-04-03。這不是上市預告,而是編輯上的重新評估時點。
改變本文判斷的條件也很明確。若在相同輸入、網路與電力條件下,目前的匯流排持續飽和,且量測顯示即使充分重疊傳輸,主機仍在等資料,匯流排擴展就成為直接的優先事項。
在那之前,與其先定線數,不如先定邊界、把時間分段量測。好的介面設計不止於得到更大的數字,還要說明那個數字在讀者的裝置中縮短了什麼。
Sources
- TinyProbe multi-wire SPI paper, arXiv v1。已確認預印本正文。提交紀錄中的 IUS 2026 採納標示是作者提供的資訊,未另外確認 IEEE 最終刊載。
- Silicon Labs SSI developer guide v1.0.3, FAQ, configuration。為同一製造商的文件組。
- TI AFE5832LP product documentation。已確認公開產品頁面。
- AMD PG327 synchronization and flags, version 1.0, 2023-05-16.
- TinyProbe official repository, photo authorship, image license。照片是 Sergei Vostrikov 的實際 TinyProbe 照片,依 CC BY 4.0 使用。不是證明論文的新介面已安裝在照片中電路板上的圖像。
本文的計算與圖表是 VLSI Korea 的說明用模型,不代表執行了實驗。使用 AI 準備文稿、翻譯與說明資料。
Disclosure
本文僅供資訊之用,不構成買入或賣出任何特定證券的建議。本文所含數字與事實係以企業公告、媒體報導、市場調查等公開可得資料為基礎撰寫,該等資料或撰寫過程中可能發生錯誤。作者可能持有文中提及企業的股票。所有投資決定及其結果由讀者自行負責。
📩 今天錯過的分析,明天早上寄到您的信箱
每天10:30(KST)Daily Silicon與財報·機構報告核心解讀搶先送達。訂閱後可選擇韓語/英語/日語新聞通訊,中文深度分析每日在網站更新。
免費訂閱 →
免費 · 無垃圾郵件 · 隨時退訂