VLSI Korea
Daily Silicon: 삼성 HBM4·엔비디아 CUDA: 4nm base die와 2nm SRAM
현직 반도체 엔지니어가 오늘 읽은 글로벌 반도체 뉴스 요약 - 삼성 HBM4·엔비디아 CUDA: 4nm base die와 2nm SRAM


🆓 무료 글 · 누구나 무료로 읽을 수 있는 글입니다
현직 반도체 엔지니어가 오늘 읽은 뉴스 요약:
HBM4의 경쟁은 stack 높이보다 4nm base die에 어떤 controller, test, telemetry를 넣느냐로 이동하고 있다. CUDA의 RISC-V 확장도 ISA 지원 선언이 아니라 PCIe coherency와 peer-to-peer를 갖춘 서버 플랫폼의 qualification 문제다.
Chase's Take - 나는 HBM4의 4nm base die를 대역폭 headline으로 읽지 않는다. PHY 면적을 줄여 남긴 영역에 memory controller와 test를 넣는 순간, package signoff는 signal integrity만이 아니라 repair map, thermal telemetry, host protocol의 공동 qualification이 된다.
CUDA용 RISC-V도 같은 구조다. 다음 확인점은 Hot Chips 발표가 실제 server platform의 ACPI, PCIe coherency, peer-to-peer 검증 항목으로 공개되는지다.
1. Hot Chips 2026: Samsung HBM Base Die Opportunities, HBM4 4nm
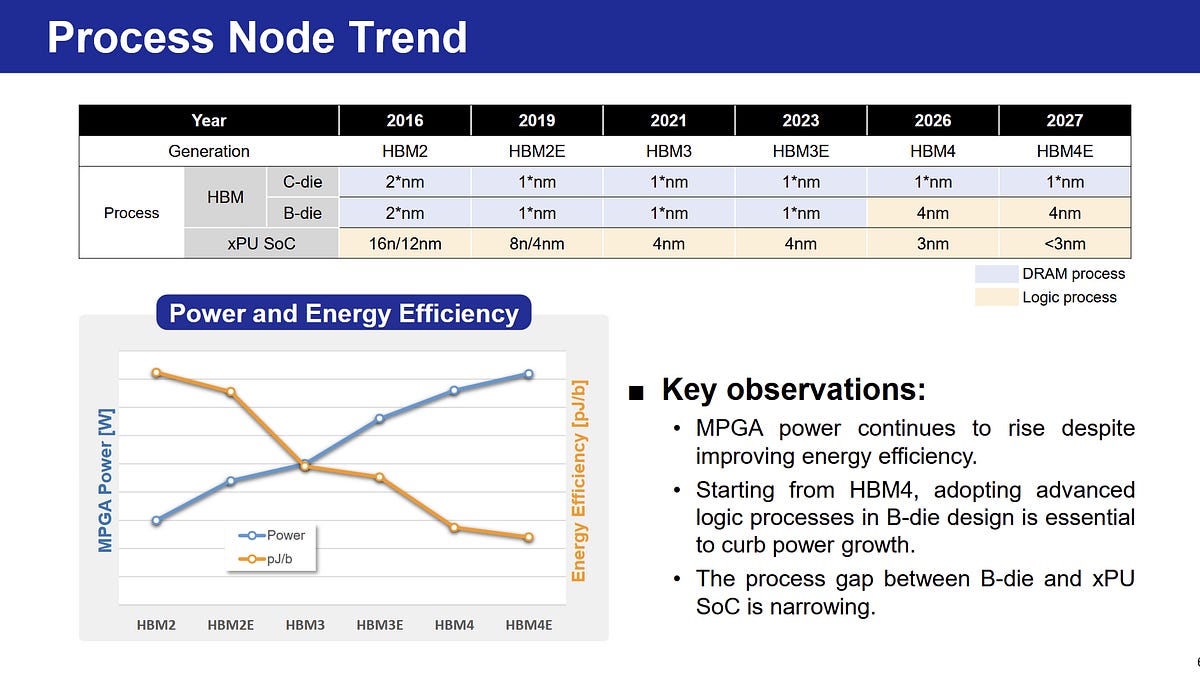
TL;DR - 삼성은 HBM4와 HBM4E base die를 4nm logic node로 옮겨, PHY 면적과 전력 제약을 controller, repair, telemetry의 설계 공간으로 바꾸고 있다.
- Hot Chips 2026 분석에 따르면 HBM4와 HBM4E base die는 4nm logic process를 사용하며, 발표는 활용 방안을 3단계로 제시했다.
- HBM interface pin 증가가 base-die 면적과 전력을 밀어 올리는 만큼, package 팀은 bandwidth보다 host protocol, thermal sensor, repair coverage의 qualification을 함께 봐야 한다.
출처: Chips and Cheese - Hot Chips 2026: Samsung HBM Base Die Opportunities, HBM4 4nm
2. Hot Chips 2026: CUDA Targets RISC-V, PCIe coherency
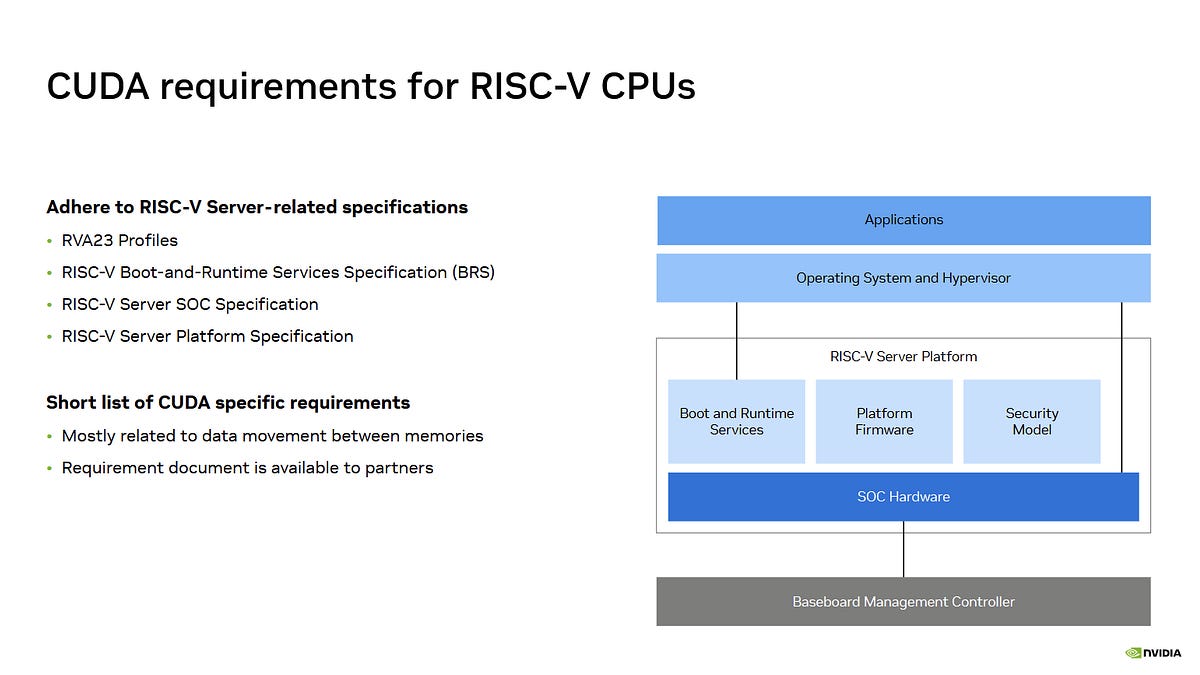
TL;DR - NVIDIA의 CUDA RISC-V 경로는 RVA23뿐 아니라 ACPI, PCIe coherency, peer-to-peer 전송을 갖춘 서버 platform을 전제로 한다.
- Hot Chips 2026 분석은 CUDA-ready RISC-V 시스템의 요구사항으로 RVA23, server platform spec, vector extension, ACPI, PCIe coherency와 peer-to-peer를 열거했다.
- GPU DMA와 CPU cache의 stale data를 막지 못하면 runtime workaround가 필요해진다. backend와 SoC 팀의 watch-point는 ISA port가 아니라 coherency protocol과 device path의 검증 범위다.
출처: Chips and Cheese - Hot Chips 2026: CUDA Targets RISC-V, PCIe coherency
3. Process-Aware Hybrid Si/IGO Monolithic-3D 6T SRAM: 2nm 면적 25%

TL;DR - 새 monolithic-3D 6T SRAM 연구는 BEOL IGO pass-gate와 Si nanosheet latch 조합으로 HP baseline 대비 footprint 25% 감소를 보고했다.
- 128×256 subarray에서 write delay는 HD baseline 대비 42.2%, EDP는 9.7% 낮았다고 연구진은 보고했다.
- 2nm SRAM의 다음 병목은 transistor 수보다 contact resistance와 BEOL parasitic이다. PDK, extraction, TCAD calibration이 같은 signoff chain에 묶여야 수치가 product로 이어진다.
출처: arXiv - Process-Aware Hybrid Si/IGO Monolithic-3D 6T SRAM: 2nm 면적 25%
4. 마이크론 Boise training center는 fab tool 20대까지 복제한다
TL;DR - 마이크론은 6만 제곱피트 training center에 최대 20대 process tool을 넣고, fiscal 2027 말까지 apprenticeship를 세 자릿수 enrollment로 확대한다.
- 마이크론과 미국 상무부는 College of Western Idaho에 교원 보수, 장비, 강의 공간용으로 300만달러를 제공한다고 밝혔다.
- fab ramp에서 tool install보다 늦어지기 쉬운 것은 operator와 maintenance qualification이다. 공정팀은 training throughput과 vendor-specific certification을 wafer starts 계획의 선행 지표로 봐야 한다.
출처: Micron Technology - 마이크론 Boise training center는 fab tool 20대까지 복제한다
앞으로 지켜볼 것
- NVIDIA와 Synopsys의 8월 26일 실적 발표
AI accelerator 수요와 EDA backlog의 공식 guidance가 다음 Daily의 P0 후보가 된다. - CUDA RISC-V의 ACPI와 PCIe coherency 구현 범위
server platform의 실제 qualification 범위가 확정돼야 software port와 silicon validation 비용을 분리해 볼 수 있다. - HBM4 logic base die의 controller와 test 기능 공개
표준 HBM interface를 유지할지, custom protocol로 옮길지가 multi-sourcing과 package validation을 바꾼다. - Boise training center의 apprenticeship enrollment
fab equipment의 공급보다 operator와 maintenance qualification이 ramp의 실제 rate limiter가 되는지 확인할 수 있다.
Signal Radar - 놓치지 말아야 할 소식
- HBF는 HBM 옆에서 capacity를 늘리지만 runtime 재설계가 필요하다 (Chips and Cheese)
- SiFive BigSky는 32-core RVA23 server platform을 제시했다 (Chips and Cheese)
- Intel Wildcat Lake는 저가 notebook에서 UCIe 전력과 BOM을 다시 계산한다 (Chips and Cheese)
- 2nm 이하 multi-die assembly의 설계와 검증 부담이 커진다 (Semiconductor Engineering)
- edge AI와 cloud AI의 역할 분리는 system co-optimization으로 이동한다 (Semiconductor Engineering)
- 서울대와 성균관대의 antiferroelectric device는 4-bit input 16개 상태를 구분했다 (Semiconductor Engineering)
- 고엔트로피 oxide semiconductor는 낮은 thermal conductivity를 노린다 (Communications Materials)
- 빛으로 반복 programming 가능한 초박막 semiconductor가 보고됐다 (Princeton Engineering)
- 서울대는 physical AI national research laboratory를 열었다 (Seoul National University)
- Hot Chips 2026은 8월 23일부터 25일까지 Stanford에서 열렸다 (Semiconductor Engineering)
VLSI Korea에서 이어 읽을 글
- 256-core server CPU의 병목은 core 수가 아니다: Diamond Rapids의 memory-I/O envelope
host memory bandwidth와 package I/O가 compute density를 제한하는 이유를 이어 읽을 수 있다.
관련 글
- Daily Silicon: 엔비디아-SK 오늘(6/8) 전격 협력 발표, 삼성 2nm 엑시노스 2600 첫 출격, 코스피…
- Daily Silicon: WSTS 반도체 $1.51T·브로드컴 $286B 쇼크·베라루빈 HBM4 3사 인증·삼성 HBM5 첫…
- Daily Silicon: 인텔·애플 칩 동맹에 10% 급등, 삼성-SK 시총격차 99조, ASML EUV 中유입 논란,…
- Daily Silicon: 삼성전자 89.5조원, HBM4·ATE capacity
- Daily Silicon: TSMC 5월 매출 417억불 신기록·美 하원 中 장비 380억불 수출 적발·SK하이닉스 HBM4…