VLSI Korea
減少了邏輯閘,電路為什麼反而更慢
佈局之後,負載與導線可能比邏輯級數更主導時序。透過反映物理資訊的重新映射研究與公開設計工具,探討應該採用哪種最佳化。


🆓 免費文章 · 任何人都可以免費閱讀
OpenROAD 的時序最佳化包含複製邏輯閘或插入緩衝器的動作。因為把電路做大這個選擇,反而可能減少延遲。不能只憑合成結果的元件數量減少,就判斷下一次佈局布線的結果也變快了。 OpenROAD Gate Resizer
VLSI Korea view: 時序最佳化的單位不是單一邏輯閘,而是在相同約束下重新實作並量測的路徑。
近期研究再次凸顯了這個差異。復旦大學研究團隊於 2026-10-01 提交的預印本,對已佈局電路的局部邏輯連同物理脈絡一起重新映射(remapping)。這不只是介紹新演算法,也是促使設計團隊自問「該如何證明什麼被改善了」的契機。 論文 v1
邏輯級數的節省在哪裡消失
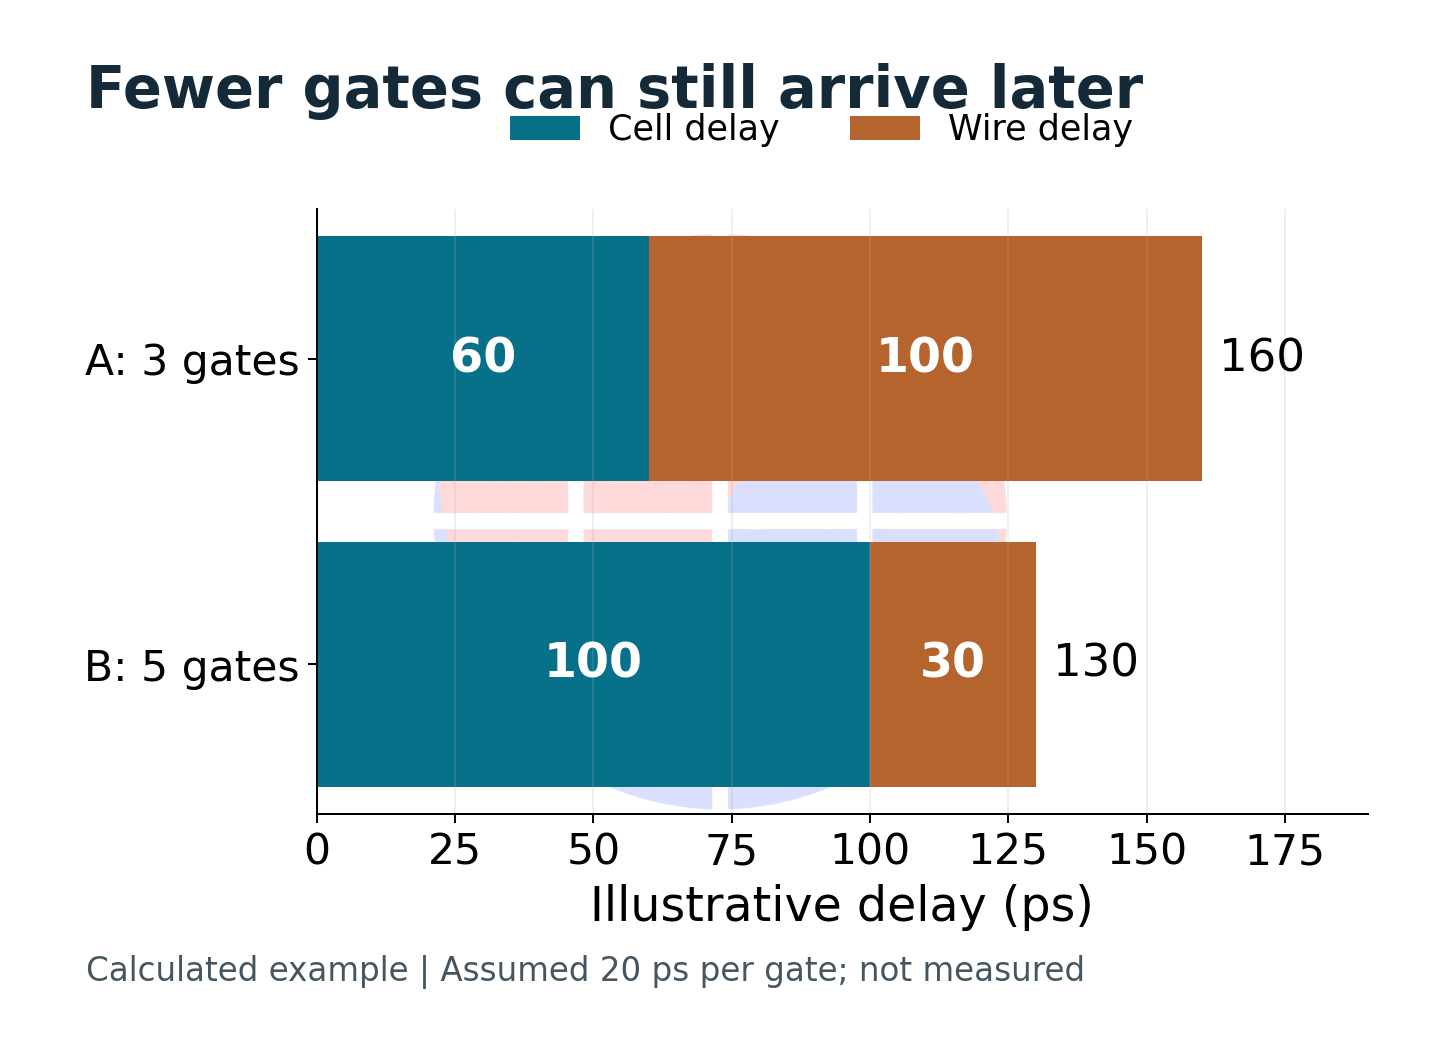
比較一條虛擬路徑。實作 A 有 3 個邏輯閘、各用 20 ps,導線延遲總和為 100 ps。實作 B 有 5 個邏輯閘、各用 20 ps,但導線延遲為 30 ps。總延遲 A 為 160 ps,B 為 130 ps。邏輯閘較少的 A 反而更慢。
這不是從實際元件庫得到的量測值,而是為了分離延遲預算項目的算術範例。實際上,每個元件的延遲也會依輸入訊號的轉換時間與輸出負載而不同,所以不應以邏輯級數乘上固定時間的計算來評估設計。
核心在於一個訊號驅動多少輸入、那些輸入在哪裡。若共用在多處使用的中間結果,邏輯式會變簡潔。然而,若必須把訊號送到距離共用點很遠的消費者,就必須同時對導線與接收輸入的電容充電。
反之,把部分邏輯複製到消費者附近,可以減少各分支承擔的負載。代價是複製元件的面積與漏電功率,以及上游輸入的追加負載。因此,編輯判斷是:複製是否有利,不能只看共用節點,必須比較其前後路徑。
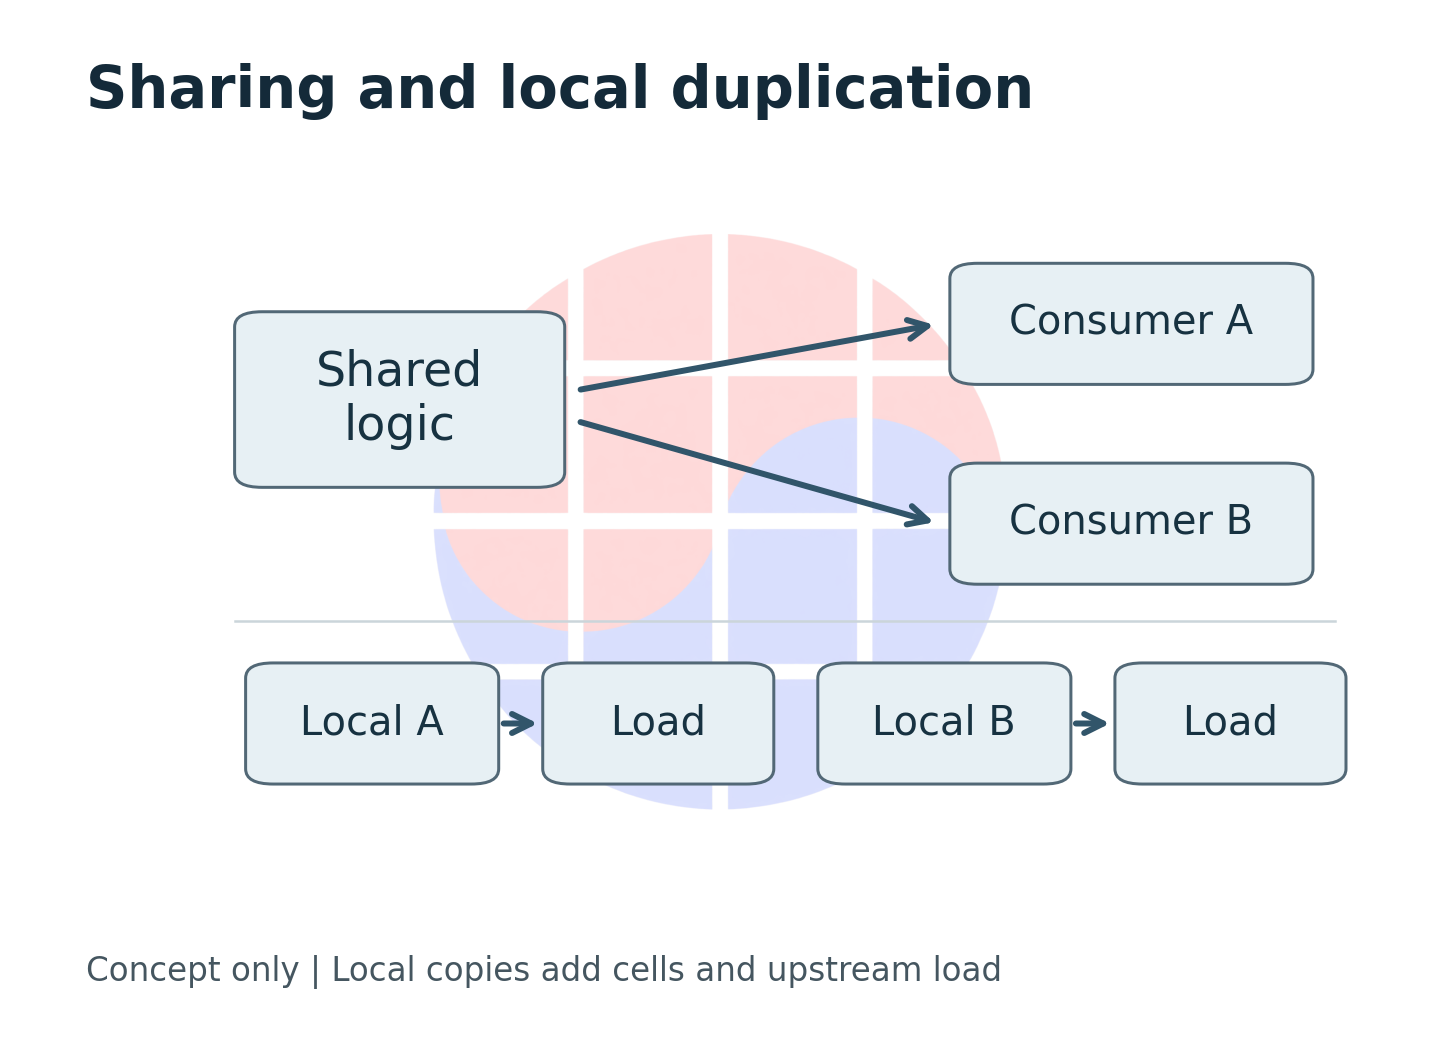
實作相同功能的元件,其驅動能力與輸入電容也不同。換成更強的元件,輸出側變好,前一級卻可能變慢。若只剪出時序報告中改善的區段來展示,就會錯過延遲只是移到其他區段的事實。
實務上也必須區分標準元件面積的減少與晶片面積的減少。即使標準元件面積總和減少,若已定好的核心大小或巨集佈局維持不變,晶粒大小不會自動變小。必須先就面積指標是元件總和還是佈局區域達成共識,才能詮釋效能與成本的交換。
| Change | Possible benefit | Cost to inspect |
|---|---|---|
| Share logic | Fewer cells | Fanout and long routes |
| Clone logic | More local loads | Area and upstream load |
| Upsize a cell | Stronger drive | Input capacitance and leakage |
| Insert buffers | Split a long load | Extra cells and hold effects |
這張表不是該先用哪個動作的排名。而是工程師在最佳化前後不應漏掉的比較軸。若特定路徑的延遲主要來自導線,反覆只換元件大小的方法改善空間可能很小;在壅塞的區域,放追加元件的空間本身就成為限制。
導線越具體化,判斷的依據也跟著改變
在佈局之前,以模型代替尚未確定的物理資訊。佈局完成後可以使用接腳位置,全域布線之後可以反映連接路徑與布線層資訊。OpenROAD 的寄生估計文件把這兩個估計階段分開提供。 Parasitics estimation
這裡的寄生成分是設計者並未以邏輯功能意圖、卻在導線上產生的電阻與電容。長度相同,不代表延遲相同。重要的是它經過哪一層、在哪裡分岔、遇到什麼負載。即使佈局座標很近,若路徑必須繞行,結果也會與直線距離的預期不同。
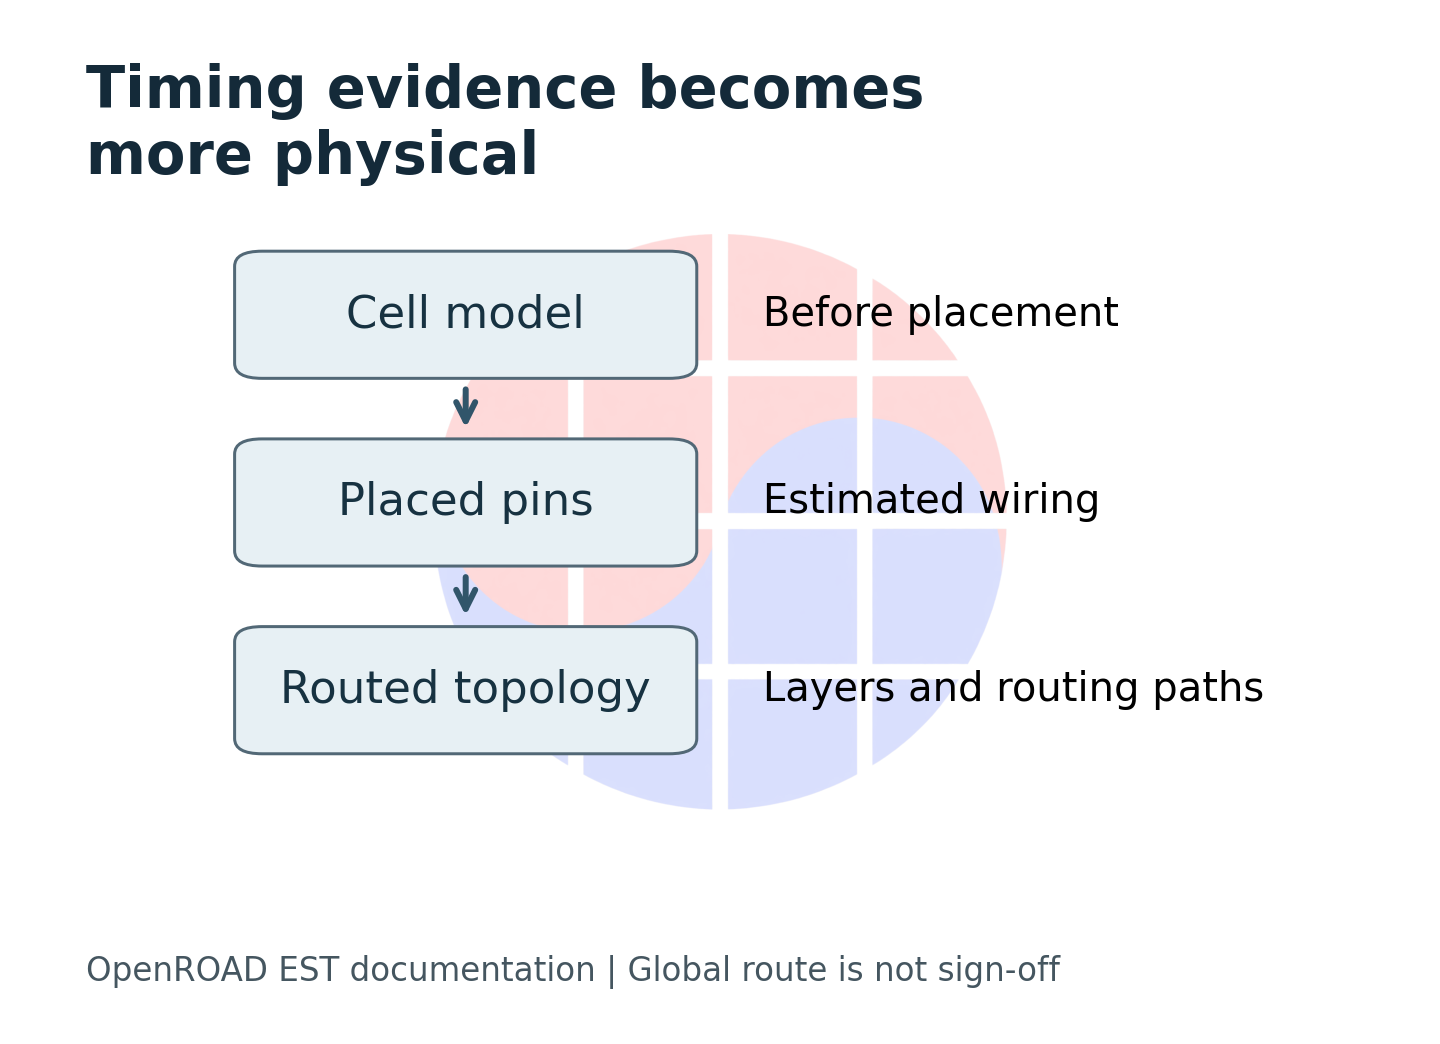
即使全域布線估計更具體,也不應直接稱它為最終擷取結果。比較表的數字旁邊,需要註明是在哪個實作階段、以什麼寄生模型量測的。若混用同一設計不同階段的值,最佳化效果與模型精度的變化就無法分離。
靜態時序分析,也就是 STA,會把時間約束結合到這個物理資訊上。OpenSTA 以包含元件特性的 Liberty、時間約束 SDC、包含布線寄生成分的 SPEF 等作為輸入。這些輸入角色不同,所以不能只因電路檔案相同,就認為時序比較條件也相同。 OpenSTA
| Evidence stage | What it can support | What it cannot establish alone |
|---|---|---|
| Cell-based estimate | Candidate screening | Routed timing closure |
| Placement estimate | Position-aware comparison | Final routing parasitics |
| Global-route estimate | Topology-aware evaluation | Final sign-off across corners |
| Final extracted analysis | A specified sign-off check | Unchecked modes or corners |
很容易以為只要固定時脈週期,比較就公平了。但若輸入延遲、輸出負載、時脈不確定性或例外路徑不同,同一條資料路徑的餘裕時間也會不同。團隊應接收的成果物,是變好的數字與產生那個數字的設定綁在一起的紀錄。
特別要避免把最初的合成估計與最後的布線估計相比來算改善率。應讓基準設計與候選設計從相同起始狀態各自走到底,再比較同一節點的報告。沒有這種實驗設計,加的演算法越複雜,就越難解釋原因。
超越換元件,重新選擇邏輯結構時
對於靠調整驅動能力與插入緩衝器解決不了的路徑,邏輯分解本身可能就是限制。此時重新映射會尋找以不同元件組合實作相同邏輯功能的候選。重點是,它不把整個電路重頭來過,而是處理與外部電路連接邊界維持不變的小區域。
📩 在持續關注這個主題嗎?
財報·報告·HBM供需的後續分析,每天10:30(KST)寄到您的信箱。 免費訂閱 →
前面介紹的研究中的 PCR,是反映周圍的到達時間與負載、導線估計來產生候選,並經過實際佈局布線評估後才接受的結構。它把在預測模型中看起來好的候選,與通過物理評估的候選分開。這個循環結構是該論文的方法論核心。 論文正文,方法與評估程序
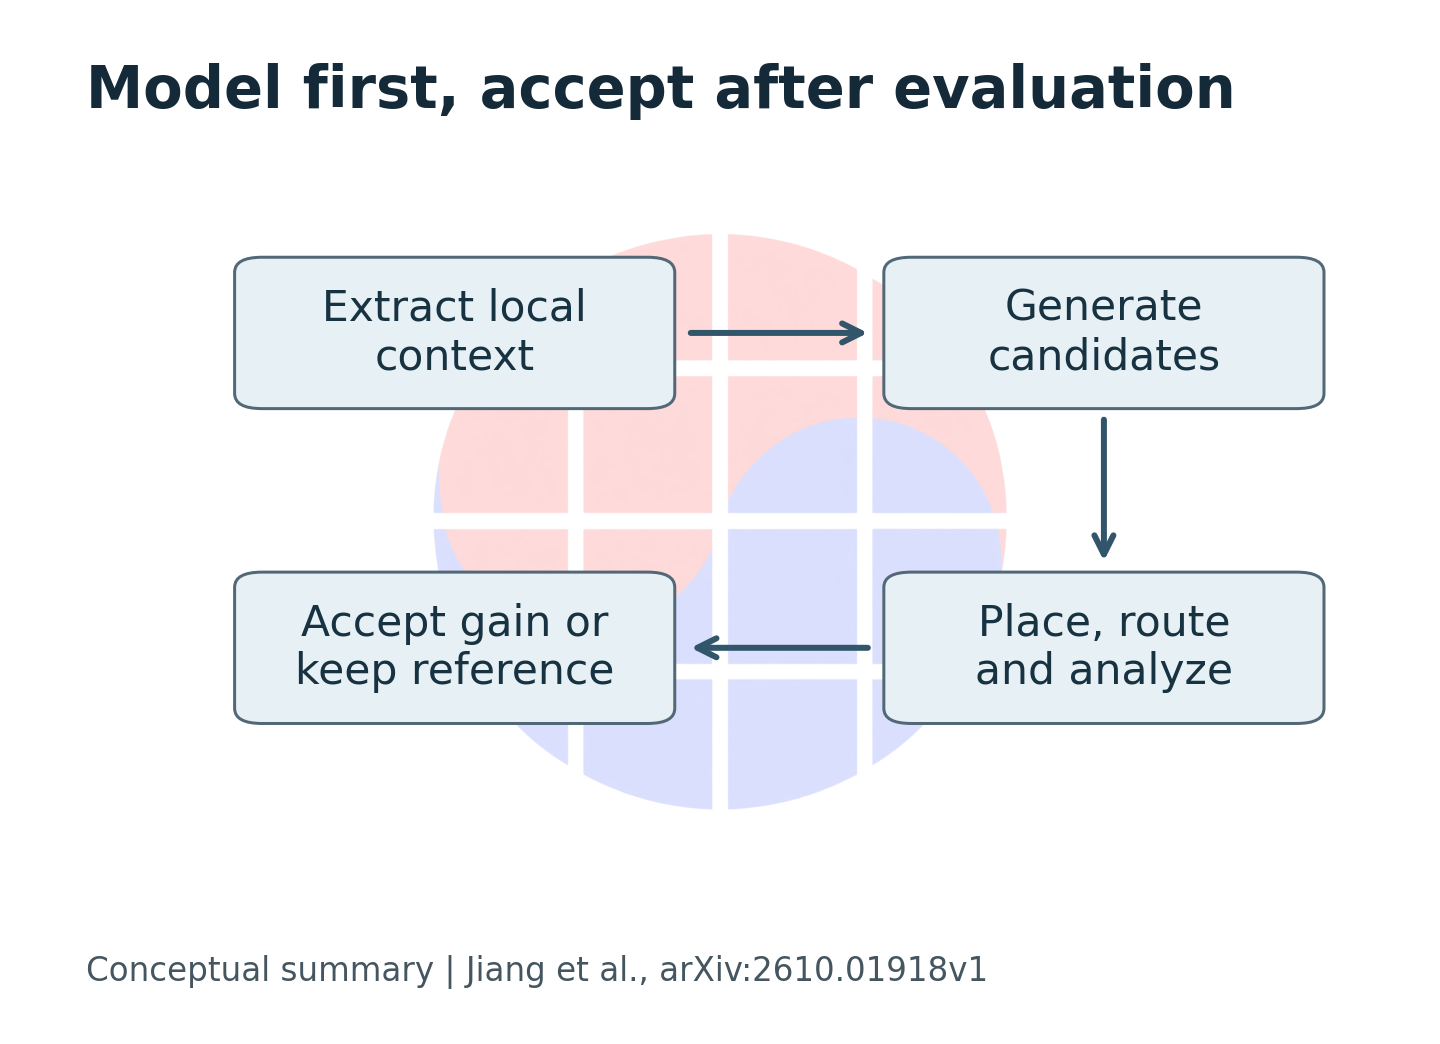
這個區分也適用於選工具的實務。候選產生器應該便宜地檢視大量選項,接受階段則應即使付出實作成本,也要過濾錯誤的改善。若對所有候選套用最昂貴的分析,探索成本會暴增;若只靠簡單預測就接受,之後階段要撤回的風險會增加。
把區域切小也不是免費的。切小可以減少運算量,卻會錯過邊界之外的重組機會。切大可以檢視更多邏輯選項,佈局變更範圍與執行時間卻會增加。設計團隊應把探索範圍與時間預算和結果數字一併記錄。
| Decision | Fast screening | Acceptance evidence |
|---|---|---|
| Timing | Estimated arrival | Matched physical analysis |
| Function | Candidate construction checks | Formal equivalence in the team flow |
| Feasibility | Search result | Legal placement and routing checks |
| Value | Predicted gain | Gain after downstream repair |
這張表中的形式等效驗證,是 VLSI Korea 對實務導入要求的標準,不是說該論文執行了所有商業驗證程序。功能相同的主張,與特定實作滿足時間約束的主張,需要不同的證據。不能把一方的成功當作另一方的替代證據。
團隊內部也必須分工。邏輯設計者確認意圖的功能與容許的轉換範圍,物理設計者確認佈局布線約束與寄生模型,驗證負責人確認等效性與時序例外的有效性。工具越自動產生候選,把這些邊界明示的接受條件就越重要。
如何從效能表中分離演算法的貢獻
論文的比較表中有一個容易錯過的註腳。在保留位置資訊的比較的 9 個案例中,實際接受重新映射變更的是 2 個。在另一個比較中,7 個案例全部維持了輸入映射。因此,不能把整張表的好結果全部詮釋為重新映射動作的直接效果。 論文 Table I·II 與結果分析
VLSI Korea view: 整個流程結果變好的證據,與特定最佳化造成那個改善的證據,必須分開要求。
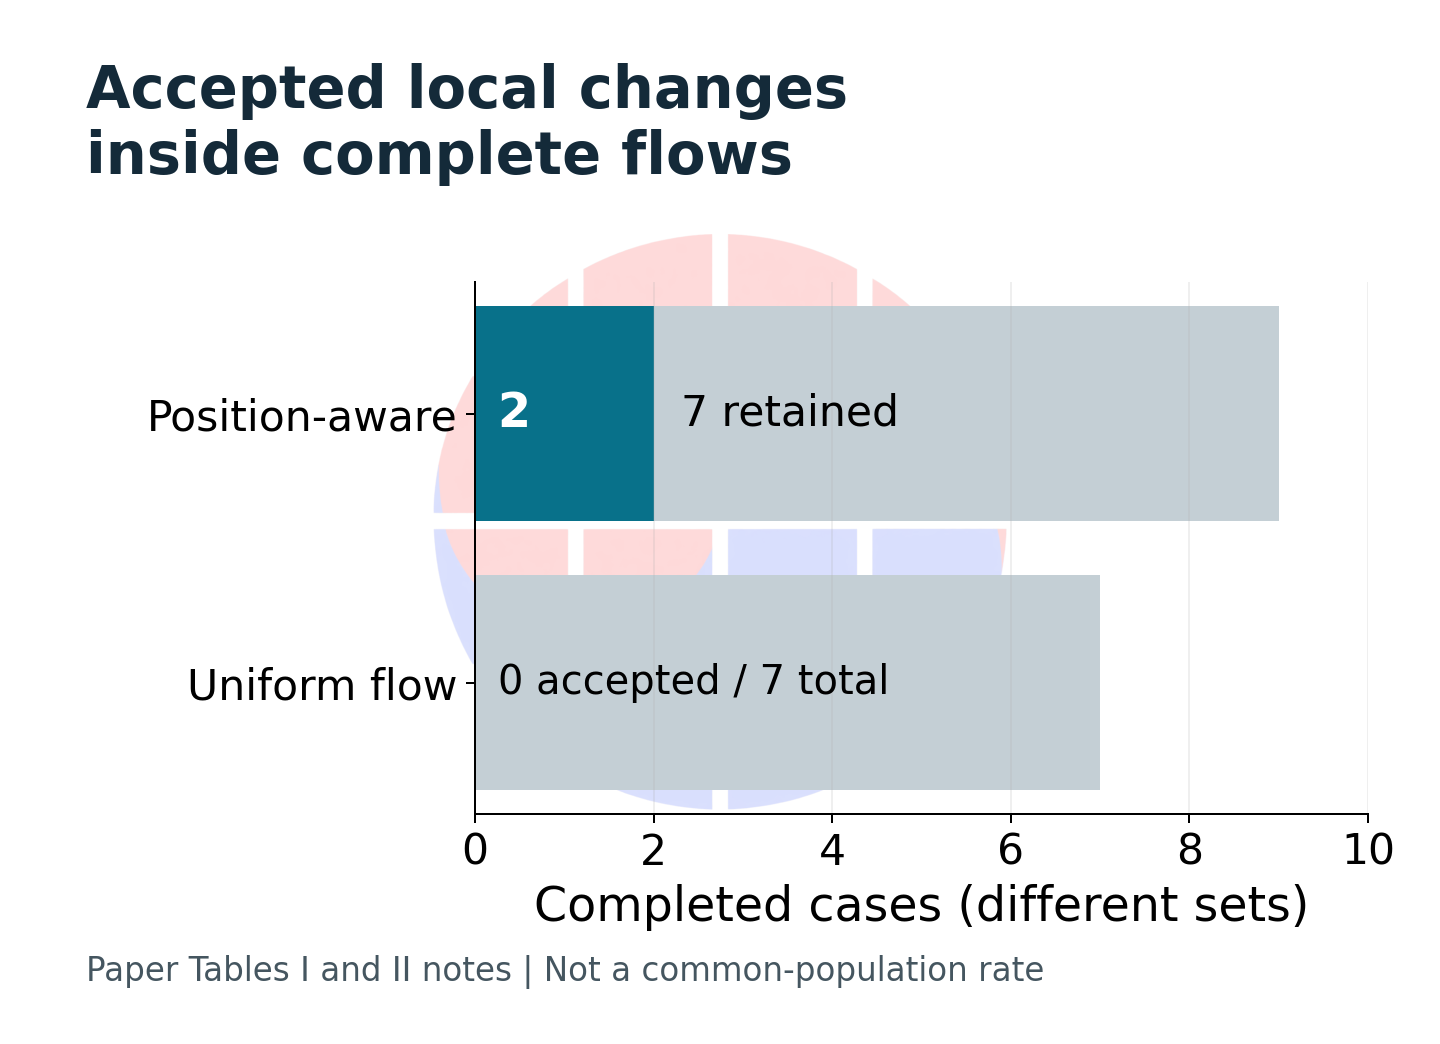
這個註腳並非消除研究的價值,而是讓問題更精確。當候選不佳時,保留既有實作的動作也有價值。不過,那個結果與「新邏輯快了多少」是不同的問題,必須一併看它把已好的基準設計守住了多少。
讀這類比較的讀者,應先確認基準線是什麼。是最初的電路、只套用相同後處理而無最佳化的狀態,還是競爭演算法的輸出,數字的意義會隨之不同。即使設計名稱相同,若後處理不同,也應當作不同的比較。
| Claim | Evidence needed |
|---|---|
| The complete flow improves timing | Matched end-to-end runs |
| Remapping itself causes the gain | Same-flow ablation with and without remapping |
| The method generalizes | Broader cases, corners and repeatable settings |
| The result is production-ready | Full project sign-off and integration evidence |
另外,WNS 是最差的負餘裕時間,TNS 是看違規累積大小的指標。即使最差路徑變好,多個其他端點的違規也可能變大,所以兩者要一起看。若未確認哪份報告使用哪種路徑、端點彙總,就先比較不同工具的總和,意義不大。
編輯建議很簡單。在與競爭技法比較的最終數字旁邊,要求在自家流程中只關掉該最佳化的實驗。若沒有那個實驗,就降低導入判斷的可信度,轉向小規模內部評估即可。不要以估計填補缺漏的實驗,也不要把基準的優勢換成商業晶片的效能提升。
韓國設計團隊應從什麼開始比較
若韓國國內的無廠半導體公司、設計服務組織與大學研究室要評估公開工具的技法,首先要做的是同條件的小型基準實驗。沒有必要把實際客戶的未公開設計放進外部服務。以有使用權限的內部環境或公開範例定出評估範圍,並在單一瓶頸路徑追蹤變更原因,會更好。
VLSI Korea 建議的紀錄單位是輸入版本、約束、元件庫識別碼、物理評估階段、工具設定與結果。這不是要分享元件庫或製程資料本身。只要在團隊內部能再次找到相同條件,留下經批准的識別資訊即可。
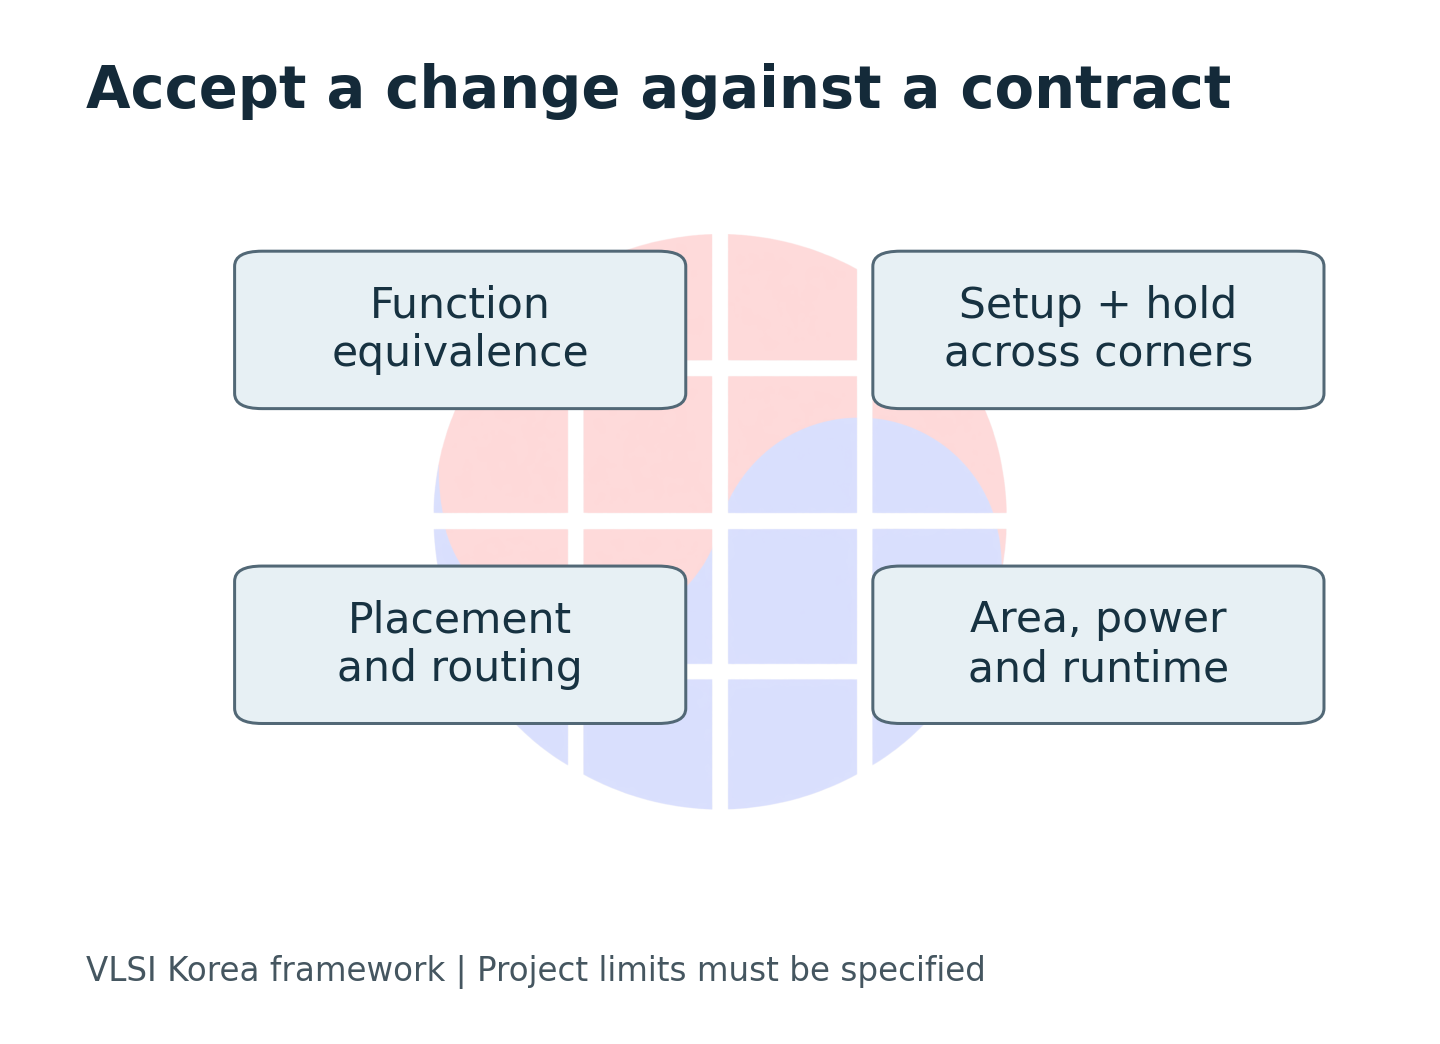
接著在同一條路徑上比較最佳化前後的元件延遲與導線延遲、負載、轉換時間。若路徑改變了,同時留下舊的最差路徑與新的最差路徑。若只保存新變好的路徑,很容易誤以為瓶頸移動就是整個問題的解決。
時序修正也必須一併看 setup 與 hold。把資料送得更快,對 setup 有幫助,但到達太早可能造成 hold 問題。OpenROAD 文件也區分 setup 與 hold 的修正,並處理其順序與相互影響。 Gate Resizer
| Keep fixed | Compare | Reject or investigate |
|---|---|---|
| Modes and corners | Setup and hold | A new failing corner |
| Constraints and exceptions | WNS and TNS | Improvement from relaxed constraints |
| Starting physical state | Cell and wire delay | Unmatched evaluation stages |
| Tool and resource budget | Runtime and accepted changes | Hidden repair or search costs |
面積與功率是另外一張價目表。若複製元件換到了時間,就必須確認那個追加成本是否在容許範圍內。不能只憑漏電功率數字就斷定動態功率也改善了,還需要實際活動率與功率分析條件。若不定出效能、功率、面積哪個軸優先,工具結果就會代替團隊決定目標。
通往矽晶的工具,接著要看的證據
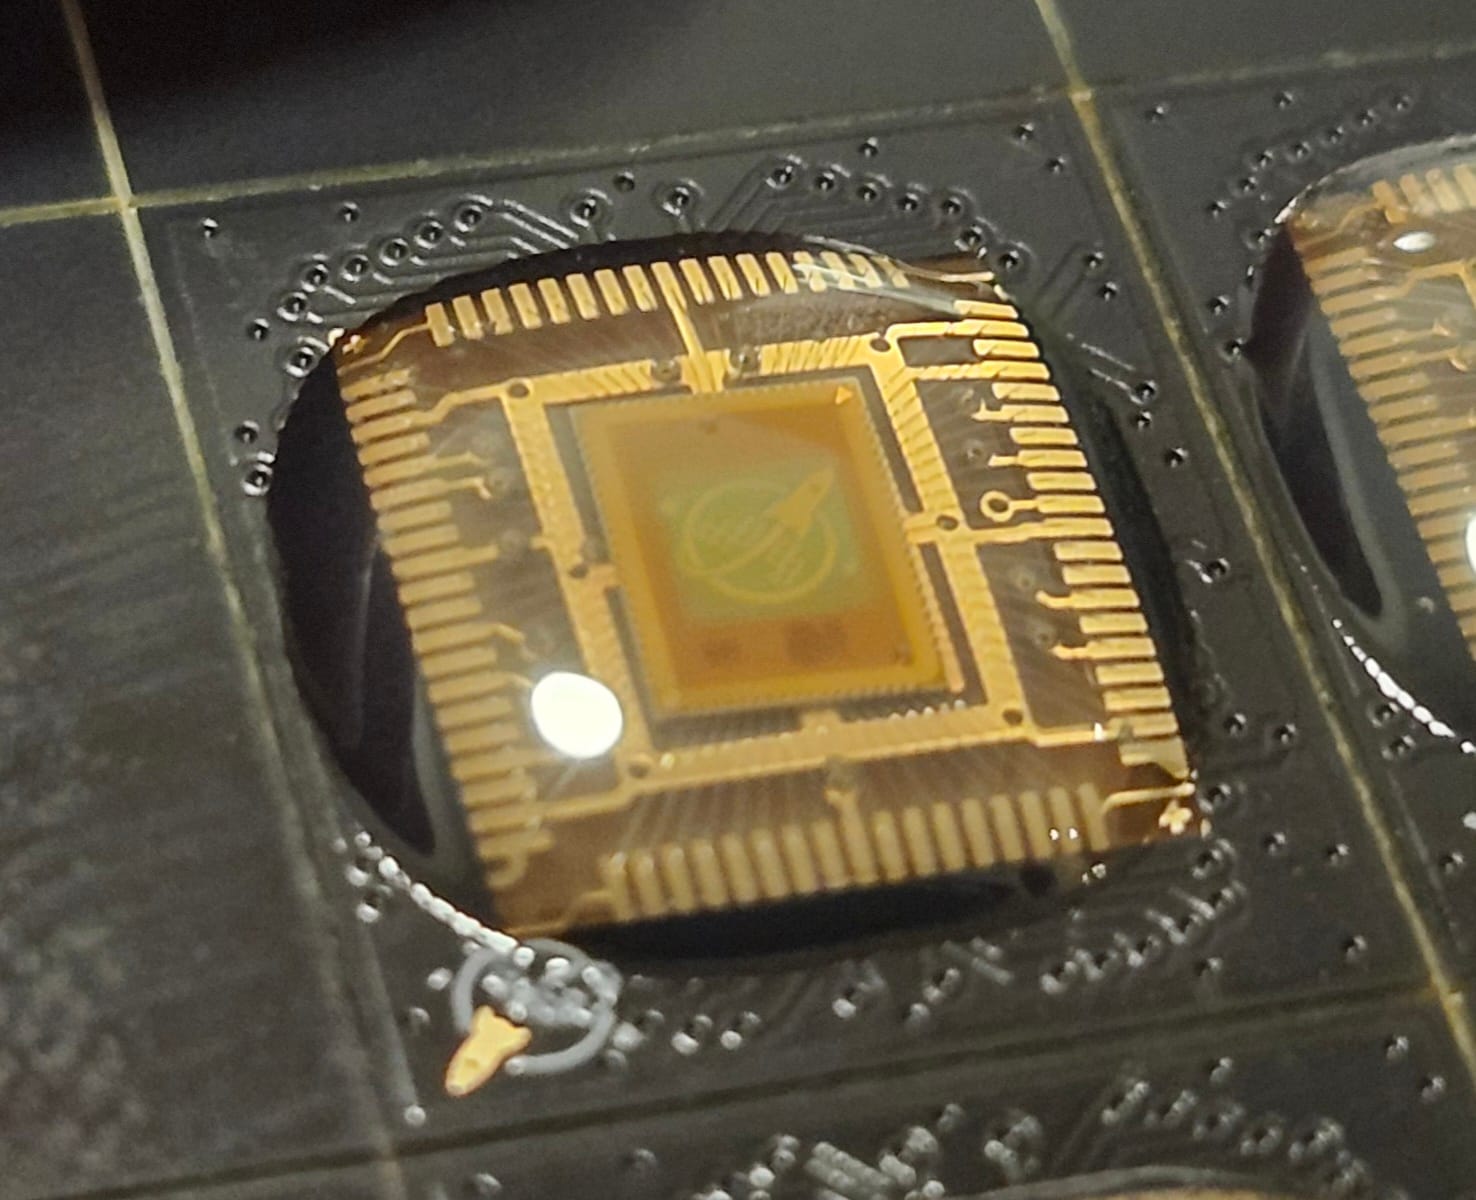
這個討論不只停留在教育用邏輯圖上。OpenROAD 在公開生態系頁面把 Tiny Tapeout 與 wafer.space 介紹為通往實體晶片的路徑。wafer.space 在官方儲存庫公開了 Run 1 的實際 chip-on-board 零件照片。這個案例展示設計工具與實物的連結,照片不是拿來當作 PCR 效能的實測證據。 OpenROAD 生態系 · wafer.space 原始資料
未來 6–12 個月要關注的不是最大的單一改善率。重要的是同一流程開關重新映射的比較、實際接受的變更數量與位置、在更廣設計與 corner 的重現性,以及包含執行時間的資料是否增加。若有這種資料,就能把模型的想法連結到團隊的導入依據。
反之,若效益在詳細布線或其他運作條件下消失,或面積、功率成本超過團隊的容許值,就必須縮小採用範圍。這就是改變本文判斷的條件。時序最佳化的成敗,不由最短的邏輯式決定,而是由在協議條件下實際留下的餘裕時間與其代價決定。
Sources and scope
已確認原文全篇的方法、表格與註腳的 PCR v1 是預印本,本文未將其視為已確認學會採納或矽晶量測。OpenROAD 與 OpenSTA 文件是工具動作的依據,不是獨立的 PCR 效能重現實驗。計算與圖表為說明用自行製作。
- Jiang et al., Timing-Driven Logic Remapping with Local Physical Context
- OpenROAD Gate Resizer
- OpenROAD Parasitics estimation
- Parallax OpenSTA project documentation
- OpenROAD ecosystem
- wafer.space Chip-on-Board Wire-Bonded PCBs
📩 今天錯過的分析,明天早上寄到您的信箱
每天10:30(KST)Daily Silicon與財報·機構報告核心解讀搶先送達。訂閱後可選擇韓語/英語/日語新聞通訊,中文深度分析每日在網站更新。
免費訂閱 →
免費 · 無垃圾郵件 · 隨時退訂