VLSI Korea
INT8 加速器的精確度在乘法之後分出高下
若 scale、捨入與飽和規則對不齊,同一個量化模型也會給出不同的答案。本文整理 RISC-V 與 FPGA 設計者應先驗證的輸出路徑。


🆓 免費文章 · 任何人都可以免費閱讀
把 INT8 模型放上加速器後精確度掉了,在擴大乘法器之前,應先確認把累加結果轉換為下一層整數的路徑。即使輸入位元數相同,若每通道的 scale、zero-point、捨入順序不同,下一層收到的值也會不同。
本文說明 RTL 設計者必須保存哪些算術動作,以及模型部署負責人應從哪個階段開始追蹤誤差。焦點在於,縮減電路時要維持的功能,以及在重新訓練模型之前要比較的基準輸出。
VLSI Korea view: 比起是否支援 INT8,更重要的是模型轉換器與加速器是否執行相同的整數運算規則。面積節省應在確認那個一致性之後再評估。
同一個「INT8」用語中缺少的資訊
照片中的裝置是 ztachip 官方指南刊載的 Digilent Arty A7-100T 與相機、VGA 連接配置。ztachip 是同時提供 RISC-V 架構加速器與軟體的公開專案,在把模型放上實際電路板的過程中,轉換器與電路之間的約定左右了能否運作。 ztachip 專案、官方電路板配置
此時提出這個問題的契機,是 2026 年 10 月 1 日提交的 ZTA-Q 預印本。作者在以 ztachip 擴展的 Arty A7-100T 實作中,一併處理了每通道重新量化與捨入,並報告在所比較的近似中,拿掉 shift 捨入時數值誤差大幅增加。詮釋資料中的 ICECS 2026 採納標示是作者申報,不是說這是今天新發表的結果。 ZTA-Q 原文與提交紀錄
這裡的重新量化,是把寬的累加值恢復為下一個運算能接受的低位元數整數的過程。即使乘法與加法都正確,輸出也可能在這最後的轉換中改變,所以不能只憑 MAC 的一致判定整個加速器的正確性。
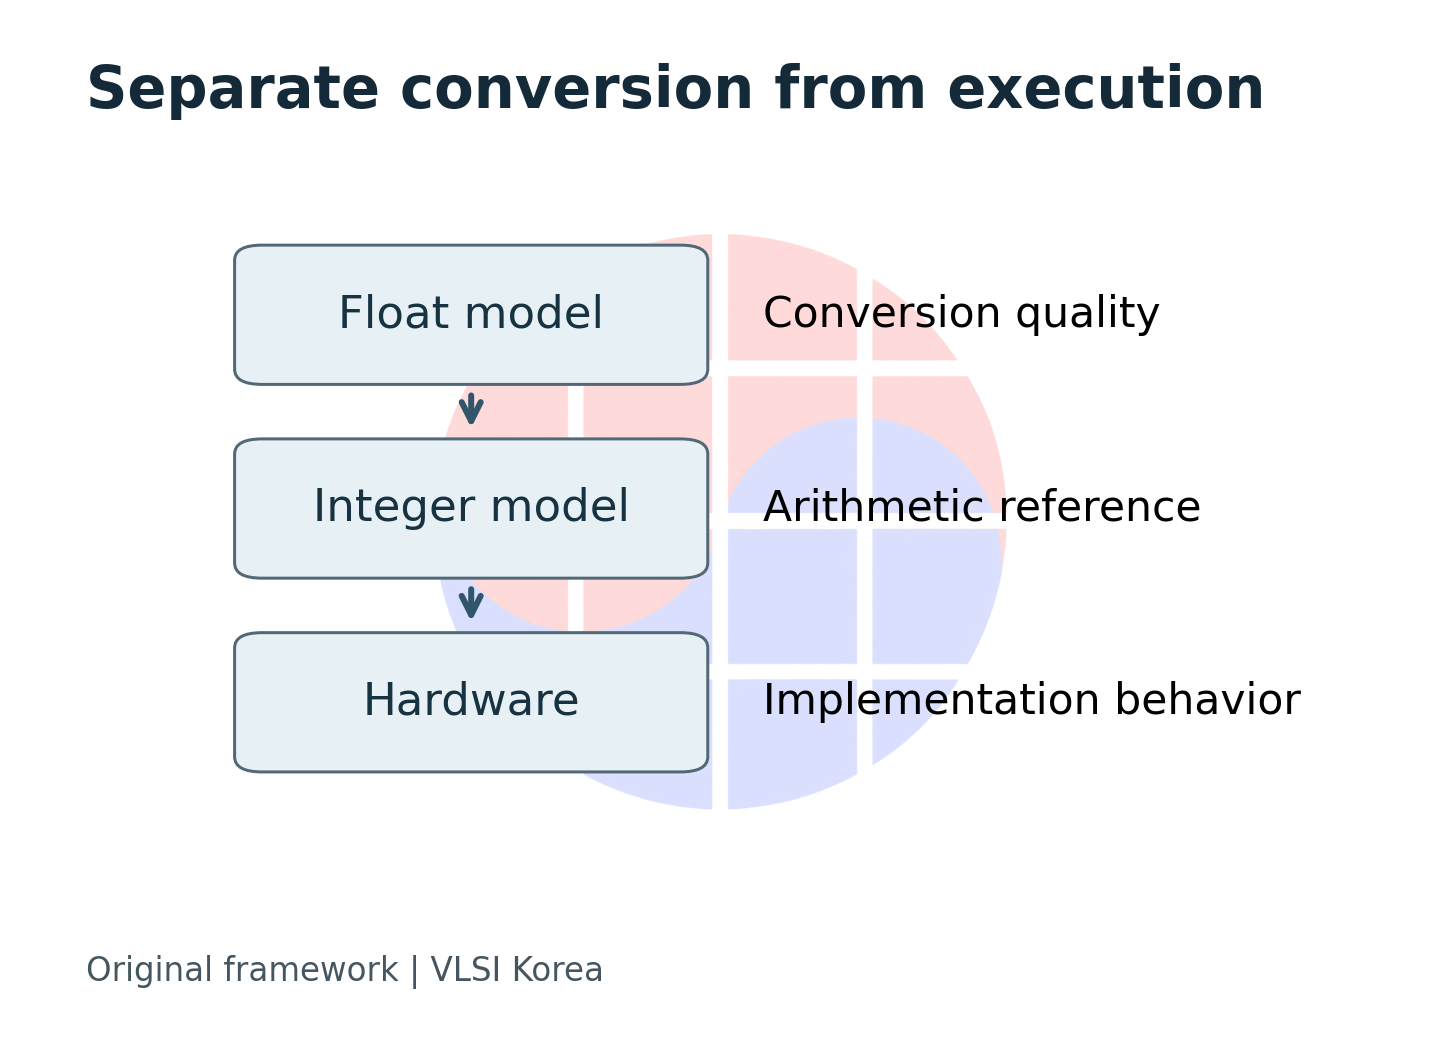
| Boundary | Question | Evidence to retain |
|---|---|---|
| Float to integer model | Did conversion change the task result? | Calibration inputs and integer model |
| Integer model to hardware | Did implementation change the arithmetic? | Layer outputs and operator parameters |
| Hardware to application | Does the deployed result meet the product need? | Accuracy, latency and power conditions |
這個區分讓我們能對症修正。若整數基準模型就已錯失目標精確度,應檢視資料與轉換方式;若整數基準通過、只有電路板上錯,則應先檢視運算映射與實作。
若模型團隊重新訓練、硬體團隊增加位元數同時開始,就難以知道哪個變更解決了問題。先找到失敗開始的邊界,能提高下一個實驗的解釋力。
整數碼附著單位與零點
整數碼 q 所表示的實數可以想成 x = s × (q − z)。s 是碼之間間隔的 scale,z 是對應實數值零的整數碼。LiteRT 的 INT8 規格允許卷積權重使用每通道 scale,並對權重 zero-point 與活化值 zero-point 施加不同的限制。 Google LiteRT 規格
Scale 不同,同一個碼也表示不同的大小。因此儲存卷積結果時,必須把以輸入與權重單位累積的累加值換成輸出單位,若每個輸出通道的權重 scale 不同,轉換係數也會不同。
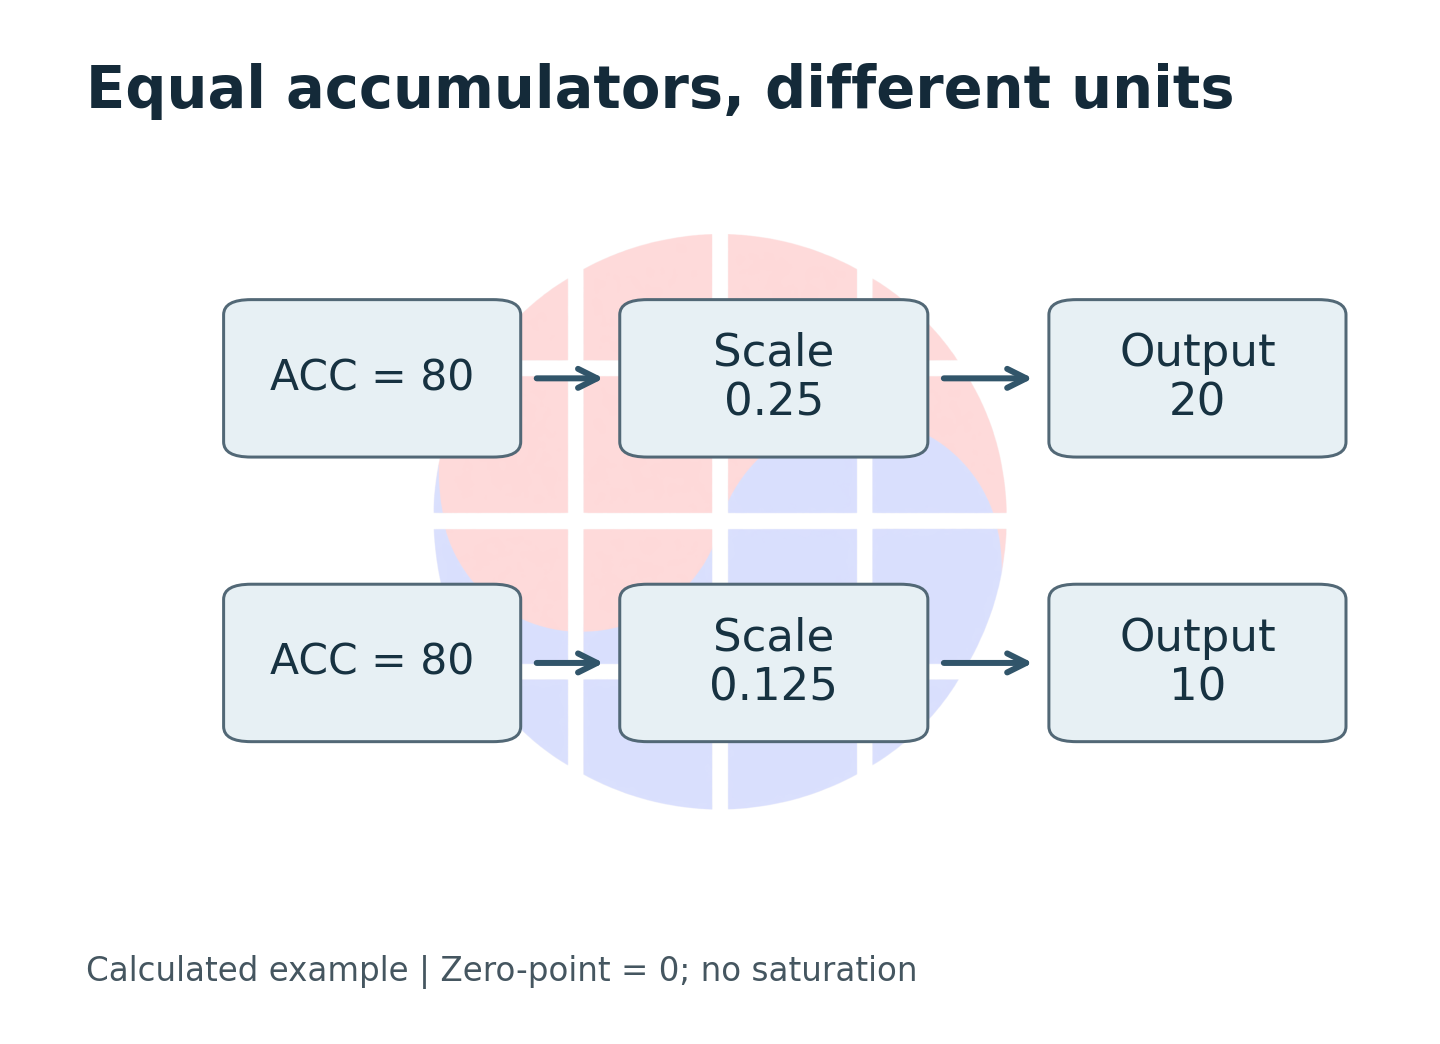
在圖的範例中,累加值 80 乘上有效 scale 0.25 是 20,乘上 0.125 是 10。這不是實際神經網路的量測值,而是只分離單位轉換的計算,顯示了把同一個 shift 或係數套用到所有通道的最佳化為什麼需要另外驗證。
只憑從記憶體讀到了係數這個事實,不能說用了正確的係數。把通道綁在一起或改變 tile 順序的編譯器,必須把權重與該通道的係數以相同順序一併搬移。
| Parameter | Meaning | A useful failure probe |
|---|---|---|
| Scale | Real-value step per integer code | Adjacent channels with different scales |
| Zero-point | Integer code representing real zero | Padded border and zero-valued input |
| Channel axis | Dimension indexed by scale values | Channel permutation with matching metadata |
| Output range | Codes the next operator can receive | Values just inside and outside the limits |
Zero-point 在 padding 中也會顯露。若在應該填實數零的邊界無條件寫入整數碼零,在 z 不為零的模型中,就等於輸入了不同的值。gemmlowp 的設計文件說明,精確表示實數零的條件是量化算術的出發點。 gemmlowp 算術說明
設計者應得到的產出物,比「支援 INT8 卷積」這一句更具體。必須有固定輸入、權重、輸出各自的 scale 與 zero-point、通道軸、bias 單位的運算規格,才能把同一個模型放進兩個實作中比較。
被丟棄的位元改變下一層的輸入
重新量化係數在電路中可以以整數乘法與 shift 的組合實作。此時如何處理被丟棄的低位元、在哪個點捨入中間結果,都是計算的一部分。gemmlowp 在寬累加器之後設置了獨立的輸出管線來表達這種轉換。 gemmlowp 輸出路徑
NVIDIA TensorRT 的 INT8 量化定義中,明示了捨入到最近整數、恰好在中間時選偶數的規則。這不代表所有 runtime 都有相同的細部動作,而是在確認要導入模型的基準運算時可檢視的項目範例。 TensorRT 量化定義
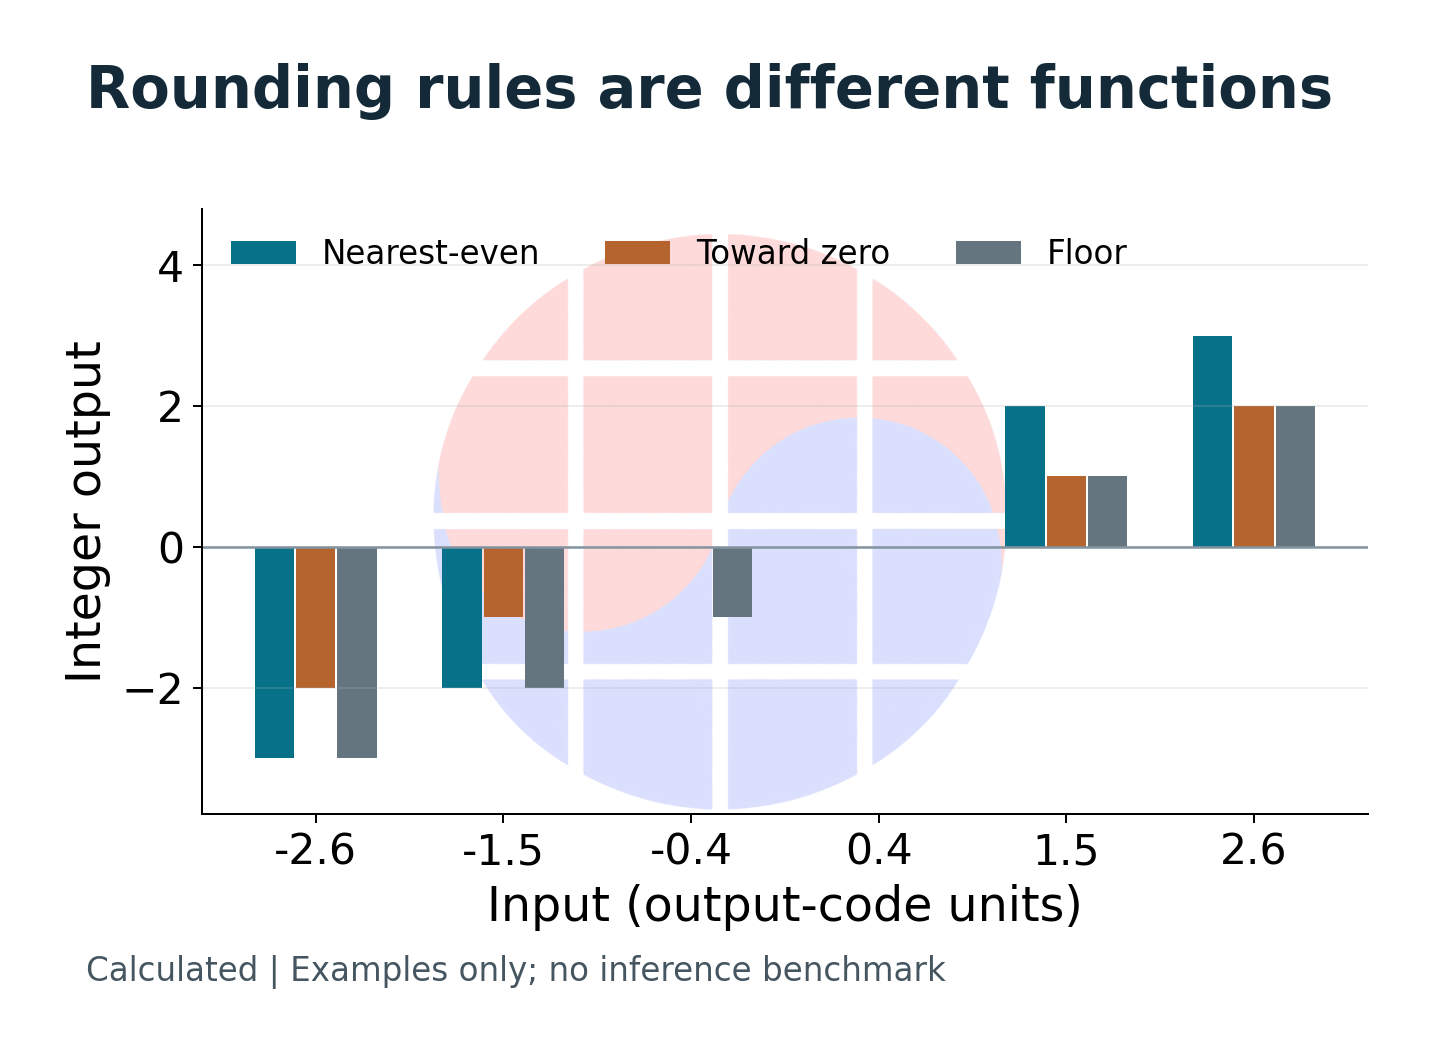
舉例來說,1.5 在偶數側最近捨入中是 2,在向零捨去中是 1。−1.5 分別是 −2 與 −1,所以只確認正數的測試會錯過負數動作的差異。
對有號整數做算術右移的動作,也必須與向零捨去區分。在有被丟棄部分的負數中,會產生朝 floor 方向下降的結果,若把符號擴展與捨入校正混在一起實作,可能做出正數正確、負數錯誤的缺陷。
驗證的邊界: 位元單位的不一致是尋找原因的訊號。不能把其本身換算成最終分類精確度相同大小的下降。
一個輸出碼的差異經過下一層會消失還是放大,取決於模型與輸入。實作的正確性應以逐層數值比較確認,對產品的影響應以整個模型的任務指標確認。
套用兩次捨入的路徑,與保持寬中間值後套用一次的路徑,一般而言也不是同一個運算。設計規格中除了最終捨入的名稱,還必須寫明中間位寬、運算順序與飽和點,電路與參考程式碼才能測試同一個對象。
📩 在持續關注這個主題嗎?
財報·報告·HBM供需的後續分析,每天10:30(KST)寄到您的信箱。 免費訂閱 →
狹窄輸出的成本該在哪裡付出
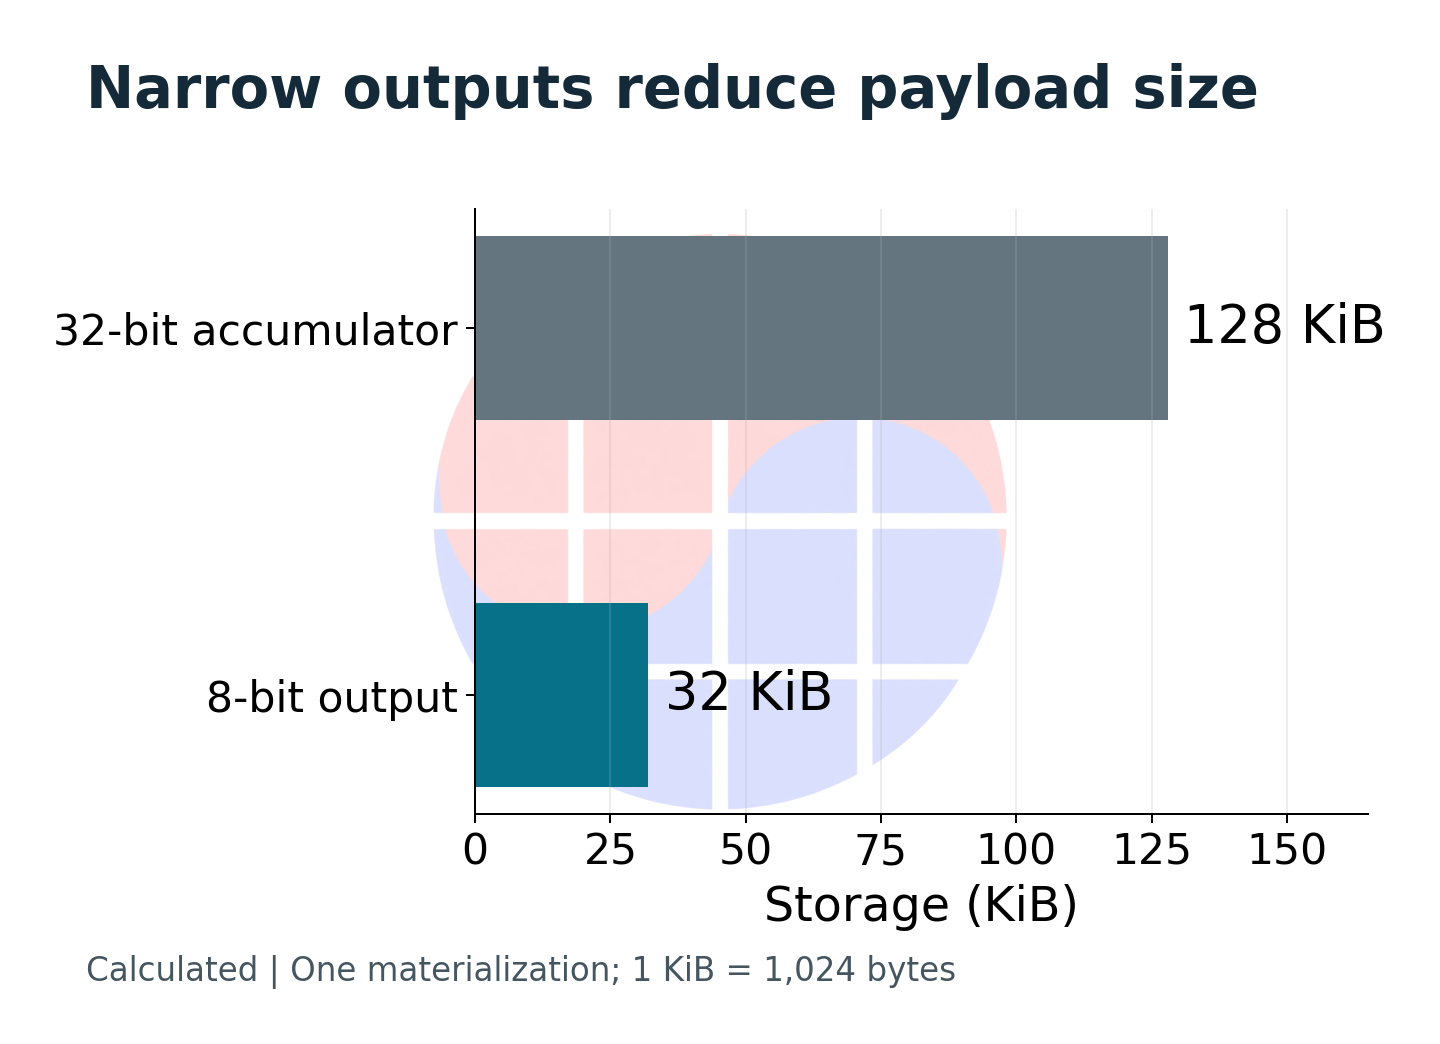
重新量化不只是精確度的問題。依把寬累加值送到記憶體後再由 CPU 縮減,還是在加速器內改成低位元數後送出,儲存空間與傳輸量會不同。
假設的輸出張量有 32,768 個值,每個值以 32 位元儲存是 128 KiB,以 8 位元儲存是 32 KiB。這個計算只算值本身的大小,不包含詮釋資料、對齊 padding、讀寫的重複。
在輸出路徑多放電路,就有機會縮短寬中間值移動的距離。反之,要給每個通道供應不同的係數與 shift,就需要暫存器、布線與控制,所以不能把儲存量比例直接讀成功率節省率。
這個部分的設計選擇,比「乘法器用得少就好」有更多條件。若多個輸出共用一個轉換器,可以減少電路,但當跟不上輸出產生速度時,緩衝器會滿、運算器會等待。
| Choice | Potential benefit | Condition to measure |
|---|---|---|
| Convert near the accumulator | Move narrower outputs | Added datapath area and timing |
| Share a conversion unit | Reuse arithmetic resources | Service rate and queue occupancy |
| Process on the CPU | Reuse software arithmetic | Transfer cost and end-to-end latency |
三個選擇的優劣依模型而變。對輸出稀疏的運算,共用電路可能足夠;對輸出連續的運算,後處理的處理率可能成為瓶頸。
因此必須在相同的輸入集與執行條件下,一併比較精確度、延遲時間與資源使用。圖中的儲存量計算是決定要量測哪條路徑的出發點,不代替特定 FPGA 或 ASIC 的面積、功率結果。
找出第一個偏離的層
診斷從保存浮點基準模型、整數基準模型、硬體輸出這三組開始。第一個比較分離模型轉換的影響,第二個比較分離實作那個整數運算方式的影響。
ONNX Runtime 提供把權重與中間活化值對應起來比較的除錯工具。文件建議把前處理與量化階段分開處理,因為圖最佳化可能打亂對應關係。 ONNX Runtime 量化除錯
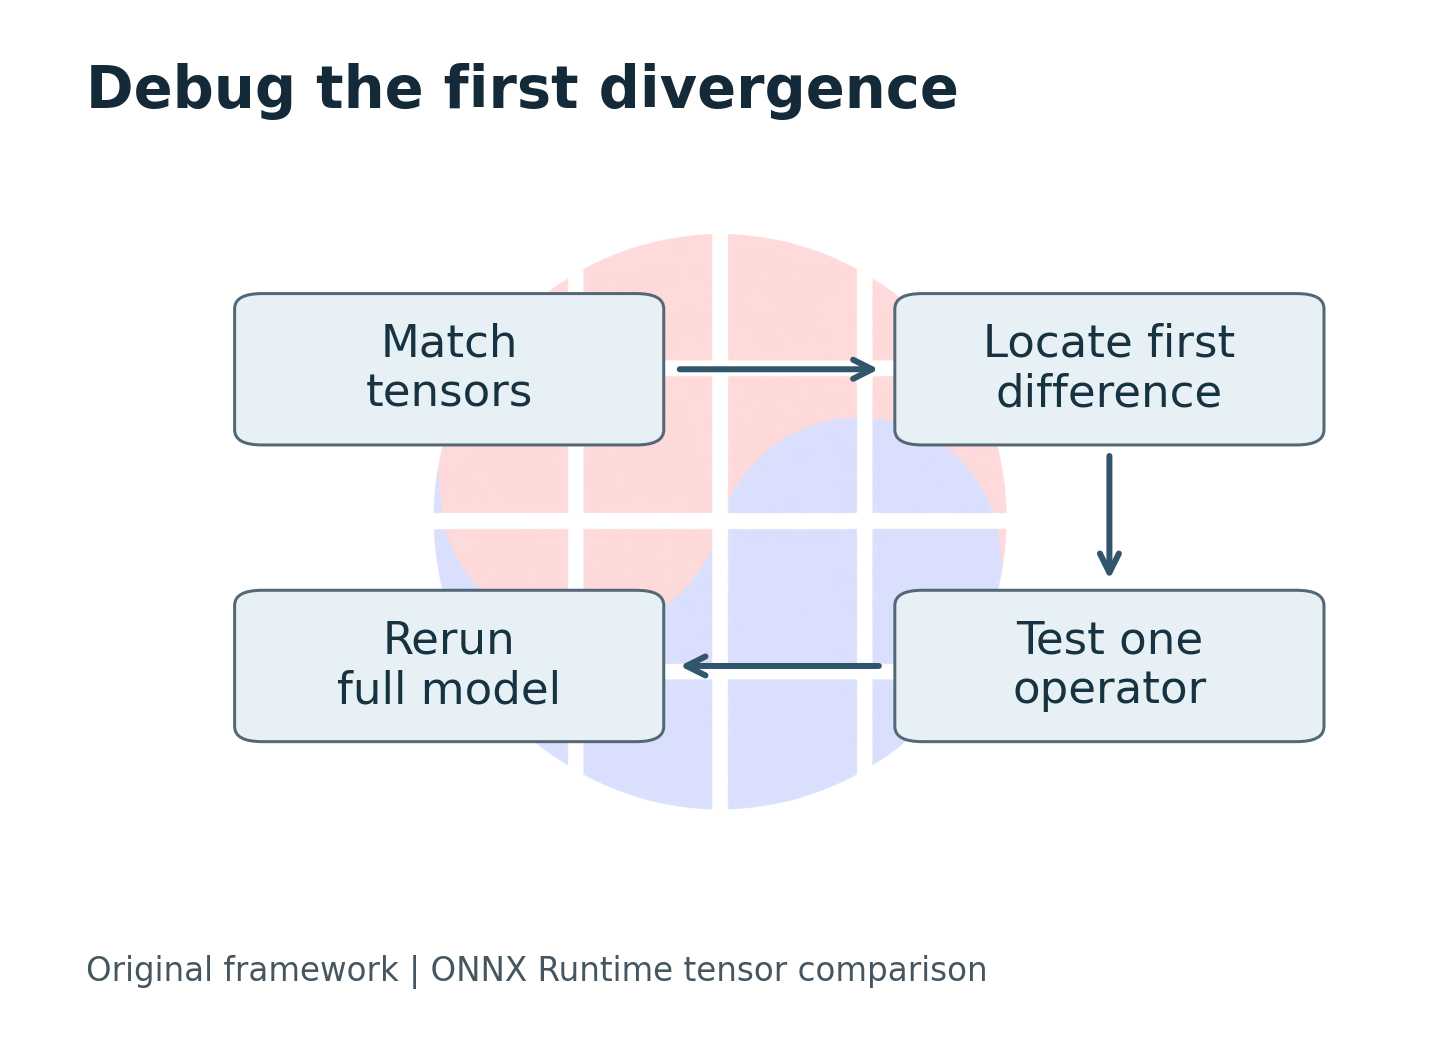
當層輸出不同時,不要只看平均誤差,也要看位置。整個通道以相似比例偏離、只在影像邊緣出現差異、只在負數與飽和附近出問題,是設計不同實驗的線索。
這個模式不是確定原因的公式。而是確認以修正通道係數順序的小變更問題是否消失,以及把相同輸入放進參考運算與 RTL 時差異是否重現的出發點。
| Probe | What it isolates | Keep constant |
|---|---|---|
| Positive and negative half steps | Tie rule and sign handling | Scale and operation order |
| Values around saturation | Clamp boundary and overflow | Output type and activation |
| Different neighboring scales | Channel-to-coefficient mapping | Tensor layout and tile order |
| Border-only inputs | Padding and zero-point treatment | Shape, stride and padding mode |
小型運算測試正確之後,必須回到實際模型。在單一層吻合良好的實作,經過運算融合、張量重新配置、不支援運算的替代路徑後,也可能產生不同結果。
連同整體精確度數字,留下評估資料識別碼、前處理、模型檔案雜湊、runtime 與編譯器版本,就能說明變更前後的差異。若缺了這個紀錄,即使精確度變好,也難以區分是電路修正的效果還是輸入管線變更的效果。
確認相容性後再選擇近似
量化硬體的實務目標,不是在所有情況下都以盡可能寬的方式計算。而是在滿足產品要求的任務精確度與延遲時間的範圍內,降低儲存、傳輸與計算成本。
RTL 負責人先做出與基準運算一致的路徑,就能把想縮減的功能分離為個別變更。模型負責人以相同資料比較逐層誤差與最終任務指標,就能判斷哪個變更超出容許範圍。
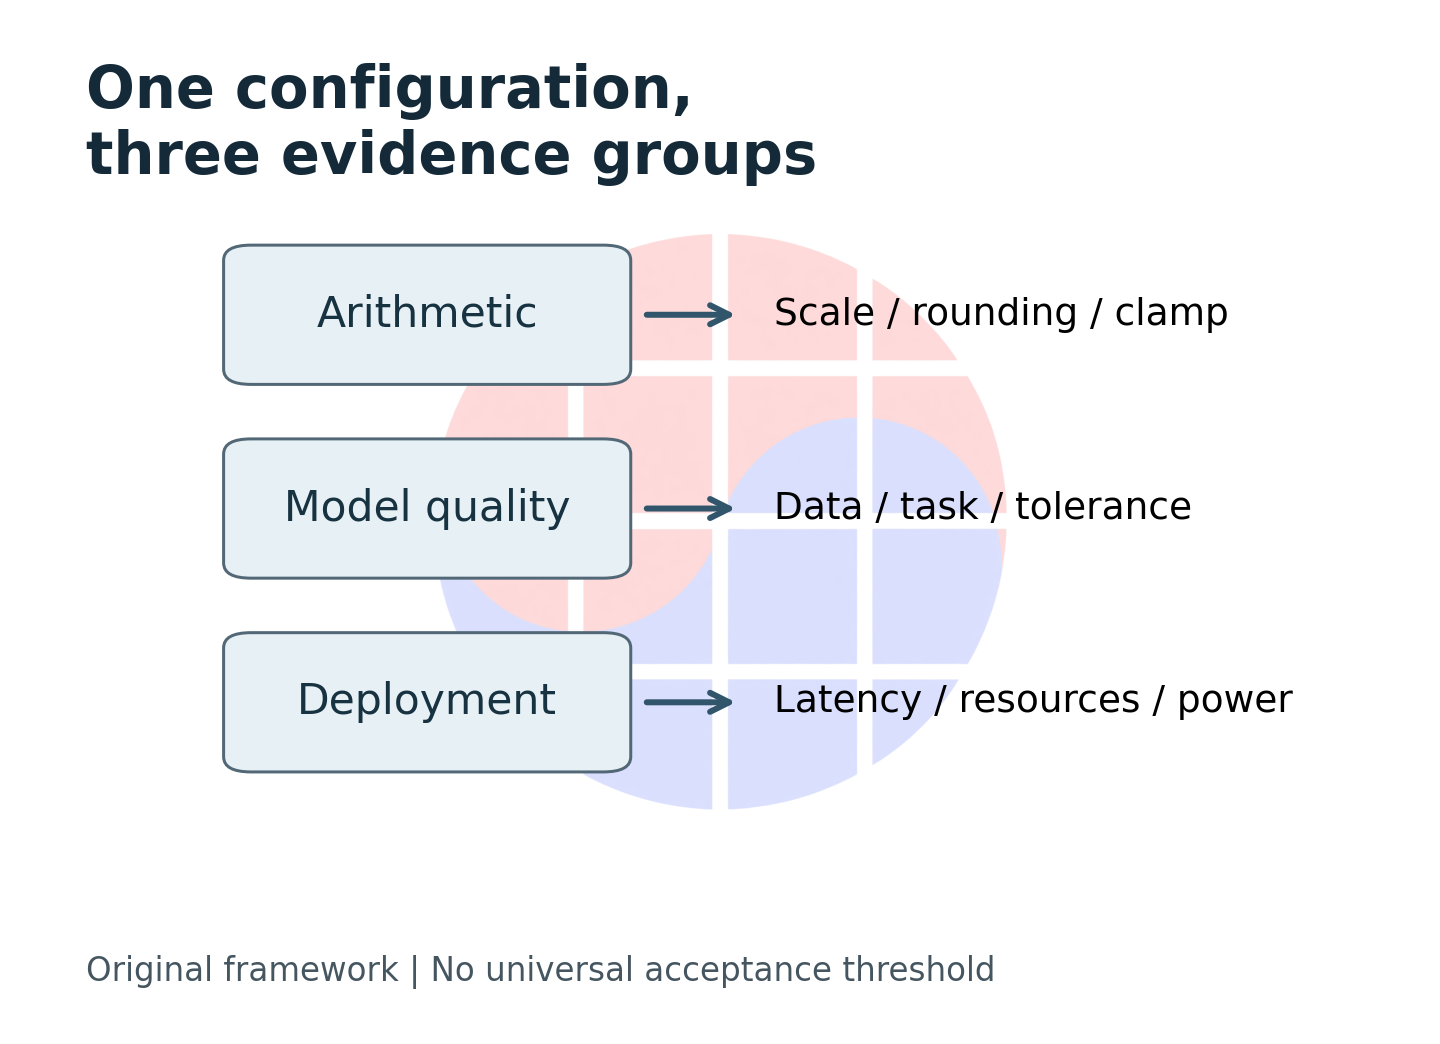
若是留有容許誤差的實作,那個容許範圍必須在評估之前定出。若在看到結果之後拿掉不利的類別或輸入,就無法說明模型的穩健性,也可能以平均精確度相同為由,掩蓋稀有輸入的大失敗。
與供應商或 IP 團隊討論時,同樣的原則也有效。除了支援位元數與運算清單之外,再要求轉換器版本、捨入與飽和動作、逐層比較資料、整個模型的執行條件,就能更具體地判斷實際整合成本。
改變本文判斷的條件很明確。若要部署的模型以更簡單的輸出算術也反覆滿足事先定出的品質基準,且那個實作改善了實際資源或延遲時間,那個近似就是合理的選擇。
在那之前,不要把精確度下降含糊地綁成「量化損失」比較好。必須能說明把哪個整數值傳給下一層,才能選擇把那個值做得更便宜的設計。
Sources and scope
ZTA-Q 是已確認全篇 HTML 原文的預印本,未執行獨立重現。照片是基礎專案 ztachip 的官方配置,不是拍攝 ZTA-Q 作者實驗裝置的照片。計算圖是依明示假設的自行範例。
- ZTA-Q, v1: 2026-10-01
- Google LiteRT: INT8 quantization specification
- Google gemmlowp: quantization arithmetic
- ONNX Runtime: quantization and debugging
- NVIDIA TensorRT: quantization schemes
- ztachip: official hardware setup
AI assistance: AI 用於資料整理、翻譯與圖表製作。事實與原文的對照及編輯判斷是另外的檢視對象。
Disclosure
本文僅供資訊之用,不構成買入或賣出任何特定證券的建議。本文所含數字與事實係以企業公告、媒體報導、市場調查等公開可得資料為基礎撰寫,該等資料或撰寫過程中可能發生錯誤。作者可能持有文中提及企業的股票。所有投資決定及其結果由讀者自行負責。
📩 今天錯過的分析,明天早上寄到您的信箱
每天10:30(KST)Daily Silicon與財報·機構報告核心解讀搶先送達。訂閱後可選擇韓語/英語/日語新聞通訊,中文深度分析每日在網站更新。
免費訂閱 →
免費 · 無垃圾郵件 · 隨時退訂