VLSI Korea
TLB 預取:未命中減少了,記憶體卻可能更忙
預先讀取位址轉換的設計,其損益取決於準確度、到達時點與追加流量。本文以自行計算的範例,整理 MMU 與平台團隊的判斷標準。


🆓 免費文章 · 任何人都可以免費閱讀
TLB 預取會預先準備接下來需要的位址轉換,以減少等待。但未命中減少了,並不代表記憶體的工作就減少了。因為未被使用的預測、太早到達而被逐出的轉換、更新預測歷史的寫入,都在消耗資源。設計的目標不是把未命中率降到最低,而是減少實際阻擋執行位址轉換等待的量,要比整體成本減少得更多。
VLSI Korea view: 提前開始轉換這件事,與消除轉換成本這件事並不相同。預取器除了準確度,還必須設計到達時點、記憶體流量,以及過時轉換的丟棄。
一次未命中不等於一次 DRAM 往返
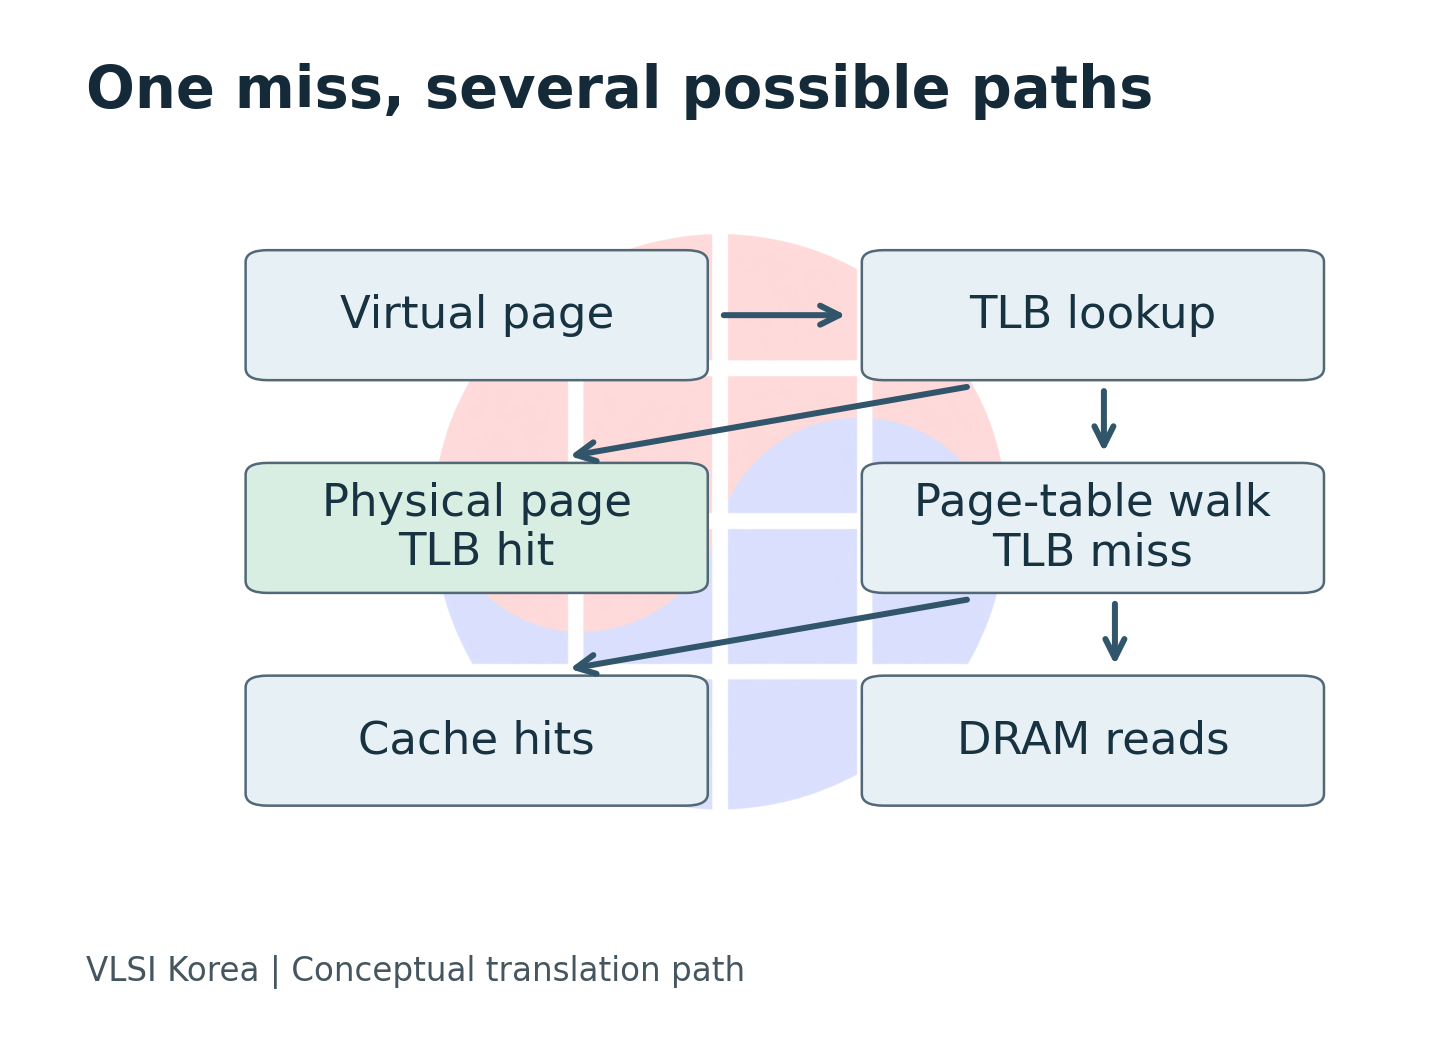
位址轉換快取 TLB 快速供應虛擬頁面與實體頁面的對應。在這裡找不到時,位址轉換程序會沿著分頁表取得所需的項目。這個過程中的讀取也可以利用快取階層。因此,最後一級 TLB 未命中數、分頁表遍歷數與實際 DRAM 讀取數,是彼此不同的計數。把三者當作同一個來處理,很容易誤會預取是消除了工作,而不是把工作搬了位置。 Agile TLB Prefetching 的背景與設計展示了選擇性利用已取回快取行中相鄰 PTE 的方法。
以實際晶片案例來看代表照片的 Baikal-T1。ZeptoBars 於 2017-02-28 公開的拆解照片展示了這顆使用 MIPS P5600 核心的晶片的晶粒。Linux v6.17 的 CPU 偵測程式碼中,有為 P5600 啟用 FTLB 的設定路徑。這顯示位址轉換結構是矽晶與系統軟體之間的具體接點。單憑照片無法得知 TLB 容量或有無預取器,也不代表下方研究技法實作在這顆歷史晶片上。
| Event | What it establishes | What it does not establish |
|---|---|---|
| Last-level TLB miss | Cached translation was unavailable | DRAM was accessed |
| Page-walk cache hit | Part of the traversal was reused | The final translation was cached |
| Prefetch used | Demand consumed a prediction | It arrived early enough to remove all waiting |
MMU 設計者首先必須區分哪種等待較長。是轉換太慢讓核心停住,還是轉換已結束、只是在等資料回應,同樣的未命中減少價值也不同。在多個請求重疊處理的系統中,個別遍歷延遲的總和也不等於整體執行時間。若消除的遍歷大多藏在其他工作之後,未命中計數變好,程式也可能幾乎沒有變快。
平台工程師的第一個決定也從這裡分岔。在決定改配置政策、改快取大小,還是加預取器之前,應先把同一個工作的位址轉換等待與資料等待分開。若在開啟預取的執行中,連工作量或頁面配置都改變了,改善的原因就會混在一起。把「相同工作、相同配置」的實驗與「實際配置變化」的實驗當作不同的問題來處理,更容易判斷。
| Mechanism | State to retain | Cost to inspect |
|---|---|---|
| Spatial prediction | Nearby-page relationship | Unused neighboring translations |
| Per-instruction history | Previous region per instruction | Aliasing and phase changes |
| Page-associated history | Successor hints near translation state | Metadata writes and compatibility |
預測歷史放哪裡,會改變設計
近期的出發點是 Trail 預印本。提交時間為 2026-10-06 15:00:44 UTC,本次調查在隔天的公開清單中確認。研究團隊學習同一指令接續的區域間移動,並在前一區域的分頁表項目中儲存指向下一區域的差值(delta)。再次讀到該項目時,也一併得到預測線索。可用位元以硬體與軟體的共識為前提,若不足,則提出使用外部 delta 表的變體。已確認正文的設計說明,此處不把模擬數字轉移到產品效能上。
為什麼每指令歷史可能有幫助?做一個說明用的順序:指令 A 讀區域 10,B 讀 40,再 A 讀 14。只看整體順序,移動是 +30 與 −26。只看 A 的歷史,是 +4。這表示預測值不是記憶體的物理移動距離,而是依如何把事物綁成同一個流程而改變的學習表示。
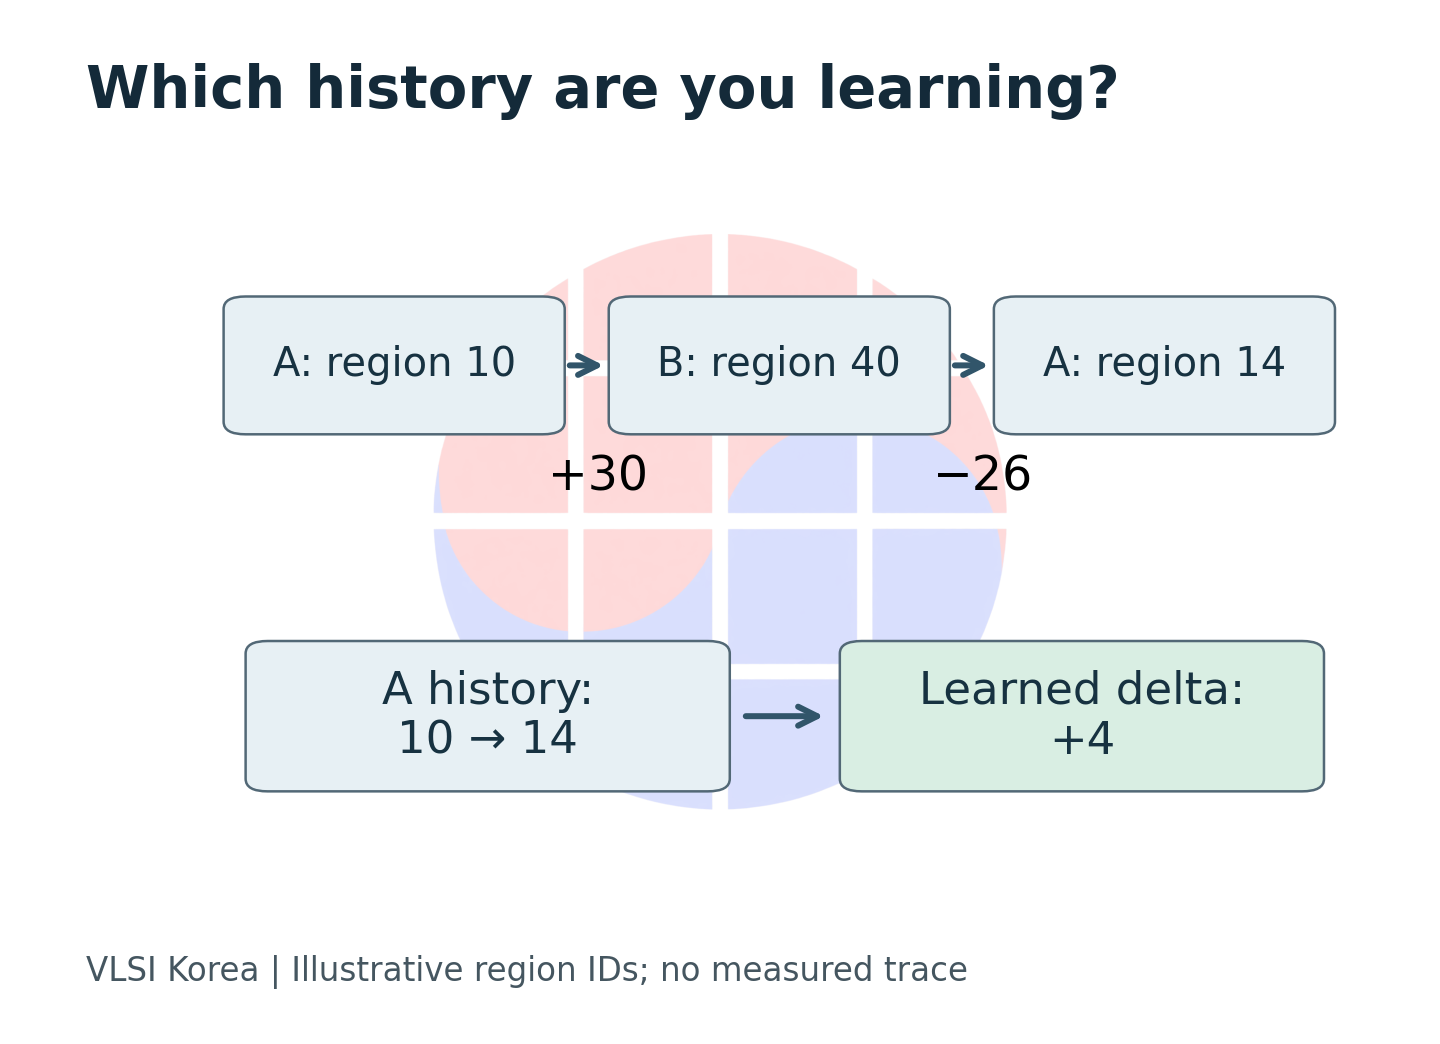
在這個範例中,並不保證 +4 下一次也正確。當 A 開始處理其他資料結構,即使是同一指令,模式也會改變。把區域綁得大,需要記住的種類可能減少,但該區域的轉換實際被用多少,必須另外計算。反之,使用小區域可以減少不必要的預先讀取,卻可能需要更多歷史。這個選擇是位址空間的壓縮與有用預測的保存之間的交換。
改變歷史儲存位置的想法,也可以從同一觀點評估。只看把專用表做小的效果很有吸引力,但還必須追蹤學到的內容在哪裡讀、何時修改。搭既有讀取便車的詮釋資料存取,與為執行新預測而引發的存取,是不同的成本。詮釋資料就在附近,不代表目的地轉換也能免費取得。在設計審查中,最好把儲存位元組、更新頻率與預測發行率列為不同項目。
| Cost path | Question |
|---|---|
| Hint read | Already fetched? |
| History update | Dirty line written back? |
| Predicted walk | Extra hierarchy requests? |
用同一個工作,重寫記憶體帳本
以下是 VLSI Korea 的說明用計算,不是論文重現。假設在關閉預取器的同一個工作中,100 件需求轉換全部引發遍歷,每次遍歷經過快取後平均產生 2 次 DRAM 讀取。基準成本是 200 次。若預取器及時供應 U 件有用的轉換,剩下的需求讀取為 (100−U)×2。再加上預取本身引發的 DRAM 讀取與詮釋資料的寫回。
選擇性設定假設 20 件預測中及時供應 16 件。把每件預測的平均 DRAM 讀取設為 0.5 次,預測讀取為 10 次。加上詮釋資料寫回 10 次,總計 188 次。激進設定預測 60 件、及時供應 36 件,但若每件預測的 DRAM 讀取為 2 次,總計增加到 258 次。兩種設定都減少了需求未命中,但整體記憶體交易的方向相反。
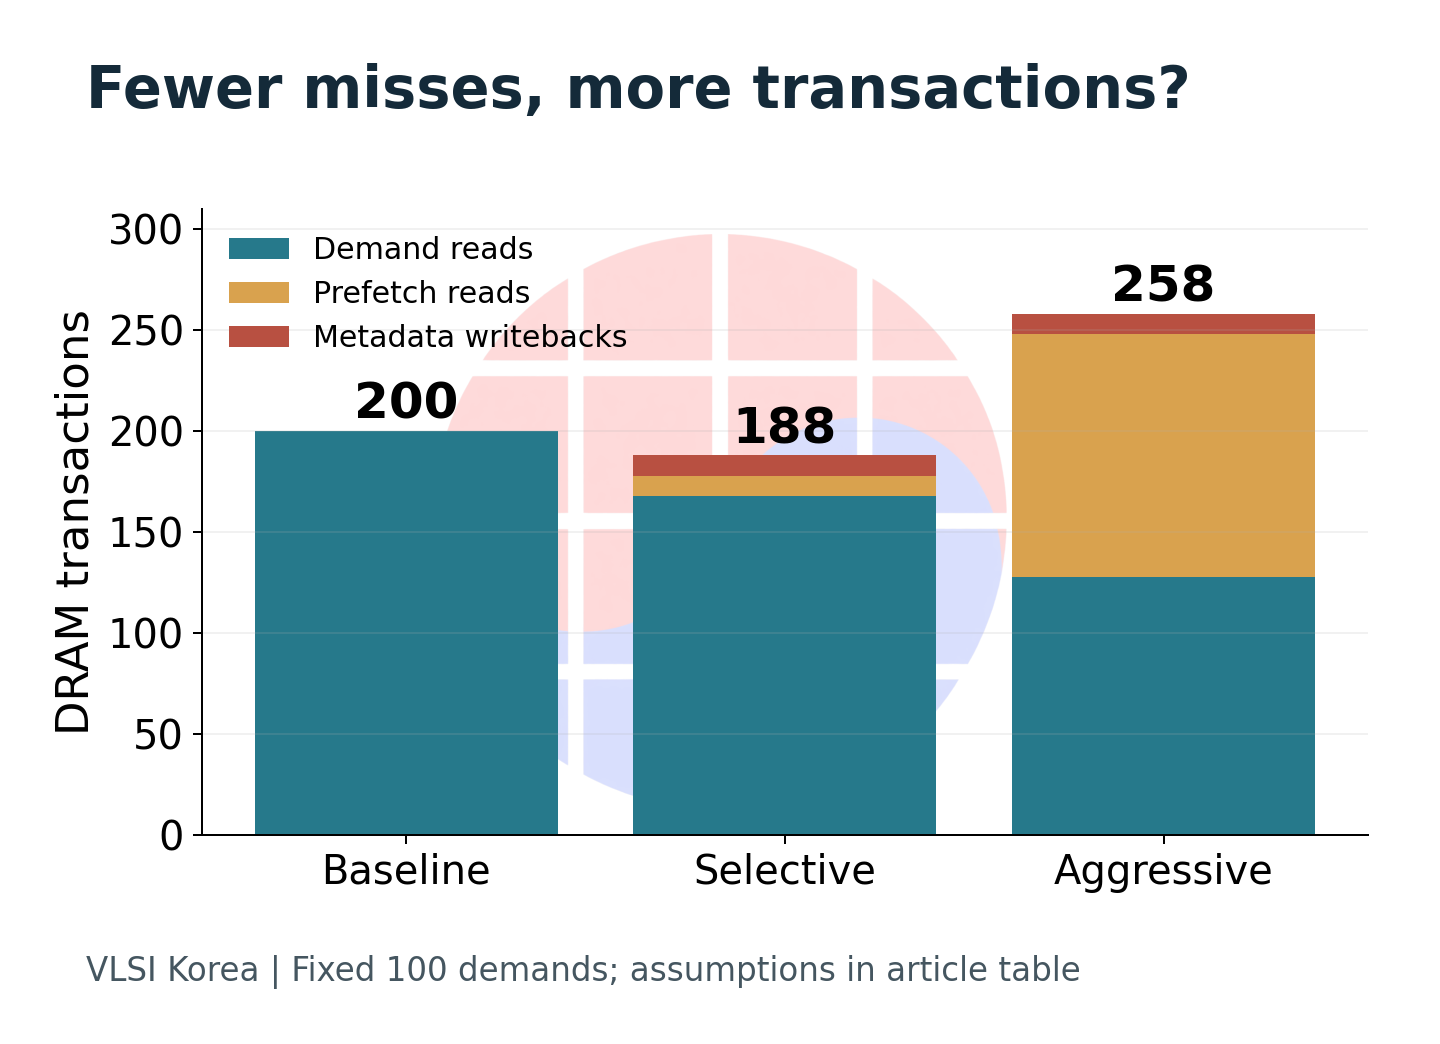
這裡的交易數是把讀取與寫回各算一件的簡單帳本。即使交易大小相同,依讀寫切換、佇列、bank 平行度與優先順序,時間也會不同,所以不能把這個總計直接換成延遲或功耗。計算固定既有資料流量,只比較與轉換相關的追加部分,也排除了預取把資料快取有用行擠出去的效果。在實際系統中必須再把那個效果納入。
📩 在持續關注這個主題嗎?
財報·報告·HBM供需的後續分析,每天10:30(KST)寄到您的信箱。 免費訂閱 →
特別重要的是,「有用」在何時判定。即使預測後來被用了一次,若它比需求請求更晚完成,就沒有消除已經發生的全部等待。太早到達的預測,可能在使用前被逐出。因此必須區分準確度、及時擋下需求未命中的比例、遲到的預測與使用前被逐出。若請求間隔與佇列壅塞程度不同,即使準確度相同,體感效能也可能不同。
VLSI Korea view: 這個計算的反證條件很明確。若增加的讀取、寫入與競爭的成本大於減少的需求等待,就沒有理由採用擋下更多未命中的設定。
| Toy case | Issued prefetches | Timely useful prefetches | Residual demand reads | Prefetch reads | Metadata writebacks | Total |
|---|---|---|---|---|---|---|
| Baseline | 0 | 0 | 200 | 0 | 0 | 200 |
| Selective | 20 | 16 | 168 | 10 | 10 | 188 |
| Aggressive | 60 | 36 | 128 | 120 | 10 | 258 |
大頁面改變的是與預測不同的成本
大頁面擴大一個轉換項目涵蓋的位址範圍。預取則提前取得所需轉換的時點。即使把兩種方法綁成同一個「TLB 改善」,實際改變的東西也不同。Linux 6.17 的 Transparent Hugepage 文件說明了大頁面的 TLB 好處,以及在只用一部分的區域可能產生記憶體浪費、配置與壓縮過程可能造成延遲。文件中的頁面大小是可能依架構而不同的範例。
為了只把容量效果拆出來看,把虛擬 TLB 固定為 64 個項目。若每個項目代表不同的 4 KiB 頁面,理想涵蓋範圍是 256 KiB。若為 2 MiB 頁面,則是 128 MiB,比例為 512 倍。這是計算可存取虛擬位址範圍,不是預測處理量會以該比例增加。此簡單計算也排除了重複、衝突、置換政策與多種頁面大小的混雜。
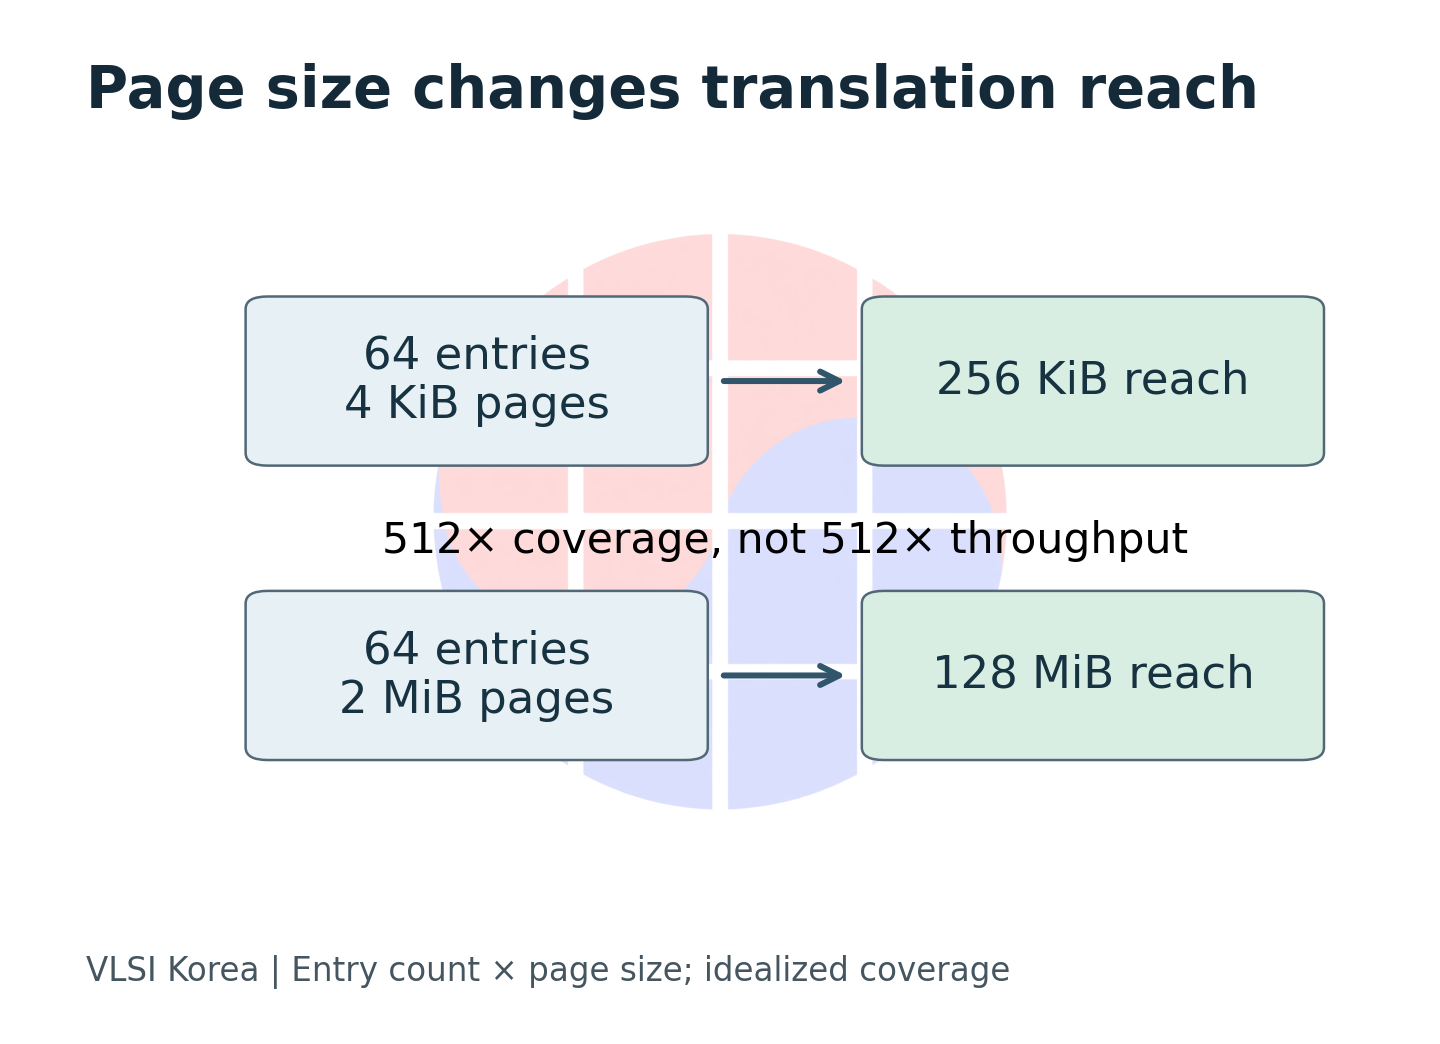
因此比較基準應寫目前部署實際得到的頁面大小。在大頁面增加的環境中,剩餘轉換未命中的性質本身也可能改變。若只剩下在全部請求中佔比很小、卻非常不規則的位址,就難以原樣套用過去的預測準確度。反之,若有許多難以取得大頁面的短生命週期配置,可能得到不同結果。必須一併看依大小的請求分佈與配置生命週期。
實務上要改的決定不是「永遠開啟大頁面」。是決定把延遲敏感請求的配置成本也納入後,要套用到哪個記憶體區域。預取器的評估也應在同一頁面政策下開始。之後再另外量測與大頁面一起使用時的追加收益,就能避免把已由兩個功能降低的同一個瓶頸的效益重複計算。
| Choice | Potential benefit | Counter-cost to include |
|---|---|---|
| Larger pages | More bytes covered per translation | Allocation, compaction, unused space |
| More TLB entries | More simultaneously retained translations | Lookup structure and replacement behavior |
| Prefetch | Translation work starts earlier | Extra walks, contention, early eviction |
比 PTE 的空位元更先看位址的生命週期
即使 PTE 中有看似沒用的位元,也不代表實作者可以任意使用。RISC-V Supervisor ISA 1.13 文件區分軟體用的 RSW 與保留給未來標準的位元。有些情況若設定了指定的保留位元會產生 page fault,SFENCE.VMA 的同步範圍也只限定於本地 hart。因此,「看起來現在沒在用」這個觀察,不能取代可移植的詮釋資料儲存契約。
更本質的問題是預測如何承受位址的再使用。想像一個預先遍歷:當虛擬位址 V 指向實體頁面 P 時已開始。作業系統把 V 改成 Q、使既有轉換失效後,若舊的遍歷結果到達,會怎樣?不能把那個結果重新安裝成有效的轉換。Linux 的快取與 TLB 失效文件所定義的更新後可見性,是即使加上預取器也必須保存的基準。
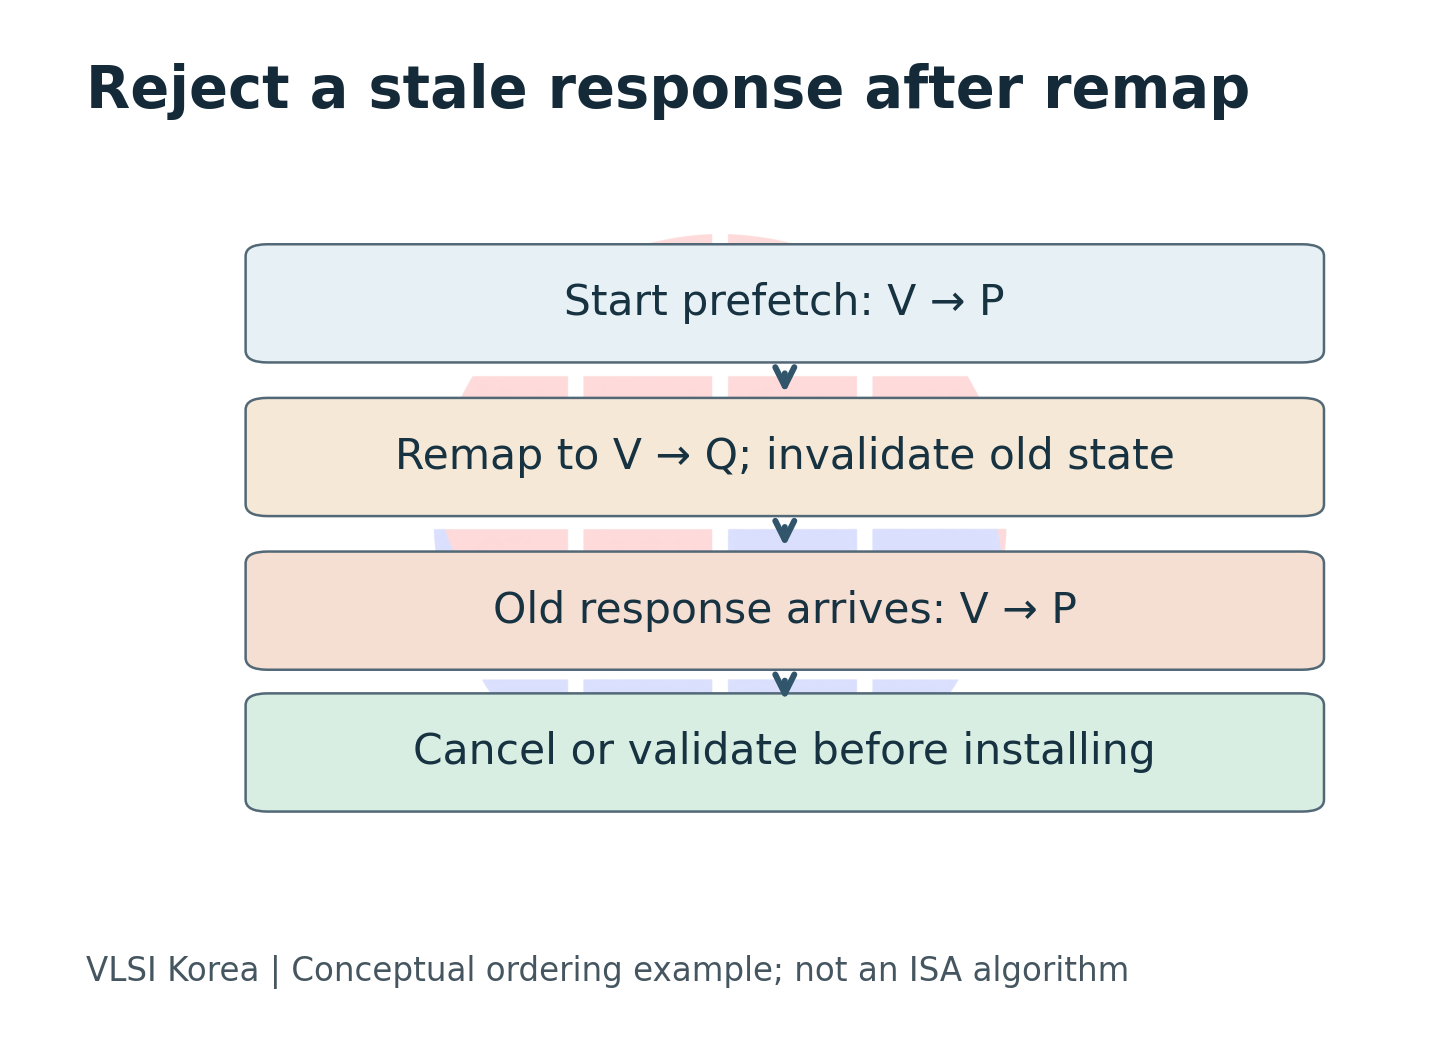
可以解釋的設計選擇,是取消進行中的工作,或在結果到達時確認位址空間與失效世代是否仍然有效。這不是主張特定指令集要求世代計數器,而是區分舊回應的實作選擇範例。是否只清空佇列就夠了,必須追蹤已送出佇列外的記憶體請求與返回路徑才知道。
預測線索與存取權限也必須分離。設計上應讓錯誤的線索原則上只造成效能損失,不能讓它代替實際轉換的位址與權限確認。處理程序切換、位址空間識別碼再使用、頁面大小變更,是這個分離容易被動搖的情境。在功能驗證中,不要只看發出請求的瞬間,還要改變失效與回應到達的順序,製造同一個位址具有不同意義的場景。
| State | Who owns its meaning? | Required separation |
|---|---|---|
| Architectural PTE fields | ISA and operating system | Address, permission and status |
| Prediction hint | Agreed hardware/software extension | Advisory value, never access authority |
| Cached translation | Translation subsystem | Address-space and invalidation scope |
韓國的設計與平台團隊應分擔的決定
對韓國的 CPU、SoC 與加速器開發團隊而言,這個問題要求一併看核心內部最佳化與記憶體系統的邊界。MMU 負責人與其只提出小型預測表的面積,不如說明包含發行佇列、去重複與失效路徑的設計成本。平台負責人必須提供實際程式的配置生命週期與頁面配置。不能只憑一方的理想位址流程,保證另一方的產品效益。
對評估記憶體系統的團隊而言,也有另一層意義。即使裝上更快的記憶體後效能變好,也必須區分應用程式資料與位址轉換流量。若與轉換相關的讀取正在擴大競爭,優先抑制預取器可能更好。反之,若頻寬有餘裕且轉換等待暴露出來,就有允許追加交易的依據。是哪一種情況,必須一併看同一個工作的完成時間與流量才能判定。
| Reader job | Immediate decision | Evidence that can reverse it |
|---|---|---|
| MMU architect | Budget queue, state and issue rate | Timely coverage falls under contention |
| Platform engineer | Tune page policy or prefetch first | Allocation tail cost exceeds saved stalls |
| Memory-system engineer | Attribute bandwidth pressure | Page-walk traffic, not application bytes, rises |
未來 6–12 個月的觀察點不是最高未命中減少率單一數字。看公開實作是否給出包含位址空間切換與映射變更的結果,在相同的頁面政策與記憶體限制下效益是否留存,以及資料與預測流量是否分開報告。檢視研究原型的團隊,最好先從自身資料結構、生命週期與競爭條件會讓結果翻轉的邊界找起。
TLB 預取看起來像預測未來的小裝置,實際上是重新配置記憶體工作在何時、何地執行的設計。好的預測及時供應有用的轉換,在過程中不妨礙更重要的請求,並在位址改變後丟棄過去的答案。應改變採用判斷的數字,不是減少的未命中數單一項,而是同一個工作的等待時間、整體交易與正確轉換的生命週期。
Sources
- Trail, arXiv v1: metadata and submission time; public design text. Preprint; no conference acceptance claim is made here.
- Agile TLB Prefetching, ISCA 2021, author-hosted paper. Background and mechanism, not a matched performance baseline.
- Linux 6.17: Transparent Hugepage Support.
- RISC-V Supervisor ISA 1.13, specification snapshot v20260120.
- Linux: Cache and TLB Flushing.
- Linux v6.17: MIPS CPU capability probing.
- ZeptoBars: Baikal-T1 die photograph, publisher reuse terms, CC BY 3.0.
Disclosure
本文的交易數、虛擬 TLB 容量計算與圖表是 VLSI Korea 的說明用構成。不是實際晶片量測或論文重現結果。Trail 是在閱讀公開預印本設計的範圍內處理,未確認商業採用。代表照片是過去 Baikal-T1 的實際晶粒照片,未修改原圖,也不標示為該研究的實驗裝置。AI 用於文稿與翻譯、說明圖表的準備。
📩 今天錯過的分析,明天早上寄到您的信箱
每天10:30(KST)Daily Silicon與財報·機構報告核心解讀搶先送達。訂閱後可選擇韓語/英語/日語新聞通訊,中文深度分析每日在網站更新。
免費訂閱 →
免費 · 無垃圾郵件 · 隨時退訂