VLSI Korea
交換器、NIC、矽光子、CPO — 為什麼不做成一顆晶片?行動 SoC 設計師完整解說
交換器、NIC、矽光子、CPO — 用行動 SoC 設計師的語言解說資料中心網路晶片為什麼分成多顆晶片。從 SerDes 512 條的數學到收斂至 CPO 的 7 個理由。


🆓 免費文章 · 任何人都可以免費閱讀
交換器、NIC、矽光子、CPO — 為什麼不做成一顆晶片?
為行動 SoC 設計師撰寫的資料中心網路晶片完整解說(基準:2026 年 10 月)
你是一位 AP 設計師。把 CPU、GPU、NPU、ISP、記憶體控制器塞進同一顆裸晶,是你的日常。你也懂 SerDes。USB、PCIe、MIPI — 都是每天看的東西。
但當你踏入資料中心網路晶片的世界,會覺得有點奇怪。有一種叫交換器的晶片,內含 500 個 SerDes;有一種叫 NIC 的晶片,裡面有 ARM CPU;用光傳送信號的晶片又是另一顆;把光晶片「一起封裝」在交換器旁邊,業界就為之震動。而且最關鍵的是 — 當你問為什麼不做成一顆晶片時,得到的答案不是「做不到」,而更接近「不應該做」。
本文將從頭到尾解釋原因。什麼是交換器、什麼是 NIC、什麼是矽光子、什麼是 CPO,以及為什麼要分成多顆晶片。我們會直接借用行動 SoC 設計師腦中的概念,一一對應說明。
第 0 章 先談世界觀:資料中心網路為什麼如此龐大
行動世界的網路很單純。一支手機連到一個基地台。流量方向也很單純,大多是下載。
資料中心正好相反。數萬台伺服器不停地互相傳送資料。連接它們的結構是 leaf-spine(fat-tree)拓撲。
- Leaf 交換器:每個伺服器機櫃(Rack)配備的交換器,匯集機櫃內數十台伺服器。
- Spine 交換器:匯集 Leaf 交換器的上層交換器。Leaf 之間通訊時,必定經過 Spine。
為什麼要用這種兩層結構?因為伺服器對伺服器直接連接,連接埠數量會爆炸。要連接 10,000 台伺服器,每台伺服器需要 9,999 個連接埠。採用 Leaf-spine,每台伺服器只需 1 個連接埠連到 Leaf,Leaf 則均勻連到 Spine。頻寬不足時,再加 Spine 就好。擴展是線性的。
這裡有個重要概念:east-west 流量。資料中心流量的 70~80% 是伺服器間通訊,也就是東西向(East-West)。使用者送出請求並收到回覆的南北向只是少數。AI 訓練會把這推向極端。數萬個 GPU 用 all-reduce 運算同步梯度,若這通訊很慢,GPU 就會閒置。一張 GPU 價值數萬美元,卻因網路而閒置。所以最近常聽到「網路就是電腦」這句話。
來感受一下規模。最新旗艦 AP 的記憶體頻寬以 LPDDR5X 為準約 100GB/s,換算成位元約 800Gbps。2026 年主力資料中心交換器晶片 1 顆的處理量是 51.2Tbps。是 AP 記憶體頻寬的 64 倍。一顆交換器晶片每秒搬運 51 兆位元。看看 AI 叢集規模就知道為什麼需要這樣。10 萬張 GPU 的叢集,需要數千台交換器來搬運這些流量。
第 1 章 交換器:內含 500 個 SerDes 的怪物
交換器做什麼
交換器的工作很簡單明瞭。看進來封包的標頭,送往目的地。就這樣。但要以每秒數十兆位元的速度、數十萬個連接埠、一個封包都不遺失地做到「就這樣」。
交換器 ASIC 內部大致是這樣的管線。
- Parser:拆解封包標頭(Ethernet/IP/TCP...)並擷取欄位。
- Match-Action Table:用擷取的欄位查詢表格。「這個目的地 MAC/IP 走幾號埠」等規則就在這裡。用 TCAM 或 SRAM 實現,包含數百萬筆條目。
- Traffic Manager / Buffer:輸出埠忙碌時,暫時把封包堆在記憶體中。這裡吸收多個輸入湧向同一輸出的 incast 或瞬間暴增(microburst)。為什麼需要這個緩衝,後面會再談。
- Scheduler:公平且不打亂順序地送出堆積的封包。
- Deparser:重新組裝標頭並送出。
也有可程式化交換器。用名為 P4 的語言定義管線行為,即使晶片已經製造,也能改變轉發邏輯。Intel 的 Tofino 是代表,但 Intel 已整頓該事業,可程式化交換器市場目前處於退潮狀態。(基準 2026 年)
SerDes 數學:為什麼是 500 個
對 AP 設計師最震撼的數字就是這個。51.2T 交換器晶片內含 512 條 SerDes 通道。與 USB、PCIe 合計只用 20 個左右 SerDes 的 AP 相比,完全是不同次元。
數學很單純。
- 51.2Tbps ÷ 112Gbps/通道 = 457 條通道。加上餘裕與額外開銷,就是 512 條。
- 從連接埠構成來看:800G 埠 64 個 = 51.2T。1 個 800G 埠由 8 條 112G 通道組成。64 × 8 = 512。
也就是說,交換器的頻寬直接換算為 SerDes 數量。交換器世代提升,也意味著每條 SerDes 通道的速度提升。56G → 112G → 224G(PAM4)。進入每通道 224G 時代,同樣 512 條通道就能做到 102.4T。Broadcom Tomahawk 6 正是那顆晶片。
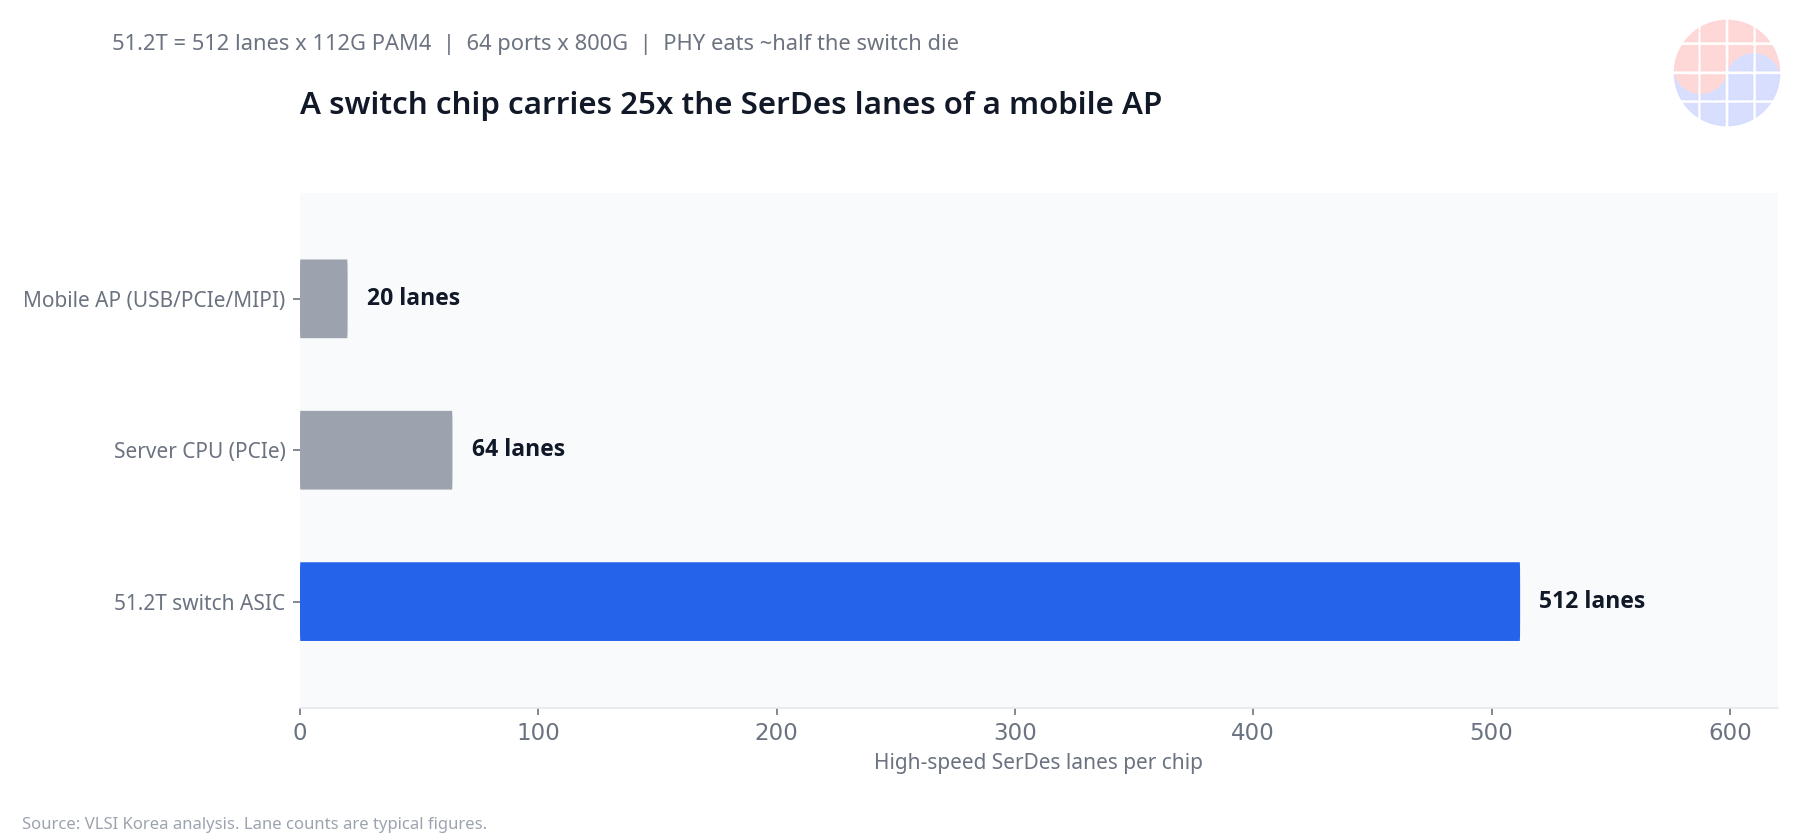
這時 AP 設計師的直覺會啟動。「512 個 SerDes,PHY 在裸晶中占的面積會非常驚人吧?」沒錯。交換器裸晶面積近一半是 SerDes PHY。而且 SerDes 是類比的,不太會隨製程微縮而變小。這個事實,後面會成為「為什麼不做成一顆晶片」的核心答案之一。
交換器晶片世系
資料中心交換器晶片市場由 Broadcom 壓倒性主導。記住世系,讀新聞會更輕鬆。
- Broadcom Tomahawk:資料中心用。TH3(12.8T)→ TH4(25.6T)→ TH5(51.2T)→ TH6(102.4T)。後面附的 Bailly、Davisson 是 CPO 版本的代號。
- Broadcom Jericho:電信商/路由器用。緩衝大(deep buffer),功能多。Jericho3-AI 內含 HBM。交換器裡有 HBM — 若你是記憶體設計師,這會讓你豎起耳朵。
- Cisco Silicon One:Cisco 自行製造的晶片,用於自家設備。
- Marvell Teralynx:Marvell 的資料中心交換器產品線。
- NVIDIA Spectrum:收購 Mellanox 後 NVIDIA 的乙太網路交換器。Spectrum-6 為 102.4T 級。Spectrum-X 是 AI 叢集用乙太網路 fabric 品牌。
它們有共同點。全部採用最先進製程(5nm 級以下),裸晶尺寸全部逼近光罩極限(≈800mm²),SerDes 全部占面積很大比重。交換器是由「數位邏輯 + 500 個 SerDes + SRAM/TCAM」組成的、世界上最 SerDes 密集的晶片。
為什麼需要緩衝記憶體
可能會有人問「為什麼要堆積封包,直接送出去不就好了」。原因是 incast。這是 AI 訓練中常見的模式,數百個 GPU 同時向一個 GPU 傳送梯度。輸入有數百個,輸出只有一個。物理上無法同時送出,必須堆在某處。那就是緩衝。
緩衝不足,封包就會被丟棄(drop)。TCP 靠重傳撐住,但 AI 訓練用的 RDMA 流量對 drop 極度敏感。所以 AI 用交換器會加大緩衝,或採用完全不 drop 的設計。這就是 Jericho 甚至內含 HBM 的原因。「交換器裡有 HBM」聽起來誇張,但相對於頻寬、緩衝不足是 AI 網路的現實。
第 2 章 NIC:伺服器的出入境審查台
NIC 做什麼
NIC(Network Interface Controller)是連接伺服器與網路的晶片。若交換器是「連接多個連接埠」的晶片,NIC 就是「把一台伺服器連上網路」的晶片。以 AP 來比喻,定位類似數據機。不是伺服器主 CPU,而是專責網路通訊。
基本工作是封包傳送與接收、總和檢查計算、segmentation(TSO:把大資料切成封包大小)等。而更進一步的概念是 RDMA。
RDMA:不經過 CPU 的複製
RDMA(Remote Direct Memory Access)字面意思就是「直接存取遠端記憶體」。把伺服器 A 記憶體中的資料複製到伺服器 B 的記憶體,完全不經過兩邊的 CPU 與 OS 核心。
為什麼要這樣做?因為核心太慢了。一般網路堆疊每當封包到達,就要經過中斷 → 核心 → socket 緩衝 → 複製到使用者記憶體。在這過程中會消耗 CPU,延遲(latency)也會忽高忽低(tail latency)。在 AI 訓練這種數萬個節點必須同步的環境中,「偶爾變慢」會拖慢全體。RDMA 由 NIC 硬體直接與記憶體控制器對話來搬移資料。CPU 只下達「搬過去」一句話,就去做別的事。Zero-copy、kernel bypass 是核心。
標準有兩大陣營。InfiniBand(NVIDIA/Mellanox 陣營,AI 叢集的傳統強者)與 RoCE(RDMA over Converged Ethernet,在乙太網路上跑 RDMA)。2026 年現在,AI 叢集正朝向這兩大陣營向乙太網路(包括 Ultra Ethernet 陣營)收斂的方向發展。
SmartNIC / DPU:為什麼 NIC 裡有 CPU
這裡會出現讓 AP 設計師困惑的點。最新 NIC 內含數十個 ARM CPU 核心。NIC 為什麼要內含 CPU?
假設你營運一個 1,000 台伺服器的資料中心。每台伺服器跑數十台虛擬機器(VM)。VM 之間的網路隔離、虛擬交換器、防火牆規則、儲存存取(NVMe-oF)、加密(IPsec/TLS)— 若全部由主機 CPU 處理,會怎樣?伺服器 CPU 核心的 20~30% 會消耗在網路處理上。在雲端,一個 CPU 核心就是錢。64 核心伺服器若有 16 個核心被網路綁住,那就是純粹的損失。
所以把這工作丟給 NIC。在 NIC 中放入 ARM 核心與加速器,在 NIC 中處理虛擬交換器(OVS)、儲存堆疊、安全處理。主機 CPU 完全只用於客戶 VM。這就是 SmartNIC,NVIDIA 的叫法是 **DPU(Data Processing Unit)**。
整理玩家如下:
- NVIDIA BlueField:DPU 的代名詞。已推出到 BlueField-4。ConnectX NIC 技術 + ARM 核心 + 加速器。
- Intel IPU(Infrastructure Processing Unit):Mount Evans 世系。Intel 的 DPU 產品線。
- AMD Pensando:DSC 晶片。特色是可用 P4 程式化的封包處理器。
- Broadcom Stingray、Marvell OCTEON:各自的 SmartNIC 產品線。
用行動比喻來整理是這樣。AP 主 CPU 若親自處理相機 ISP 工作,電池會融化。所以設置 ISP 這種專用硬體。DPU 也是相同邏輯。主機 CPU 若親自處理網路工作,錢會融化。所以設置專用晶片。卸載經濟學在行動與資料中心是相同的。只是單位不同。行動是電力,資料中心是錢。
第 3 章 為什麼銅線不行 — SerDes 的物理學
在進入光的故事之前,必須先了解為什麼銅線不行。這就是矽光子與 CPO 存在的全部理由。
SerDes 與 PAM4
SerDes 是 Serializer/Deserializer。是把晶片內的平行資料轉換為串列高速信號並送出的 PHY。原理與 USB、PCIe 的相同。不同的是速度。資料中心現在每通道 112Gbps,即將進入 224Gbps 時代。
達到此速度的秘訣是 PAM4。既有 NRZ 每符號 1 位元(0/1),PAM4 使用 4 個電壓位準,每符號傳送 2 位元。把鮑率(符號速度)降低一半,資料率卻提升 2 倍。如 AP 設計師所知,天下沒有免費的午餐。位準變成 4 個,雜訊裕度縮小到 1/3。眼圖(eye)變窄。所以動用各種等化技術(CTLE、DFE、FFE)。這就是 SerDes PHY 是類比塊的原因。
距離 × 頻寬的法則
銅線配線有殘酷的物理法則。速度提升 2 倍,信號能承受的距離縮小到 1/4。因為高頻損耗(skin effect + 介電損耗)與頻率的平方成正比增加。
用數字來看。112G PAM4 SerDes 的通道損耗預算約 30dB 水準。在此頻段,PCB 走線每 1cm 損耗超過 1dB。從交換器 ASIC 到電路板前面板的距離是 15~25cm。計算下來損耗 20~30dB,幾乎用完預算。所以在中間插入名為 retimer 的晶片。它是接收信號、再生後再送出的中繼器。每加一個 retimer,就增加金錢、電力與延遲。
到了 224G 時代,這計算更殘酷。相同距離下損耗跳升超過 2 倍。可能需要插入兩個 retimer。交換器電路板的一半會被 SerDes、retimer、光模組的電力填滿。實際上,在 800G 光模組系統中,光相關電力接近系統總電力的一半。
電力的牆
SerDes 每通道電力以 112G 為準約 1W。512 條通道就是 500W。交換器晶片總電力 800W~1kW,其中一半以上來自 SerDes。數位邏輯(封包轉發)隨製程微縮電力下降,但 SerDes 類比不會下降。世代越往前,「交換器晶片 = SerDes 塊」的性格越強。
總結來說,銅的極限有三個。
- 距離:速度越高,到達距離急劇縮短。
- 電力:SerDes 與 retimer、光模組 DSP 消耗電力。
- 密度:前面板能插入的光模組數量有限。若要以可插拔方式實現 102.4T,必須在前面板插入 128 個 800G 模組。物理上做不到。
所以走向光。光一次解決這三個問題。隨距離的損耗幾乎沒有(光纖損耗 0.2dB/km — 與銅的單位不同),頻寬密度高,長距離傳輸的電力效率壓倒性地好。
第 4 章 矽光子:處理光的技術
為什麼偏偏是矽
用光傳送信號的想法本身並不新。光通訊是數十年的技術。矽光子重新受到關注的原因只有一個。因為可以直接使用 CMOS 晶圓廠。
既有光元件用 III-V 化合物(InP、GaAs)等特殊製程製造。昂貴、難以大量生產、難以與電子晶片整合。矽光子在矽晶圓上製造光波導、調變器、受光元件。直接沿用 200mm/300mm 晶圓廠的規模經濟。也容易把電子晶片(EIC)與光晶片(PIC)靠近。用 AP 設計師熟悉的話來說,就是「把光功能用矽標準化了」。
構成要素解剖
矽光子鏈路由四個部分組成。
- 雷射(Laser):光的源頭。CW(continuous wave)雷射發出恒定的光。
- 調變器(Modulator):把資料載入恒定的光。有兩種方式。
- MZM(Mach-Zehnder Modulator):把光分成兩路再合併,利用干涉產生 on/off。體積大但線性好,對高速強。
- Microring Modulator:用電信號稍微移動環形諧振器的諧振波長來調變光。非常小但對溫度敏感。只要變化 0.1°C,諧振波長就會偏離。
- 波導(Waveguide):光行走的路。用氧化膜(折射率 ≈1.5)包裹矽核心(折射率 ≈3.5),以全反射困住光。與銅配線不同,光與旁邊波導幾乎不干涉。所以可以高密度配線。
- 光電二極體(Photodetector):把光再轉換為電。矽不太能吸收 1.3~1.55μm 波段的光,所以使用鍺(Ge)。
而驅動這些光元件的電子晶片(EIC)會成對附著。傳送端有驅動調變器的 driver,接收端有放大光電二極體微小電流的 TIA(Transimpedance Amplifier),以及協調整體的 DSP。
📩 在持續關注這個主題嗎?
財報·報告·HBM供需的後續分析,每天10:30(KST)寄到您的信箱。 免費訂閱 →
雷射為什麼在晶片外
這是矽光子的阿基里斯腱。矽不會發光。因為是間接能隙(indirect bandgap),電子與電洞重組時,能量不是以光、而是以熱的形式釋放。雷射材料 III-V 化合物(InP 系)是直接能隙,所以很會發光。
所以把雷射放在矽之外。方式正朝三個方向演進。
- 外部雷射(External Laser Source):從獨立封裝的雷射模組透過光纖引入光。最成熟的方式。
- 異質整合(Heterogeneous Integration):把 InP 裸晶接合在矽晶圓上。Intel 長期推動的方式。
- 遠端雷射(Remote Laser):CPO 使用的方式。只把雷射獨立出來以便更換。雷射故障時,只換雷射。
2026 年 3 月,NVIDIA 向 Lumentum 與 Coherent 各投資 20 億美元、共 40 億美元,原因正是這雷射供應鏈。CPO 時代來臨,雷射將成為瓶頸。這是提前鎖定的宣示。
光模組解剖:800G OSFP 裡有什麼
拆開插在資料中心前面板的光模組(QSFP-DD、OSFP),長這樣。
- DSP:消耗模組電力約 40% 的大胃王。負責 SerDes 信號的等化、FEC、retiming。
- Driver + TIA:驅動調變器與光電二極體的類比晶片。
- PIC:矽光子晶片。整合調變器、波導、光電二極體。
- 雷射:以 ELS 附著或接合。
1 個 800G 模組的電力約 15W。在 1 台交換器上插 64 個,光模組就接近 1kW。系統電力一半來自光,就是從這裡來的。
誰在製造
- Intel:做矽光子最久的公司。從 100G 到 800G 直接銷售光模組。
- Cisco:收購 Luxtera 後將矽光子內部化。
- Marvell:收購 Inphi 成為光 DSP 最強者。2026 年 ECOC 展示了以 2nm 製程為基礎的 400G/通道光技術。
- Broadcom:直接製造 CPO 用光引擎(SCIP)。Bailly 的 8 個光引擎是 Broadcom 自家矽光子。
- Lumentum / Coherent:雷射與光元件。NVIDIA 的 40 億美元投入之處。
- TSMC:推動名為 COUPE 的矽光子封裝平台。NVIDIA 的 CPO 交換器在 TSMC COUPE 上製造。
- Ayar Labs:CPO 專業新創。AMD、Intel、NVIDIA、MediaTek 都有投資。光 2026 年就募資 6.5 億美元,累計超過 10 億美元。這數字顯示業界對 CPO 的下注程度。
2026 年現在,1.6T 光模組(8 通道 × 200G)已商用化,3.2T 預計 2027 年送樣。速度持續上升。問題是「銅區間」撐不住這速度。所以下一章,CPO 登場。
第 5 章 CPO:把光貼在交換器旁邊
可插拔為什麼曾是標準
要理解 CPO,必須先了解為什麼光模組是「插在前面板」的形態。QSFP、OSFP 等可插拔外形規格成為標準,純粹是出於實用。
- 維修容易。光模組故障是現場故障的常客。雷射壽命、連接器污染、老化 — 光模組接近耗材。可插拔形態,故障時只拔出更換即可。
- 可多源供應。標準外形 + 標準光規格,就能更換供應商。這是超大規模業者(hyperscaler)的生命線。
- 世代更換容易。交換器用 5 年,光模組可從 400G 升級到 800G。
這是合理的選擇。但隨著速度上升,這結構的代價變大了。從 ASIC 到前面板 15~25cm 的銅走線。在 224G 時代,這走線本身會侵蝕信號。DSP 為了彌補而消耗電力,retimer 插在中間,前面板被模組塞滿。
CPO 的結構
**CPO(Co-Packaged Optics)**顛覆了想法。不要把光模組插在前面板,而是把光引擎(optical engine)貼在交換器 ASIC 旁邊、同一封裝內。
以代表產品來看。Broadcom Bailly 在 Tomahawk 5 交換器晶片周圍,於同一封裝上搭載了 8 個 6.4Tbps 級矽光子光引擎(SCIP)。8 × 6.4T = 51.2T。光纖從封裝直接通往前面板。前面板上不再有厚重的光模組,只有細的光纖連接器。
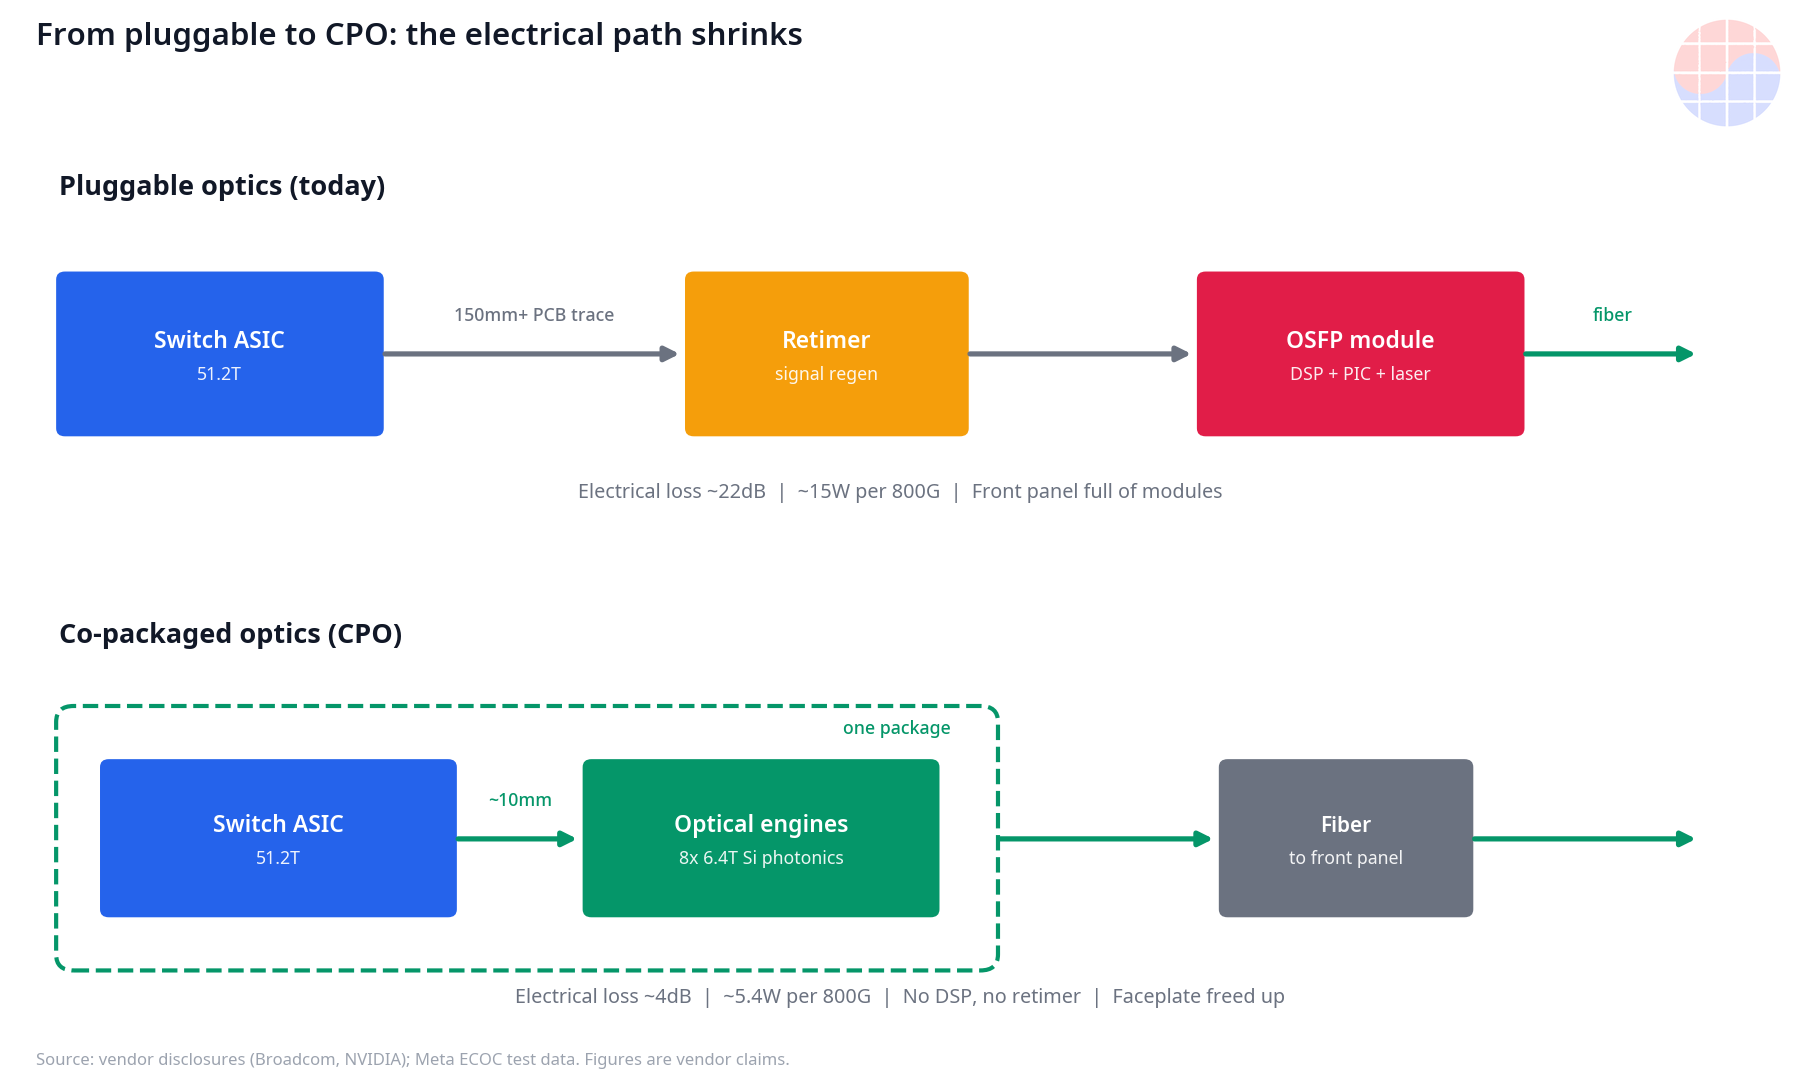
效果是戲劇性的。
- 電配線縮短:從 ASIC 到光模組 15cm 以上 → 到光引擎 1cm 左右。銅區間的信號損耗從 22dB 降至 4dB 水準(NVIDIA 發表數字)。
- 電力節省:移除 DSP(不需要 retimer),在短距離進行光轉換。Broadcom 主張相較可插拔,光相關電力節省 70%,Meta 的驗證測試也得出每 800G 可插拔約 15W 相比 CPO 光引擎+雷射約 5.4W 的數字。方向很明確。
- 密度:前面板空間被解放。102.4T、甚至 400T 級交換器成為可能。可插拔方式無法在前面板插滿所有模組。
2026 年 10 月現在,CPO 已超越試點,進入量產階段。Broadcom Bailly(51.2T)正在量產並通過 Meta 驗證。以 Tomahawk 6 為基礎的 Davisson(102.4T CPO)系統也已推出。NVIDIA 正以 TSMC COUPE 封裝量產爬坡 Spectrum-X Photonics 乙太網路交換器與 Quantum-X Photonics InfiniBand 交換器。Spectrum-X Photonics 是可擴展至最高 409.6Tbps(800G 埠 512 個)的設計。首批客戶被提及的有 CoreWeave、Lambda、Meta、Microsoft、Oracle。
中間地帶:NPO 與 LPO
若 CPO 是激進的,也有漸進的妥協方案。
- NPO(Near-Packaged Optics):把光引擎貼在封裝「旁邊」的基板上,而不是封裝「裡面」。沒有 CPO 那麼近,但比可插拔近得多。封裝難度比 CPO 低。
- LPO(Linear Pluggable Optics):外形仍是可插拔,但移除內部的 DSP。改由交換器 ASIC 的 SerDes 直接負責等化(linear channel)。電力降低,延遲也降低。代價是鏈路預算吃緊,交換器與模組之間的相容性變得重要。有名為 LPO-MSA 的標準化組織。
業界目前的格局是「可插拔(DSP)→ LPO → NPO → CPO」的光譜。能走到哪裡,由電力、成本、維修便利性的權衡決定。
CPO 的問題 — 誠實地說
CPO 並非萬能。整理 2026 年現在業界指出的瓶頸與風險:
- 無法維修。光引擎進入封裝內,故障時整塊板一起更換。可插拔時代的「拔出更換」做不到。緩解措施是遠端雷射(只分離最容易故障的雷射),但不是完整解法。
- 熱。雷射波長對溫度敏感,微環調變器更敏感。旁邊有數百 W 的交換器 ASIC 在沸騰,光引擎卻必須保持冷卻。熱設計成為封裝的核心難題。
- 良率。光引擎本身的良率 × 先進封裝的良率。2026 年現在 CPO 量產爬坡的瓶頸被指為光引擎良率與封裝產能。能做,但做不多。
- 測試。必須在封裝層級同時測試電與光。光 ATE 基礎設施仍不足。
- 生態系。可插拔有 20 年建立的多供應商生態系。CPO 目前供應商依賴性仍強。這是超大規模業者最討厭的。
所以 CPO 不是「行不行」的問題,而是「走到哪裡、多快」的問題。方向朝 CPO,但速度由這五點決定。
第 6 章 核心問題:所以為什麼不做成一顆晶片
現在進入正題。行動 SoC 設計師腦中有這樣的直覺。「AP 把 CPU、GPU、NPU、ISP、記憶體控制器全塞進去,交換器+SerDes+光引擎也塞進一顆裸晶不就好了?」
不行。正確地說,更接近「不應該做」。有七個原因。逐一來看。全部都是 AP 設計師已經知道的概念。
原因 1. 製程不同
交換器邏輯用 5nm、3nm 等最先進 CMOS 製造。因為數位邏輯從微縮中受益最大。
矽光子是另一個世界。光波導需要數百 nm 的尺寸。沒有理由用 3nm 做,也做不到。使用的晶圓也不同。使用具有厚 BOX(buried oxide)層的 SOI 晶圓。DRC、元件、PDK 完全不同。放在同一晶圓廠、同一晶圓上的想法本身就不成立。
行動比喻:這與 AP 不放入 RF 收發器的原因完全相同。RF 用 RF-SOI 或 SiGe 製程製造,PMIC 用 BCD 製程製造。用邏輯製程做,性能出不來。光也一樣。在適當位置使用不同製程,是 AP 設計師每天做的事。
原因 2. 光罩已滿
交換器裸晶已逼近光刻極限(reticle limit,≈800mm²)。數位管線 + 512 個 SerDes + SRAM/TCAM 已塞滿。物理上沒有地方放光調變器、波導、光電二極體。
「那把裸晶做大一點?」不能做得比光罩大。曝光設備一次拍攝就那個極限。AP 設計師會知道 stitching 的惡夢。良率與成本會崩潰。
原因 3. 良率數學
良率是乘法。大面積裸晶的良率 × 異質(光+電)整合製程的良率。假設兩者都是 90%,合起來 81%。兩者都是 80%,就是 64%。光製程的成熟度比 CMOS 低,實際上會更低。
所以業界的答案是小晶片(chiplet)。交換器裸晶歸交換器裸晶,光引擎歸光引擎,分開製造,只挑好的(KGD)在封裝中貼合。這就是 CPO 是「co-packaged」而不是「monolithic」的原因。與 AP 設計師知道的小晶片經濟學相同。小裸晶多顆比大裸晶一顆良率好。光的法則適用得更嚴苛。
原因 4. 熱-光耦合
雷射波長隨溫度漂移(0.1nm/°C 水準)。微環調變器若諧振波長偏離,就直接無法運作。溫度穩定性是生命。
但旁邊有 3nm 邏輯在噴出數百 W。若放在同一裸晶上,光元件會坐上溫度雲霄飛車。必須放入熱隔離結構,放了也不完美。所以 CPO 也把光引擎放在 ASIC「旁邊」,而不是「上面」。在熱上分離的同時靠近,是 CPO 封裝設計的核心。單石整合因熱而從源頭被封鎖。
原因 5. 類比不會微縮
SerDes PHY、TIA、driver 是類比的。用 3nm 做不會變好。反而電晶體的 intrinsic gain 下降、雜訊成為問題、電壓餘裕消失。類比常是「舊製程是好製程」。
所以適材適所。數位管線(交換器邏輯)用 3nm,SerDes 類比用適當製程,光用光製程。各自做好,在封裝中相遇。與 AP 分離類比/RF 的邏輯相同。單石整合,只會讓類比承擔微細製程的缺點。
原因 6. 解聚合的經濟學
與技術原因同等重要的是經濟。超大規模業者(買方)極度討厭供應商鎖定。
若全塞進一顆晶片,就得把一切交給製造那顆晶片的一家公司。光引擎 A 公司做得好,交換器 ASIC B 公司做得好,但一顆晶片就必須放棄其中之一。價格談判力也消失。
所以買方想要「分開,但以標準連接」的結構。光引擎歸光引擎競爭,ASIC 歸 ASIC 競爭。在封裝中相遇用標準介面。這是 CPO 生態系想走的方向。單石整合與這經濟學正面衝突。
行動比喻:與 Samsung 或 Apple 即使自製 AP,數據機也用(曾用)Qualcomm 的原因相同。用做得好的人的東西,更便宜更快。
原因 7. 生命週期不同
光模組的世代更換週期是 2~3 年。400G → 800G → 1.6T。交換器 ASIC 的壽命是 5~10 年。若綁成一顆晶片,變換快的光會拖住變換慢的 ASIC。想只升級光,也得整顆晶片換掉。
而且光模組接近耗材。雷射壽命、連接器污染、老化。是現場故障的常客。ASIC 是用 10 年的資產。把生命週期不同的東西綁在同一裸晶上,就像把輪胎與引擎做成一體。輪胎必須更換。
整理:不是「一顆晶片」,而是收斂到「一個封裝」
把七個原因濃縮成一行就是這樣。
製程不同、尺寸不合、良率以乘法崩潰、熱也是問題、類比沒有微縮好處、經濟學也反對、生命週期也不同。
所以業界的答案不是單石,而是 co-packaging。分開製造,但在封裝內盡可能靠近。CPO 正是那個妥協點的名字。對於「為什麼不做成一顆晶片」這個問題,2026 年業界的答案是「不做成一顆晶片,做成一個封裝」。
這邏輯對 AP 設計師其實不陌生。AP 這個「一顆晶片」裡面,CPU 是 3nm、RF 是不同製程、PMIC 又是不同製程、記憶體以 HBM 從外部貼合。行動 SoC 本身也不是「完整的一顆晶片」。是適材適所的分工。網路晶片世界只是那分工更露骨而已。
第 7 章 給韓國設計師的啟示
為什麼只做行動的你需要知道這些。有四點。
1. HBM 之後的下一個瓶頸是網路
GPU 靠 HBM 讓記憶體變快了。現在搬不動資料的是網路。AI 叢集的錢正從 GPU 移往網路。CPO、矽光子、1.6T/3.2T 光模組 — 這市場未來 5 年最熱。
2. CPO 是封裝需求
CPO 的本質是先進封裝。把光引擎與 ASIC 貼合的 COUPE 等技術、光纖 attach、熱設計。CoWoS 級封裝需求從 AI 晶片擴展到網路晶片。對韓國 OSAT、載板業界是機會。
3. 交換器裡進了 HBM
出現了像 Jericho3-AI 這樣以緩衝用途內含 HBM 的交換器。HBM 的下一個市場可能是網路設備。若你是記憶體設計師,這是值得關注的點。
4. 類比/混合信號設計師的機會
光 DSP、TIA、driver、retimer — 全部是類比/混合信號。數位設計師過剩,但能處理 224G SerDes 與光類比的人稀少。對在行動領域做 SerDes 或類比的人來說,網路晶片是最自然的下一個職涯。韓國無廠半導體公司能瞄準的位置也在這裡。
FAQ
什麼是交換器 ASIC?是在資料中心內把封包送往目的地的晶片。拆解封包標頭(Parser)、查詢表格(Match-Action)、從輸出埠送出。最新晶片為 51.2Tbps 級,內含 512 條 SerDes 通道。Broadcom Tomahawk、Cisco Silicon One、NVIDIA Spectrum 等是代表。
NIC 與 SmartNIC(DPU)有什麼不同?NIC 是把伺服器連上網路的基本晶片。SmartNIC/DPU 在此之上加上 ARM CPU 與加速器,在 NIC 中處理虛擬交換器、儲存(NVMe-oF)、加密等基礎設施工作。讓主機 CPU 只用於客戶工作負載,節省資料中心的錢。NVIDIA BlueField 是代表。
什麼是矽光子?是在矽晶圓上製造光波導、調變器、受光元件的技術。把 CMOS 晶圓廠的規模經濟帶入光通訊。只有雷射因為矽不會發光(間接能隙),使用外部 III-V 雷射。
什麼是 CPO?與可插拔光模組有什麼不同?CPO(Co-Packaged Optics)是把光引擎貼在與交換器 ASIC 相同封裝內的技術。既有可插拔從前面板模組到 ASIC 要經過超過 15cm 的銅配線,CPO 把那距離縮短到 1cm 左右。把光相關電力降低到 70% 水準,並使 100Tbps 級交換器成為可能。代價是維修難度、熱設計、良率成為課題。
為什麼不把交換器與光引擎做成一顆晶片?有七個原因。製程不同(3nm 邏輯 vs 光 SOI)、光罩已滿、良率以乘法崩潰、熱-光耦合問題、類比沒有微縮好處、超大規模業者討厭供應商鎖定、生命週期不同(光 2~3 年 vs ASIC 5~10 年)。所以正收斂到 co-packaging 而非單石。
CPO 的缺點是什麼?無法維修(光引擎故障時更換電路板)、熱設計難度(雷射對溫度敏感)、光引擎+封裝良率瓶頸、光-電整合測試基礎設施不足、尚未成熟的多供應商生態系。2026 年現在量產已開始,但「走到哪裡多快」由這些課題決定。
本文以 2026 年 10 月為基準撰寫。CPO 市場變動快速,最新產品規格請確認各供應商的發表。
相關文章
- CPO(Co-packaged Optics)是什麼?進入交換器、GPU 旁邊的光 IO 結構與 trade-off
- 行動 AP 市場在沒落嗎:出貨量、矽價值、自製晶片的三路分叉
- Samsung 的矽光子收購戰 — 誰定義光 I/O 層
- AI 光互連真正的瓶頸 — 從預付款看矽光子代工戰爭
- Samsung DDR5 Q-die 捕捉:2GB 裸晶與 78FBGA 說的成本戰爭
📩 今天錯過的分析,明天早上寄到您的信箱
每天10:30(KST)Daily Silicon與財報·機構報告核心解讀搶先送達。訂閱後可選擇韓語/英語/日語新聞通訊,中文深度分析每日在網站更新。
免費訂閱 →
免費 · 無垃圾郵件 · 隨時退訂