VLSI Korea
Agentic EDA(3):切分得越細就越聰明——階層式 AI 晶片設計研究的最前線
讓 LLM 扁平生成整顆晶片,複雜度一上升 hallucination 就會爆發。RTLRewriter、ROME、HiVeGen、MAHL 等 2024~2025 年研究一致指出:階層式切分能提升最佳化效果,ROME 更讓 token 成本減少 58.8%。分割標準正從團隊人數移向 AI 的上下文視窗。


🆓 免費文章 · 任何人都可以免費閱讀
Agentic EDA 五部曲之三。第 1 部談代理如何改變 RTL-to-GDS 流程,第 2 部談 AI 實驗室與 EDA 廠商的角力。本篇第 3 部是整個系列的中軸:巨大的晶片切分得越細,AI 代理就越能理解並最佳化每一塊碎片——我們將透過 2024~2025 年的核心研究來驗證這個論點。
為什麼現在談這個主題。第 1 部談到的代理、第 2 部談到的廠商藍圖,背後都有一個共同前提:存在著代理要處理的工作單位。然而,這個單位由誰決定、以多大的粒度決定,相關討論卻出乎意料地少。分割(partitioning)長期以來被視為「理所當然由人類來做的事」。本文正是從質疑這個理所當然開始。或許,分割才是代理時代真正的核心設計行為。
TL;DR
- 若讓 LLM 把整顆晶片生成為一個扁平(flat)的 Verilog 區塊,複雜度一上升,hallucination 就會爆發。2024~2025 年研究的處方驚人地一致:階層式地切分。
- 香港中文大學(CUHK)團隊的 RTLRewriter(ICCAD 2024,2024 年 9 月於 arXiv 公開)觀察到,對分割後的子電路套用 LLM 式最佳化時,效果明顯變好。其依據是 Transformer 在長上下文理解上的極限。
- NYU 團隊的 ROME(2024 年 7 月於 arXiv 公開,發表於 MLCAD 2024)以階層式提示讓 GPT-4 成功生成了扁平方式完全失敗的 systolic array 與 UART。Token 成本最多減少 58.8%。
- 同一研究中,較小的模型連階層計畫(hierarchy plan)本身都訂不出來。切分得細是正解,但決定「如何切分」的設計依然困難。
- 實務意涵很明確。決定分割粒度的標準,正從「團隊人數」移向「AI 的上下文視窗」。若再與小晶片(chiplet)趨勢結合,設計方法論與組織將一同改變。
1. 問題意識:為什麼扁平生成會爆掉
以 LLM 生成 Verilog 的研究自 2023 年起正式展開。VerilogEval(2023 年 11 月公開)成為標準基準,RTLCoder、Chip-Chat 等早期研究接續而來。但這些早期研究有一個共同極限:模組的生成沒有階層結構,而是一整段直線式的程式碼區塊。
這個方式在小型設計上行得通。問題出現在複雜度上升的那一點。借用 ROME 論文的說法,複雜設計的直線式程式碼區塊必然比階層式替代方案更長,而在拉長的輸出中,LLM 會產生 hallucination。LLM 生成的文字太長時,往往會遺失原始目標的上下文。[1]
再往下走一步。與軟體程式碼不同,Verilog 具有平行(parallel)語意。always 區塊同時運作,狀態在時脈邊緣改變。Verilog 在 LLM 訓練資料中所佔的比重很小,而且大多是小型範例程式碼。在拉長的生成過程中,模型一旦遺失「我現在正在描述哪個時脈域的哪個狀態」,就會產出文法正確、語意卻錯誤的程式碼。
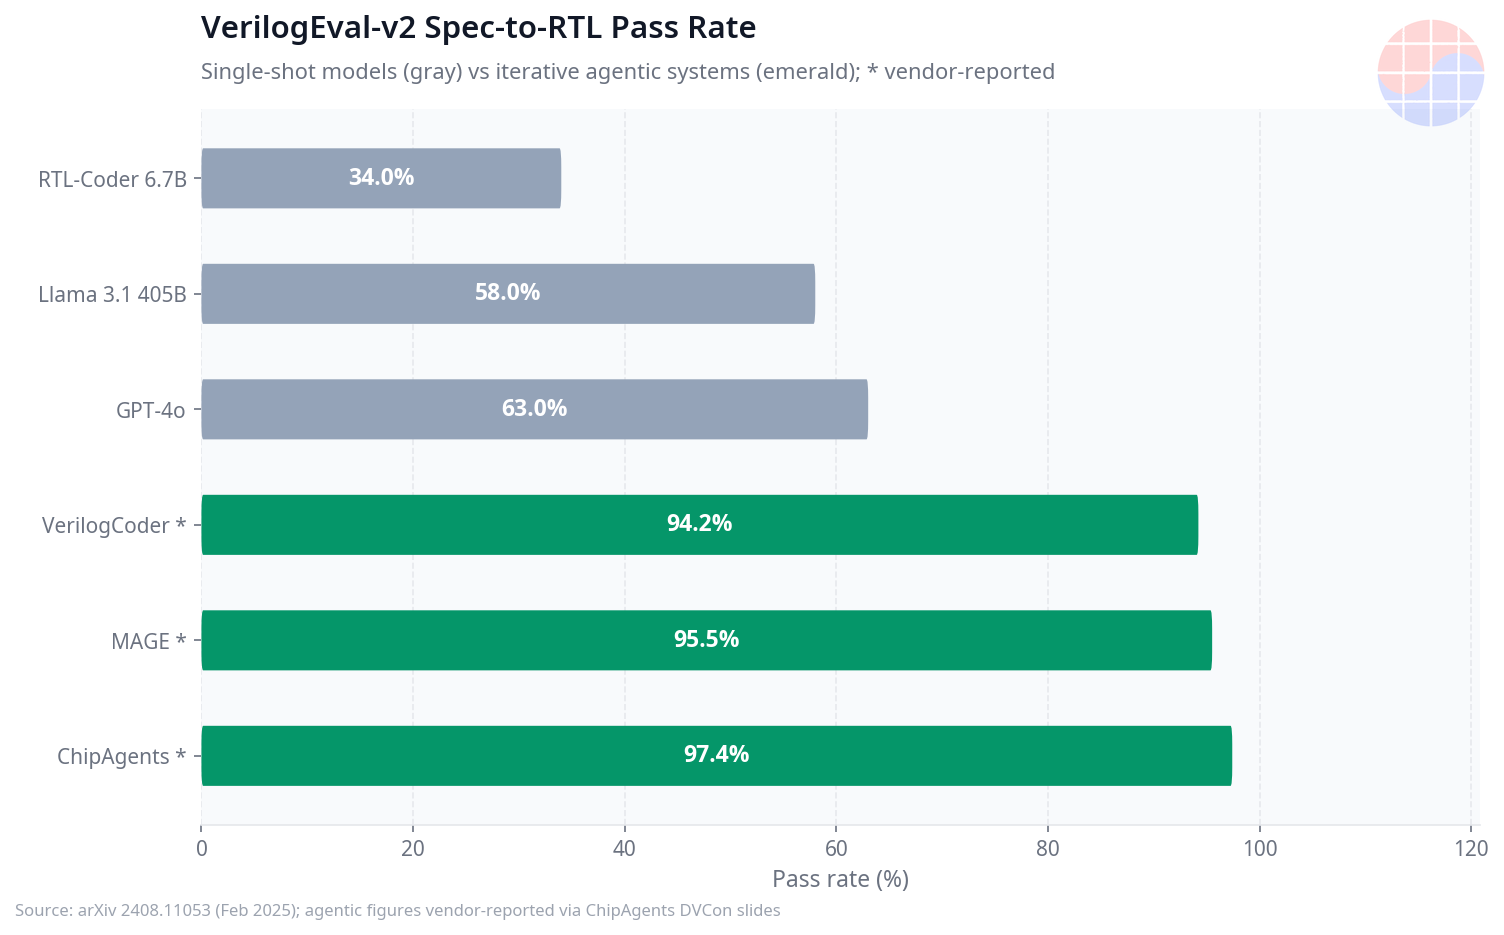
從基準分數的走勢也能看出這個極限走到了哪裡。根據 NVIDIA 團隊的「Revisiting VerilogEval」(arXiv,2025 年 2 月修訂),GPT-4o 在 spec-to-RTL 任務上記錄了 63% 的 pass rate。開源模型 Llama 3.1 405B 也以 58% 緊追在後。然而迭代式 agentic 系統報告的數字是另一個量級:ChipAgents 97.4%、MAGE 95.5%、VerilogCoder 94.2%(以上為 2026 年 ChipAgents DVCon 簡報中引用的廠商報告值)。基準本身已被迭代式系統推近飽和狀態。如今戰線已從「正確生成」移向「PPA 做好、在系統層級上正確打造」。
- 本節的限制:廠商報告值(agentic 系統的 94~97%)是各公司在自家簡報中主張的數字,沒有獨立的第三方驗證。單次生成模型與迭代式系統的測量條件也不相同。 ↩︎
2. RTLRewriter:切分之後,最佳化就不一樣
不只生成,最佳化也說著同樣的故事。香港中文大學(CUHK)Bei Yu 教授團隊的 RTLRewriter(2024 年 9 月於 arXiv 公開,發表於 ICCAD 2024)探討以 LLM 進行 RTL 程式碼最佳化的方法論。這篇論文最犀利的一段在 3.1 節「Circuit Partition」。
作者先指出,Transformer 式模型理解長上下文的問題依然未解,原因是 quadratic complexity。接著他們提出實測觀察:相較於對整個電路套用 rewriting,對分割後的子電路套用時,rewriting 的效果明顯更好。當小碎片進入 LLM 的「工作記憶體」時,模型能正確掌握該碎片的結構與意圖,並加以最佳化。
RTLRewriter 的分割管線本身也值得關注。它把 RTL 程式碼解析為 AST,轉換為 instance tree,再執行一個預測每個節點(Verilog 模組)synthesis time 的 circuit predictor。根據該預測,在均勻分配整體 synthesis workload 的同時,把效能損失降到最低的方向切分分割區。也就是說,它把分割本身當作一個最佳化問題來解。
筆者關注的重點只有一個。分割原本是業界為了縮短 synthesis 時間的實務慣例。RTLRewriter 為這個實務慣例加上了 AI 時代的第二個理由:切分成 LLM 能理解的單位。同一個行為,不同的目的。今後談分割時,「為什麼要切分」的答案將有兩個:為了平行合成,以及為了讓 AI 理解。
3. HiVeGen:在階層式生成上疊加 DSE
HiVeGen(arXiv 2412.05393,2024 年 12 月公開)的全名是「Hierarchical LLM-based Verilog Generation for Scalable Chip Design」。問題意識很明確:LLM 傾向把硬體設計生成為單一 HDL 程式碼區塊而非階層結構,這在 domain-specific accelerator(DSA)等複雜設計中尤其會導致 hallucination。
HiVeGen 的處方是把生成任務分解為「LLM 能負荷的階層式子模組」。不止於此,它還疊加了三件事。第一,把 automatic design space exploration(DSE)整合進 hierarchy-aware prompt generation。第二,以 weight-based retrieval 強化程式碼重用。第三,透過即時 human-computer interaction 降低錯誤修正成本。
加上筆者的評論,第一點最重要。把 DSE 接上階層結構,意味著可以以分割為單位跑 PPA 探索。比起一次探索整顆晶片,平行探索小碎片更有效率,這與 DOE 自動化代理的討論精確地扣合。
4. ROME:階層式提示的證明
最正面證明本系列論點的論文,是 NYU 團隊的 ROME。「Rome was Not Built in a Single Step: Hierarchical Prompting for LLM-based Chip Design」(arXiv 2407.18276,2024 年 7 月公開,發表於 MLCAD 2024)。
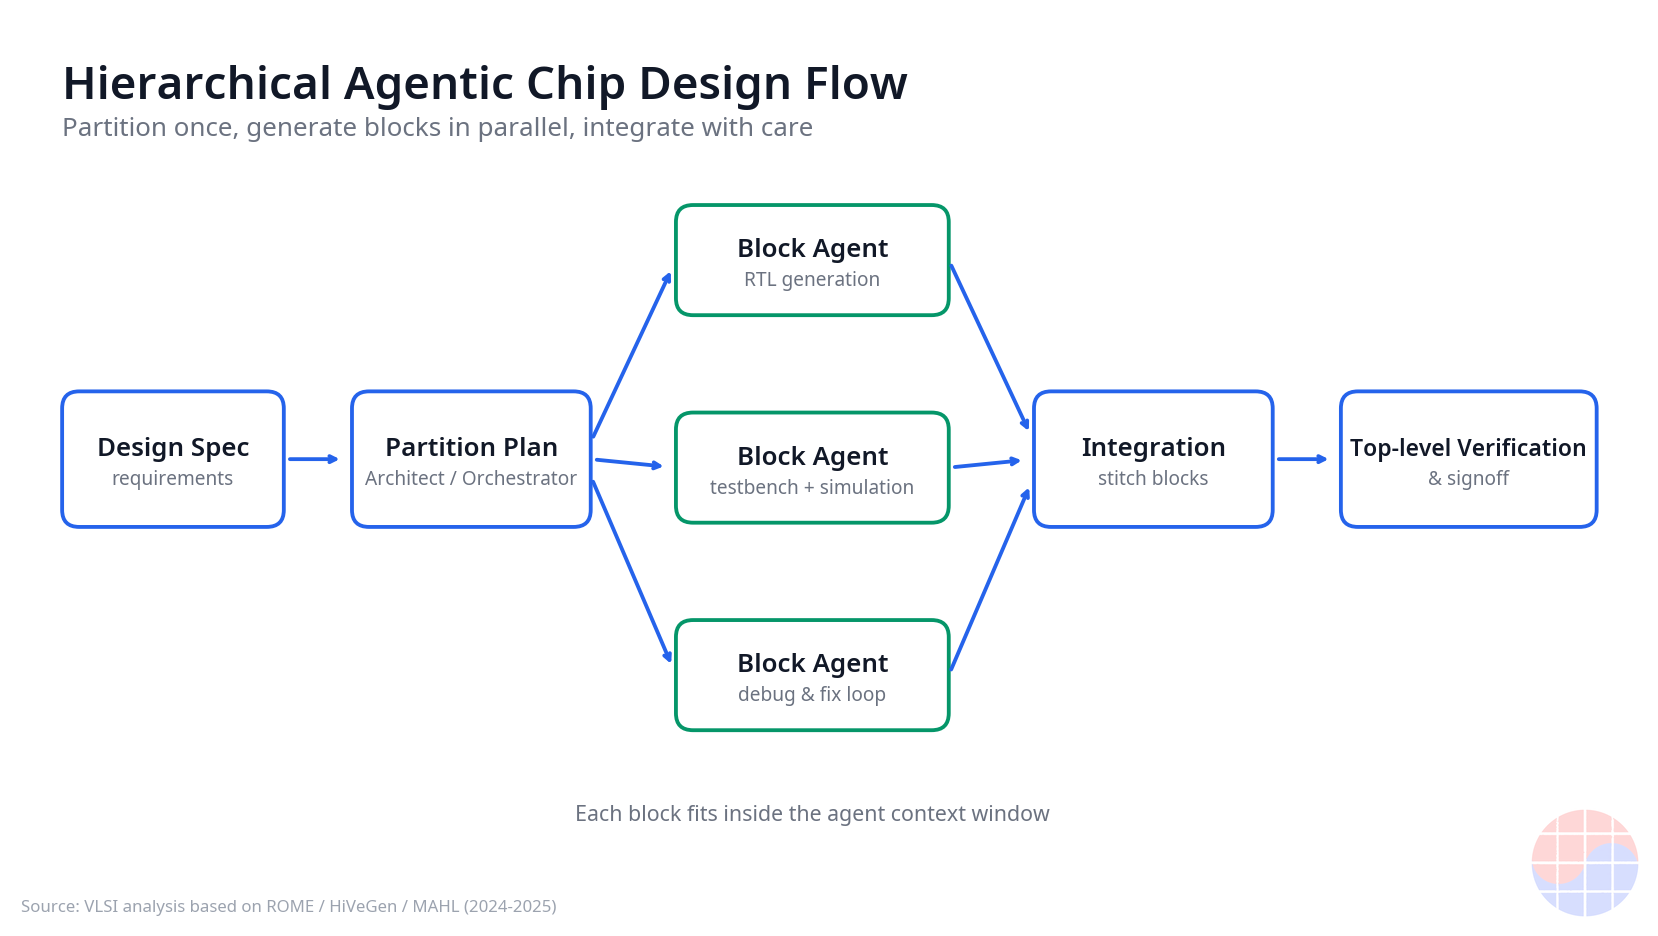
核心想法很簡單:把階層結構以提示的方式注入。有兩種模式。HDHP(human-driven hierarchical prompting)把人類提出的階層結構放進提示,並以各子模組 unit test 產生的編譯器回饋反覆修正。PGHP(purely generative hierarchical prompting)再往前一步:只給 LLM 基本提示,讓它從所需區塊的分解開始自行完成。
兩種模式的區分之所以重要,是因為這正是「人類的角色還剩下多少」的實驗設計。而論文結果精細地呈現了這個區分。在 PGHP 中成功自行訂出階層計畫的只有 GPT-4,較小的模型則漏掉子模組或塞入不相干的模組而失敗。換句話說,「切分的計畫」比「切分後碎片的實作」高一個難度的層次,這一點已被實證。
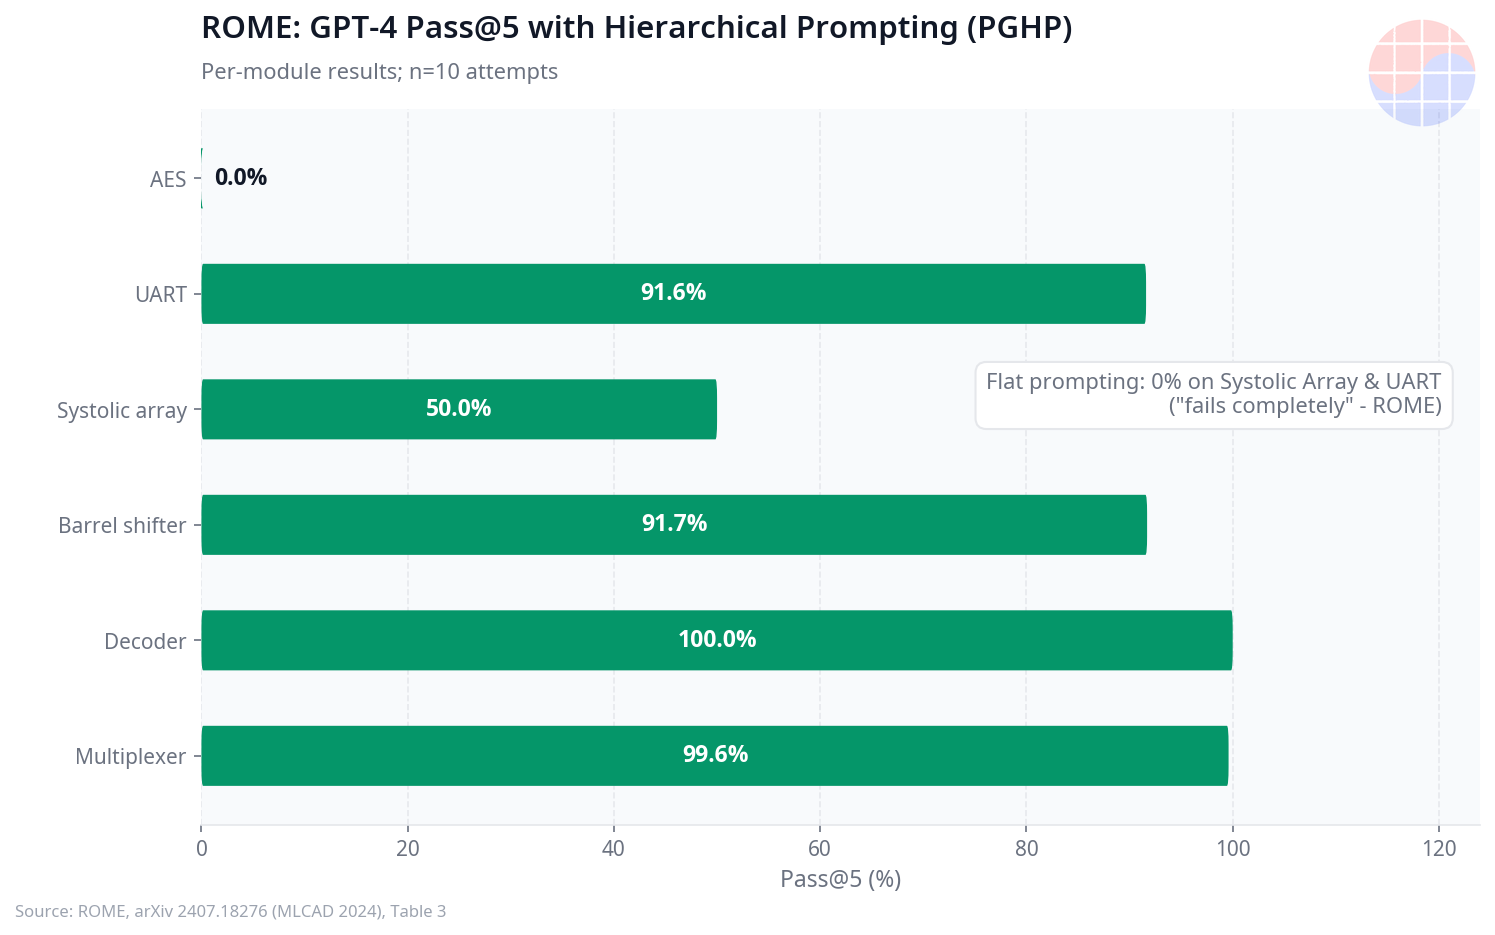
結果相當戲劇化。套用 PGHP 的 GPT-4 生成了扁平方式完全失敗的 systolic array 與 UART 的有效實作。GPT-4 PGHP 在 6 種基準上的 pass@5 分別為 multiplexer 99.6%、decoder 100%、barrel shifter 91.7%、systolic array 50%、UART 91.6%。(AES 為 0%,極限依然明確。)[1]
更有趣的是成本。階層式提示同時縮短了生成時間,也降低了 token 成本。在 32-bit RISC-V 處理器的生成中,token 成本減少了 58.8%。模組越複雜,節省幅度越大。
還有這篇論文留下的最挑釁的紀錄:以 PGHP,GPT-4「在沒有人類介入的情況下」設計了 16-bit MIPS 處理器。在最初的一個提示之後,所有設計決策與錯誤處理都自動進行,23 分 37 秒就產出了可合成的處理器。
5. VeriBToT:自行切分、自行驗證的推理
2025 年 11 月出現了觸及推理典範本身的論文。中國科學院 ICT 與香港中文大學團隊的 VeriBToT,「Think with Self-Decoupling and Self-Verification: Automated RTL Design with Backtrack-ToT」(arXiv 2511.13139,2025 年 11 月 17 日公開)。
問題意識相當犀利:chain-of-thought(CoT)在 IC 設計工作流程自動化中大致無效,且需要人工介入。核心議題在於控制 CoT 的推理方向與逐步細粒度(granularity),而其診斷是:這與專家的 RTL 設計知識並不相符。
VeriBToT 的答案是把 top-down 方法與 DFV(design-for-verification)結合。它達成中間步驟的 self-decoupling 與 self-verification,並建構 Backtrack Tree of Thought。DFV 這個概念值得注意:把思考切分成代理能自行驗證的單位。切分成可驗證的大小。這是 RTLRewriter 的「切分成可理解的大小」、HiVeGen 的「切分成可生成的大小」的另一種變奏。2025 年的研究從不同角度抵達了同一個結論:AI 處理的一切,其單位都是模組。
📩 在持續關注這個主題嗎?
財報·報告·HBM供需的後續分析,每天10:30(KST)寄到您的信箱。 免費訂閱 →
6. MAHL:擴展到小晶片的階層設計
MAHL,「Multi-Agent LLM-Guided Hierarchical Chiplet Design with Adaptive Debugging」(arXiv 2508.14053,2025 年 8 月公開)。這是把 LLM 的領域從模組單位生成擴展到 2.5D 小晶片設計的嘗試。
MAHL 是 6 個代理協作的框架。論文提出的數字令人印象深刻:對真實世界小晶片設計的 Pass@5,以 best-case 為基準,從既有 LLM 的 0 上升到 0.72。意思是,既有 LLM 一次都不曾成功的真實世界小晶片設計,在階層式多代理結構下,72% 的嘗試都能成功。
這裡應該讀出的趨勢是規模放大。HiVeGen(模組)→ MAHL(小晶片)。以階層式分解這同一件武器處理的單位正在變大。而且小晶片並非偶然的選擇。在整個業界正從單片式 SoC 移向小晶片的此刻,AI 代理的分割單位與產業的分割單位正指向同一個方向。
7. Architect in the Loop:整合才是瓶頸
到目前為止是「切分得細就變聰明」的故事。現在看另一面。「Architect in the Loop Agentic Hardware Design and Verification」(arXiv 2512.00016,2025 年 10 月)報告了把 RISC-V CPU 的完整設計交給代理的實驗。
結果很冷靜。在元件層級成功了,但在系統層級驗證上無一例外地失敗。作者提出的處方是 architect-in-the-loop 典範:不是完全自主,而是讓架構師進入迴圈的結構,在經濟上才是可行的。
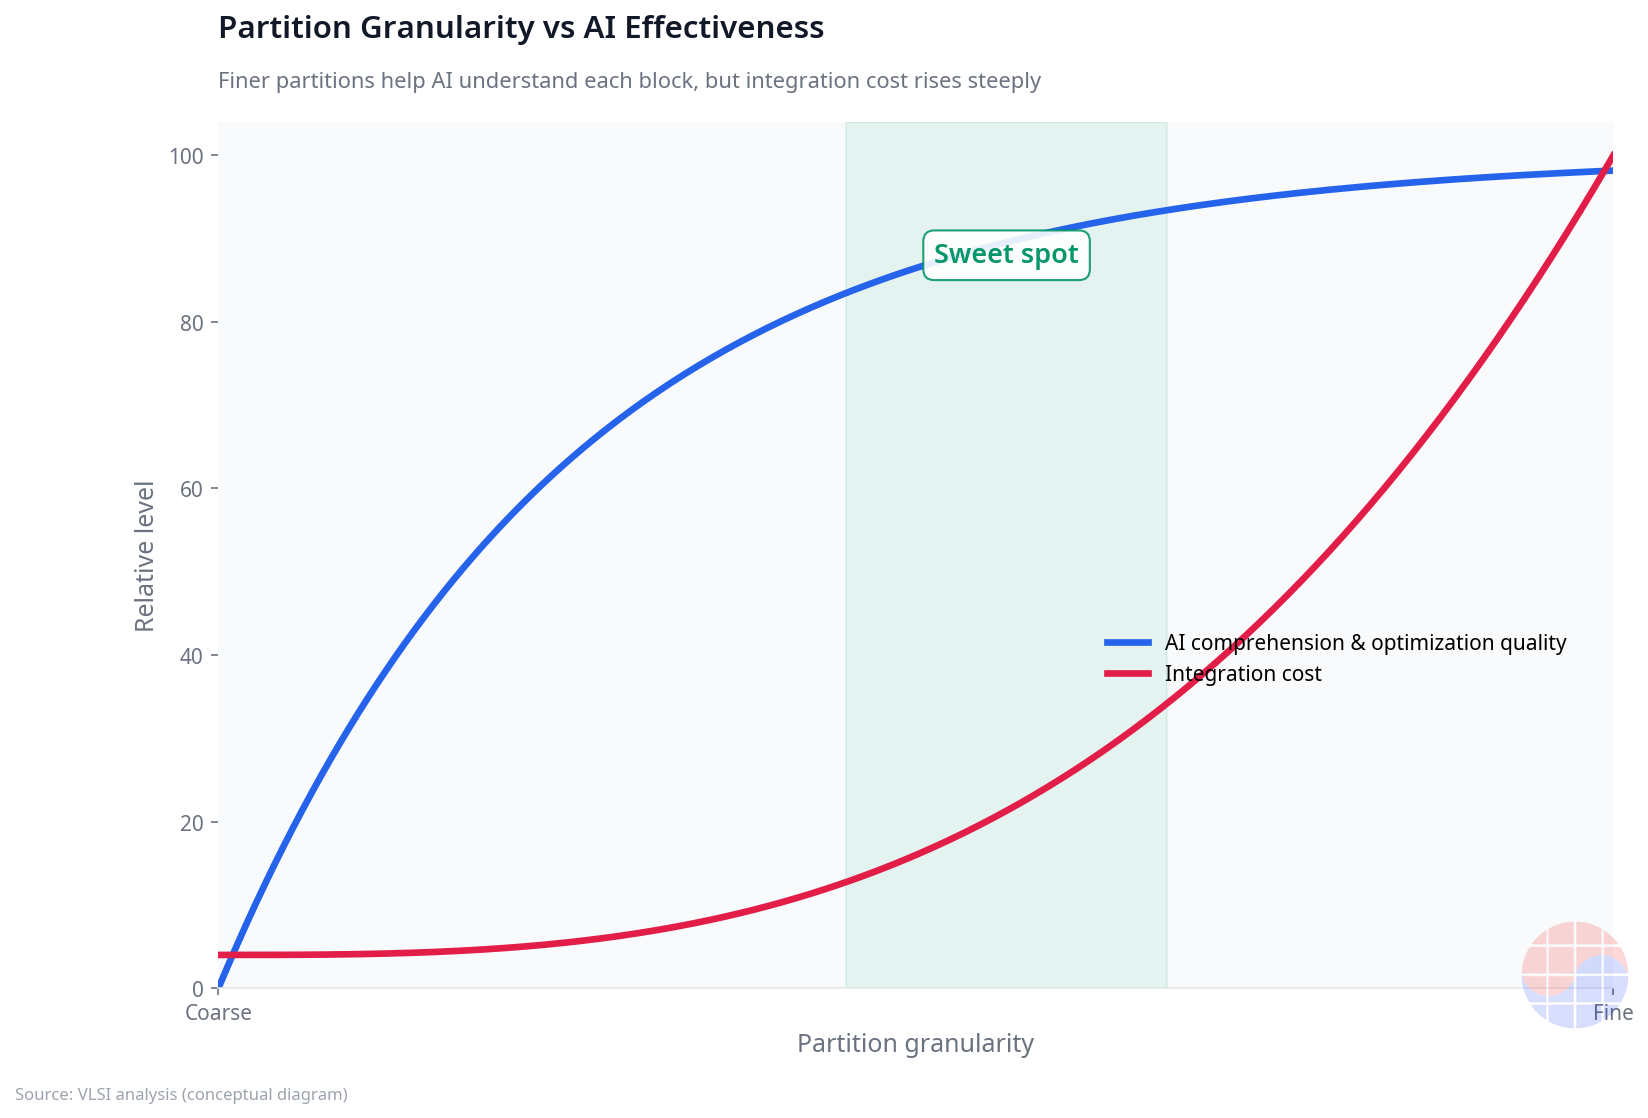
這篇論文丟出的問題是:把碎片做得好,和把碎片接得好,是不同的技能。分割一旦有數百個,每個區塊的介面定義、整合、系統層級驗證就成為新的瓶頸。切分得越細,AI 確實越聰明,但把切分的東西重新組成一個整體的成本也同步上升。[2]
也來看看 architect-in-the-loop 具體意味著什麼。架構師仍是訂定分割計畫、定義區塊間介面 contract、對系統層級驗證作出判定的主體。無論代理在各自的分割區內變得多聰明,保證分割區之間的整合一致性是另一個層次的工作。
- 本節的限制:pass@k 是以 n=10 次嘗試為基準的論文自身測量值。如 AES 0% 所示,複雜度一旦超過一定水準,光靠階層結構無法解決。 ↩︎
- 本節的限制:該論文的實驗針對特定的 RISC-V CPU 設計,無法推廣到所有複雜度的設計。 ↩︎
8. 實務意涵:分割標準的移動
現在離開研究室,把目光轉向實務。
過去的分割是組織圖的函數。因為每個區塊都需要一位負責的工程師,分割的數量配合團隊人數,以最小限度切分。這是 Conway's law 的典型表現:組織結構形塑架構。
在代理時代,目標函數被翻轉。決定分割大小的標準,從「人類組織的人數」變成「AI 的上下文視窗」。以能平行運行的代理數量、以每個代理能理解的大小來切分,成為最佳解。晶片的階層結構開始像代理群集的結構——這是 Conway's law 的逆轉。
而且這股潮流與業界的小晶片(chiplet)趨勢精確地扣合。移向小晶片的原始動機是良率與成本。如今又加上了第二個動機:AI 平行化。設計切分得越細,代理就越容易理解與最佳化,也能以分割為單位平行執行 DOE。
不過也要指出物理現實。邏輯上切分得細,與物理上以細粒度實作,是不同的問題。P&R 不喜歡跨越分割邊界的時序,時脈分配與電源網格在邊界變多時也越來越棘手。邏輯階層與物理階層如何映射,依然是人類架構師的設計領域。
9. 限制與展望
也整理一下誠實的限制。當區塊達到數百個,頂層整合地獄就會開啟。介面時序預算由誰決定?CDC 邊界達到數百個時由誰驗證?正如 ROME 的 MIPS 處理器實驗所揭示,像統一子模組輸入輸出線路命名這種「看似瑣碎」的整合工作,會拖住自動化的腳步。
因此第 3 部的結論收斂如下:善於分割的 AI 與負責整合的架構師之間的分工。AI 會越來越擅長理解與最佳化切分得細的碎片。然而,決定「如何切分」的分割計畫、區塊間介面定義、系統層級驗證與最終簽核,仍是架構師的核心能力。
謹慎提出展望如下。在中小型晶片上,5 年內「一位工程師 + 一群代理」扛起整顆晶片的樣貌可能成為現實。在最先進的 SoC 上,architect-in-the-loop 結構會持續很久。無論哪一種,設計分割的能力價值會上升,而反覆跑流程、抓錯誤的管線清理工作價值會下降。
最後也談談 token 經濟學的觀點。ROME 的結果顯示,階層式提示不只解決正確度問題,也解決成本問題。在 32-bit RISC-V 處理器的生成中,token 成本減少了 58.8%。在 long-horizon 代理運行數千步驟的時代,token 成本就是設計成本。分割既是正確度的問題,也是經濟性的問題。切分得細的團隊,能以更便宜、更快的速度做出晶片。
FAQ
Q1. 階層式設計是萬能的嗎?小型設計也需要嗎?
不是。小型設計用扁平方式生成也沒問題。階層結構的收益發生在複雜度上升的那一點。階層化不是萬能處方,而是針對複雜度的處方。
Q2. 分割切分得越細就一定越好嗎?
不是,其中有取捨。區塊越小,AI 的理解度與最佳化品質會上升,但整合成本(介面定義、CDC 驗證、頂層時序收斂)也會同步上升。最佳的分割大小,落在「AI 能理解的最大單位」與「整合成本可負擔的最小單位」之間的某處。
Q3. 小型模型真的做不了階層設計嗎?
根據 ROME 論文的實驗,在純生成模式(PGHP)中成功自行訂出階層計畫的只有 GPT-4。不過在 human-driven 模式(HDHP)中,若人類給予階層結構,小型模型也能成功生成複雜模組。「訂定切分計畫」與「實作切分後的碎片」是不同難度的工作。
Q4. 這些研究有實際走到 tapeout 的案例嗎?
截至 2026 年 10 月,尚無完全自主的代理完成產業規模晶片 tapeout 並經獨立驗證的案例。研究還處於證明方向的階段。
Q5. 現職工程師應該準備什麼?
分割計畫、介面定義、系統層級驗證與簽核判斷。也就是切分與組裝架構的能力。像 STA signoff 這種「保證信任的層次」的專業,價值反而會上升。
Sources
- ROME — Nakkab et al., "Rome was Not Built in a Single Step: Hierarchical Prompting for LLM-based Chip Design", arXiv 2407.18276 (2024 年 7 月), MLCAD 2024 發表。 https://arxiv.org/abs/2407.18276
- HiVeGen — Tang et al., "HiVeGen: Hierarchical LLM-based Verilog Generation for Scalable Chip Design", arXiv 2412.05393 (2024 年 12 月,2025 年 10 月修訂)。 https://arxiv.org/abs/2412.05393
- RTLRewriter — "Methodologies for Large Models aided RTL Code Optimization", arXiv 2409.11414 (2024 年 9 月), ICCAD 2024。 https://arxiv.org/abs/2409.11414
- VeriBToT — Chao et al., "Think with Self-Decoupling and Self-Verification: Automated RTL Design with Backtrack-ToT", arXiv 2511.13139 (2025 年 11 月 17 日)。 https://arxiv.org/abs/2511.13139
- MAHL — Tang et al., "MAHL: Multi-Agent LLM-Guided Hierarchical Chiplet Design with Adaptive Debugging", arXiv 2508.14053 (2025 年 8 月,10 月修訂)。 https://arxiv.org/abs/2508.14053
- Architect in the Loop — "Architect in the Loop Agentic Hardware Design and Verification", arXiv 2512.00016 (2025 年 10 月)。 https://arxiv.org/abs/2512.00016
- VerilogEval revisited — Pinckney et al., "Revisiting VerilogEval: A Year of Improvements in Large-Language Models for Hardware Code Generation", arXiv 2408.11053 (2025 年 2 月修訂)。 https://arxiv.org/abs/2408.11053
常見問題
RTLRewriter 確認的分割效果是什麼?
RTLRewriter 確認,對分割後的子電路套用時,重寫效果明顯變好。香港中文大學團隊的 RTLRewriter(ICCAD 2024)指出原因是 Transformer 在長上下文理解上的極限,並把分割本身當作以合成時間預測為基礎的最佳化問題來解。
ROME 的階層式提示結果如何?
在 NYU 團隊的 ROME(MLCAD 2024)中,套用階層式提示的 GPT-4 生成了扁平方式完全失敗的 systolic array 與 UART 的有效實作。pass@5 為 multiplexer 99.6%、decoder 100%、barrel shifter 91.7%、UART 91.6%,而 AES 為 0%,極限依然存在。
階層式提示減少了多少 token 成本?
在 32 位元 RISC-V 處理器的生成中,token 成本減少了 58.8%,模組越複雜,節省幅度越大。據報告,生成時間也一併縮短。
哪個模型成功自行訂出了階層計畫?
只有 GPT-4 成功。較小的模型漏掉子模組或塞入不相干的模組而失敗,這顯示訂定切分計畫比實作切分後的碎片高一個難度層次。
相關文章
- Agentic EDA 2026:Synopsys、Cadence、Siemens 三家公司的晶片設計代理策略比較
- 晶片設計 AI 代理由誰販售:以 build vs buy 解讀 Agentic EDA 市場地圖
- 一人晶片時代來臨:AI 代理如何改變半導體工程師的工作與生存策略
- AI 設計 AI 晶片:OpenAI、Anthropic、Tesla 跨入矽晶的真正原因
📩 今天錯過的分析,明天早上寄到您的信箱
每天10:30(KST)Daily Silicon與財報·機構報告核心解讀搶先送達。訂閱後可選擇韓語/英語/日語新聞通訊,中文深度分析每日在網站更新。
免費訂閱 →
免費 · 無垃圾郵件 · 隨時退訂